
System Design
Source: https://github.com/madd86/awesome-system-design at
52834671253b
License: CC0-1.0
Read the English original
This edition is an AI-assisted translation.

Auswahl von Artikeln, Büchern, Videos und Werkzeugen zu verteilten Systemen und Big Data.
Ganz gleich, ob du dich auf ein Vorstellungsgespräch vorbereitest oder eine verteilte beziehungsweise auf Microservices ausgerichtete Anwendung entwerfen möchtest – diese Liste hilft dir dabei.
Achtung: Die Anzahl der GitHub-Sterne spiegelt nicht die Nutzung oder Popularität aller hier aufgeführten Einträge wider.
Inspiriert von Awesome-BigData
Gestartet von Gabriel Leon de Mattos
- Relational Database
- NoSQL
- Verteilte Dateisysteme
- Ressourcenverwaltung
- Stream-Verarbeitung
- Message Broker
- Load Balancer
- Hadoop-Ökosystem
- REST-Framework
Artikel
Abschnitt betitelt „Artikel“Einführung / Interviews
Abschnitt betitelt „Einführung / Interviews“-
System Design Primer - [109k ⭐] - Tolle Zusammenstellung von Ressourcen, einschließlich Anki-Lernkartendecks.
-
System Design Interview Questions - Concepts you should know - Eine kuratierte Themenliste, die Sie in das Systemdesign einführt.
-
Grokking the System Design Interview - [Paid 💵] - Die Vorbereitung auf Grokking System Design ist einer der am meisten diskutierten Kurse. Das Beste daran ist das Design der vorgeschlagenen Anwendungen und nicht die Erklärung, was jedes Tool tun soll.
-
System Design in Software Development - Grundlagenartikel zu den Themen Systemdesign und Architektur.
-
System Design - Einführende Ressourcen zur Vorbereitung auf Vorstellungsgespräche.
-
Design Pattern for Distributed Systems - Artikel über einige Muster sowie einige zu berücksichtigende Technologien.
-
Practice system design problems using AI on Codemia.io - Ein Tool, mit dem Sie Systemdesignprobleme wie ein Interview mit KI interaktiv üben können. Es gibt iteratives Feedback und eine abschließende Bewertung, die Ihre Leistung bewertet
Fortgeschritten
Abschnitt betitelt „Fortgeschritten“-
Distributed Computing - Wikipedia-Artikel, der den Blickwinkel auf das Design verteilter Systeme erweitert.
-
Fallacies of Distributed Computing - Wikipedia-Artikel zur Einführung in das Thema der Trugschlüsse des verteilten Rechnens und seiner Auswirkungen.
-
Fallacies of Distributed Computing Explained - Ausführliche Erläuterung der oben genannten Irrtümer.
-
CAP Theorem - IBM-Artikel über CAP-Theorem, Microservices und NoSQL-DBs.
-
Pattern: Microservice Architecture - Guter Artikel über die Microservice-Architektur und ihre Nachteile.
-
Taxonomy of Distributed Systems - 11-seitiger Vortrag zur Klassifizierung verteilter Systeme und insbesondere, warum wir sie brauchen.
-
Top 10 Secure Coding Practices - Kurzer Artikel über bewährte Praktiken für Code-Sicherheiten.
-
Scalable Web Architecture and Distributed Systems - Guter Artikel über verteilte Systeme sowie einige der möglichen Tools.
-
Designing Distributed Systems: Patterns and Paradigms for Scalable, Reliable Services - [Paid 💵] - Buch, das über verteilte Systeme spricht und leicht Code demonstriert, wie es aussieht.
-
Designing Data Intensive Applications - [Paid 💵] - Erläutert ausführlich die verschiedenen Ressourcen, die wir bei der Arbeit mit verteilten Systemen verwenden, erklärt, wie sie entstanden sind und welche Probleme sie lösen sollen.
-
The System Design Manual - [Paid 💵] - Behandelt die Kernaspekte verteilter Systeme, wie zum Beispiel: Netzwerkgrundlagen, die Theorie, die verteilten Systemen zugrunde liegt, Architekturmuster skalierbarer Systeme, Stabilitätsmuster, die Systeme gegen Ausfälle schützen, und betriebliche Best Practices für die Wartung großer Systeme mit einem kleinen Team.
-
Building Microservices - [Free 👍] - Tolles Buch, das ausführlich über das Entwerfen von Systemarchitekturen mit Microservices spricht und die relevantesten Themen in dieser Hinsicht enthält.
-
Monolith to Microservices - [Free 👍] - Dieses Buch wurde vom selben Autor wie der oben genannte geschrieben und behandelt die Migration von Monolith zu Microservices. Es wird empfohlen, mit dem vorherigen Buch zu beginnen.
-
Distributed Systems (3rd Edition) - [Free 👍] - Toller Überblick und ausführliche Einführung in verteilte Systeme. Empfohlen für Leser mit mittlerem Niveau.
-
Safe by Design - [Free 👍] - Tolles Buch über die Durchsetzung der Code-Korrektheit durch Design.
Eine Videosammlung zu verteilten Systemen.
Einführung / Interviews
Abschnitt betitelt „Einführung / Interviews“-
Gaurav Sen - System Design Series - Gute Ressource für Leute, die mehr über Systemdesign erfahren möchten, führt das Thema auf sehr leicht verständliche Weise ein.
-
Tech Dummies - System Design Series - Eine weitere Einführung in das Systemdesign.
-
Mock System Design Interview at Google - Überblick darüber, wie ein Interview zum Thema Systemdesign aus der Perspektive einer fehlerhaften, aber genauen Erfüllung der Anforderungen aussehen würde. Entscheidend ist hier, wie die Interaktion mit dem Interviewer verläuft.
-
Google Preparation Guide - Ein kurzes Video, das erklärt, wie sie interviewen.
-
System Design Interview - Der YouTube-Kanal konzentrierte sich auf Inhalte, die sich speziell auf Systemdesign-Interviews beziehen, mit ausführlichen Erläuterungen zu verschiedenen Problemen.
-
Intro to Architecture and System Design Interviews - Ein YouTube-Video mit Jackson Gabbard mit guten Informationen zu Systemdesign-Interviews.
-
System Design Introduction for Interview - Tushars Einführung in das Systemdesign.
-
Distributed Systems - Dies ist ein Einführungskurs in verteilte Systeme von Chris Colohan. Er promovierte an der Carnegie Mellon und arbeitete dann zehn Jahre lang bei Google am Aufbau verteilter Systeme.
-
The Easy Way - Aufstrebender Kanal mit leicht verständlichen Videos über verteilte Systeme.
-
System Design by SDE Skills - Eine gute Ressource für Leute, die sich auf Systemdesign-Interviews vorbereiten. Es gibt mehrere Probeinterviews zum Systemdesign und ausführliche Einblicke.
-
System Design by CodeKarle - Eine weitere großartige kostenlose Ressource: eine Liste häufig gestellter Fragen im Vorstellungsgespräch.
Fortgeschritten
Abschnitt betitelt „Fortgeschritten“- The evolution of Reddit Architecture - Überblick über die Skalierung des Reddit-Systemdesigns.
- 6.824 Distributed Systems by MIT - Graduiertenkurs über verteilte Systeme vom MIT (2020).
- CSE138 Distributed Systems by UCSC - Grundstudiengang über verteilte Systeme an der UCSC (2020).
Werkzeuge
Abschnitt betitelt „Werkzeuge“- Eine Sammlung der am häufigsten verwendeten Werkzeuge für verteilte Systeme
Relationales Datenbankmanagementsystem
Abschnitt betitelt „Relationales Datenbankmanagementsystem“-
MariaDB - MariaDB ist ein Fork des MySQL-Servers.
-
MySQL - Weit verbreitete relationale Datenbank.
-
PostgresSQL - Relationale Datenbank, die immer beliebter wird.
-
SQLite - Eine weitere weit verbreitete Datenbank, die in allen Mobiltelefonen und den meisten Computern integriert ist.
-
Sql Server - Weit verbreitete relationale Datenbank.
Cache (Schlüssel-Wert)
Abschnitt betitelt „Cache (Schlüssel-Wert)“-
Apache Ignite - [3.3k ⭐] - In-Memory-Caching mit ACID-Eigenschaften.
-
Couchbase - Inspiriert von Memcached, mit Funktionen wie Replikation und Persistenz.
-
Oracle Coherence - [126 ⭐] - Hohe Skalierung, In-Memory-Caching mit geringer Latenz.
-
Memcached - [10.2k ⭐] - Eine der ersten In-Memory-Caching-Datenbanken mit hoher Leistung und Multithreading.
-
Redis - [44k ⭐] - Weit verbreitete In-Memory-Caching-Datenbank mit vielen zusätzlichen Funktionen wie persistenter Speicherung und der Unterstützung von Strings, Listen, Sätzen, Hashes, Streams, Bitmaps usw.
Speicher (Schlüssel-Wert)
Abschnitt betitelt „Speicher (Schlüssel-Wert)“-
Apple FoundationDB - [10k ⭐] - Multimodell (viele Datentypen in einer einzigen Datenbank), ACID-Schlüsselwertspeicher. Leicht skalierbar und fehlertolerant.
-
Cosmos DB - Der weltweit verteilte Multimodell-Datenbankdienst von Microsoft. Skalieren Sie Durchsatz und Speicher flexibel und unabhängig. SQL-, MongoDB-, Cassandra-, Tabellen-, Gremlin- und Spark-APIs.
Dokumentenspeicher
Abschnitt betitelt „Dokumentenspeicher“-
CouchDB - [4.6k ⭐] - ACID-kompatible NoSQL-Dokumentspeicher-DB bietet eine RESTful-HTTP-API zum Lesen und Aktualisieren von Datenbankdokumenten.
-
MongoDB - Eine der beliebtesten „NoSQL“-Datenbanken für allgemeine Zwecke.
-
RethinkDB - [23.8k ⭐] - Dokumentenspeicher-DB.
-
ElasticSearch - [49.9k ⭐] - Weit verbreitete „NoSQL“-Datenbank für schnelle und skalierbare Suchmaschinen.
-
Cosmos DB - Der weltweit verteilte Multimodell-Datenbankdienst von Microsoft. Skalieren Sie Durchsatz und Speicher flexibel und unabhängig. SQL-, MongoDB-, Cassandra-, Tabellen-, Gremlin- und Spark-APIs.
Wide-Column-Speicher
Abschnitt betitelt „Wide-Column-Speicher“-
Amazon DynamoDB - Schlüsselwert- und Dokumentendatenbank, hochperformant, skalierbar und sicher.
-
Google Bigtable - Skalierbare und leistungsstarke „NoSQL“-Datenbank für große analytische und betriebliche Arbeitslasten.
-
Cassandra - Von Facebook entwickeltes Projekt, sehr schnell, leicht skalierbar, mit der Option, bei jedem Vorgang Konsistenz zu berücksichtigen.
-
Scylla - [4.9k ⭐] - „NoSQL“-Datenspeicher mit Seastar-Framework, kompatibel mit Cassandra.
-
HBase - [3.6k ⭐] - Nach dem Vorbild von Googles Bigtable modelliert und in Java geschrieben. Entwickelt als Teil des Apache Hadoop-Projekts und läuft auf HDFS oder Alluxio. (Siehe Hadoop Related)
-
Cosmos DB - Der weltweit verteilte Multimodell-Datenbankdienst von Microsoft. Skalieren Sie Durchsatz und Speicher flexibel und unabhängig. SQL-, MongoDB-, Cassandra-, Tabellen-, Gremlin- und Spark-APIs.
Graphen
Abschnitt betitelt „Graphen“-
Amazon Neptune - Schneller, zuverlässiger und vollständig verwalteter Diagrammdatenbankdienst.
-
ArangoDB - [10k ⭐] - Flexible Datenbank für Dokumente, Schlüsselwerte, Diagramme. Verwendet seine eigene Abfragesprache, AQL.
-
Neo4j - [7.9k ⭐] - Gute Unterstützung für eine Graph-Datenbank, ACID-kompatibel und flexibel.
-
Cosmos DB - Der weltweit verteilte Multimodell-Datenbankdienst von Microsoft. Skalieren Sie Durchsatz und Speicher flexibel und unabhängig. SQL-, MongoDB-, Cassandra-, Tabellen-, Gremlin- und Spark-APIs.
Verteilte Dateisysteme
Abschnitt betitelt „Verteilte Dateisysteme“-
HDFS - Das Hadoop-Dateisystem erfreut sich unter seinen Big-Data-Konkurrenten großer Beliebtheit und bietet Zugriff mit hohem Datendurchsatz.
-
Lustre - Dateisystem für Computercluster.
-
CephFS - Einheitliches, verteiltes Speichersystem.
-
GlusterFS - Scale-out-NAS-Dateisystem.
-
MooseFS - POSIX-kompatibles verteiltes Dateisystem.
-
XtreemFS - Fehlertolerantes Dateisystem.
Ressourcenverwaltung
Abschnitt betitelt „Ressourcenverwaltung“- Kubernetes - Sehr beliebte Methode zur Bereitstellung, Verwaltung und automatischen Skalierung eines Clusters von Containern auf Bare-Metal- oder virtuellen Servern.
Stream-Verarbeitung
Abschnitt betitelt „Stream-Verarbeitung“-
Apache Samza - Erstellen Sie zustandsbehaftete Anwendungen, die Daten aus mehreren Quellen, einschließlich Kafka, in Echtzeit verarbeiten. Einfaches und kostengünstiges Multi-Abonnenten-Modell, kann Gegendruck beseitigen und bietet zuverlässige Beständigkeit mit geringer Latenz.
-
Apache Flink - Basierend auf dem Konzept von Streams und Transformationen. Verwendet Maven und verarbeitet Batch-Aufgaben als Datenströme mit endlichen Grenzen. Geringe Latenz, hoher Durchsatz.
-
Amazon Kinesis Streams - Langlebiger, skalierbarer Echtzeitdienst. Sammelt Gigabytes an Daten pro Sekunde aus Hunderttausenden Quellen, einschließlich Datenbank-Ereignisströmen, Website-Clickstreams, Finanztransaktionen usw.
-
Azure Stream Analytics - Echtzeit-Analysedienst, der für geschäftskritische Arbeitslasten konzipiert ist.
Message Broker
Abschnitt betitelt „Message Broker“-
Amazon MQ - Open-Source-Nachrichtenbroker von Amazon.
-
Apache ActiveMQ - Es handelt sich um einen Multiprotokoll-Messaging-Server auf Java-Basis.
-
Apache Kafka - Weit verbreiteter Nachrichtenbroker mit geringer Latenz für das Datenstreaming.
-
RabbitMQ - Sehr beliebtes Leichtgewicht In Erlang geschriebener Nachrichtenbroker, der auch mehrere Nachrichtenprotokolle unterstützt.
-
IronMQ - Sehr schneller und hoch skalierbarer Messaging-Broker. (nicht Open Source)
-
Apache Pulsar - Erstellt von Yahoo, außerdem hoch skalierbar, geringe Latenz, Georeplikation und Mandantenfähigkeit.
-
Kestrel - In Scala geschrieben und spricht das zwischengespeicherte Protokoll. Es funktioniert ähnlich wie Kafka.
-
Azure Service Bus - Ein vollständig verwalteter Nachrichtenbroker für die Unternehmensintegration.
Load Balancer
Abschnitt betitelt „Load Balancer“Open-Source-Software
Abschnitt betitelt „Open-Source-Software“-
SeeSaw - [5.1k ⭐] - Von Google verwendeter, in Go entwickelter, Linux-basierter virtueller Load-Balancer-Server.
-
HAProxy - Sehr beliebte Option, bietet Hochverfügbarkeit, Proxy und TCP/HTTP-Lastausgleich. Wird von Reddit, Imgur, MaxCDN, GitHub, AirBNB verwendet.
-
Zevenet - Unterstützt L3, L4 und L7. Einfache Installation mit einem Docker-Repo. Unterstützt erweiterte Gesundheitscheck-Überwachung.
-
Neutrino - Wird von eBay verwendet und mit Scala und Netty erstellt. Unterstützt Round-Robin- und Least-Connection-Algorithmen.
-
Nginx - Moment, ist Nginx nicht ein Webserver? Ja, Open Source unterstützt die grundlegende Inhaltsvermittlung und Anforderungsweiterleitung. Die Plus Edition unterstützt Lastausgleich, WAF, Überwachung usw.
-
Openresty - Nginx + Lua, perfekte Kombination.
Hardware
Abschnitt betitelt „Hardware“-
F5 - Robuste Hardware-Load-Balancer-Option, die mehrere Protokolle unterstützt (IP, TCP, FTP, UDP, HTTP).
-
TP-Link - Günstigere Alternative, die als Load Balancer fungiert.
-
Barracuda - Eine der Top-Optionen für den Lastausgleich, wenn es um Inhouse-Server geht. Integrierte erstklassige Sicherheitsmaßnahmen, umfassende Berichte und Überwachung des ausgehenden Datenverkehrs zur Verhinderung von Datenverlust.
-
Amazon Elastic Load Balancing - Beliebte Wahl für Amazon-Kunden, unterstützt Lambda-Funktionen, hoch skalierbar.
-
Google Load Balancing - Beliebte Wahl für Google-Kunden, mit automatischer Skalierungsfunktion, sehr schnell, mit integriertem CDN.
-
Cloudflare Load Balancing - Skalierbarer Lastausgleich durch Cloudflare, schnelles Failover und ein Dashboard.
-
DigitalOcean Load Balancing - Wenn Sie ein Digitalocean-Kunde sind, ist dies eine gute Option, sehr günstig, regional verfügbar, skalierbar und einfach unter Ihren anderen Droplets bereitzustellen.
-
Azure Load Balancing - Beliebte Wahl für Azure-Kunden von Microsoft. Unterstützt internen und externen Datenverkehr, IPv6, Überwachung und die standardmäßigen Lastausgleichsfunktionen.
Hadoop-Ökosystem
Abschnitt betitelt „Hadoop-Ökosystem“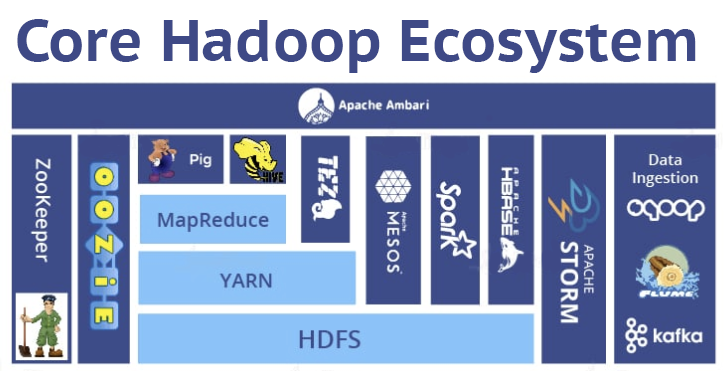
Dashboard
Abschnitt betitelt „Dashboard“- Ambari - Dashboard, das die meisten Hadoop-bezogenen Technologien für eine einfache Verwaltung und Ausführung integriert.
Datenaufnahme
Abschnitt betitelt „Datenaufnahme“-
Sqoop - Übertragen Sie Daten effizient zwischen Hadoop und strukturierten Datenspeichern wie relationalen Datenbanken.
-
Flume - Verteilt, hochverfügbar und effizient beim Sammeln, Aggregieren und Verschieben großer Mengen an Protokolldaten.
-
Apache Kafka - Weit verbreiteter Nachrichtenbroker mit geringer Latenz für das Datenstreaming.
Workflow-Scheduler
Abschnitt betitelt „Workflow-Scheduler“- Oozie - Erstellen Sie Workflows in XML, um Jobs (aus anderen Hadoop-Ökosystemanwendungen) schrittweise auszuführen, und ermöglichen Sie auch die parallele Ausführung.
Abfrage
Abschnitt betitelt „Abfrage“- Hive - Fragen Sie in SQL gespeicherte Hadoop-Daten ab.
- Pig - Skriptsprache, die wie SQL aussieht, um Hadoop-Daten abzufragen.
Verarbeitung
Abschnitt betitelt „Verarbeitung“- Tez - Löst ein ähnliches Problem wie Spark und MapReduce. Es ist effizienter als MapReduce, da es die effizienteste Vorgehensweise berechnet.
- Map Reduce - MapReduce ordnet, wie der Name schon sagt, Daten zu und reduziert die Ergebnisse.
- Spark - Leistungsstarke Datenverarbeitung, um nicht nur Daten wie Tez (und MapReduce) zu verarbeiten, sondern auch Datenströme in Echtzeit verarbeiten, Regressionsanalysealgorithmen in ML anwenden und vieles mehr.
- Apex - *Zurückgezogenes Projekt, es ist eine YARN-native Plattform, die Stream- und Batch-Verarbeitung vereint.
Datenbank
Abschnitt betitelt „Datenbank“- HBase - [3.6k ⭐] - Nach dem Vorbild von Googles Bigtable modelliert und in Java geschrieben. Entwickelt als Teil des Apache Hadoop-Projekts.
Ressourcenverwaltung
Abschnitt betitelt „Ressourcenverwaltung“- YARN - „Yet Another Resource Negotiator“ funktioniert wie ein Kernel, um Computerressourcen über die Cluster hinweg zu verwalten.
- MESOS - Funktioniert wie ein Linux-Kernel, indem er CPU, Arbeitsspeicher, Speicher und andere Ressourcen im gesamten Cluster verwaltet.
REST-Framework
Abschnitt betitelt „REST-Framework“-
Gin - [40.6k ⭐] - Extrem schnelles Microservice-Framework mit Golang und hoher Durchsatzkapazität.
-
Phoenix - [15.5k ⭐] - Verteilte Verarbeitung, leicht skalierbar, Unterstützung für Kanäle und Live-Chat. Dieses in Elixir geschriebene Framework verwendet BEAM und Erlang, ist für große Systeme sehr effizient und unterstützt einen hohen Durchsatz.
-
Express.js - [49.6k ⭐] - Schnelle node.js-Rest-API, die in vielen Szenarien eine gute Leistung erbringen kann.
-
Rails - [46.2k ⭐] - Rails ist in Ruby geschrieben und liefert auf effiziente Weise schnelle APIs vom Prototyp bis zur Produktion.
-
Play Framework - [11.6k ⭐] - Sehr schnelles Framework mit hohem Durchsatz, geschrieben in Scala/Java, das standardmäßig RESTful ist.
-
Flask - [51.6k ⭐] - Ein leichtes Python-Mikroframework für schnelles Prototyping und Produktion.
-
FastAPI - [22.7k ⭐] - Ein leichtes Python-Mikroframework, das von Flask inspiriert wurde, aber moderner ist und Python Async verwendet.
-
Django REST - [18.4k ⭐] - Django Rest wurde in Python geschrieben und ist eine leistungsstarke und flexible REST-API. Die Effizienz und Markteinführungszeit ähneln Rails.
-
ASP.NET Core MVC - Ein umfangreiches Framework zum Erstellen von Web-Apps und APIs mithilfe des Model-View-Controller-Entwurfsmusters in C# oder F#. Nummer 6 auf TechEmpower Composite Benchmarks für Web-Frameworks.
-
Fastify - [15.4k ⭐] - Ein Node.js-Webframework, das sich stark darauf konzentriert, die beste Entwicklererfahrung mit dem geringsten Overhead und einer leistungsstarken Plugin-Architektur zu bieten.
HagiCode
HagiCode ist ein agentischer Coding-Arbeitsplatz. Vielseitige, komfortable Interaktionen in der Benutzeroberfläche machen Planung, Agent-Ausführung und Projektarbeit zugänglich und leicht nachvollziehbar – für ein ansprechendes Entwicklungserlebnis.
Entdecken Sie ein ansprechendes Entwicklungserlebnis mit vielseitigen, komfortablen Interaktionen in der Benutzeroberfläche.

- IntelligentOpenSpec-Workflows machen aus einer Absicht einen umsetzbaren Weg vom Vorschlag über Design und Aufgaben bis zur Auslieferung.
- EffizientMulti-Agent-Ausführung führt Recherche, Umsetzung und Prüfung parallel aus, über mehrere Repositories und die Agent CLIs, die Sie bereits nutzen.
- InteressantVielseitige, komfortable Interaktionen in der Benutzeroberfläche machen Planung, Agent-Ausführung und Projektarbeit zugänglich und leicht nachvollziehbar.
Für Windows herunterladen
HagiCode teilen

Aus Ideen wird ausgelieferte Software.
HagiCode ist ein agentischer Coding-Arbeitsplatz: OpenSpec-Workflows planen die Änderung, Multi-Agent-Ausführung setzt sie um, und Hero Scenario macht den langen Weg sichtbar, bis aus der Idee ausgelieferte Software wird.
- Intelligent
- OpenSpec-Workflows machen aus einer Absicht einen Weg vom Vorschlag bis zur Auslieferung.
- Effizient
- Multi-Agent-Ausführung treibt Recherche, Umsetzung und Prüfung parallel voran.
- Unterhaltsam
- UI-Interaktionen erleichtern Planung, Agent-Ausführung und Projektarbeit.
© 2026 HagiCode | Powered By hagilight-starlight@0.21.0 | Branch: main | Commit: 745b50b | Built: