
Production Machine Learning
Source: https://github.com/EthicalML/awesome-production-machine-learning at
4efc0a16249c
License: MIT
Read the English original
This edition is an AI-assisted translation.


Awesome Production Machine Learning
Abschnitt betitelt „Awesome Production Machine Learning“Dieses Repository enthält eine kuratierte Liste hervorragender Open-Source-Bibliotheken, mit denen du maschinelles Lernen in der Produktion bereitstellen, überwachen, versionieren, skalieren und absichern kannst 🚀
Du bleibst auf dem Laufenden, wenn du dieses GitHub-Repository beobachtest: Über Releases erhältst du jeden Monat eine Zusammenfassung der neu hinzugefügten Produktions-ML-Bibliotheken 🤩
Zusätzlich bieten wir ein Such-Toolkit, mit dem du dich schnell durch die Toolchain navigieren kannst.
Schnellzugriffe auf die Abschnitte dieser Seite
Abschnitt betitelt „Schnellzugriffe auf die Abschnitte dieser Seite“Zur Liste beitragen
Abschnitt betitelt „Zur Liste beitragen“Bitte beachte beim Einreichen eines PR unsere Anforderungen in CONTRIBUTING.md, damit wir die Liste sauber und aktuell halten können. Vielen Dank an die Community für die stetige Unterstützung und das Wachstum 🚀
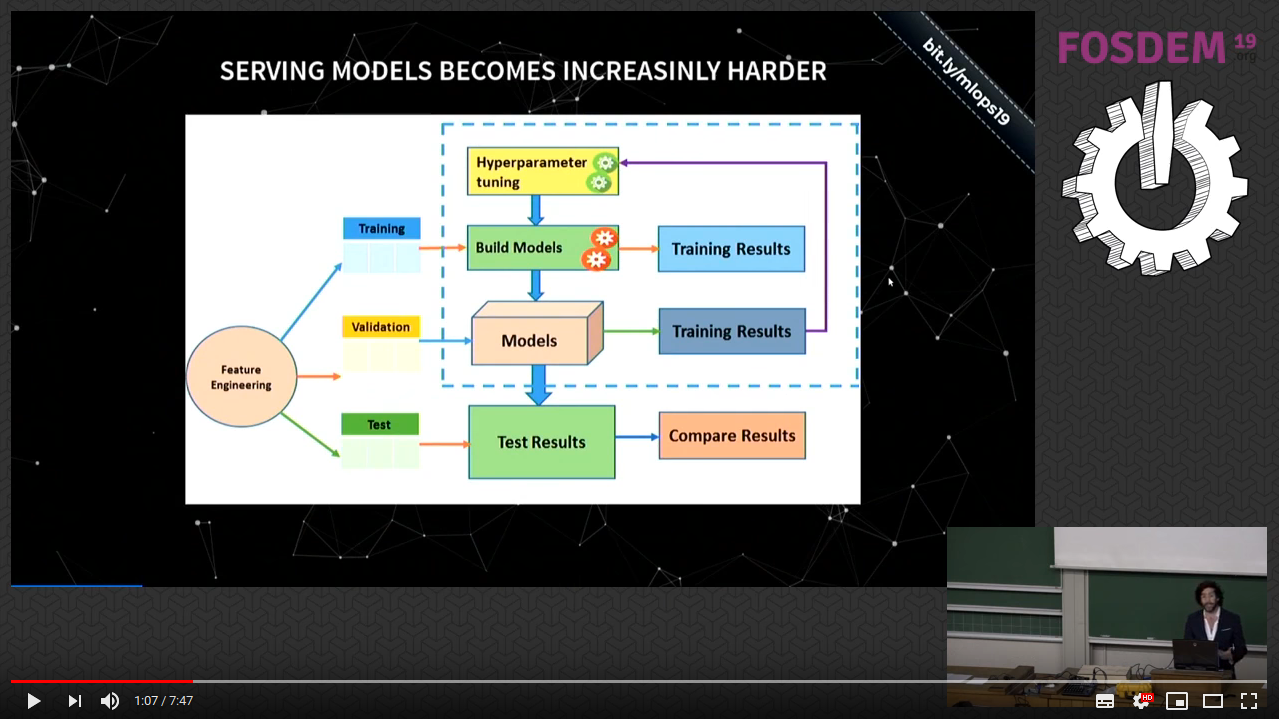
Videoüberblick in 10 Minuten
Abschnitt betitelt „Videoüberblick in 10 Minuten“| Dieses 10-minütige Video gibt einen Überblick über die Beweggründe für Machine Learning Operations sowie über einige der Werkzeuge in diesem Repository. Dieses neuere Video behandelt den aktualisierten Stand von MLOps im Jahr 2024. |
|
Möchtest du regelmäßig Updates zu diesem Repository und anderen Entwicklungen erhalten?
Abschnitt betitelt „Möchtest du regelmäßig Updates zu diesem Repository und anderen Entwicklungen erhalten?“| Du kannst den Newsletter Machine Learning Engineer abonnieren. Schließe dich mehr als 70.000 ML-Fachleuten und -Enthusiasten an, die wöchentlich kuratierte Artikel und Tutorials zu maschinellem Lernen in der Produktion erhalten. |
|
| Sieh dir auch die Liste Awesome Production GenAI an. Dort stellen wir eine kuratierte Auswahl hervorragender Open-Source-Bibliotheken zur Bereitstellung, Überwachung, Versionierung und Skalierung generativer KI-Anwendungen und -Systeme zusammen. |
|
Hauptinhalt
Abschnitt betitelt „Hauptinhalt“- AIDE
 - AIDE ist ein Open-Source-Agent für ML-Engineering, der einen Baumsuchalgorithmus verwendet, um Lösungsstrategien für Aufgaben des maschinellen Lernens autonom zu erkunden, umzusetzen und zu bewerten.
- AutoGluon
 - Automatisierte Auswahl von Merkmalen, Modellen und Hyperparametern für Tabellen-, Bild- und Textdaten auf Basis beliebter Bibliotheken für maschinelles Lernen (Scikit-Learn, LightGBM, CatBoost, PyTorch, MXNet).
- Autokeras
 - AutoML-Bibliothek für Keras auf Grundlage von “Auto-Keras: Efficient Neural Architecture Search with Network Morphism”.
- auto-sklearn
 - Framework zur Automatisierung der Algorithmus- und Hyperparameteroptimierung für sklearn.
- Ax
 - Ax ist eine zugängliche, universell einsetzbare Plattform zum Verstehen, Verwalten, Bereitstellen und Automatisieren adaptiver Experimente.
- BoTorch
 - BoTorch ist eine auf PyTorch aufbauende Bibliothek für Bayes’sche Optimierung.
- EvalML
 - EvalML ist eine AutoML-Bibliothek, die ML-Pipelines mithilfe domänenspezifischer Zielfunktionen erstellt, optimiert und bewertet.
- Feature Engine
 - Feature-engine ist eine Python-Bibliothek mit verschiedenen Transformatoren zur Merkmalsentwicklung für den Einsatz in Modellen des maschinellen Lernens.
- Featuretools
 - Ein Open-Source-Framework für die automatisierte Merkmalsentwicklung.
- FLAML
 - FLAML ist eine schnelle Bibliothek für automatisiertes maschinelles Lernen und Tuning.
- HEBO
 - Sammlung von Open-Source-Frameworks zur Hyperparameteroptimierung, darunter der Siegerbeitrag zur NeurIPS 2020 Black-Box Optimisation Challenge, getestet mit Aufgaben zur Hyperparameteroptimierung.
- Katib
 - Ein Kubernetes-basiertes System für Hyperparameteroptimierung und die Suche nach neuronalen Architekturen.
- keras-tuner
 - Keras Tuner ist ein einfach zu verwendendes, verteilbares Framework zur Hyperparameteroptimierung, das die Schwierigkeiten bei der Hyperparametersuche behebt. Mit Keras Tuner lassen sich Suchräume leicht definieren und die enthaltenen Algorithmen nutzen, um die besten Hyperparameterwerte zu finden.
- Optuna
 - Optuna ist ein Framework für automatische Hyperparameteroptimierung, das speziell für maschinelles Lernen entwickelt wurde.
- OSS Vizier
 - OSS Vizier ist ein Python-basierter Dienst für Black-Box-Optimierung und Forschung und war einer der ersten Hyperparameter-Tuning-Dienste, die für den Einsatz in großem Maßstab konzipiert wurden.
- Perpetual
 - Ein Gradient-Boosting-Verfahren, das keine Hyperparameteroptimierung benötigt; ein einfacher Budgetparameter steuert die Modellkomplexität.
- TPOT
 - Automatisiert die Erstellung von sklearn-Pipelines (einschließlich Merkmalsauswahl, Vorverarbeitung usw.).
- tsfresh
 - Automatische Extraktion relevanter Merkmale aus Zeitreihen.
Computation and Communication Optimisation
Abschnitt betitelt „Computation and Communication Optimisation“- Accelerate
 - Accelerate abstrahiert genau und ausschließlich den Boilerplate-Code für Multi-GPU-/TPU-Betrieb und gemischte Genauigkeit; der übrige Code bleibt unverändert.
- Adapters
 - Adapters ist eine einheitliche Bibliothek für modulare, parametereffiziente Transfer-Learning-Verfahren.
- Cache-DiT
 - Cache-DiT baut auf Diffusers auf und unterstützt nahezu alle DiTs. Die Bibliothek bietet hybride Cache-Beschleunigung (DBCache, TaylorSeer, SCM usw.) sowie umfassende Parallelisierungsoptimierungen, darunter Context Parallelism, Tensor Parallelism und hybride 2D-/3D-Parallelisierung, und ist mit Kompilierung, CPU-Offloading und Quantisierung kompatibel.
- Colossal-AI
 - Ein einheitliches Deep-Learning-System für das Zeitalter großer Modelle, mit dem sich das Training und die Inferenz großer KI-Modelle effizient und schnell bereitstellen lassen.
- Composer
 - Composer ist eine PyTorch-Bibliothek, mit der sich neuronale Netze schneller, kostengünstiger und mit höherer Genauigkeit trainieren lassen.
- CuDF
 - cuDF basiert auf dem spaltenorientierten Apache-Arrow-Speicherformat und ist eine GPU-DataFrame-Bibliothek zum Laden, Verbinden, Aggregieren, Filtern und anderweitigen Bearbeiten von Daten.
- CuML
 - cuML ist eine Sammlung von Bibliotheken, die Algorithmen des maschinellen Lernens und mathematische Primitive mit APIs implementiert, die mit anderen RAPIDS-Projekten kompatibel sind.
- CuPy
 - Eine CUDA-Implementierung mehrdimensionaler Arrays, die mit NumPy kompatibel ist. CuPy umfasst die zentrale mehrdimensionale Array-Klasse cupy.ndarray sowie zahlreiche Funktionen dafür.
- DEAP
 - Ein neuartiges Framework für evolutionäre Berechnung zur schnellen Erstellung von Prototypen und zum Testen von Ideen. Es macht Algorithmen explizit und Datenstrukturen transparent und harmoniert hervorragend mit Parallelisierungsmechanismen wie multiprocessing und SCOOP.
- DeepEP
 - DeepEP ist eine Kommunikationsbibliothek speziell für Mixture-of-Experts (MoE) und Expert Parallelism (EP). Sie stellt GPU-Kernels für All-to-All-Kommunikation mit hohem Durchsatz und geringer Latenz bereit, auch bekannt als MoE Dispatch und Combine. Außerdem unterstützt die Bibliothek Operationen mit geringer Genauigkeit, darunter FP8.
- DGL
 - DGL ist ein benutzerfreundliches, leistungsstarkes und skalierbares Python-Paket für Deep Learning auf Graphen.
- DLRover
 - DLRover macht verteiltes Training großer KI-Modelle einfach, stabil, schnell und ressourcenschonend.
- Dask
 - Framework für verteilte parallele Verarbeitung von Pandas- und NumPy-Berechnungen.
- DeepSpeed
 - DeepSpeed ist eine Optimierungsbibliothek für Deep Learning, die verteiltes Training und Inferenz einfach, effizient und effektiv macht.
- FlagGems
 - FlagGems ist eine leistungsstarke, universell einsetzbare Operatorbibliothek, implementiert mit OpenAI Triton. Sie baut auf einer Sammlung backendneutraler Kernels auf, die das Training und die Inferenz von LLMs auf unterschiedlichen Hardwareplattformen beschleunigen sollen.
- Flashlight
 - Eine schnelle, flexible ML-Bibliothek, vollständig in C++ geschrieben, von Facebook AI Research und den Entwicklern von Torch, TensorFlow, Eigen und Deep Speech.
- Flax
 - Eine auf Flexibilität ausgelegte Bibliothek für neuronale Netze samt Ökosystem für JAX.
- GPUStack
 - GPUStack ist ein Open-Source-Manager für GPU-Cluster zum Ausführen von KI-Modellen.
- Hivemind
 - Dezentrales Deep Learning mit PyTorch.
- Jax
 - Kombinierbare Transformationen von Python- und NumPy-Programmen: differenzieren, vektorisieren, per JIT für GPU/TPU kompilieren und mehr.
- Kompute
 - Ein blitzschnelles, leichtgewichtiges und mobilgerätetaugliches Vulkan-Compute-Framework, optimiert für fortgeschrittene GPU-Datenverarbeitung.
- Liger Kernel
 - Liger Kernel ist eine Sammlung von Triton-Kernels, die speziell für das Training von LLMs entwickelt wurden.
- LightGBM
 - LightGBM ist ein Gradient-Boosting-Framework, das baumbasierte Lernalgorithmen verwendet.
- MLX
 - MLX ist ein Array-Framework für maschinelles Lernen auf Apple-Silicon.
- Modin
 - Beschleunige deine Pandas-Workflows mit nur einer Codezeile.
- NVIDIA TensorRT
 - TensorRT ist eine C++-Bibliothek für leistungsstarke Inferenz auf NVIDIA-GPUs und Deep-Learning-Beschleunigern.
- Nevergrad
 - Nevergrad ist eine Plattform für gradientenfreie Optimierung.
- Norse
 - Norse soll die Vorteile bioinspirierter neuronaler Komponenten nutzen, die dünn besetzt und ereignisgesteuert sind – ein grundlegender Unterschied zu künstlichen neuronalen Netzen.
- Numba
 - Ein Compiler für Python-Array- und numerische Funktionen.
- Optimum
 - Optimum ist eine Erweiterung von Transformers und Diffusers und bietet Optimierungswerkzeuge, mit denen sich Modelle auf bestimmter Hardware möglichst effizient trainieren und ausführen lassen, ohne die einfache Bedienung aufzugeben.
- PEFT
 - Verfahren für Parameter-Efficient Fine-Tuning (PEFT) ermöglichen die effiziente Anpassung vortrainierter Sprachmodelle (PLMs) an verschiedene nachgelagerte Anwendungen, ohne alle Modellparameter feinabzustimmen.
- PaddlePaddle
 - PaddlePaddle ist ein Framework für das Training großer neuronaler Netze mit Datenquellen, die auf Hunderte von Knoten verteilt sind.
- PyG
 - PyG (PyTorch Geometric) baut auf PyTorch auf und erleichtert das Schreiben und Trainieren neuronaler Graphennetze (GNNs) für vielfältige Anwendungen mit strukturierten Daten.
- PyTorch Lightning
 - PyTorch Lightning trainiert vor und feinab, und stellt KI-Modelle auf mehreren GPUs und TPUs bereit – ohne Änderungen am Code.
- PyTorch
 - PyTorch ist eine Bibliothek zum Entwickeln und Trainieren neuronaler Deep-Learning-Modelle.
- Ray
 - Ray ist ein flexibles, leistungsstarkes Framework für verteilte Ausführung im maschinellen Lernen.
- SetFit
 - SetFit ist ein effizientes, promptfreies Framework für Few-Shot-Fine-Tuning von Sentence Transformers.
- Sonnet
 - Sonnet baut auf TensorFlow 2 auf und bietet einfache, kombinierbare Abstraktionen für die ML-Forschung.
- Streaming
 - Eine Bibliothek für Datenstreaming zum effizienten Training neuronaler Netze.
- TensorFlow
 - TensorFlow ist eine führende Bibliothek zur Entwicklung und Bereitstellung hochmoderner Anwendungen für maschinelles Lernen.
- ThunderKittens
 ThunderKittens ist ein Framework, das das Schreiben schneller Deep-Learning-Kernels in CUDA erleichtert.
- TorchOpt
 - TorchOpt ist eine effiziente Bibliothek für differenzierbare Optimierung auf Basis von PyTorch.
- Triton
 - Triton ist eine Sprache und ein Compiler zum Schreiben hocheffizienter, benutzerdefinierter Deep-Learning-Primitiven. Ziel von Triton ist eine Open-Source-Umgebung, in der sich schneller Code produktiver als mit CUDA und zugleich flexibler als mit anderen vorhandenen DSLs schreiben lässt.
- Vaex
 Vaex ist eine leistungsstarke Python-Bibliothek für verzögerte Out-of-Core-DataFrames (ähnlich wie Pandas), um große tabellarische Datensätze zu visualisieren und zu erkunden. Vaex nutzt Memory Mapping, kopierfreien Speicherzugriff und verzögerte Berechnungen für maximale Leistung (ohne Speicher zu verschwenden).
- Vowpal Wabbit
 Vowpal Wabbit ist ein System für maschinelles Lernen, das mit Techniken wie Online-Lernen, Hashing, Allreduce, Reduktionen, Learning to Search sowie aktivem und interaktivem Lernen neue Maßstäbe setzt.
- XGBoost
 - XGBoost ist eine optimierte, verteilte Gradient-Boosting-Bibliothek, die auf hohe Effizienz, Flexibilität und Portabilität ausgelegt ist.
- YDF
 - YDF (Yggdrasil Decision Forests) ist eine Bibliothek zum Trainieren, Bewerten, Interpretieren und Bereitstellen von Random-Forest-, Gradient-Boosted-Decision-Tree-, CART- und Isolation-Forest-Modellen.
- bitsandbytes
 - Die Bitsandbytes-Bibliothek ist ein schlanker Python-Wrapper für benutzerdefinierte CUDA-Funktionen, insbesondere für 8-Bit-Optimierer, Matrixmultiplikation (LLM.int8()) und 8- sowie 4-Bit-Quantisierung.
- einops
 - Flexible und leistungsstarke Tensoroperationen für lesbaren und zuverlässigen Code.
- scikit-learn
 - Scikit-learn ist eine leistungsstarke Bibliothek für maschinelles Lernen mit zahlreichen Modulen für Datenzugriff, Datenaufbereitung und statistische Modellbildung.
- snnTorch
 - snnTorch ist eine Bibliothek für Deep Learning und Online-Lernen mit Spiking Neural Networks.
- torchdistill
 - torchdistill bietet verschiedene hochmoderne Knowledge-Distillation-Verfahren und ermöglicht das Entwerfen neuer Experimente durch Bearbeiten einer deklarativen YAML-Konfigurationsdatei statt Python-Code.
- torchkeras
 Die torchkeras-Bibliothek ist ein einfaches Werkzeug, um neuronale Netze in PyTorch im Keras-Stil zu trainieren.
- veScale
 - veScale ist ein natives LLM-Trainingsframework für PyTorch.
- yellowbrick
 - yellowbrick bietet auf matplotlib basierende Diagramme zur Modellbewertung für scikit-learn und andere Bibliotheken für maschinelles Lernen.
Data Annotation and Synthesis
Abschnitt betitelt „Data Annotation and Synthesis“- Argilla
 - Argilla hilft Fachexpertinnen und Fachexperten sowie Datenteams, in kürzerer Zeit bessere NLP-Datensätze zu erstellen.
- cleanlab
 - Python-Bibliothek für datenzentrierte KI. Sie kann automatisch fehlerhaft beschriftete Daten finden, Ausreißer erkennen, Konsens und Annotationsqualität für Datensätze mit mehreren Annotierenden schätzen und vorschlagen, welche Daten als Nächstes (erneut) annotiert werden sollten.
- COCO Annotator
 - Webbasiertes Bildsegmentierungswerkzeug für Objekterkennung, Lokalisierung und Keypoints.
- CVAT
 - CVAT (Computer Vision Annotation Tool) ist OpenCVs webbasiertes Annotationswerkzeug für Videos und Bilder für Computeralgorithmen.
- Doccano
 - Open-Source-Werkzeuge für die manuelle Textannotation mit Funktionen für Sentimentanalyse, Erkennung benannter Entitäten und maschinelle Übersetzung.
- Label Studio
 - Domänenübergreifendes Werkzeug zur Datenkennzeichnung und Annotation mit standardisiertem Ausgabeformat.
- LightlyStudio
 - Ein Open-Source-Werkzeug zum Kuratieren, Annotieren und Verwalten von Bild- und Videodatensätzen. Es unterstützt embeddingbasierte automatische Auswahl, Annotation und automatische Beschriftung von Begrenzungsrahmen und Segmentierungen.
- NeMo Curator
 - NeMo Curator ist ein GPU-beschleunigtes Framework zur effizienten Kuratierung von Daten für große Sprachmodelle.
- refinery
 - Die Open-Source-Lösung der Data-Science-Community zum Skalieren, Bewerten und Pflegen von Sprachdaten.
- SDV
 - Synthetic Data Vault (SDV) ist ein Ökosystem von Bibliotheken zur Erzeugung synthetischer Daten. Damit lassen sich Einzeltabellen-, Mehrtabellen- und Zeitreihendatensätze einfach erlernen, um anschließend synthetische Daten zu erzeugen, die dasselbe Format und dieselben statistischen Eigenschaften wie die ursprünglichen Datensätze aufweisen.
- Semantic Segmentation Editor
 - Hitachis Open-Source-Werkzeug zur Kennzeichnung von Kamera- und LIDAR-Daten.
- synthcity
 - synthcity ist eine Bibliothek zur Erzeugung und Bewertung synthetischer Tabellendaten.
- TabGAN
 - Erzeugung synthetischer Tabellendaten mit GANs (CTGAN), Diffusionsmodellen und LLMs sowie adversarialem Filtern, Datenschutzmetriken und sklearn-Integration.
- ViPE
 - ViPE ist ein Spatial-AI-Werkzeug zur Annotation von Kameraposen und dichten Tiefenkarten aus unbearbeiteten Videos.
- YData Synthetic
 - YData Synthetic ist ein Paket zur Erzeugung synthetischer Tabellen- und Zeitreihendaten mithilfe modernster generativer Modelle.
Data Pipeline
Abschnitt betitelt „Data Pipeline“- Apache Airflow
 - In Python entwickeltes Framework für Datenpipelines mit Scheduler, DAG-Definition und Benutzeroberfläche zur Visualisierung.
- Apache Nifi
 - Apache NiFi wurde für Datenflüsse entwickelt. Es unterstützt hochgradig konfigurierbare gerichtete Graphen für Datenweiterleitung, Transformation und Systemvermittlung.
- Argo Workflows
 - Argo Workflows ist eine Open-Source-Workflow-Engine für containerbasierte Orchestrierung paralleler Jobs auf Kubernetes. Argo Workflows ist als Kubernetes-CRD (Custom Resource Definition) implementiert.
- Couler
 - Einheitliche Schnittstelle zum Erstellen und Verwalten von Workflows für maschinelles Lernen auf unterschiedlichen Workflow-Engines wie Argo Workflows, Tekton Pipelines und Apache Airflow.
- DataTrove
 - DataTrove ist eine Bibliothek zur Verarbeitung, Filterung und Deduplizierung von Textdaten in sehr großem Maßstab.
- Dagster
 - Ein Datenorchestrator für maschinelles Lernen, Analytik und ETL.
- DBT
 - ETL-Werkzeug zum Ausführen von Transformationen in Data Warehouses.
- Flyte
 - Lyfts cloudnatives ML- und Datenverarbeitungsframework – (Demo).
- Genie
 - Eine Job-Orchestrierungs-Engine zur Anbindung an Hadoop-basierte Systeme und zum Auslösen der Ausführung von Jobs.
- Hamilton
 - Hamilton ist ein Micro-Orchestrierungsframework zur Definition von Datenflüssen. Es läuft überall dort, wo Python ausgeführt werden kann (z. B. in Jupyter, FastAPI, Spark, Ray und Dask). Es vermittelt Best Practices der Softwareentwicklung, ohne dass man sich darum kümmern muss. Es dient zur Definition von Transformationen für die Merkmalsentwicklung, durchgängigen Modellpipelines und LLM-Workflows. Als Ergänzung zu Makro-Orchestrierungssystemen (z. B. Kedro, Luigi, Airflow und dbt) ersetzt es den Code innerhalb ihrer Makroaufgaben. Die selbst hostbare Benutzeroberfläche erfasst Lineage und Herkunft, Ausführungs-Telemetrie und Datenzusammenfassungen und erstellt einen sich selbst befüllenden Katalog; sie kann sowohl in der Entwicklung als auch in der Produktion eingesetzt werden.
- Instill VDP
 - Instill VDP (Versatile Data Pipeline) soll Datenverarbeitungspipelines von der ersten Idee bis zum Abschluss vereinfachen.
- Instructor
 - Mit Instructor lassen sich strukturierte Daten wie JSON einfach aus LLMs wie GPT-3.5, GPT-4, GPT-4-Vision und Open-Source-Modellen beziehen.
- Kedro
 - Kedro ist ein Werkzeug zur Workflow-Entwicklung, mit dem sich robuste, skalierbare, bereitstellbare, reproduzierbare und versionierte Datenpipelines erstellen lassen.
- Luigi
 - Luigi ist ein Python-Modul, mit dem sich komplexe Pipelines aus Batch-Jobs erstellen lassen; es übernimmt die Auflösung von Abhängigkeiten, Workflow-Verwaltung, Visualisierung usw.
- Metaflow
 - Ein Framework, mit dem Data Scientists praxisnahe Data-Science-Projekte einfach erstellen und verwalten können.
- Pachyderm
 - Verteiltes Open-Source-Verarbeitungsframework auf Kubernetes, das vor allem auf die dynamische Erstellung produktionsreifer Pipelines für maschinelles Lernen ausgelegt ist – (Video).
- Pixeltable
 – Open-Source-Python-Bibliothek mit deklarativer, inkrementeller Dateninfrastruktur zum Erstellen und Verwalten multimodaler KI-Workloads.
- Prefect Core
 - Workflow-Verwaltungssystem, mit dem sich Datenpipelines einfach um Funktionen wie Wiederholungsversuche, Protokollierung, dynamisches Mapping, Caching und Fehlermeldungen ergänzen lassen.
- SeqIO
 - SeqIO ist eine Bibliothek zur Verarbeitung sequenzieller Daten, die an nachgelagerte Sequenzmodelle übergeben werden.
- Snakemake
 - Workflow-Verwaltungssystem für reproduzierbare und skalierbare Datenanalysen.
- Towhee
 - Universell einsetzbare Pipeline für maschinelles Lernen zur Erzeugung von Embedding-Vektoren mit einem oder mehreren ML-Modellen.
- unstructured
 - unstructured vereinfacht und optimiert die Datenverarbeitung für LLMs: Es nimmt Bilder und Textdokumente wie PDFs, HTML- und Word-Dateien sowie viele weitere Formate auf und verarbeitet sie vor.
- ZenML
 - ZenML ist ein erweiterbares Open-Source-MLOps-Framework zum Erstellen reproduzierbarer ML-Pipelines. Schwerpunkte sind automatisierte Metadatenerfassung, Caching und zahlreiche Integrationen mit anderen Werkzeugen.
Data Science Notebook
Abschnitt betitelt „Data Science Notebook“- Apache Zeppelin
 - Webbasiertes Notebook für datengestützte, interaktive Datenanalysen und kollaborative Dokumente mit SQL, Scala und mehr.
- Deepnote
 - Deepnote ist ein direkter Ersatz für Jupyter mit KI-zentriertem Design, eleganter Benutzeroberfläche, neuen Blöcken und nativen Datenintegrationen. Verwende Python, R und SQL lokal in deiner bevorzugten IDE und wechsle anschließend zur Deepnote-Cloud für Zusammenarbeit in Echtzeit, den Deepnote-Agenten und bereitstellbare Daten-Apps.
- Jupyter Notebooks
 - Weboberfläche für Python-Sandbox-Umgebungen zur reproduzierbaren Entwicklung.
- Marimo
 - Reaktives Python-Notebook: reproduzierbare Experimente ausführen, als Skript starten, als App bereitstellen und mit Git versionieren.
- Papermill
 - Papermill ist eine Bibliothek zum Parametrisieren von Notebooks und Ausführen dieser wie Python-Skripte.
- Polynote
 - Polynote ist eine experimentelle mehrsprachige Notebook-Umgebung. Derzeit unterstützt sie Scala und Python (mit oder ohne Spark), SQL und Vega.
- RMarkdown
 - Das Paket rmarkdown ist eine Implementierung der nächsten Generation von R Markdown auf Grundlage von Pandoc.
- Stencila
 - Stencila ist eine Plattform zum Erstellen, gemeinsamen Bearbeiten und Teilen datengesteuerter Inhalte, die transparent und reproduzierbar sind.
- Voilà
 - Voilà verwandelt Jupyter-Notebooks in eigenständige Webanwendungen, die beispielsweise als Dashboards dienen können.
Data Storage Optimisation
Abschnitt betitelt „Data Storage Optimisation“- AIStore
 - AIStore ist ein leichtgewichtiges Objektspeichersystem, das sich mit jedem hinzugefügten Speicherknoten linear skalieren lässt und besonders auf Deep Learning im Petabyte-Maßstab ausgerichtet ist.
- Alluxio
 - Ein virtuelles verteiltes Speichersystem, das die Lücke zwischen Rechenframeworks und Speichersystemen schließt.
- Apache Arrow
 - Spaltenorientierte In-Memory-Darstellung von Daten, kompatibel mit Pandas, Hadoop-basierten Systemen usw.
- Apache Druid
 - Eine leistungsstarke Echtzeit-Analysedatenbank. Eine Einführung bietet dieser Artikel.
- Apache Hudi
 - Hudi ist eine transaktionale Data-Lake-Plattform, die zentrale Funktionen von Data Warehouses und Datenbanken direkt in einen Data Lake bringt. Hudi eignet sich hervorragend für Streaming-Workloads und ermöglicht außerdem effiziente inkrementelle Batch-Pipelines. Unterstützt beliebte Abfrage-Engines wie Spark, Flink, Presto, Trino, Hive usw. Weitere Informationen hier.
- Apache Iceberg
 - Iceberg ist ein ACID-konformes, leistungsstarkes Format für riesige Analysetabellen mit bis zu Dutzenden Petabytes an Daten. Es bringt die Zuverlässigkeit und Einfachheit von SQL-Tabellen in Big Data und ermöglicht es Engines wie Spark, Trino, Flink, Presto, Hive und Impala, sicher und gleichzeitig mit denselben Tabellen zu arbeiten. Weitere Informationen hier.
- Apache Ignite
 - Eine speicherzentrierte verteilte Datenbank-, Caching- und Verarbeitungsplattform für transaktionale, analytische und Streaming-Workloads, die In-Memory-Geschwindigkeit im Petabyte-Maßstab bietet – Demo.
- Apache Parquet
 - Spaltenorientierte Datendarstellung auf Festplatte, kompatibel mit Pandas, Hadoop-basierten Systemen usw.
- Apache Pinot
 - Ein verteiltes OLAP-Datenspeichersystem für Echtzeitdaten. Ein Vergleich der Open-Source-OLAP-Systeme für Big Data – ClickHouse, Druid und Pinot – findet sich hier.
- Casibase
 - Casibase ist eine LangChain-ähnliche RAG-Wissensdatenbank (Retrieval-Augmented Generation) mit Weboberfläche und Enterprise-SSO.
- Chroma
 - Chroma ist eine Open-Source-Datenbank für Embeddings.
- ClickHouse
 - ClickHouse ist ein spaltenorientiertes Open-Source-Datenbankverwaltungssystem.
- Delta Lake
 - Delta Lake ist eine Speicherschicht, die skalierbare ACID-Transaktionen für Apache Spark und andere Big-Data-Engines bereitstellt.
- EdgeDB
 - Gel erweitert Postgres um ein modernes Datenmodell, Graphabfragen, Authentifizierungs- und KI-Lösungen und vieles mehr.
- GPTCache
 - GPTCache ist eine Bibliothek zum Erstellen semantischer Caches für Abfragen an große Sprachmodelle.
- InfluxDB
 Skalierbarer Datenspeicher für Metriken, Ereignisse und Echtzeitanalysen.
- Milvus
 Milvus ist eine cloudnative Open-Source-Vektordatenbank zur Verwaltung von Embedding-Vektoren, die von Modellen des maschinellen Lernens und neuronalen Netzen erzeugt werden.
- Marqo
 Marqo ist eine durchgängige Vektorsuchmaschine.
- pgvector
 pgvector ermöglicht die Ähnlichkeitssuche von Vektoren in Postgres.
- PostgresML
 PostgresML ist eine Erweiterung für maschinelles Lernen für PostgreSQL, mit der sich Training und Inferenz für Text- und Tabellendaten mithilfe von SQL-Abfragen ausführen lassen.
- Redis
 Redis ist ein Open-Source-In-Memory-Datenspeicher mit Unterstützung für Vektorähnlichkeitssuche und eignet sich dadurch für KI-/ML-Anwendungen wie semantische Suche und Empfehlungssysteme.
- Safetensors
 Einfache und sichere Möglichkeit zum Speichern und Verteilen von Tensoren.
- TimescaleDB
 Open-Source-SQL-Datenbank für Zeitreihen, als PostgreSQL-Erweiterung paketiert und für schnelles Erfassen sowie komplexe Abfragen optimiert – (Video).
- Weaviate
 - Eine Vektorsuchmaschine mit geringer Latenz (GraphQL, REST), die verschiedene Medientypen standardmäßig unterstützt. Zu den Modulen gehören semantische Suche, Fragen und Antworten, Klassifizierung, anpassbare Modelle (PyTorch/TensorFlow/Keras) und mehr.
- Zarr
 - Python-Implementierung gekachelter, komprimierter N-dimensionaler Arrays zur Verwendung in der parallelen Datenverarbeitung.
Data Stream Processing
Abschnitt betitelt „Data Stream Processing“- Apache Beam
 Apache Beam ist ein einheitliches Programmiermodell für Batch- und Streaming-Verarbeitung.
- Apache Flink
 - Open-Source-Framework für Stream-Verarbeitung mit leistungsstarken Funktionen für Stream- und Batch-Verarbeitung.
- Apache Kafka
 - Kafka-Clientbibliothek zum Erstellen von Anwendungen und Microservices, deren Ein- und Ausgaben in Kafka-Clustern gespeichert werden.
- Apache Samza
 - Framework für verteilte Stream-Verarbeitung. Es verwendet Apache Kafka für die Nachrichtenübermittlung und Apache Hadoop YARN für Fehlertoleranz, Prozessisolierung, Sicherheit und Ressourcenverwaltung.
- Apache Spark
 - Mikro-Batch-Verarbeitung von Streams mit dem Apache-Spark-Framework als Backend und Unterstützung zustandsbehafteter Exactly-once-Semantik.
- Bytewax
 - Flexibles, Python-zentriertes Framework für zustandsbehaftete Stream-Verarbeitung auf Basis einer Rust-Engine.
- FastStream
 - Modernes, brokerunabhängiges Python-Framework für Streaming mit Unterstützung der Protokolle Apache Kafka, RabbitMQ und NATS. Inspiriert von FastAPI und einfach in andere Webframeworks integrierbar.
- MOA
 - MOA (Massive Online Analysis) ist ein Open-Source-Framework für Stream-Mining mit Big Data.
- MosaicML Streaming - Schnelles, deterministisches Streaming großer Datensätze aus Cloud-Speichern für verteiltes Modelltraining.
- RisingWave
 - Eine verteilte SQL-Streaming-Datenbank, die Stream-Verarbeitung und Serving mit geringer Latenz vereint – ideal zum Erstellen und Bereitstellen von Features für Online-ML.
- TensorStore
 - Bibliothek zum Lesen und Schreiben großer mehrdimensionaler Arrays.
Deployment and Serving
Abschnitt betitelt „Deployment and Serving“- Agenta
 - Agenta bietet durchgängige Werkzeuge für den gesamten LLMOps-Workflow: Entwicklung (LLM-Playground, Evaluierung), Bereitstellung (Prompt- und Konfigurationsverwaltung) sowie Observability und Tracing für LLMs.
- AirLLM
 - AirLLM optimiert den Speicherbedarf der Inferenz, sodass große Sprachmodelle mit 70 Milliarden Parametern ohne Quantisierung, Distillation oder Pruning auf einer einzelnen 4-GB-GPU ausgeführt werden können.
- AITemplate
 - AITemplate (AIT) ist ein Python-Framework, das tiefe neuronale Netze in CUDA- (NVIDIA-GPU-) bzw. HIP- (AMD-GPU-)C++-Code für extrem schnelle Inferenzbereitstellung umwandelt.
- BentoML
 - BentoML ist ein Open-Source-Framework für die leistungsstarke Bereitstellung von ML-Modellen.
- Bifrost
 - KI-Gateway mit einer einzelnen OpenAI-kompatiblen API für mehr als 23 LLM-Anbieter, automatischen Fallbacks, Lastverteilung, semantischem Caching, Budgetverwaltung und Prometheus-Metriken.
- BISHENG
 - BISHENG ist eine offene DevOps-Plattform für LLM-Anwendungen mit Schwerpunkt auf Unternehmensszenarien.
- CosmoEdge
 - Eine C++-Engine für Video-KI am Edge für den Produktionseinsatz, die RTSP-Aufnahme, CV-/VLM-Inferenz, visuelle Orchestrierung, Alarme und Ereignisübermittlung auf Sophon- und Rockchip-NPUs vereint.
- DeepDetect
 - Produktionsserver für maschinelles Lernen mit TensorFlow-, XGBoost- und Cafe-Modellen, in C++ geschrieben und von Jolibrain gepflegt.
- Dynamo
 - NVIDIA Dynamo ist ein Inferenzframework mit hohem Durchsatz und geringer Latenz für generative KI- und Reasoning-Modelle in verteilten Umgebungen mit mehreren Knoten.
- exo
 - exo hilft dir, mit alltäglichen Geräten deinen eigenen KI-Cluster zu Hause zu betreiben.
- Genkit
 - Genkit ist ein Open-Source-Framework zum Erstellen KI-gestützter Apps mit vertrauten, codezentrierten Mustern. Es erleichtert die Entwicklung, Integration und das Testen von KI-Funktionen mit Observability und Evaluierungen.
- GoModel
 - GoModel ist ein selbst gehostetes, in Go geschriebenes KI-Gateway mit einer einheitlichen OpenAI-kompatiblen API für OpenAI, Anthropic, Gemini, Groq, xAI, Ollama und weitere Anbieter; es bietet Routing, Nutzungs-Tracking, Ratenbegrenzungen und Schutzmechanismen.
- Inference
 - Ein schneller, produktionsreifer Inferenzserver für Computer Vision, der die Bereitstellung zahlreicher beliebter Modellarchitekturen und feinabgestimmter Modelle unterstützt. Mit Inference lassen sich Modelle wie YOLOv5, YOLOv8, CLIP, SAM und CogVLM mithilfe von Docker auf eigener Hardware bereitstellen.
- Infinity
 - Infinity ist eine REST-API mit hohem Durchsatz und geringer Latenz zur Bereitstellung von Text-Embeddings, Reranking-Modellen und CLIP.
- LiteLLM
 - LiteLLM ist ein Python-SDK und Proxyserver (LLM-Gateway), um mehr als 100 LLM-APIs im OpenAI-Format aufzurufen – Bedrock, Azure, OpenAI, VertexAI, Cohere, Anthropic, Sagemaker, HuggingFace, Replicate und Groq.
- LiteRT
 - LiteRT (früher TensorFlow Lite) ist Googles leistungsstarke Laufzeitumgebung für KI-Inferenz auf Geräten und ermöglicht die Bereitstellung von ML-Modellen auf Mobilgeräten, eingebetteten Systemen und Edge-Geräten.
- LiteRT-LM
 - LiteRT-LM ist Googles produktionsreifes, leistungsstarkes Inferenzframework zur Bereitstellung großer Sprachmodelle auf Edge-Geräten. Es unterstützt Android, iOS, Web, Desktop und IoT.
- LitServe
 - LitServe ist eine flexible, auf FastAPI aufbauende Serving-Engine für KI-Modelle. Sie unterstützt benutzerdefinierte Inferenz-Engines für Modelle, Agenten, multimodale Systeme, RAG und komplexe ML-Pipelines.
- jevos
 - jevos ist eine Open-Source-Alternative zu TypeSafes Jev für Ja/Nein-Entscheidungen: ein binärer Klassifikator mit 1 Milliarde Parametern (GGUF, llama.cpp), der über eine Jev-kompatible FastAPI-HTTP-API bereitgestellt wird und ausschließlich auf der CPU eines Laptops läuft.
- Jina-serve
 - Jina-serve ist ein Framework zum Erstellen und Bereitstellen von KI-Diensten, die über gRPC, HTTP und WebSockets kommunizieren.
- Kiln
 - Kiln ist ein Open-Source-Werkzeug zum Feinabstimmen von LLMs, Erzeugen synthetischer Daten und gemeinsamen Bearbeiten von Datensätzen.
- KServe
 - KServe stellt eine Kubernetes Custom Resource Definition zur Bereitstellung prädiktiver und generativer ML-Modelle bereit.
- KTransformers
 - KTransformers ist ein flexibles Framework, um modernste Optimierungen für LLM-Inferenz zu nutzen.
- Langtrace
 - Langtrace ist ein Open-Source-Observability-Werkzeug auf Basis von OpenTelemetry, das LLM-Anwendungen durchgängig überwacht und Echtzeit-Tracing, Evaluierungen und Metriken für beliebte LLMs, LLM-Frameworks, Vektordatenbanken und mehr bereitstellt.
- Lepton AI
 - Mit der Python-Bibliothek LeptonAI lässt sich ganz einfach aus Python-Code ein KI-Dienst erstellen.
- LightLLM
 - LightLLM ist ein Python-basiertes Framework für Inferenz und Bereitstellung großer Sprachmodelle, das sich durch sein leichtgewichtiges Design, einfache Skalierbarkeit und hohe Geschwindigkeit auszeichnet.
- llama.cpp
 - llama.cpp ist eine Open-Source-Softwarebibliothek, die Inferenz für verschiedene große Sprachmodelle wie Llama ausführt.
- llmfit
 - Ein Terminalwerkzeug, das LLM-Modelle passend zu RAM, CPU und GPU deines Systems auswählt. Es erkennt die Hardware, bewertet jedes Modell nach Qualität, Geschwindigkeit, Passform und Kontext und zeigt, welche Modelle auf deinem Rechner tatsächlich gut laufen.
- LMCache
 - LMCache ist eine leistungsstarke KV-Cache-Schicht, die die LLM-Inferenz beschleunigt.
- LMDeploy
 - LMDeploy ist ein Toolkit zum Komprimieren, Bereitstellen und Ausführen von LLMs.
- LM Studio
 - LM Studio ist ein Werkzeug, um LLM-Modelle lokal auf dem Computer bereitzustellen – auch auf relativ leistungsschwachen Geräten, sofern sie die Mindestanforderungen erfüllen.
- LocalAI
 - LocalAI ist eine REST-API als direkter Ersatz, die mit den OpenAI-API-Spezifikationen für lokale Inferenz kompatibel ist.
- MindsDB
 - MindsDB ist eine Plattform zum Erstellen, Bereitstellen und Feinabstimmen von Modellen in Echtzeit auf Basis deiner Datenbanken, Vektorspeicher und Anwendungsdaten.
- mini-sglang
 - mini-sglang ist ein leichtgewichtiges und effizientes Serving-Framework für große Sprachmodelle.
- MLRun
 MLRun ist ein offenes MLOps-Framework zur schnellen Erstellung und Verwaltung kontinuierlicher ML- und generativer KI-Anwendungen über ihren gesamten Lebenszyklus hinweg.
- MLServer
 - Ein Inferenzserver für ML-Modelle mit Unterstützung für mehrere Frameworks, Multi-Model-Serving und mehr.
- Model Runner
 - Docker Model Runner erleichtert die Verwaltung, Ausführung und Bereitstellung von KI-Modellen mit Docker. Unterstützt werden LLMs und andere KI-Modelle, die direkt von Docker Hub oder einer beliebigen OCI-kompatiblen Registry abgerufen werden.
- Mosec
 - Ein von Rust angetriebener, mehrstufiger, pipelinierter Modellserver mit dynamischem Batching und mehr. Besonders einfach als Microservice zu implementieren und bereitzustellen.
- nano-vllm
 - nano-vllm ist eine von Grund auf entwickelte, leichtgewichtige vLLM-Implementierung für schnelle Offline-Inferenz mit Optimierungen wie Prefix-Caching, Tensor-Parallelisierung und CUDA-Graphen.
- nndeploy
 - Ein benutzerfreundliches und leistungsstarkes Framework zur Bereitstellung von KI.
- Nuclio
 - Ein leistungsstarkes „serverloses“ Framework mit Schwerpunkt auf daten-, I/O- und rechenintensiven Workloads. Es ist gut in beliebte Data-Science-Werkzeuge wie Jupyter und Kubeflow integriert, unterstützt verschiedene Daten- und Streamingquellen und kann auf CPUs und GPUs ausgeführt werden.
- OpenLLM
 - OpenLLM ermöglicht Entwicklerinnen und Entwicklern, beliebige Open-Source-LLMs (Llama 3.1, Qwen2, Phi3 und weitere) oder eigene Modelle mit nur einem Befehl als OpenAI-kompatible APIs auszuführen.
- OpenVINO
 - OpenVINO ist ein Open-Source-Toolkit zur Optimierung und Bereitstellung von KI-Inferenz.
- Open WebUI
 - Open WebUI ist eine erweiterbare, funktionsreiche und benutzerfreundliche, selbst gehostete KI-Plattform, die vollständig offline betrieben werden kann. Sie unterstützt verschiedene LLM-Laufzeitumgebungen wie Ollama und OpenAI-kompatible APIs und verfügt über eine integrierte Inferenz-Engine für RAG – eine leistungsstarke Lösung zur Bereitstellung von KI.
- OptiLLM
 - OptiLLM ist ein mit der OpenAI-API kompatibler Proxy zur Optimierung der Inferenz. Er implementiert mehr als 20 hochmoderne Verfahren, um Genauigkeit und Leistung von LLMs bei Reasoning-Aufgaben deutlich zu verbessern – ohne Training oder Feinabstimmung von Modellen.
- PowerInfer
 - PowerInfer ist eine Inferenz-Engine für LLMs auf CPU und GPU, die Aktivitätslokalität für dein Gerät nutzt.
- Prompt2Model
 - Prompt2Model ist ein System, das eine natürlichsprachliche Aufgabenbeschreibung (wie Prompts für LLMs wie ChatGPT) entgegennimmt und ein kleines, spezialisiertes Modell trainiert, das sich für die Bereitstellung eignet.
- RamaLama
 - RamaLama ist ein Open-Source-Werkzeug, das die lokale Nutzung und Bereitstellung von KI-Modellen für Inferenz über OCI-Container vereinfacht und die Konfiguration des Hostsystems überflüssig macht.
- RunAnywhere
 - RunAnywhere ist ein produktionsreifes SDK, um KI-Modelle (LLMs, Spracherkennung und Sprachsynthese) auf iOS, Android, React Native und Flutter direkt auf dem Gerät auszuführen – für private, offlinefähige und schnelle mobile KI-Anwendungen.
- Seldon Core
 - Open-Source-Plattform zur Bereitstellung von Modellen für maschinelles Lernen in Kubernetes – (Video).
- SGLang
 - SGLang ist ein schnelles Serving-Framework für große Sprachmodelle und Vision-Language-Modelle.
- SIE
 - Open-Source-Inferenzserver und Produktionscluster für Embeddings, Reranking und Extraktion. Über 85 vorkonfigurierte Modelle für dichte, dünn besetzte und Multi-Vektor-Embeddings, Bildverarbeitung, Reranking und Extraktion. Enthält Helm, KEDA-Autoskalierung, Grafana-Dashboards und Terraform.
- SkyPilot
 - SkyPilot ist ein Framework zum Ausführen von LLMs, KI- und Batch-Jobs in beliebigen Clouds und bietet maximale Kosteneinsparungen, höchste GPU-Verfügbarkeit und verwaltete Ausführung.
- Tensorflow Serving
 - Leistungsstarkes Framework zur Bereitstellung von TensorFlow-Modellen über das gRPC-Protokoll; kann 100.000 Anfragen pro Sekunde und Kern verarbeiten.
- torchtune
 - torchtune ist eine PyTorch-Bibliothek zum einfachen Erstellen, Nachtrainieren und Experimentieren mit LLMs.
- Transformer Lab
 - Transformer Lab ist eine Open-Source-Arbeitsumgebung für LLMs zum lokalen Feinabstimmen, Bewerten, Exportieren und Testen von Modellen über verschiedene Inferenz-Engines und Plattformen hinweg.
- Triton Inference Server
 - Triton ist eine leistungsstarke Open-Source-Serving-Software zur Bereitstellung von KI-Modellen aus beliebigen Frameworks auf GPU und CPU bei maximaler Auslastung.
- Vercel AI
 - Vercel AI ist ein TypeScript-Toolkit zum Erstellen KI-gestützter Anwendungen mit beliebten Frameworks wie Next.js, React, Svelte und Vue sowie Laufzeitumgebungen wie Node.js.
- Vespa
 - Durchsuche, führe Inferenz aus und organisiere Vektoren, Tensoren, Text und strukturierte Daten zur Bereitstellungszeit und in beliebigem Maßstab.
- vLLM
 - vLLM ist eine Inferenz- und Serving-Engine für LLMs mit hohem Durchsatz und effizienter Speichernutzung.
Evaluation and Monitoring
Abschnitt betitelt „Evaluation and Monitoring“- AlpacaEval
 - AlpacaEval ist ein automatischer Evaluator für Sprachmodelle, die Anweisungen befolgen.
- ANN-Benchmarks
 - ANN-Benchmarks ist eine Benchmark-Umgebung für Suchalgorithmen zur approximativen Suche nach nächsten Nachbarn.
- ARES
 - ARES ist ein Framework zur automatischen Evaluierung von Retrieval-Augmented-Generation-Modellen (RAG).
- BEIR
 - BEIR ist ein heterogener Benchmark mit vielfältigen IR-Aufgaben. Außerdem bietet es ein gemeinsames, einfaches Framework zur Evaluierung von NLP-basierten Retrieval-Modellen innerhalb des Benchmarks.
- Code Generation LM Evaluation Harness
 - Code Generation LM Evaluation Harness ist ein Framework zur Evaluierung von Codegenerierungsmodellen.
- COMET
 - COMET ist ein Open-Source-Framework für die Bewertung maschinellen Lernens.
- C-Eval
 - C-Eval ist eine umfassende chinesische Evaluierungssuite für Foundation Models.
- Deepchecks
 - Deepchecks ist eine ganzheitliche Open-Source-Lösung für alle Anforderungen an die Validierung von KI und ML und ermöglicht gründliche Tests von Daten und Modellen – von der Forschung bis zur Produktion.
- DeepEval
 - DeepEval ist ein benutzerfreundliches Open-Source-Evaluierungsframework für LLM-Anwendungen.
- EvalAI
 - EvalAI ist eine Open-Source-Plattform zur Evaluierung und zum Vergleich von KI-Algorithmen in großem Maßstab.
- Evalchemy
 - Evalchemy ist ein einheitliches, einfach zu verwendendes Toolkit zur Evaluierung nachtrainierter Sprachmodelle.
- EvalPlus
 - EvalPlus ist ein robustes Evaluierungsframework für LLM4Code mit erweiterten Benchmarks HumanEval+ und MBPP+, Effizienzbewertung (EvalPerf) sowie einem sicheren und erweiterbaren Evaluierungs-Toolkit.
- Evals
 - Evals ist ein Framework zur Evaluierung von OpenAI-Modellen und eine Open-Source-Registrierung von Benchmarks.
- EvalScope
 - EvalScope ist ein schlankes und anpassbares Framework für effiziente Evaluierung großer Modelle und Leistungsbenchmarks.
- Evaluate
 - Evaluate ist eine Bibliothek, die das Evaluieren und Vergleichen von Modellen sowie eine standardisierte Berichterstattung über ihre Leistung erleichtert.
- Evidently
 - Evidently ist ein Open-Source-Framework zur Evaluierung, zum Testen und zur Überwachung von ML- und LLM-gestützten Systemen.
- Future AGI
 - Offene, selbst hostbare, durchgängige Plattform für die Entwicklung und Optimierung von Agenten, die Tracing, Evaluierungen, Simulationen, Datensätze, Gateway und Schutzmechanismen für LLM- und KI-Agent-Anwendungen vereint.
- GAOKAO-Bench
 - GAOKAO-Bench ist ein Evaluierungsframework, das Aufgaben der chinesischen nationalen Hochschulaufnahmeprüfung (GAOKAO) als Datensatz nutzt, um Sprachverständnis und logisches Schlussfolgern großer Modelle zu bewerten.
- Giskard
 - Giskard ist eine Open-Source-Python-Bibliothek, die Leistungs-, Bias- und Sicherheitsprobleme in KI-Anwendungen automatisch erkennt.
- guidellm
 - guidellm ist ein Benchmark- und Leistungsbewertungswerkzeug für Inferenzsysteme großer Sprachmodelle.
- Harbor
 - Harbor ist ein Framework zur Evaluierung und Optimierung von Agenten und Sprachmodellen. Es unterstützt parallele Experimente in Containerumgebungen und bietet integrierte Verwaltung von Benchmarks und Umgebungen.
- HumanEval
 - HumanEval ist ein Benchmark zur Bewertung der funktionalen Korrektheit von Codegenerierungsmodellen anhand von Python-Programmieraufgaben mit Unit-Tests.
- Helicone
 - Helicone ist die All-in-one-Open-Source-Entwicklungsplattform für LLMs.
- HELM
 - HELM (Holistic Evaluation of Language Models) bietet Werkzeuge zur ganzheitlichen Bewertung von Sprachmodellen, darunter standardisierte Datensätze, eine einheitliche API für verschiedene Modelle, diverse Metriken, Robustheits- und Fairness-Perturbationen, ein Framework zum Erstellen von Prompts sowie einen Proxyserver für den einheitlichen Modellzugriff.
- Inspect
 - Inspect ist ein Framework zur Evaluierung großer Sprachmodelle.
- IsaacLab-Arena
 - IsaacLab-Arena ist eine Open-Source-Erweiterung für NVIDIA Isaac Lab, mit der sich kombinierbare Umgebungen erstellen und Robotik-Policies in großem Maßstab bewerten lassen.
- JiWER
 - JiWER ist ein einfaches und schnelles Python-Paket zur Bewertung eines Systems für automatische Spracherkennung.
- Laminar
 - Laminar ist eine Open-Source-Plattform zum Nachverfolgen, Bewerten, Annotieren und Analysieren von LLM-Daten für KI-Produkte.
- Langfuse
 - Langfuse ist eine Observability- und Analyselösung für LLM-basierte Anwendungen.
- LangTest
 - LangTest ist ein umfassendes Evaluierungs-Toolkit für NLP-Modelle.
- Language Model Evaluation Harness
 - Language Model Evaluation Harness ist ein Framework zum Testen generativer Sprachmodelle mit einer Vielzahl verschiedener Evaluierungsaufgaben.
- LangWatch
 - LangWatch ist eine visuelle Oberfläche für DSPy und eine vollständige LLM-Ops-Plattform zum Überwachen, Experimentieren, Messen und Verbessern von LLM-Pipelines, die nach einem Fair-Code-Modell vertrieben wird.
- Latitude
 - Latitude ist eine Open-Source-Plattform für die Observability von KI-Agenten mit semantischer Trace-Suche und Issue-Tracking.
- LightEval
 - LightEval ist eine leichtgewichtige Evaluierungssuite für LLMs.
- lmms-eval
 - lmms-eval ist ein sorgfältig entwickeltes Evaluierungsframework für eine konsistente und effiziente Bewertung von LMMs.
- Melting Pot
 - Melting Pot ist eine Sammlung von Testszenarien für Multi-Agent-Reinforcement-Learning.
- Meta-World
 - Meta-World ist ein Open-Source-simulierter Benchmark für Meta-Reinforcement-Learning und Multi-Task-Learning mit 50 unterschiedlichen Aufgaben zur Robotermanipulation.
- mir_eval
 - mir_eval ist eine Python-Bibliothek, die eine transparente, standardisierte und unkomplizierte Methode zur Bewertung von Music-Information-Retrieval-Systemen bietet.
- MLPerf Inference
 - MLPerf Inference ist eine Benchmark-Suite, mit der gemessen wird, wie schnell Systeme Modelle in verschiedenen Bereitstellungsszenarien ausführen können.
- Massive Text Embedding Benchmark - Massive Text Embedding Benchmark (MTEB) ist ein umfassendes Evaluierungsframework, das die Leistung von Text-Embedding-Modellen über vielfältige Aufgaben und Sprachen hinweg beurteilt: Es umfasst 8 Embedding-Aufgaben, 58 Datensätze und 112 Sprachen.
- NannyML
 - NannyML ist eine Bibliothek, mit der sich die Modellleistung nach der Bereitstellung (ohne Zugriff auf Zielwerte) schätzen, Data Drift erkennen und Warnungen zu Data Drift intelligent mit Änderungen der Modellleistung verknüpfen lassen.
- OGB
 - Der Open Graph Benchmark (OGB) ist eine Sammlung von Benchmark-Datensätzen, Datenladern und Evaluatoren für maschinelles Lernen auf Graphen.
- Ollama Grid Search
 - Ollama Grid Search automatisiert die Auswahl der besten Modelle, Prompts oder Inferenzparameter für einen Anwendungsfall. So lassen sich Kombinationen durchspielen und die Ergebnisse visuell prüfen.
- onWatch
 - onWatch ist ein schlankes Go-CLI, das in Echtzeit die Nutzung von KI-API-Kontingenten über mehrere Anbieter hinweg erfasst (Anthropic-Pro-/Max-Tarife, Codex, Gemini CLI, Synthetic, Z.ai, GitHub Copilot, MiniMax Coding/Token Plan, Antigravity und OpenRouter) – mit Prognosen zur Verbrauchsrate, historischen Nutzungsdiagrammen und Auswertung pro Abrechnungszyklus.
- OpenCompass
 - OpenCompass ist eine Plattform zur Evaluierung von LLMs. Sie unterstützt eine Vielzahl von Modellen (LLaMA, LLaMa2, ChatGLM2, ChatGPT, Claude usw.) auf über 50 Datensätzen.
- OpenLIT
 - OpenLIT ist eine Open-Source-Plattform für KI-Engineering, die LLM-Workflows mit Observability, Überwachung, Schutzmechanismen, Evaluierungen und nahtlosen Integrationen vereinfacht.
- OpenLLMetry
 - OpenLLMetry bietet Entwicklerinnen und Entwicklern umfassende Einblicke in Anwendungen mit großen Sprachmodellen – durch Leistungsüberwachung, Ausführungs-Tracing und Debugging-Funktionen.
- Opik
 - Opik ist eine Open-Source-Plattform zur Evaluierung, zum Testen und zur Überwachung von LLM-Anwendungen.
- Overcooked-AI
 - Overcooked-AI ist eine Benchmark-Umgebung für vollständig kooperative Aufgaben zwischen Menschen und KI, basierend auf dem äußerst beliebten Videospiel Overcooked.
- Phoenix
 - Phoenix ist eine Open-Source-Plattform für KI-Observability, die für Experimente, Evaluierung und Fehlerbehebung konzipiert wurde.
- Promptfoo
 - Framework für Red Teaming und Evaluierung von LLMs zum Testen von Jailbreaks, Prompt Injection und anderen Schwachstellen mit CI/CD-Integration.
- Prometheus-Eval
 - RagaAI Catalyst ist eine umfassende Plattform zur Verbesserung der Verwaltung und Optimierung von LLM-Projekten.
- RagaAI Catalyst
 - Prometheus-Eval ist eine Sammlung von Werkzeugen zum Trainieren, Evaluieren und Verwenden von Sprachmodellen, die speziell auf die Bewertung anderer Sprachmodelle ausgerichtet sind.
- Ragas
 - Ragas ist ein Framework zur Evaluierung von RAG-Pipelines.
- RewardBench
 - RewardBench ist ein Benchmark zur Bewertung der Fähigkeiten und Sicherheit von Reward-Modellen.
- RLBench
 - RLBench ist ein ambitionierter, groß angelegter Benchmark und eine Lernumgebung zur Forschung in verschiedenen Bereichen der visuell gesteuerten Manipulation, darunter Reinforcement Learning, Imitation Learning, Multi-Task-Learning, geometrische Computer Vision und insbesondere Few-Shot-Learning.
- SimplerEnv
 - SimplerEnv ist eine simulierte Umgebung zur Bewertung von Manipulations-Policies für reale Robotersysteme.
- SwanLab
 - SwanLab ist ein Werkzeug zur Nachverfolgung und Visualisierung von KI-Trainingsläufen.
- Speech-to-Text Benchmark
 - Speech-to-Text Benchmark ist ein minimalistisches und erweiterbares Framework für den Benchmark-Vergleich verschiedener Speech-to-Text-Engines.
- TensorFlow Model Analysis
 - TensorFlow Model Analysis (TFMA) ist eine Bibliothek zur verteilten Bewertung von TensorFlow-Modellen auf großen Datenmengen unter Verwendung derselben Metriken wie im jeweiligen Trainer.
- TorchBench
 - TorchBench ist eine Sammlung von Open-Source-Benchmarks zur Bewertung der PyTorch-Leistung.
- TruLens
 - TruLens bietet eine Reihe von Werkzeugen zur Evaluierung und Nachverfolgung von LLM-Experimenten.
- TrustLLM
 - TrustLLM ist ein umfassendes Framework zur Bewertung der Vertrauenswürdigkeit großer Sprachmodelle und umfasst Prinzipien, Umfragen und Benchmarks.
- VBench
 - VBench ist eine umfassende Benchmark-Suite für generative Videomodelle.
- VLMEvalKit
 - VLMEvalKit ist ein Open-Source-Evaluierungs-Toolkit für große Vision-Language-Modelle (LVLMs).
Explainability and Fairness
Abschnitt betitelt „Explainability and Fairness“- Aequitas
 - Ein Open-Source-Toolkit zur Bias-Prüfung für Data Scientists, Forschende im Bereich maschinelles Lernen und politische Entscheidungsträger. Es dient dazu, ML-Modelle auf Diskriminierung und Bias zu prüfen und fundierte, gerechte Entscheidungen bei der Entwicklung und Bereitstellung prädiktiver Risikobewertungswerkzeuge zu treffen.
- AI Explainability 360
 - Interpretierbarkeit und Erklärbarkeit von Daten und Modellen des maschinellen Lernens, einschließlich einer umfassenden Auswahl an Algorithmen für verschiedene Erklärungsperspektiven sowie Proxy-Metriken zur Erklärbarkeit.
- AI Fairness 360
 - Umfassende Sammlung von Fairness-Metriken für Datensätze und ML-Modelle, Erläuterungen zu diesen Metriken sowie Algorithmen zur Verringerung von Bias in Datensätzen und Modellen.
- Alibi
 - Alibi ist eine Open-Source-Python-Bibliothek zur Inspektion und Interpretation von ML-Modellen. Ihr anfänglicher Schwerpunkt liegt auf Erklärungen für Black-Box-Modelle auf Einzelfallbasis.
- captum
 - Bibliothek zum Interpretieren und Verstehen von Modellen in PyTorch, entwickelt von Facebook. Sie enthält allgemeine Implementierungen von Integrated Gradients, Saliency Maps, SmoothGrad, VarGrad und weiteren Verfahren für PyTorch-Modelle.
- Fairlearn
 - Fairlearn ist ein Python-Toolkit zur Bewertung und Verringerung von Ungerechtigkeit in Modellen des maschinellen Lernens.
- InterpretML
 - InterpretML ist ein Open-Source-Paket zum Trainieren interpretierbarer Modelle und Erklären von Black-Box-Systemen.
- Lightly
 - Python-Framework für selbstüberwachtes Lernen mit Bildern. Die erlernten Repräsentationen können zur Analyse der Verteilung unbeschrifteter Daten und zum Ausgleichen von Datensätzen verwendet werden.
- LOFO Importance
 - LOFO (Leave One Feature Out) Importance berechnet die Wichtigkeit einer Gruppe von Merkmalen anhand einer ausgewählten Metrik und eines ausgewählten Modells. Dazu wird iterativ jedes Merkmal entfernt und die Modellleistung mit einem gewählten Validierungsverfahren anhand der Metrik bewertet.
- mljar-supervised
 - Python-Paket für AutoML mit Tabellendaten, Merkmalsentwicklung, Hyperparameteroptimierung, Erklärungen und automatischer Dokumentation.
- Quantus
 - Quantus ist ein Toolkit für erklärbare KI zur verantwortungsvollen Bewertung von Erklärungen neuronaler Netze.
- SHAP
 - SHapley Additive exPlanations ist ein einheitlicher Ansatz, um die Ausgaben beliebiger Modelle des maschinellen Lernens zu erklären.
- SHAPash
 - Shapash ist eine Python-Bibliothek mit verschiedenen Visualisierungen, die verständliche, explizite Bezeichnungen anzeigen.
- WhatIf
 - Eine einfach zu verwendende Oberfläche, um ein besseres Verständnis eines Black-Box-Klassifikations- oder Regressionsmodells zu gewinnen.
Feature Store
Abschnitt betitelt „Feature Store“- FEAST
 - Feast (Feature Store) ist ein Open-Source-Feature-Store für maschinelles Lernen. Es ist der schnellste Weg, vorhandene Infrastruktur zu nutzen, um analytische Daten für Modelltraining und Online-Inferenz produktionsreif zu machen.
- Featureform
 - Ein virtueller Feature-Store. Per Plug-and-Play in die bestehende Infrastruktur integrierbar und von Data Scientists anerkannt. Datenentdeckung, Governance, Lineage und Zusammenarbeit sind nur eine pip-Installation entfernt. Unterstützt pandas, Python, Spark, SQL sowie Integrationen mit großen Cloud-Anbietern.
- Hopsworks Feature Store
 - Offline-/Online-Feature-Store für ML (Video).
Industry-strength Anomaly Detection
Abschnitt betitelt „Industry-strength Anomaly Detection“- Alibi Detect
 - alibi-detect ist ein Python-Paket zur Erkennung von Ausreißern, adversarialen Angriffen und Concept Drift.
- Darts
 - Darts ist eine benutzerfreundliche Bibliothek für Prognosen und Anomalieerkennung bei Zeitreihen.
- Deequ
 - Eine auf Apache Spark aufbauende Bibliothek zur Definition von „Unit-Tests für Daten“, mit denen die Datenqualität großer Datensätze gemessen wird.
- PyOD
 - Ein Python-Toolkit für skalierbare Ausreißererkennung (Anomalieerkennung).
- TFDV
 - TFDV (TensorFlow Data Validation) ist eine Bibliothek zum Erkunden und Validieren von Daten für maschinelles Lernen.
Industry Strength Computer Vision
Abschnitt betitelt „Industry Strength Computer Vision“- CameraTraps
 - CameraTraps (PyTorch Wildlife) ist ein kollaboratives Deep-Learning-Framework zur Analyse von Wildtierbildern. Es bietet Erkennungs- und Klassifizierungsmodelle, die mit umfangreichen Datensätzen aus Kamerafallen trainiert wurden.
- Deep Lake
 - Deep Lake ist eine für Computer Vision optimierte Dateninfrastruktur.
- DeepForest
 - DeepForest ist ein Python-Paket zum Trainieren und Vorhersagen einzelner Baumkronen und Baumarten anhand von RGB-Luftbildern mit Deep Learning.
- Detectron2
 - Detectron2 ist die Bibliothek der nächsten Generation von Facebook AI Research mit hochmodernen Algorithmen für Erkennung und Segmentierung.
- Kornia
 - Kornia ist eine auf PyTorch aufbauende differenzierbare Computer-Vision-Bibliothek mit umfangreichen differenzierbaren Algorithmen zur Bildverarbeitung und geometrischen Bildanalyse.
- libcom
 - libcom ist ein Toolkit zur Bildkomposition.
- LightlyTrain
 - Computer-Vision-Modelle für industrielle Anwendungen mit unbeschrifteten Daten vortrainieren.
- MMCV
 - MMCV ist eine grundlegende Computer-Vision-Bibliothek von OpenMMLab mit wichtigen Funktionen wie Bild- und Videoverarbeitung, Datentransformation und -augmentation, CNN-Architekturen und optimierten CUDA-Operationen.
- SuperGradients
 - SuperGradients ist eine Open-Source-Bibliothek zum Trainieren von Computer-Vision-Modellen auf Basis von PyTorch.
- supervision
 - supervision ist eine Python-Bibliothek zur effizienten Verwaltung von Computer-Vision-Pipelines und bietet Werkzeuge für Annotation, Visualisierung und Modellüberwachung.
- VideoSys
 - VideoSys unterstützt zahlreiche Diffusionsmodelle mit verschiedenen Beschleunigungstechniken, sodass diese Modelle schneller laufen und weniger Speicher benötigen.
Industry Strength Information Retrieval
Abschnitt betitelt „Industry Strength Information Retrieval“- AutoRAG
 - AutoRAG ist ein RAG-AutoML-Werkzeug, das automatisch eine optimale RAG-Pipeline für deine Daten findet.
- BGE
 - BGE erstellt ein umfassendes Retrieval-Toolkit für Suche und RAG.
- EmbedAnything
 - EmbedAnything ist eine minimalistische, leichtgewichtige und leistungsstarke, in Rust entwickelte Embedding-Pipeline zur Erzeugung von Embeddings aus Text, Bildern, Audio, PDFs und anderen Medien. Sie unterstützt dichte und dünn besetzte Embeddings, ONNX sowie Late Interaction.
- Faiss
 - Faiss ist eine Bibliothek zur effizienten Ähnlichkeitssuche und Clusterbildung mit dichten Vektoren.
- GraphRAG
 - GraphRAG ist eine Datenpipeline- und Transformationssuite, die mithilfe von LLMs aussagekräftige, strukturierte Daten aus unstrukturiertem Text extrahiert.
- HippoRAG
 - HippoRAG ist ein neuartiges Retrieval-Augmented-Generation-Framework (RAG), inspiriert von der Neurobiologie des menschlichen Langzeitgedächtnisses. Es ermöglicht LLMs, Wissen aus externen Dokumenten kontinuierlich zu integrieren.
- JamAI Base
 - JamAI Base ist eine Open-Source-Backend-Plattform für RAG (Retrieval-Augmented Generation), die eine eingebettete Datenbank (SQLite) und eine eingebettete Vektordatenbank (LanceDB) mit verwalteten Speicher- und RAG-Funktionen kombiniert. Sie bietet integrierte Orchestrierung und Verwaltung von LLMs, Vektor-Embeddings und Reranking – alles über eine intuitive, tabellenkalkulationsähnliche Benutzeroberfläche und eine einfache REST-API.
- LangExtract
 - LangExtract ist eine Python-Bibliothek, die LLMs nutzt, um anhand benutzerdefinierter Anweisungen strukturierte Informationen aus unstrukturierten Textdokumenten zu extrahieren. Sie verarbeitet etwa klinische Notizen oder Berichte, identifiziert und ordnet wichtige Details und stellt sicher, dass die extrahierten Daten dem Quelltext entsprechen.
- LightRAG
 - Ein einfaches und schnelles Framework für Retrieval-Augmented Generation.
- llmware
 - llmware bietet ein einheitliches Framework zum Erstellen LLM-basierter Anwendungen (z. B. RAG und Agenten) mit kleinen, spezialisierten Modellen, die privat bereitgestellt, sicher mit Unternehmenswissensquellen verbunden und kosteneffizient auf Geschäftsprozesse abgestimmt und angepasst werden können.
- Mem0
 - Mem0 erweitert KI-Assistenten und Agenten um eine intelligente Speicherschicht und ermöglicht personalisierte KI-Interaktionen.
- NGT
 - NGT bietet Befehle und eine Bibliothek für schnelle approximative Suche nach nächsten Nachbarn in großen Datenmengen hochdimensionaler Vektorräume.
- NMSLIB
 - Non-Metric Space Library (NMSLIB): eine effiziente Bibliothek für Ähnlichkeitssuche und ein Toolkit zur Bewertung von k-NN-Verfahren in allgemeinen nicht-metrischen Räumen.
- Qdrant
 - Eine Open-Source-Engine zur Ähnlichkeitssuche von Vektoren mit erweiterten Filterfunktionen.
- R2R
 - R2R (RAG to Riches) ist eine umfassende Plattform zum Erstellen, Bereitstellen und Skalieren von RAG-Anwendungen mit hybrider Suche, multimodaler Unterstützung und fortschrittlicher Observability.
- RAGFlow
 - RAGFlow ist eine RAG-Engine auf Grundlage eines tiefgreifenden Dokumentverständnisses.
- RAGxplorer
 - RAGxplorer ist ein Werkzeug zum Erstellen von Visualisierungen für RAG.
- RAG-FiT
 - RAG-FiT ist eine Bibliothek, die die Fähigkeit von LLMs verbessern soll, externe Informationen zu nutzen, indem Modelle mit speziell erstellten RAG-erweiterten Datensätzen feinabgestimmt werden.
- TextWorld
 - TextWorld ist ein textbasierter Spielegenerator und eine erweiterbare Lern-Sandbox zum Trainieren und Testen von Reinforcement-Learning-Agenten (RL).
- Zvec
 - Zvec ist eine Open-Source-Vektordatenbank, die im Prozess läuft und eine Ähnlichkeitssuche mit geringer Latenz ermöglicht.
Industry Strength Natural Language Processing
Abschnitt betitelt „Industry Strength Natural Language Processing“- aisuite
 - aisuite ist eine einfache, einheitliche Schnittstelle zu mehreren Anbietern generativer KI.
- Align-Anything
 - Align-Anything hat das Ziel, große Modelle beliebiger Modalitäten (Any-to-Any-Modelle), darunter LLMs und VLMs, an menschlichen Absichten und Werten auszurichten.
- BERTopic
 - BERTopic ist ein Topic-Modeling-Verfahren, das Transformer und c-TF-IDF nutzt, um dichte Cluster zu bilden. So entstehen leicht interpretierbare Themen, während wichtige Wörter in den Themenbeschreibungen erhalten bleiben.
- Burr
 - Burr unterstützt die Entwicklung entscheidungsfähiger Anwendungen (Chatbots, Agenten, Simulationen). Es bietet produktionsreife Funktionen (Telemetrie, Persistenz, Bereitstellung usw.) sowie die kostenlose, quelloffene und lokal ausgerichtete Burr-Benutzeroberfläche.
- Context7
 - Context7 stellt aktuelle Code-Dokumentation für Prompts und KI-Coding-Agenten bereit.
- Dify
 - Dify ist eine Open-Source-Entwicklungsplattform für LLM-Apps. Ihre intuitive Oberfläche vereint agentische KI-Workflows, RAG-Pipelines, Agentenfunktionen, Modellverwaltung, Observability und mehr, damit sich Prototypen schnell in Produktion überführen lassen.
- dspy
 - Ein Framework für die Programmierung mit Foundation Models.
- Dust
 - Dust unterstützt die Entwicklung und Bereitstellung von Apps für große Sprachmodelle.
- ESPnet
 - ESPnet ist ein durchgängiges Toolkit für Sprachverarbeitung.
- FastChat
 - FastChat ist eine offene Plattform zum Trainieren, Bereitstellen und Evaluieren von Chatbots auf Basis großer Sprachmodelle.
- Flair
 - Ein einfaches Framework für modernste NLP-Verfahren, entwickelt von Zalando und direkt auf PyTorch aufbauend.
- FunASR
 - FunASR ist ein produktionsreifes ASR-Toolkit für mehr als 50 Sprachen. Es bietet integrierte VAD, Zeichensetzung, Sprecherdiarisierung und Emotionserkennung sowie Bereitstellung über Docker, WebSocket und REST und Unterstützung für die ONNX-Laufzeitumgebung.
- Fun-ASR
 - LLM-basiertes ASR für 31 Sprachen einschließlich chinesischer Dialekte, mit nativer Zeichensetzung, Zeitstempeln und Sprecherdiarisierung.
- Gensim
 - Gensim ist eine Python-Bibliothek für Topic Modeling, Dokumentindizierung und Ähnlichkeits-Retrieval in großen Korpora.
- gpt-fast
 - Einfache und effiziente Textgenerierung mit Transformern, nativ für PyTorch.
- Haystack
 - Haystack ist ein Open-Source-NLP-Framework zur Interaktion mit Daten mithilfe von Transformer-Modellen und LLMs (wie GPT-3). Es bietet produktionsreife Werkzeuge, um schnell Frage-Antwort-Systeme ähnlich ChatGPT, semantische Suche, Textgenerierung und mehr zu erstellen.
- Interactive Composition Explorer
 - ICE ist eine Python-Bibliothek und ein Trace-Visualizer für Sprachmodellprogramme.
- Jan
 - Jan ist eine Open-Source-Alternative zu ChatGPT, die vollständig offline auf deinem Computer läuft. Damit kannst du LLMs herunterladen und lokal mit vollständiger Kontrolle und Privatsphäre ausführen.
- Lamini
 - Lamini ist eine LLM-Engine zur schnellen Anpassung von Modellen.
- LangChain
 - LangChain unterstützt durch kombinierbare Komponenten das Erstellen von Anwendungen mit LLMs.
- LlamaIndex
 - LlamaIndex (GPT Index) ist ein Datenframework für deine LLM-Anwendung.
- LLaMA
 - LLaMA ist als minimales, anpassbares und gut lesbares Beispiel gedacht, um LLaMA-Modelle (arXiv) zu laden und Inferenz auszuführen.
- LLaMA-Factory
 - LLaMA-Factory erleichtert das Feinabstimmen von mehr als 100 großen Sprachmodellen über ein codefreies CLI und eine Weboberfläche.
- LLMBox
 - LLMBox ist eine umfassende Bibliothek zur Implementierung von LLMs, einschließlich einer einheitlichen Trainingspipeline und umfassender Modellbewertung.
- LLaMA2-Accessory
 - LLaMA2-Accessory ist ein Open-Source-Toolkit zum Vortrainieren, Feinabstimmen und Bereitstellen großer Sprachmodelle (LLMs) und multimodaler LLMs.
- LMFlow
 - LMFlow ist eine erweiterbare, praktische und effiziente Toolbox zur Feinabstimmung großer Modelle des maschinellen Lernens.
- Megatron-LM
 - Megatron-LM ist eine hochoptimierte und effiziente Bibliothek zum Trainieren großer Sprachmodelle.
- MindNLP
 - MindNLP ist ein benutzerfreundliches und leistungsstarkes NLP- und LLM-Framework auf Basis von MindSpore, kompatibel mit Modellen und Datensätzen von Hugging Face.
- MLC LLM
 - MLC LLM ist eine universelle Lösung, mit der sich beliebige Sprachmodelle nativ auf vielfältiger Hardware und in nativen Anwendungen bereitstellen lassen. Darüber hinaus ist es ein produktives Framework, mit dem alle die Modellleistung für eigene Anwendungsfälle weiter optimieren können.
- mlx-lm
 - MLX LM ist ein Python-Paket zur Textgenerierung und Feinabstimmung großer Sprachmodelle auf Apple-Silicon mit MLX. Es bietet eine Integration mit dem Hugging Face Hub sowie Unterstützung für Quantisierung und verteilte Inferenz.
- Ollama
 - Große Sprachmodelle lokal starten und ausführen.
- olmOCR
 - olmOCR ist ein Toolkit zum Trainieren von Sprachmodellen für die Verarbeitung realer PDF-Dokumente.
- PaddleNLP
 - PaddleNLP ist eine Suite zur Entwicklung großer Sprachmodelle auf Basis des Deep-Learning-Frameworks PaddlePaddle. Sie unterstützt effizientes Training großer Modelle, verlustfreie Komprimierung und leistungsstarke Inferenz auf verschiedenen Hardwaregeräten.
- Promptise Foundry
 - Promptise Foundry ist ein produktionsreifes Python-Framework für agentische KI und MCP-Server. Es umfasst autonome Laufzeit, Speicher, Werkzeugintegration, Governance (Budget, Zustand, Mission, Geheimnisse), Schutzmechanismen, semantisches Caching und Observability.
- Semantic Kernel
 - Semantic Kernel ist ein SDK, das große Sprachmodelle (LLMs) wie OpenAI, Azure OpenAI und Hugging Face mit herkömmlichen Programmiersprachen wie C#, Python und Java verbindet. Dazu lassen sich Plugins definieren, die sich mit nur wenigen Codezeilen kombinieren lassen.
- Sentence Transformers
 - Sentence Transformers bietet eine einfache Methode, dichte Vektorrepräsentationen von Sätzen, Absätzen und Bildern zu berechnen.
- SpaCy
 - spaCy ist eine Bibliothek für fortgeschrittene Verarbeitung natürlicher Sprache in Python und Cython.
- SWIFT
 - SWIFT ist eine skalierbare, leichtgewichtige Infrastruktur zur Feinabstimmung von Deep-Learning-Modellen.
- Tensorflow Lingvo
 - Ein Framework zum Erstellen neuronaler Netze in TensorFlow, insbesondere Sequenzmodelle.
- Tensorflow Text
 - TensorFlow Text bietet eine Sammlung sofort einsetzbarer, textbezogener Klassen und Operationen für TensorFlow 2.0.
- ToolBench
 - ToolBench ist eine offene Plattform zum Trainieren, Bereitstellen und Evaluieren großer Sprachmodelle für das Erlernen des Werkzeugeinsatzes.
- Transformers
 - Hugging Faces Bibliothek mit hochmodernen vortrainierten Modellen für die Verarbeitung natürlicher Sprache (NLP).
Industry Strength Recommender System
Abschnitt betitelt „Industry Strength Recommender System“- EasyRec
 - EasyRec ist ein Framework für Empfehlungsalgorithmen im großen Maßstab.
- Gorse
 - Gorse hat das Ziel, ein universell einsetzbares Open-Source-Empfehlungssystem bereitzustellen, das sich schnell in verschiedenste Onlinedienste integrieren lässt.
- Merlin
 - NVIDIA Merlin ist eine Open-Source-Bibliothek für durchgängige, GPU-beschleunigte Empfehlungssysteme – von der Merkmalsentwicklung und Vorverarbeitung bis zum Training von Deep-Learning-Modellen und der Inferenz in der Produktion.
- Recommenders
 - Recommenders enthält Jupyter-Notebooks mit Benchmarks und Best Practices zum Erstellen von Empfehlungssystemen.
- TorchRec
 - TorchRec ist eine PyTorch-Domänenbibliothek mit gängigen Grundbausteinen für Sparsity und Parallelisierung, die große Empfehlungssysteme (RecSys) benötigen.
Industry Strength Reinforcement Learning
Abschnitt betitelt „Industry Strength Reinforcement Learning“- Acme
 - Acme ist eine Bibliothek mit Bausteinen für Reinforcement Learning (RL), die einfache, effiziente und gut lesbare Agenten ermöglichen sollen.
- AReaL
 - AReaL ist eine Bibliothek für Reinforcement Learning.
- ChatLearn
 - ChatLearn ist ein flexibles und effizientes Framework zum Trainieren großer Sprachmodelle mit Reinforcement Learning. Es unterstützt verteilte Trainings-Engines (FSDP2, Megatron) und Inferenz-Engines (vLLM, SGLang) sowie moderne RL-Algorithmen wie GRPO und GSPO.
- CleanRL
 - CleanRL ist eine Deep-Reinforcement-Learning-Bibliothek mit hochwertigen Implementierungen in einzelnen Dateien und forschungsfreundlichen Funktionen. Die Implementierungen sind klar und einfach, lassen sich aber auf Tausende Experimente mit AWS Batch skalieren.
- d3rlpy
 - d3rlpy ist eine Bibliothek für Offline-Deep-Reinforcement-Learning für Praktiker und Forschende.
- D4RL
 - D4RL ist ein Open-Source-Benchmark für Offline-Reinforcement-Learning.
- Dopamine
 - Dopamine ist ein Forschungsframework zur schnellen Entwicklung von Prototypen für Reinforcement-Learning-Algorithmen. Es soll eine kleine, leicht verständliche Codebasis bieten, in der Anwender frei mit gewagten Ideen experimentieren können (explorative Forschung).
- EvoTorch
 - EvoTorch ist eine Open-Source-Bibliothek für evolutionäre Berechnung, entwickelt bei NNAISENSE und auf PyTorch aufgebaut.
- FinRL
 - FinRL ist das erste Open-Source-Framework, das das große Potenzial von Financial Reinforcement Learning demonstriert.
- Gymnasium
 - Gymnasium ist eine Open-Source-Python-Bibliothek zur Entwicklung und zum Vergleich von Reinforcement-Learning-Algorithmen. Sie bietet eine Standard-API für die Kommunikation zwischen Lernalgorithmen und Umgebungen sowie eine Sammlung von Umgebungen, die dieser API entsprechen.
- Gymnasium-Robotics
 - Gymnasium-Robotics umfasst eine Sammlung von Robotik-Umgebungen für Reinforcement Learning, die die Gymnasium-API verwenden. Die Umgebungen laufen mit der Physik-Engine MuJoCo und den gepflegten Python-Bindings für mujoco.
- Jumanji
 - Jumanji ist eine Suite von Reinforcement-Learning-Umgebungen (RL) in JAX mit klaren, hardwarebeschleunigten Umgebungen für industrienahe Forschung.
- MARLlib
 - MARLlib ist eine umfassende Bibliothek mit Multi-Agent-Reinforcement-Learning-Algorithmen auf Basis von RLlib. Sie bietet der MARL-Forschungsgemeinschaft eine einheitliche Plattform zum Entwickeln, Trainieren und Evaluieren von MARL-Algorithmen.
- Mava
 - Mava ist ein Framework für verteiltes Multi-Agent-Reinforcement-Learning in JAX.
- Melting Pot - Melting Pot ist eine Sammlung von Testszenarien für Multi-Agent-Reinforcement-Learning.
- MetaDrive
 - MetaDrive ist ein Fahrsimulator, der vielfältige Fahrszenarien für verallgemeinerbares Reinforcement Learning kombiniert.
- Minigrid
 - Die Minigrid-Bibliothek enthält eine Sammlung diskreter Grid-World-Umgebungen für die Forschung zu Reinforcement Learning. Die Umgebungen entsprechen der Gymnasium-Standard-API und sind leichtgewichtig, schnell und einfach anpassbar.
- MiniWorld
 - MiniWorld ist ein minimalistischer 3D-Innenraumsimulator für die Forschung zu Reinforcement Learning und Robotik.
- ML-Agents
 - ML-Agents ist ein Open-Source-Projekt, mit dem Spiele und Simulationen als Umgebungen zum Trainieren intelligenter Reinforcement-Learning-Agenten dienen können.
- MushroomRL
 - MushroomRL ist eine Python-Bibliothek für Reinforcement Learning (RL). Ihre Modularität ermöglicht die einfache Verwendung bekannter Python-Bibliotheken für Tensorberechnungen (z. B. PyTorch, TensorFlow) und RL-Benchmarks (z. B. OpenAI Gym, PyBullet, DeepMind Control Suite).
- OmniSafe
 - OmniSafe ist ein Infrastrukturframework zur Beschleunigung der Forschung zu sicherem Reinforcement Learning (RL).
- OpenRLHF
 - OpenRLHF ist ein Open-Source-Framework für Reinforcement Learning aus menschlichem Feedback (RLHF).
- PARL
 - PARL ist ein flexibles und hocheffizientes Framework für Reinforcement Learning.
- PettingZoo
 - PettingZoo ist eine Python-Bibliothek für die Forschung zu Multi-Agent-Reinforcement-Learning, vergleichbar mit einer Multi-Agent-Version von Gymnasium.
- ranx
 - ranx ist eine Bibliothek mit schnellen Metriken zur Bewertung von Rankings, in Python implementiert und mit Numba für schnelle Vektoroperationen und automatische Parallelisierung optimiert.
- RL4CO
 - RL4CO ist eine PyTorch-Bibliothek für Reinforcement Learning bei kombinatorischer Optimierung (CO).
- RL2
 - RL2 ist eine Bibliothek für Reinforcement Learning.
- RLinf
 - RLinf ist eine Bibliothek für Reinforcement Learning.
- ROLL
 - ROLL ist eine Bibliothek für Reinforcement Learning.
- skrl
 - skrl ist eine in Python geschriebene, modulare Open-Source-Bibliothek für Reinforcement Learning mit PyTorch. Sie legt besonderen Wert auf Lesbarkeit, Einfachheit und Transparenz bei der Implementierung von Algorithmen.
- SkyRL
 - SkyRL ist eine Full-Stack-Bibliothek für Reinforcement Learning mit modularen Trainingsframeworks, plattformübergreifenden Inferenz-Backends, agentischen Pipelines und Gymnasium-Umgebungen für langfristige RL-Aufgaben in der realen Welt.
- slime
 - slime ist ein Framework für das Nachtraining von LLMs zur Skalierung von Reinforcement Learning.
- Stable Baselines
 - Ein Fork von OpenAI Baselines mit Implementierungen von Reinforcement-Learning-Algorithmen.
- TF-Agents
 - Eine zuverlässige, skalierbare und benutzerfreundliche TensorFlow-Bibliothek für kontextuelle Banditen und Reinforcement Learning.
- TorchRL
 - TorchRL ist eine Open-Source-Bibliothek für Reinforcement Learning (RL) in PyTorch.
- TRL
 - Transformer-Sprachmodelle mit Reinforcement Learning trainieren.
- veRL
 - veRL (HybridFlow) ist ein flexibles, effizientes und industriegerechtes RLHF-Trainingsframework für LLMs.
Industry Strength Robotics
Abschnitt betitelt „Industry Strength Robotics“- AI2-THOR
 - AI2-THOR ist ein nahezu fotorealistisches, interaktives Framework für KI-Agenten.
- Genesis
 - Genesis ist eine Physikplattform für Embodied AI und Robotersimulation.
- Habitat-Sim
 - Habitat-Sim ist ein flexibler, leistungsstarker 3D-Simulator für die Forschung zu Embodied AI.
- IsaacLab
 - IsaacLab ist ein einheitliches, modulares Framework für Roboterlernen auf Grundlage von NVIDIA Isaac Sim.
- LeRobot
 - LeRobot bietet Modelle, Datensätze und Werkzeuge für Robotik in der realen Welt und Imitation Learning.
- robosuite
 - robosuite ist ein von der Physik-Engine MuJoCo angetriebenes Simulationsframework für Roboterlernen.
- RoboVerse
 - RoboVerse ist eine umfassende Plattform für Robotersimulation mit vielfältigen Umgebungen.
Industry Strength Visualisation
Abschnitt betitelt „Industry Strength Visualisation“- Apache ECharts
 - Apache ECharts ist eine leistungsstarke, interaktive Diagramm- und Datenvisualisierungsbibliothek für Browser.
- Apache Superset
 - Eine moderne, unternehmenstaugliche Webanwendung für Business Intelligence.
- Bokeh
 - Bokeh ist eine interaktive Visualisierungsbibliothek für Python, mit der sich ansprechende und aussagekräftige Datenvisualisierungen in modernen Webbrowsern erstellen lassen.
- Bread Dataset Viewer - Eine VS-Code-Erweiterung zum Anzeigen und Erkunden großer Datensätze für maschinelles Lernen (CSV, JSON, Parquet usw.) direkt im Editor, ohne dass die IDE abstürzt.
- Bread WandB Viewer - Eine VS-Code-Erweiterung zum Anzeigen von Weights-&-Biases-Experimenten, Protokollen und Artefakten in der IDE. So muss nicht zur Weboberfläche gewechselt werden und der Datenschutz bleibt gewahrt, da alles vollständig offline läuft.
- Data Formulator
 - Daten transformieren und mit KI iterativ aussagekräftige Visualisierungen erstellen.
- ggplot2
 - Eine Implementierung der Grammatik der Grafiken für R.
- gradio
 - Erstelle und teile schnell Modelldemos – nur mit Python-Code. Debugge Modelle interaktiv im Browser, hole Feedback von Mitarbeitenden ein und erstelle öffentliche Links, ohne etwas bereitzustellen.
- Kangas
 - Kangas ist ein Werkzeug zum Erkunden, Analysieren und Visualisieren umfangreicher Multimediadaten. Es bietet eine unkomplizierte Python-API zum Protokollieren großer Datentabellen sowie eine intuitive visuelle Oberfläche für komplexe Abfragen über den Datensatz.
- matplotlib
 - Eine Python-Bibliothek für 2D-Diagramme, die publikationsreife Abbildungen in zahlreichen Druckformaten und interaktiven Umgebungen auf verschiedenen Plattformen erstellt.
- Model Explorer
 - Model Explorer ist ein Werkzeug zum Visualisieren und Erkunden von ML-Modellen. Eine intuitive graphbasierte Ansicht vermittelt die Modellstruktur, ermöglicht die Prüfung von Layer-Details und die Navigation durch große neuronale Netze.
- Netron
 - Netron ist ein Viewer für neuronale Netze sowie Deep-Learning- und ML-Modelle.
- Perspective
 Streaming-Pivot-Visualisierung mit WebAssembly.
- Plotly
 - Eine interaktive, quelloffene und browserbasierte Diagrammbibliothek für Python.
- Redash
 - Redash ist ein Open-Source-Visualisierungsframework, das mithilfe mehrerer Backends den einfachen Zugriff auf große Datensätze ermöglicht.
- Rerun
 - Rerun ist ein Open-Source-SDK zum Protokollieren, Speichern, Abfragen und Visualisieren multimodaler Daten. Es wurde für Robotik, Computer Vision und Spatial AI entwickelt.
- seaborn
 - Seaborn ist eine auf matplotlib aufbauende Python-Visualisierungsbibliothek. Sie bietet eine High-Level-Schnittstelle zum Erstellen ansprechender statistischer Grafiken.
- Spotlight
 - Spotlight hilft dabei, kritische Datensegmente und Fehlermodi von Modellen zu identifizieren. Durch das Kuratieren hochwertiger Datensätze unterstützt es den Aufbau und die Pflege zuverlässiger ML-Modelle.
- Streamlit
 - Mit Streamlit lassen sich Apps für ML-Projekte mit täuschend einfachen Python-Skripten erstellen. Dank Hot Reloading wird die App während der Bearbeitung und beim Speichern sofort aktualisiert.
- tensorboardX
 - TensorBoard-Ereignisse mit einem einfachen Funktionsaufruf schreiben.
- TensorBoard
 - TensorBoard ist ein Visualisierungs-Toolkit für Experimente mit maschinellem Lernen, mit dem sich ML-Experimente einfach hosten, nachverfolgen und teilen lassen.
- Torchvista
 - Torchvista ist ein interaktives, notebookbasiertes Werkzeug zur Visualisierung des Forward Pass beliebiger PyTorch-Modelle als Berechnungsgraph direkt in Notebooks. Es unterstützt einklappbare verschachtelte Module und fehlertolerante partielle Visualisierungen.
- Transformer Explainer
 - Transformer Explainer ist ein interaktives Visualisierungswerkzeug, mit dem alle nachvollziehen können, wie Transformer-basierte Modelle wie GPT funktionieren.
- Vega-Altair
 - Vega-Altair ist eine deklarative statistische Visualisierungsbibliothek für Python.
- ydata-profiling
 - ydata-profiling bietet eine schnelle, einheitliche explorative Datenanalyse (EDA) mit nur einer Codezeile.
Metadata Management
Abschnitt betitelt „Metadata Management“- Apache Atlas
 - Das Apache-Atlas-Framework ist eine erweiterbare Sammlung grundlegender Governance-Dienste. Unternehmen können damit Compliance-Anforderungen in Hadoop effizient erfüllen und eine Integration in das gesamte Datenökosystem des Unternehmens ermöglichen.
- DataHub
 - DataHub ist LinkedIns universelles Werkzeug zur Suche und Entdeckung von Metadaten.
- Marquez
 - Marquez ist ein Open-Source-Metadatendienst zum Erfassen, Aggregieren und Visualisieren der Metadaten eines Datenökosystems.
- Metacat
 - Metacat ist ein einheitlicher API-Dienst zur Erkundung von Metadaten. Er befasst sich mit folgenden Problemen: 1) föderierte Ansichten von Metadatensystemen; 2) beliebige Metadatenspeicherung zu Datensätzen; 3) Auffinden von Metadaten.
- ML Metadata
 - Eine Bibliothek zum Erfassen und Abrufen von Metadaten zu Workflows von ML-Entwicklern und Data Scientists.
Model, Data and Experiment Management
Abschnitt betitelt „Model, Data and Experiment Management“- Aim
 - Eine besonders einfache Möglichkeit, KI-Experimente aufzuzeichnen, zu durchsuchen und zu vergleichen.
- ClearML
 - Automagischer Experimentmanager und Versionskontrolle für KI (früher Trains).
- DataHub - DataHub ist ein Open-Source-Datenkatalog für den modernen Daten-Stack.
- Dolt
 - Dolt ist eine SQL-Datenbank, die sich wie ein Git-Repository forken, klonen, verzweigen, zusammenführen, pushen und pullen lässt.
- DVC
 - DVC (Data Version Control) ist ein Git-Fork, der die Versionsverwaltung von Modellen ermöglicht.
- HuggingFace Model Downloader
 - HuggingFace Model Downloader ist ein Dienstprogramm zum Herunterladen von Modellen und Datensätzen von der Hugging-Face-Website. Es bietet Multithread-Downloads für LFS-Dateien und prüft mithilfe von SHA256-Prüfsummen die Integrität der heruntergeladenen Modelle.
- Keepsake
 - Versionskontrolle für maschinelles Lernen.
- KitOps
 - KitOps ist ein offenes, standardbasiertes Paketierungs- und Versionsverwaltungssystem für KI-/ML-Projekte, das mit den bereits verwendeten KI-, Entwicklungs- und DevOps-Werkzeugen funktioniert.
- lakeFS
 - Reproduzierbarer, atomarer und versionierter Data Lake auf Objektspeicher.
- MLflow
 - Open-Source-Plattform zur Verwaltung des ML-Lebenszyklus, einschließlich Experimenten, Reproduzierbarkeit und Bereitstellung.
- Polyaxon
 - Eine Plattform für reproduzierbares und skalierbares maschinelles Lernen und Deep Learning auf Kubernetes – (Video).
- Quilt
 - Versionsverwaltung, Reproduzierbarkeit und Bereitstellung von Daten und Modellen.
- Sacred
 - Werkzeug zum Konfigurieren, Organisieren und Protokollieren von Experimenten des maschinellen Lernens sowie zum Reproduzieren dieser Experimente.
- TerminusDB
 - Ein Graphdatenbank-Verwaltungssystem, das Daten wie Git speichert.
- Weights & Biases
 - Weights & Biases ist eine Plattform zur Nachverfolgung von ML-Experimenten, Versionierung von Datensätzen, Hyperparametersuche, Visualisierung und Zusammenarbeit.
Model Training and Orchestration
Abschnitt betitelt „Model Training and Orchestration“- AutoTrain Advanced
 - AutoTrain Advanced ist eine No-Code-Lösung, mit der sich Modelle des maschinellen Lernens mit wenigen Klicks trainieren lassen.
- Avalanche
 - Avalanche ist eine durchgängige Bibliothek für Continual Learning mit einer gemeinsamen, kollaborativen und MIT-lizenzierten Open-Source-Codebasis zur schnellen Prototypentwicklung, zum Training und zur reproduzierbaren Bewertung von Continual-Learning-Algorithmen.
- Axolotl
 - Axolotl ist ein Werkzeug zur Vereinfachung der Feinabstimmung verschiedener KI-Modelle und unterstützt mehrere Konfigurationen und Architekturen.
- BindsNET
 - BindsNET ist eine Simulationsbibliothek für Spiking Neural Networks zur Entwicklung biologisch inspirierter Algorithmen für maschinelles Lernen.
- CML
 - Continuous Machine Learning (CML) ist eine Open-Source-Bibliothek zur Implementierung kontinuierlicher Integration und Bereitstellung (CI/CD) in ML-Projekten.
- CoreNet
 - CoreNet ist ein Toolkit für tiefe neuronale Netze, mit dem Forschende und Entwickler standardmäßige und neuartige Modelle verschiedener Größen für unterschiedliche Aufgaben trainieren können, darunter Foundation Models (z. B. CLIP und LLMs), Objektklassifizierung, Objekterkennung und semantische Segmentierung.
- DataLinter
 - DataLinter ist ein kontextbezogener Open-Source-Linter für Daten und Code. Dank Plugins ist er sowohl gegenüber Daten als auch Code agnostisch.
- Determined
 - Trainingsplattform für Deep Learning mit integrierter Unterstützung für verteiltes Training, Hyperparameteroptimierung und Modellverwaltung (unterstützt TensorFlow und PyTorch).
- dstack
 - dstack ist ein Open-Source-Container-Orchestrator, der die Orchestrierung von Workloads vereinfacht und die GPU-Auslastung für ML-Teams steigert.
- envd
 - Entwicklungsumgebung für maschinelles Lernen für Data-Science- und KI-/ML-Engineering-Teams.
- Fire-Flyer File System
 - Das Fire-Flyer File System (3FS) ist ein leistungsstarkes verteiltes Dateisystem für die Anforderungen von KI-Trainings- und Inferenz-Workloads. Es nutzt moderne SSDs und RDMA-Netzwerke als gemeinsame Speicherschicht und vereinfacht so die Entwicklung verteilter Anwendungen.
- H2O-3
 - Schnelle, skalierbare Plattform für maschinelles Lernen zur Entwicklung intelligenterer Anwendungen: Deep Learning, Gradient Boosting und XGBoost, Random Forest, generalisierte lineare Modelle (logistische Regression, Elastic Net), K-Means, PCA, Stacked Ensembles, automatisiertes maschinelles Lernen (AutoML) usw.
- Hopsworks
 - Hopsworks ist eine datenintensive Plattform zum Entwerfen und Betreiben von Pipelines für maschinelles Lernen.
- Ignite
 - Ignite ist eine High-Level-Bibliothek zur flexiblen und transparenten Unterstützung beim Trainieren und Evaluieren neuronaler Netze in PyTorch.
- Kubeflow
 - Eine cloudnative Plattform für maschinelles Lernen, basierend auf Googles internen ML-Pipelines.
- Ludwig
 - Ludwig ist ein Low-Code-Framework zum Erstellen benutzerdefinierter KI-Modelle wie LLMs und anderer tiefer neuronaler Netze.
- MFTCoder
 - MFTCoder ist ein Open-Source-Projekt von CodeFuse für präzises und effizientes Multi-Task-Fine-Tuning (MFT) großer Sprachmodelle (LLMs), insbesondere von Code-LLMs für Programmieraufgaben.
- MLeap
 - Standardisierung der Serialisierung von Pipelines und Modellen für Spark, TensorFlow und sklearn.
- Nanotron
 - Nanotron bietet verteilte Grundbausteine, um verschiedene Modelle mithilfe von 3D-Parallelisierung effizient zu trainieren.
- NeMo
 - NVIDIA NeMo ist ein skalierbares, cloudnatives Framework für generative KI. Es richtet sich an Forschende und PyTorch-Entwickler, die mit großen Sprachmodellen (LLMs), multimodalen Modellen (MMs), automatischer Spracherkennung (ASR), Sprachsynthese (TTS) und Computer Vision (CV) arbeiten. Vorhandener Code und vortrainierte Modell-Checkpoints ermöglichen die effiziente Erstellung, Anpassung und Bereitstellung neuer generativer KI-Modelle.
- Prime
 - Prime ist ein Framework für effizientes, weltweit verteiltes Training von KI-Modellen über das Internet.
- PyCaret
 ) - Low-Code-Bibliothek zum Trainieren und Bereitstellen von Modellen (scikit-learn, XGBoost, LightGBM, spaCy).
- Sematic
 - Plattform zum Erstellen ressourcenintensiver Pipelines mit einfachem Python-Code.
- Skaffold
 - Skaffold ist ein Kommandozeilenwerkzeug für die kontinuierliche Entwicklung von Kubernetes-Anwendungen. Quellcode lässt sich lokal iterativ bearbeiten und anschließend in lokalen oder entfernten Kubernetes-Clustern bereitstellen.
- TFX
 - TensorFlow Extended (TFX) ist ein produktionsorientiertes Konfigurationsframework für ML auf Basis von TensorFlow, einschließlich Überwachung und Modellversionsverwaltung.
- unsloth
 - Feinabstimmung und Reinforcement Learning für LLMs. Trainiere OpenAI gpt-oss, DeepSeek-R1, Qwen3, Gemma 3 und TTS doppelt so schnell bei 70 % weniger VRAM.
Model Storage Optimisation
Abschnitt betitelt „Model Storage Optimisation“- AWQ
 - Aktivierungsbewusste Gewichtungsquantisierung zur Komprimierung und Beschleunigung von LLMs.
- GGML
 - GGML ist eine leistungsstarke Tensorbibliothek für maschinelles Lernen, die effiziente Inferenz auf CPUs ermöglicht und besonders für große Sprachmodelle optimiert ist.
- neural-compressor
 - Intel® Neural Compressor bietet beliebte Verfahren zur Modellkomprimierung wie Quantisierung, Pruning (Sparsity), Distillation und Suche nach neuronalen Architekturen für gängige Frameworks.
- NNEF - Neural Network Exchange Format (NNEF) ist ein offener Standard zur Darstellung neuronaler Netze, der Interoperabilität und Portabilität zwischen verschiedenen Frameworks und Plattformen für maschinelles Lernen ermöglicht.
- ONNX
 - ONNX (Open Neural Network Exchange) ist ein Open-Source-Format, das die Interoperabilität und Portabilität von Modellen des maschinellen Lernens über verschiedene Frameworks und Plattformen hinweg erleichtert.
- PFA - PFA (Portable Format for Analytics) ist ein Standard zur Darstellung und zum Austausch prädiktiver Modelle und analytischer Workflows in einem portablen, JSON-basierten Format.
- PMML - PMML (Predictive Model Markup Language) ist ein XML-basierter Standard zur Darstellung und zum Austausch prädiktiver Modelle zwischen verschiedenen Anwendungen.
- Quanto
 - Quanto soll die Quantisierung von Deep-Learning-Modellen vereinfachen.
Privacy and Safety
Abschnitt betitelt „Privacy and Safety“- AI Gateway
 - Das AI Gateway ist ein blitzschnelles KI-Gateway mit integrierten Schutzmechanismen.
- ART
 - ART (Adversarial Robustness Toolbox) bietet Werkzeuge, mit denen Entwickler und Forschende Modelle und Anwendungen des maschinellen Lernens gegen adversariale Bedrohungen wie Umgehung, Vergiftung, Extraktion und Inferenz verteidigen und bewerten können.
- CipherChat
 - CipherChat ist ein Framework zur Bewertung der Generalisierungsfähigkeit von Safety Alignment bei LLMs.
- DeepTeam
 - DeepTeam ist ein benutzerfreundliches Open-Source-Framework für Red Teaming von LLMs, für Penetrationstests und zum Absichern von Systemen mit großen Sprachmodellen.
- FATE
 - FATE (Federated AI Technology Enabler) ist das weltweit erste Open-Source-Framework für föderiertes Lernen in Industriequalität. Es ermöglicht Unternehmen und Institutionen die gemeinsame Datennutzung und schützt dabei Datensicherheit und Privatsphäre.
- FedML
 - FedML bietet eine integrierte Edge-Cloud-Plattform für Forschung und Produktion im föderierten und verteilten maschinellen Lernen – überall und in jedem Maßstab.
- Flower
 - Flower ist ein Framework für föderiertes Lernen mit einem einheitlichen Ansatz. Es ermöglicht die Föderation beliebiger ML-Workloads mit jedem ML-Framework und jeder Programmiersprache.
- Google’s Differential Privacy
 - Eine C++-Bibliothek mit Algorithmen für ε-differentielle Privatsphäre, mit denen sich aggregierte Statistiken über numerische Datensätze mit privaten oder vertraulichen Informationen erstellen lassen.
- Guardrails
 - Guardrails ist ein Paket, mit dem sich Ausgaben großer Sprachmodelle um Garantien hinsichtlich Struktur, Typ und Qualität ergänzen lassen.
- NeMo Guardrails
 - NeMo Guardrails ist ein Open-Source-Toolkit, mit dem sich programmierbare Schutzmechanismen einfach zu dialogbasierten Systemen mit LLMs hinzufügen lassen.
- Opacus
 - Opacus ermöglicht das Trainieren von PyTorch-Modellen mit differentieller Privatsphäre. Es erfordert clientseitig nur minimale Codeänderungen, beeinträchtigt die Trainingsleistung kaum und ermöglicht die laufende Nachverfolgung des verbrauchten Datenschutzbudgets.
- OpenFL
 - OpenFL ist ein Python-Framework für föderiertes Lernen. Es ist als flexibles, erweiterbares und leicht erlernbares Werkzeug für Data Scientists konzipiert. Entwickelt wird OpenFL von Intel Internet of Things Group (IOTG) und Intel Labs.
- PySyft
 - Eine Python-Bibliothek für sicheres, privates Deep Learning. PySyft trennt private Daten vom Modelltraining und nutzt dafür Multi-Party Computation (MPC) in PyTorch.
- Tensorflow Privacy
 - Eine Python-Bibliothek mit Implementierungen von TensorFlow-Optimierern zum Trainieren von Modellen des maschinellen Lernens mit differentieller Privatsphäre.
- TF Encrypted
 - Ein Framework für vertrauliches maschinelles Lernen mit verschlüsselten Daten in TensorFlow.
Weitere Awesome-Listen
Abschnitt betitelt „Weitere Awesome-Listen“- Awesome Agentic Engineering Resources
 - Eine kuratierte Sammlung von Ressourcen, Werkzeugen und Referenzen zum Erstellen agentischer KI-Systeme.
- Awesome AI Gateway
 - Kuratierte, zweisprachige (EN/zh-CN) Liste von KI-Gateways und LLM-Proxys (LiteLLM, OpenRouter, Portkey, Kong, Higress, new-api), verglichen nach Kosten, Compliance, Selbsthosting und Routing, ergänzt um einen Entscheidungsbaum, reproduzierbare Kostenbenchmarks und eine Bewertungsmatrix.
- Awesome AI Regulation
 - Behandelt Governance, Compliance und regulatorische Rahmenwerke, die für die verantwortungsvolle Bereitstellung von ML-Systemen in verschiedenen Rechtsräumen unverzichtbar sind.
- Awesome AI Tokenomics
 - Behandelt Tokenkosten und Effizienz in KI-Systemen, einschließlich Überwachung, Optimierung, Caching, Modellauswahl und Kontextverwaltung.
- Awesome Production GenAI
 - Konzentriert sich gezielt auf die Bereitstellung generativer KI, einschließlich LLM-Betrieb, Prompt Engineering und Überwachungs- und Sicherheitswerkzeugen speziell für generative KI.
- Awesome RAG Production
 - Kuratierte Liste produktionsreifer Werkzeuge und Best Practices zum Erstellen skalierbarer RAG-Systeme.
Mitwirkende
Abschnitt betitelt „Mitwirkende“HagiCode
HagiCode ist ein agentischer Coding-Arbeitsplatz. Vielseitige, komfortable Interaktionen in der Benutzeroberfläche machen Planung, Agent-Ausführung und Projektarbeit zugänglich und leicht nachvollziehbar – für ein ansprechendes Entwicklungserlebnis.
Entdecken Sie ein ansprechendes Entwicklungserlebnis mit vielseitigen, komfortablen Interaktionen in der Benutzeroberfläche.

- IntelligentOpenSpec-Workflows machen aus einer Absicht einen umsetzbaren Weg vom Vorschlag über Design und Aufgaben bis zur Auslieferung.
- EffizientMulti-Agent-Ausführung führt Recherche, Umsetzung und Prüfung parallel aus, über mehrere Repositories und die Agent CLIs, die Sie bereits nutzen.
- InteressantVielseitige, komfortable Interaktionen in der Benutzeroberfläche machen Planung, Agent-Ausführung und Projektarbeit zugänglich und leicht nachvollziehbar.
Für Windows herunterladen
HagiCode teilen

Aus Ideen wird ausgelieferte Software.
HagiCode ist ein agentischer Coding-Arbeitsplatz: OpenSpec-Workflows planen die Änderung, Multi-Agent-Ausführung setzt sie um, und Hero Scenario macht den langen Weg sichtbar, bis aus der Idee ausgelieferte Software wird.
- Intelligent
- OpenSpec-Workflows machen aus einer Absicht einen Weg vom Vorschlag bis zur Auslieferung.
- Effizient
- Multi-Agent-Ausführung treibt Recherche, Umsetzung und Prüfung parallel voran.
- Unterhaltsam
- UI-Interaktionen erleichtern Planung, Agent-Ausführung und Projektarbeit.
© 2026 HagiCode | Powered By hagilight-starlight@0.21.0 | Branch: main | Commit: 745b50b | Built: