Zum Inhalt springen

Sprache wählen

Aktuelle Sprache: Deutsch

Prompt Engineering

Source: https://github.com/promptslab/Awesome-Prompt-Engineering at 23542555e534
License: Apache-2.0
Read the English original

This edition is an AI-assisted translation.

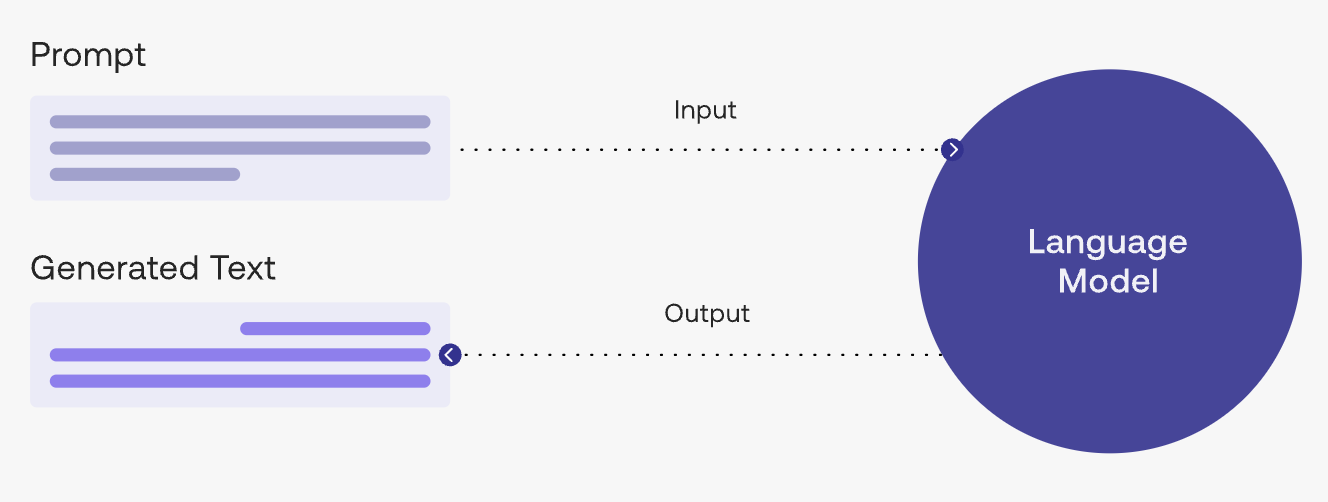
Eine handkuratierte Sammlung von Ressourcen für Prompt Engineering und Context Engineering - mit Papieren, Tools, Modellen, APIs, Benchmarks, Kursen und Communities für die Arbeit mit großen Sprachmodellen.

https://promptslab.github.io

Master Prompt Engineering. Join the Course at https://promptslab.github.io

Awesome License PRs Welcome Community Last Updated


Abschnitt betitelt „ Master Prompt Engineering. Join the Course at https://promptslab.github.io “

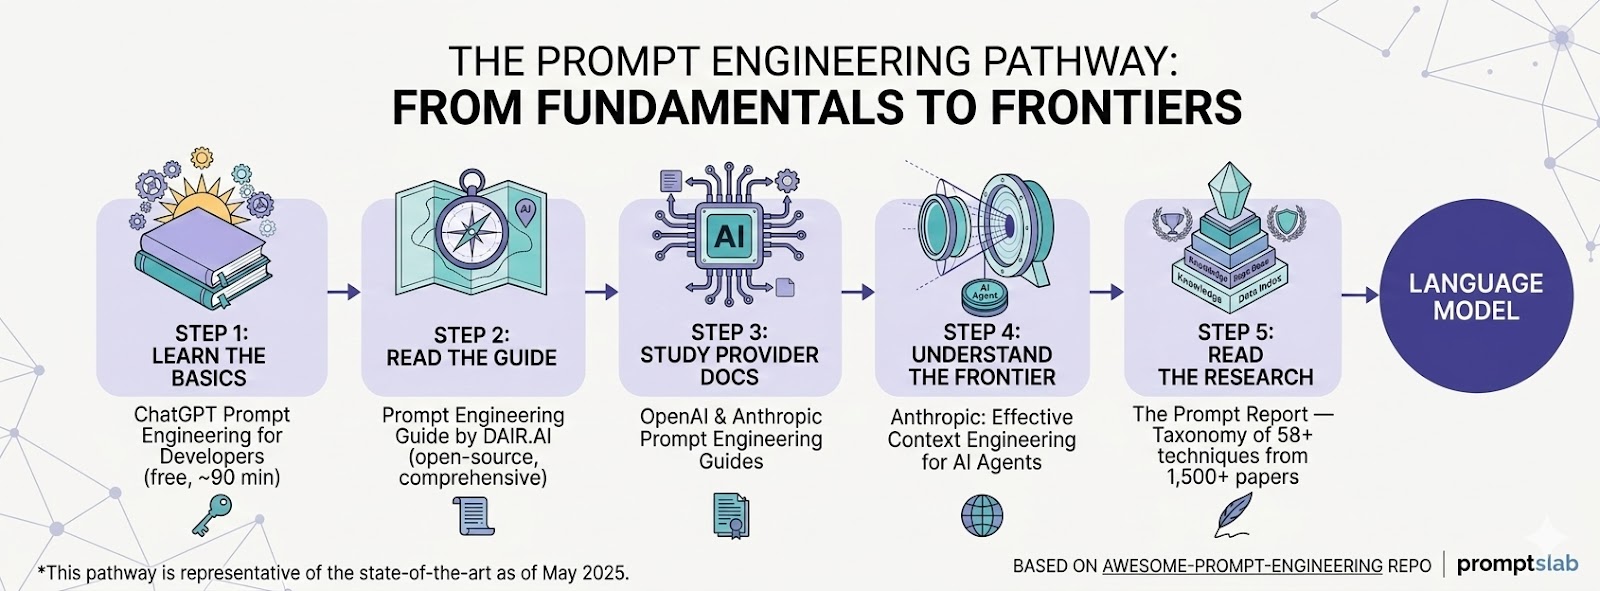
Neu bei prompt engineering? Folgen Sie diesem Weg:

  1. Lernen Sie die Grundlagen → ChatGPT Prompt Engineering für Entwickler (frei, ~90 min)
  2. Lesen Sie den Leitfaden → Prompt Engineering Guide von DAIR. AI (Open-Source, umfassend)
  3. Studienanbieter Docs → OpenAI Prompt Engineering Guide · Anthropischer Prompt Engineering Guide
  4. Verstehen Sie, wohin das Feld geht → Anthropic: Effektives Context Engineering für KI-Agenten
  5. Lesen Sie die Forschung → Der Prompt Report — Taxonomie von 58+ Aufforderungstechniken aus 1.500+ Papieren


📄

Diese Papiere etablierten die Kernkonzepte, auf denen das moderne prompte Engineering aufbaut:


🔧

NameBeschreibungLink
PromptfooOpen-Source-CLI zum Testen, Auswerten und Red-Teaming von LLM-Anweisungen. YAML-Konfigurationen, CI/CD-Integration, kontradiktorische Tests. ~9K+ ⭐GitHub
PromptifyNLP lösen Probleme mit LLM & Einfach generieren verschiedene NLP Task-Anweisungen für beliebte generative Modelle wie GPT, PaLM und mehr mit Promptify[Github]
AgentaOpen-Source-LM-Entwicklerplattform für promptes Management, Evaluierung, menschliches Feedback und Bereitstellung.GitHub
PromptLayerVersionieren, testen und überwachen Sie jede Eingabeaufforderung und jeden Agenten mit robusten Evals-, Tracing- und Regressionssätzen.Website
HeliconeProduktions prompt Überwachungs- und Optimierungsplattform.Website
LangGPTFramework für strukturiertes und Meta-Prompt Design. 10K+ ⭐GitHub
ChainForgeVisuelles Toolkit zum Erstellen, Testen und Vergleichen von LLM-Antworten ohne Code.GitHub
LMQLEine Abfragesprache für LLMs, die komplexe prompte Logik programmierbar macht.GitHub
PromptotypePlattform zum Entwickeln, Testen und Verwalten strukturierter LLM-Aufforderungen.Website
PromptPandaKI-gestütztes promptes Managementsystem zur Optimierung von prompten Workflows.Website
Promptimize AIBrowser-Erweiterung zur automatischen Verbesserung der Benutzeraufforderungen für jedes AI-Modell.Website
PROMPTMETHEUSWebbasierte “Prompt Engineering IDE” zum iterativen Erstellen und Ausführen von Eingabeaufforderungen.Website
Better PromptTesten Sie die Suite für LLM-Eingabeaufforderungen, bevor Sie in die Produktion gehen.GitHub
OpenPromptOpen-Source-Framework für prompt-Learning-Forschung.GitHub
Prompt SourceToolkit zum Erstellen, Teilen und Verwenden natürlicher Sprachaufforderungen.GitHub
Prompt EngineNPM Utility Library zum Erstellen und Verwalten von Eingabeaufforderungen für LLMs (Microsoft).GitHub
PromptInjectFramework für die quantitative Analyse der LLM Robustheit gegenüber gegnerischen prompten Angriffen.GitHub
LynxPromptSelf-Hostable Plattform zur Verwaltung von AI IDE-Konfigdateien (.cursorrules, CLAUDE.md, copilot-instructions.md). Web-Benutzeroberfläche, REST-API, CLI und föderierter Blueprint-Marktplatz für über 30 KI-Codierungsassistenten.GitHub
flomptVisual AI prompt builder, der Eingabeaufforderungen in 12 semantische Blöcke (Rolle, Kontext, Einschränkungen, Beispiele usw.) zerlegt und in optimiertes XML kompiliert. Browser-Erweiterung für ChatGPT/Claude/Gemini und MCP-Server für Claude Code-Agenten. Frei, Open Source.Website
NameBeschreibungLink
DeepEvalOpen-Source-Evaluierungs-Framework für RAG, Agenten und Gespräche mit CI / CD-Integration. ~7K + ⭐GitHub
RagasRAG-Bewertung mit Knowledge-Graph-basierter Testset-Generierung und 30+ Metriken. ~8K+ ⭐GitHub
LangSmithLangChains Plattform zum Debuggen, Testen, Auswerten und Überwachen von LLM-Anwendungen.Website
LangfuseOpen-Source-LLM-Beobachtung mit Rückverfolgung, promptem Management und menschlicher Anmerkung. ~7K + ⭐GitHub
BraintrustEnd-to-End AI-Evaluierungsplattform, SOC2 Typ II zertifiziert.Website
Arize AI / PhoenixEchtzeit-LM-Überwachung mit Drifterkennung und -aufspürung.GitHub
TruLensBewertung und Erklärung von LLM-Apps; verfolgt Halluzinationen, Relevanz, Erdung.GitHub
InspectAIZweckgebunden für die Bewertung von Agenten gegen Benchmarks (UK AISI).GitHub
OpikBewerten, Testen und Versenden von LLM-Anwendungen über Dev- und Produktionslebenszyklen hinweg.GitHub
EvalViewCLI-Tool zum Testen von mehrstufigen KI-Agenten mit YAML-Testfällen, Regressionserkennung und Produktionsüberwachung.GitHub
NameBeschreibungLink
LangChain / LangGraphDas am weitesten verbreitete LLM-App-Framework LangGraph fügt graphenbasierte mehrstufige Agenten-Workflows hinzu. ~100K+ / ~10K+GitHub · LangGraph
CrewAIRollenspiel-AI-Agent-Orchestrierung mit 700+ Integrationen. ~44K+ ⭐GitHub
AutoGen (AG2)Microsofts multi-agenten-konversations-framework. ~ 40K + ⭐GitHub
DSPyStanfords Framework für die Programmierung von LLMs mit automatischer prompt / Gewichtsoptimierung. 22K+ ⭐GitHub
OpenAI Agents SDKOfficial Agent Framework mit Funktionsaufruf, Leitplanken und Handoffs. ~ 10K + ⭐GitHub
Semantic KernelMicrosofts AI-Framework mit M365 Copilot; C#, Python, Java. ~24K + ⭐GitHub
LlamaIndexDatenrahmen für RAG- und Agentenfähigkeiten. ~ 40K + ⭐GitHub
HaystackOpen-Source NLP Framework mit Pipeline-Architektur für RAG und Agenten. ~ 20K + ⭐GitHub
Agno (formerly Phidata)Python Agent Framework mit Mikrosekunden-Instanziation. ~ 20K + ⭐GitHub
SmolagentsHugging Faces minimalistisches codezentriertes Agenten-Framework (~1000 LOC). ~15K + ⭐GitHub
Pydantic AIType-Safe Agent Framework mit Pydantic für strukturierte Validierung. ~8K+ ⭐GitHub
MastraTypeScript AI Agent Framework mit Assistenten, RAG und Beobachtbarkeit. ~ 20K + ⭐GitHub
Google ADKAgent Development Kit ist tief in Gemini und Google Cloud integriert.GitHub
Strands Agents (AWS)Modell-agnostisches Framework mit tiefen AWS-Integrationen.GitHub
LangflowNode-basierter Visual Agent Builder mit Drag-and-Drop. ~50K + ⭐GitHub
n8nWorkflow-Automatisierung mit KI-Agentenfähigkeiten und 400+ Integrationen. ~ 60K + ⭐GitHub
DifyAll-in-One Backend für agentische Workflows mit Tool-Using Agents und RAG.GitHub
PraisonAIMulti-AI Agents Framework mit mehr als 100 LLM-Unterstützung, MCP-Integration und integriertem Speicher.GitHub
NeurolinkMulti-Provider AI Agent Framework vereint 12+ Anbieter mit Workflow-Orchestrierung.GitHub
ComposioVerbinden Sie über 100 Tools mit KI-Agenten mit Null-Setup.GitHub
NameBeschreibungLink
DSPyMehrere Optimierer (MIPROv2, BootstrapFewShot, COPRO) für automatisches promptes Tuning. ~22K+ ⭐GitHub
TextGradAutomatische Differenzierung über Text (Stanford). ~2K+ ⭐GitHub
OPROGoogle DeepMind Optimierung durch Aufforderung.GitHub
NameBeschreibungLink
Garak (NVIDIA)LLM-Vulnerabilitätsscanner für Halluzinationen, Injektionen und Jailbreaks - die “Nmap für LLMs”. ~3K + ⭐GitHub
PyRIT (Microsoft)Python Risk Identification Tool für automatisiertes Red-Teaming. ~3K+GitHub
DeepTeam40+ Schwachstellen, 10+ Angriffsmethoden, OWASP Top 10 Unterstützung.GitHub
LLM GuardSicherheits-Toolkit für die LLM-I/O-Validierung. ~2K+ ⭐GitHub
NeMo Guardrails (NVIDIA)Programmierbare Leitplanken für Konversationssysteme. ~5K+ ⭐GitHub
Guardrails AIDefinieren Sie strenge Ausgabeformate (JSON-Schemata), um die Zuverlässigkeit des Systems zu gewährleisten.Website
LakeraKI-Sicherheitsplattform für Echtzeit-Injektionserkennung.Website
Purple Llama (Meta)Open-Source LLM Sicherheitsbewertung einschließlich CyberSecEval.GitHub
GPTFuzzAutomatisierte Jailbreak-Vorlagengenerierung mit Erfolgsquoten von > 90 %.GitHub
RebuffOpen-Source-Tool zur Erkennung und Verhinderung einer sofortigen Injektion.GitHub
AgentSeal“Open-Source-Scanner, der 150 Angriffssonden ausführt, um KI-Agenten auf schnelle Injektions- und Extraktionslücken zu testen.”GitHub

MCP ist ein offener Standard, der von Anthropic (November 2024, gespendet an Linux Foundation Dezember 2025) für die Verbindung von KI-Assistenten mit externen Datenquellen und Tools über eine standardisierte Schnittstelle entwickelt wurde. Es hat 97M+ monatliche SDK Downloads und wurde von GitHub, Google und den meisten großen KI-Anbietern übernommen.

NameBeschreibungLink
MCP SpecificationDie Kernprotokollspezifikation und SDKs. ~15K + ⭐GitHub
MCP Reference ServersOffizielle Implementierungen: fetch, filesystem, GitHub, Slack, Postgres.GitHub
FastMCP (Python)Hohes Python-Framework zum Aufbau von MCP-Servern. ~5K + ⭐GitHub
GitHub MCP ServerGitHubs offizieller MCP-Server für Repo-, Issue-, PR- und Action-Interaktion. 15K+ ⭐GitHub
Awesome MCP ServersKuratierte Liste von 10.000+ Community-MCP-Servern. ~ 30K + ⭐GitHub
Context7Der MCP-Server bietet eine versionenspezifische Dokumentation, um die Codehalluzination zu reduzieren.GitHub
GitMCPErstellen Sie entfernte MCP-Server für jedes GitHub-Repo, indem Sie die Domain ändern.Website
MCP InspectorVisuelles Test-Tool für die Entwicklung von MCP-Servern.GitHub

🟢 = Open Source · 🔵 = Kommerziell · 🟣 = Open Source + kommerziell (Open Core mit kostenpflichtiger Cloud/API)

Terminal-native agentische Tools, die Ihre Codebasis verstehen und mehrstufige Aufgaben ausführen.

NameBeschreibungTypLink
Claude CodeAnthropic Agentic Coding CLI; versteht vollständige Codebasen und führt komplexe mehrstufige Aufgaben über natürliche Sprache aus.🔵Docs
OpenAI Codex CLIOpen-Source-Terminalcodierungsagent von OpenAI; leichtgewichtig, local-first, mit Sandbox-Codeausführung. ~68K+ ⭐🟣GitHub
Gemini CLIGoogles Open-Source-Terminal-KI-Agent mit 1M-Token-Kontextfenster und Google Search Grounding. ~96K+ ⭐🟣GitHub
Qwen CodeOpen-Source-Terminal-AI-Agent optimiert für Qwen3-Coder; Multi-Protokoll-Unterstützung (OpenAI / Anthropic / Gemini-APIs), 1.000 kostenlose Anfragen / Tag. ~21K + ⭐🟢GitHub
AiderKI-Paar-Programmierung im Terminal mit tiefer Git-Integration; bildet ganze Codebasen ab und überträgt automatisch Änderungen. ~42K+ ⭐🟢GitHub
OpenCodeLeistungsstarker Open Source AI Coding Agent mit schöner TUI; unterstützt nahezu alle AI Model Anbieter. ~ 120K + ⭐🟢GitHub
GooseErweiterbarer Open-Source-AI-Agent von Block (Square/Cash App); installiert, führt aus, bearbeitet und testet mit jedem LLM. ~29K + ⭐🟢GitHub
CrushGlamorous Agentic Coding Agent von Charmbracelet mit Multi-Modell-Unterstützung, LSP-Integration und schöner Terminal-Benutzeroberfläche. ~9K + ⭐🟢GitHub
Amazon Q Developer CLIAgentische Chat-Erfahrung im Terminal von AWS; Übergang zu Kiro CLI.🟣GitHub
AmpSourcegraph Agentic Coding Tool (Cody Nachfolger); funktioniert über CLI und IDE.🔵Website
Junie CLIJetBrains LLM-agnostic Coding Agent CLI (Beta 2026); unterstützt alle großen Modellanbieter.🔵Website
Autohand Code CLISelbstentwickelnder autonomer Terminal-Codierungsagent mit Multi-Provider-LM-Unterstützung, 40+ Tools und modularem Fähigkeitensystem.🟢GitHub

Standalone-Editoren oder IDE-Forks mit tiefer KI-Integration.

NameBeschreibungTypLink
CursorFührender AI-nativer Code-Editor (VS-Code-Fork); Composer generiert ganze Apps aus natürlicher Sprache, agentische Multi-Datei-Bearbeitungen.🔵Website
WindsurfAI-powered IDE (VS Code Fork) mit proprietärem Cascade Agent und SWE-1.5 Modell; erworben von Cognition AI.🔵Website
ZedHochleistungs-Editor in Rust mit nativen AI-Funktionen, Zeta-Vorhersage und Unterstützung des Agent Client Protocol. ~77K+ ⭐🟢GitHub
TraeKostenlose KI-basierte IDE von ByteDance (“The Real AI Engineer”) mit Builder-Modus; bietet kostenlosen Zugang zu Claude, GPT-4o und DeepSeek.🔵Website
Google AntigravityGoogles Agent-First IDE (VS-Code-Fork) mit Manager-Ansicht zum Orchestrieren mehrerer Agenten parallel; powered by Gemini.🔵Website
KiroAWS’s spec-driven agentic AI IDE (VS Code Fork); verwandelt Eingabeaufforderungen in Spezifikationen, dann Arbeitscode, Dokumente und Tests.🔵Website
PearAIOpen-Source AI Code Editor (VS Code Fork) mit Continue-basiertem Chat und Fertigstellungen. ~ 40K + ⭐🟢GitHub
VoidOpen-Source-Cursor-Alternative (VS-Code-Fork); jedes Modell oder lokales Hosting mit Änderungsvisualisierung. 28K+ ⭐🟢GitHub
MeltyOpen-Source-Chat-erster AI-Code-Editor mit Multi-Datei-Bearbeitung und tiefer Git-Integration. ~7K + ⭐🟢GitHub
EmdashOpen-Source Agentic Dev Environment (YC W26) zum parallelen Ausführen mehrerer Codierungsagenten in isolierten Git-Worktrees.🟢GitHub

Plugins für VS Code, JetBrains, Neovim und andere Editoren.

NameBeschreibungTypLink
GitHub CopilotDer am weitesten verbreitete KI-Codierungsassistent; Inline-Fertigstellungen, Chat und Agentic Codierungsagent über VS Code, JetBrains, Neovim.🔵Website
ClineAutonomer Codierungsagent in VS Code mit Human-in-the-Loop-Zulassungen; Dateibearbeitung, Terminalbefehle und Browsernutzung. ~ 59K + ⭐🟢GitHub
ContinueOpen-Source-VS-Code und JetBrains-Erweiterung für die Erstellung benutzerdefinierter, modularer KI-Entwicklungssysteme; jedes Modell. ~32K + ⭐🟢GitHub
CodySourcegraph-basierter KI-Assistent, der Kontext aus lokalen und entfernten Codebasen zieht; VS Code, JetBrains, Visual Studio.🔵Website
CodeiumKostenlose ki-codierungserweiterung für 40 + ides mit vervollständigungen, chat und suche in 70 + sprachen.🟣Website
Amazon Q DeveloperDer AI-Codierungsassistent von AWS mit Fertigstellungen, Inline-Chat und Agentenmodus; tiefe AWS-Integration.🟣Website
Gemini Code AssistGoogles IDE-Erweiterung powered by Gemini mit Fertigstellungen, Next Edit Predictions und Inline-Diffs; kostenlos für Einzelpersonen.🟣Website
TabnineDatenschutzorientierter KI-Assistent, der auf permissiv lizenziertem OSS geschult ist; unterstützt alle wichtigen IDEs bei der lokalen Bereitstellung.🔵Website
Augment CodeEnterprise AI Codierassistent mit 200K-Token Context Engine für tiefes Codebasisverständnis.🔵Website
QodoAI Code Review und Qualitätsplattform mit Multi-Agent-Architektur; Testgenerierung, Code Review, CI/CD Durchsetzung.🟣Website
CodeGeeXOpen-Source-Modell zur mehrsprachigen Codegenerierung unterstützt 20+ Sprachen mit VS-Code und JetBrains-Erweiterungen. ~11K+ ⭐🟢GitHub
TabbySelbst gehosteter Open-Source-KI-Codierungsassistent (Copilot-Alternative); läuft vollständig auf Ihrer Infrastruktur. 25K+ ⭐🟢GitHub

Browserbasierte oder Cloud-gehostete Agenten, die autonom erstellen, testen und bereitstellen.

NameBeschreibungTypLink
DevinErster vollständig autonomer Cloud-basierter KI-Software-Ingenieur; plant, programmiert, testet und öffnet PRs unabhängig.🔵Website
Replit AgentCloud-nativer KI-Agent, der autonom Full-Stack-Apps im Browser erstellt, testet und bereitstellt; 50+ Sprachen.🔵Website
bolt.newKI-gestützter Web-Dev-Agent; Aufforderung, Ausführung, Bearbeitung und Bereitstellung von Full-Stack-Apps direkt im Browser über WebContainers. 15K+ ⭐🟢GitHub
bolt.diyCommunity Fork von bolt.new mit erweiterten Funktionen und breiterer LLM-Flexibilität. ~12K + ⭐🟢GitHub
LovableFull-Stack-Apps aus natürlicher Sprache mit eingebauter Supabase, Auth und One-Click-Bereitstellung; schnellstes europäisches Startup auf 20 Millionen US-Dollar.🔵Website
v0Vercels KI-Plattform zur Generierung von hochwertigem React/Next. js UI-Komponenten aus natürlicher Sprache.🔵Website
GitHub Copilot WorkspaceCloud-basierte Codierungsumgebung mit Plan, Brainstorming und Reparaturagenten; in den kostenpflichtigen Copilot-Plänen enthalten.🔵Website
Firebase StudioGoogles agentische Cloud-basierte Entwicklungsumgebung.🔵Website

Frameworks und Forschungsprojekte zum Aufbau autonomer Codierungsagenten.

NameBeschreibungTypLink
OpenHandsFührende Open-Source-Plattform für Cloud-Codierungsagenten; konsequent top auf SWE-bench. Früher OpenDevin. ~69K + ⭐🟢GitHub
SWE-agentBehebt ein GitHub-Problem und behebt es automatisch mit einer benutzerdefinierten Agent-Computer-Schnittstelle. [NeurIPS 2024] ~ 19K + ⭐🟢GitHub
Open SWEDas in der Cloud gehostete async Coding Agent Framework von LangChain basiert auf LangGraph mit Slack/Linear-Integration. ~8K+ ⭐🟢GitHub
DevikaOpen-Source Agentic Software Engineer; bricht Anweisungen auf, recherchiert und schreibt Code. Devin Alternative. ~ 18K + ⭐🟢GitHub
AutoCodeRoverAutonome Programmverbesserung kombiniert LLMs mit Fehlerlokalisierung für die Lösung von GitHub-Problemen. ~2.8K + ⭐🟢GitHub
AgentlessEinfacher dreiphasiger Ansatz (localize → repair → validate) zur Lösung von Softwareentwicklungsproblemen. ~2K+ ⭐🟢GitHub
DevonOpen-Source-Paar-Programmierer SWE-Agent mit Code-Schreiben, Planung und Forschung; unterstützt Claude, GPT-4, Llama, Ollama. 3,5K+ ⭐🟢GitHub
NameBeschreibungLink
Prompt Engineering Guide (DAIR.AI)Der definitive Open-Source-Guide und Ressourcen-Hub. 3M + Lernende. ~ 55K + ⭐GitHub
Awesome ChatGPT Prompts / Prompts.chatWeltweit größte Open-Source-Prompt-Bibliothek. Tausende von Aufforderungen für alle wichtigen Modelle.GitHub
12-Factor AgentsPrinzipien für den Aufbau von LLM-basierter Software in Produktionsqualität. ~ 17K + ⭐GitHub
NirDiamant/Prompt_Engineering22 praktische Jupyter Notebook Tutorials. ~3K + ⭐GitHub
Context Engineering RepositoryErste Prinzipien Handbuch für den Übergang über prompt Engineering zu Kontext-Design.GitHub
AI Agent System Prompts LibrarySammlung von Systemaufforderungen aus Produktions-KI-Codeagenten (Claude Code, Gemini CLI, Cline, Aider, Roo Code).GitHub
Awesome Vibe CodingKuratierte liste von 245+ tools und ressourcen zum erstellen von software durch natürliche sprachaufforderungen.GitHub
OpenAI CookbookOffizielle Rezepte für Eingabeaufforderungen, Tools, RAG und Auswertungen.GitHub
EmbedchainFramework zum Erstellen von ChatGPT-ähnlichen Bots über Ihren Datensatz.GitHub
ThoughtSourceFramework für die Wissenschaft des maschinellen Denkens.GitHub
PromptextExtrahieren und Formate Code-Kontext für AI-Eingabeaufforderungen mit Token-Zählung.GitHub
Price Per TokenVergleichen Sie die LLM API-Preise für über 200 Modelle.Website
OpenPawCLI-Werkzeugnpx pawmode), die Claude Code in einen persönlichen Assistenten verwandelt, indem Systemaufforderungen (CLAUDE.md + SOUL.md) mit Persönlichkeit, Gedächtnis und 38 Skill-Routern generiert werden.GitHub
Think BetterOpen-Source-CLI, das 10 strukturierte Entscheidungsrahmen (MECE, Issue Trees, Pre-Mortems) und 12 kognitive Bias-Detektoren dauerhaft in KI-Assistenten-Aufforderungen einspeist. Go, MIT.GitHub

💻

ModellKontextPreis (Input/Output pro 1M Token)Hauptmerkmal
GPT-5.2 / 5.2 Thinking400K$1.75 / $14Neuestes Flaggschiff, 90% Cached-Rabatt, konfigurierbare Argumentation
GPT-5.1400K$1.25 / $10Flaggschiff der vorherigen Generation
GPT-4.1 / 4.1 mini / nano1M$2 / $8Bestes Nicht-Grundmodell, 40% schneller und 80% billiger als GPT-4o
o3 / o3-pro200KSortenReasoning-Modelle mit nativem Tool
o4-mini200KKosteneffizientSchnelles Denken, am besten auf AIME in seiner Kostenklasse
GPT-OSS-120B / 20B128K$0.03 / $0.30Erste offene Modelle, Apache 2.0

Hauptfunktionen: Responses API, Agents SDK, Structured Outputs, Function Calling, promptes Caching (90% Rabatt), Batch API (50% Rabatt), MCP-Unterstützung. Plattform Docs

ModellKontextPreis (Input/Output pro 1M Token)Hauptmerkmal
Claude Opus 4.61M (Beta)$5 / $25Leistungsstärkste, modernste Codierung und agentische Aufgaben
Claude Sonnet 4.5200K$3 / $15Bestes Codierungsmodell, 61,4% OSWorld (Computernutzung)
Claude Haiku 4.5200KSchnelles TierNahe der Grenze, schnellste Modellklasse
Claude Opus 4 / Sonnet 4200K$ 15 / $ 75 (Opus)Opus: 72,5% SWE-Bench, Sonnet 4 Powers GitHub Copilot

Hauptmerkmale: Extended Thinking mit Tool-Nutzung, Computer-Nutzung, MCP (hier entstanden), promptes Caching, Claude Code CLI, verfügbar bei AWS Bedrock und Google Vertex AI. API Docs

ModellKontextPreis (Input/Output pro 1M Token)Hauptmerkmal
Gemini 3 Pro Preview1M$2 / $12Das intelligenteste Google-Modell, das auf 2B+ bereitgestellt wird Suchbenutzer
Gemini 2.5 Pro1M$1.25 / $10Am besten für Codierung /agentische Aufgaben, Denkmodell
Gemini 2.5 Flash / Flash-Lite1M$0.30/$1.50 · $0.10/$0.40Preis-Leistungsführer

Hauptmerkmale: Denken (alle 2.5+ Modelle), Google Search Grounding, Codeausführung, Live API (Echtzeit-Audio / Video), Kontext-Caching. Google AI Studio

ModellArchitekturKontextHauptmerkmal
Llama 4 Scout109B MoE / 17B aktiv10MPasst Single H100, multimodal, Offengewicht
Llama 4 Maverick400B MoE / 17B aktiv, 128 Experten1MBeats GPT-4o, offenes Gewicht
Llama 3.3 70Bdicht128KSpiele Llama 3.1 405B

Verfügbar für über 25 Cloud-Partner, Hugging Face und Inferenz-APIs. Llama

AnbieterBeschreibungLink
Mistral AIMistral Large 3 (675B MoE), Devstral 2, Ministral 3. Apache 2.0.Website
DeepSeekV3.2 (671B MoE), R1 (Gründung, MIT-Lizenz). $0,15 / $0,75 pro 1M Token.Website
xAI (Grok)Grok 4.1 Schnell: 2M Kontext, $0,20/$0,50 pro 1M Token.Website
CohereBefehl A (111B, 256K Kontext), Embed v4, Rang 4.0. Excels bei RAG.Website
Together AI200+ offene Modelle mit einer Latenz von unter 100ms.Website
GroqLPU-Hardware mit ~ 300 + Token / sec Inferenz.Website
Fireworks AISchnelle Rückschlüsse auf HIPAA + SOC2-Compliance.Website
OpenRouterUnified API für 300+ Modelle aller Anbieter.Website
CerebrasWafer-Chips mit der besten Gesamtantwortzeit.Website
Perplexity AISearch-Augmented API mit Zitaten.Website
Amazon BedrockManaged Multi-Modell-Service mit Claude, Llama, Mistral, Cohere.Website
Hugging Face InferenceZugriff auf offene Modelle über API.Website

💾

NameBeschreibungLink
Chatbot Arena / LM Arena6M + Benutzer stimmen für Elo-bewertete paarweise LLM-Vergleiche. De facto Standard für menschliche Präferenz.Website
MMLU-Pro12.000+ Diplom-Level-Fragen in 14 Domänen. NeurIPS 2024 Spotlight.GitHub
GPQA448 “Google-proof” STEM-Fragen; Nicht-Experten-Validatoren erreichen nur 34%.arXiv
SWE-bench VerifiedHuman-validated 500-Task-Subset für die reale GitHub-Problemlösung.Website
SWE-bench Pro1.865 Aufgaben in 41 professionellen Repos; beste Modelle erzielen nur ~23%.Leaderboard
Humanity’s Last Exam (HLE)2.500 Experten-geprüfte Fragen; Top-KI erzielt nur ~10-30%.Website
BigCodeBench1.140 Kodierungsaufgaben in 7 Domänen; KI erreicht ~ 35,5 % gegenüber 97 % menschlichen Erfolg.Leaderboard
LiveBenchKontaminationsresistent mit häufig aktualisierten Fragen.Paper
FrontierMathMathematik auf Forschungsebene; AI löst nur ~ 2% der Probleme.Forschung
ARC-AGI v2Abstraktes Denken zur Messung der fluiden Intelligenz.Forschung
IFEvalInstruktionsfolgende Auswertung mit Formatierungs- / Inhaltsbeschränkungen.arXiv
MLE-benchDie ML-Engineering-Evaluierung von OpenAI über Aufgaben im Kaggle-Stil.GitHub
PaperBenchBewertet die Fähigkeit von AI, 20 ICML 2024 Papiere von Grund auf neu zu replizieren.GitHub
NameBeschreibungLink
Hugging Face Open LLM Leaderboard v2Bewertet offene Modelle auf MMLU-Pro, GPQA, IFEval, MATH.Leaderboard
Artificial Analysis Intelligence Index v3Aggregiert 10 Auswertungen.Website
SEAL by Scale AIHosts SWE-bench Pro und agentische Auswertungen.Leaderboard
NameBeschreibungLink
P3 (Public Pool of Prompts)Sofortvorlagen für 270+ NLP-Aufgaben, die zum Trainieren von T0 und ähnlichen Modellen verwendet werden.HuggingFace
System Prompts Dataset944 Systemaufforderungsvorlagen für Agenten-Workflows (von Daniel Rosehill, Aug 2025).HuggingFace
OpenAssistant Conversations (OASST)161.443 Nachrichten in 35 Sprachen mit 461.292 Qualitätsbewertungen.HuggingFace
UltraChat / UltraFeedbackGroß angelegte synthetische Instruktions- und Präferenzdatensätze für das Ausrichtungstraining.HuggingFace
SoftAge Prompt Engineering Dataset1.000 verschiedene Aufforderungen in 10 Kategorien zum Benchmarking der prompten Leistung.HuggingFace
Text Transformation Prompt LibraryUmfassende Sammlung von Texttransformationsaufforderungen (Mai 2025).HuggingFace
Writing Prompts~ 300K von Menschen geschriebene Geschichten gepaart mit Aufforderungen von r / WritingPrompts.Kaggle
Midjourney PromptsTextaufforderungen und Bild-URLs, die von MidJourneys öffentlicher Discord abgekratzt wurden.HuggingFace
CodeAlpaca-20k20.000 Programmieranweisungs-Ausgabe-Paare.HuggingFace
ProPEX-RAGDatensatz zur zeitnahen Optimierung in RAG-Workflows.HuggingFace
NanoBanana Trending PromptsÜber 1.000 kuratierte AI-Bildaufforderungen von X / Twitter, geordnet nach Engagement.GitHub
NameBeschreibungLink
HarmBench510 schädliche Verhaltensweisen in Standard-, Kontext-, Copyright- und multimodalen Kategorien.Website
JailbreakBenchOpen Robustheit Benchmark für Jailbreaking mit 100 Aufforderungen.Forschung
AgentHarm110 bösartige Agentenaufgaben in 11 Schadenskategorien.arXiv
DecodingTrust243.877 fordert die Bewertung der Vertrauenswürdigkeit in 8 Perspektiven.Forschung
SafetyPrompts.comAggregator Tracking 50+ Sicherheit / Red-Teaming-Datensätze.Website

🧠

ModellAnbieterKontextSchlüsselstärke
GPT-5.2OpenAI400KAllgemeine Intelligenz, 100% AIME 2025
Claude Opus 4.6Anthropisch1M (Beta)Codierung, agentische Aufgaben, erweitertes Denken
Gemini 3 ProGoogle1M#1 LMArena (~1500 Elo), multimodal
Grok 4.1x AI2M#2 LMArena (1483 Elo), niedrige Halluzination
Mistral Large 3Mistral AI256KBestes Freigewicht (675B MoE/41B aktiv), Apache 2.0
DeepSeek-V3.2DeepSeek128KBester Wert (671B MoE/37B aktiv), MIT-Lizenz
Llama 4 MaverickMetadaten1MBeats GPT-4o (400B MoE/17B aktiv), offenes Gewicht
ModellSchlüsselangaben
OpenAI o3 / o3-pro87,7% GPQA Diamond. Native Tool verwenden.
OpenAI o4-miniBest AIME in seiner Kostenklasse mit visuellem Denken.
DeepSeek-R1 / R1-0528Freigewicht, RL-trainiert. 87,5% auf AIME 2025. MIT-Lizenz.
QwQ (Qwen with Questions)32B Argumentationsmodell. Apache 2.0. Vergleichbar mit R1.
Gemini 2.5 Pro/Flash (Thinking)Eingebautes Denken mit konfigurierbarem Denkbudget.
Claude Extended ThinkingHybridmodus mit sichtbarer Gedankenkette und Werkzeugnutzung.
Phi-4 Reasoning / Plus14B Argumentationsmodelle konkurrieren mit viel größeren Modellen. Offengewicht.
GPT-OSS-120BOpenAIs offenes Gewicht mit CoT. Nahezu Parität mit o4-mini. Apache 2.0.
ModellAnbieterSchlüsselangaben
Qwen3-235B-A22BAlibabaFlaggschiff MoE: Starke Argumentation/Code/mehrsprachig. Apache 2.0. Meist heruntergeladene Familie auf HuggingFace.
Gemma 3Google270M bis 27B. Multimodal. 128K Kontext. 140+ Sprachen.
OLMo 2/3Allen AIVollständig geöffnet (Daten, Code, Gewichte, Protokolle). OLMo 2 32B übertrifft GPT-3.5. Apache 2.0.
SmolLM3-3BGesicht umarmenÜbertrifft Llama-3.2-3B. Dual-Mode-Überlegung. 128K Kontext.
Kimi K2Moonshot AI32B aktiv. Offengewicht. Maßgeschneidert für die Kodierung/agentische Verwendung.
Llama 4 ScoutMetadaten109B MoE/17B aktiv. 10M Token Kontext. Passt Single H100.
ModellSchlüsselangaben
Qwen3-Coder (480B-A35B)69,6% SWE-Bench - Meilenstein für Open-Source-Codierung. 256K Kontext. Apache 2.0.
Devstral 2 (123B)72,2% SWE-Bank verifiziert. 7x kostengünstiger als Claude Sonnet.
Codestral 25.01Mistrals Codemodell. 80+ Sprachen. Fill-in-the-Middle Unterstützung.
DeepSeek-Coder-V2236B MoE / 21B aktiv. 338 Programmiersprachen.
Qwen 2.5-Coder7B/32B. 92 Programmiersprachen. 88,4% HumanEval. Apache 2.0.

Diese Modelle etablierten Schlüsselkonzepte, sind aber für den praktischen Einsatz weitgehend abgelöst:

ModellAnbieterBedeutung
GLM-130BTsinghuaOffenes zweisprachiges Englisch/Chinesisch LLM (2023)
Falcon 180BTIIGroßes offenes generatives Modell (2023)
Mixtral 8x7BMistral AIWegweisende MoE-Architektur für offene Modelle (2023)
GPT-NeoX-20BEleutherAIFrühe offene autoregressive LLM
GPT-J-6BEleutherAIFrühes offenes kausales Sprachmodell

🔎

NameGenauigkeitHauptmerkmalLink
GPTZero99 % behauptet10M+ Benutzer, #1 auf G2 (2025). Detects GPT-4/5, Gemini, Claude, Llama. Freie Stufe verfügbar.Website
Originality.ai98–100% (Peer-Review)Konsequent am genauesten bewertet. Kombiniert KI-Erkennung + Plagiat + Faktenprüfung. Ab $ 14.95 / Monat.Website
Turnitin AI Detection98%+ auf unmodifiziertem KI-TextDominant in der Wissenschaft. Start der AI-Bypasser-/Humanizer-Erkennung (Aug 2025). Institutionelle Lizenzierung.Website
Copyleaks99%+ behauptetEnterprise Tool erkennt KI in mehr als 30 Sprachen. LMS Integrationen.Website
Winston AI99,98 % beanspruchtOCR für gescannte Dokumente, AI Image/Deepfake Detection. 11 Sprachen.Website
Pangram Labs99,3% (COLING 2025)Höchste Punktzahl in COLING 2025 Shared Task. 100% TPR auf “humanisierten” Text. 97,7% gegnerische Robustheit.Website
NameBeschreibungLink
BinocularsOpen-Source-Forschungsdetektor mit Querperplexität zwischen zwei LLMs.arXiv
DetectGPT / Fast-DetectGPTStatistisches Verfahren zum Vergleich von Log-Wahrscheinlichkeiten von Originaltext vs. Störungen.arXiv
Openai DetectorAI-Klassifikator zur Anzeige von AI-geschriebenem Text (OpenAI Detector Python Wrapper)[GitHub]
Sapling AI DetectorKostenloser browserbasierter Detektor (bis zu 2.000 Zeichen). 97% Genauigkeit in einigen Studien.Website
QuillBot AI DetectorKostenlos, keine Anmeldung erforderlich.Website
Writer AI Content DetectorKostenloses Tool mit farbcodierten Ergebnissen.Website
ZeroGPTBeliebte freie Detektor in mehreren akademischen Studien ausgewertet.Website
NameBeschreibungLink
SynthID (Google DeepMind)Wasserzeichen für ki-text, bilder und audio über statistische token-sampling. Wird in Google-Produkten eingesetzt.Website
OpenAI Text WatermarkingEntwickelt, aber noch experimentell ab 2025. Forschung zeigt Fragilität Bedenken.Experimentell

Wichtiger Vorbehalt: Kein Detektor behauptet 100% Genauigkeit. Gemischter menschlicher / KI-Text bleibt am schwersten zu erkennen (50-70% Genauigkeit). Gegensätzliche Robustheit variiert stark. Der Markt für KI-Erkennung wird voraussichtlich von ~ 2,3 Mrd. USD (2025) auf 15 Mrd. USD bis 2035 wachsen.


📖

TitelAutor(en)HerausgeberJahr
Prompt Engineering for LLMsJohn Berryman und Albert ZieglerO’Reilly2024
Prompt Engineering for Generative AIJames Phoenix und Mike TaylorO’Reilly2024
Prompt Engineering for LLMsThomas R. CaldwellUnabhängig2025
TitelAutor(en)HerausgeberJahr
AI Engineering: Building Applications with Foundation ModelsChip HuyenO’Reilly2025
Build a Large Language Model (From Scratch)Sebastian RaschkaBesatzung2024
Building LLMs for ProductionLouis-François Bouchard und Louie PetersO’Reilly2024
LLM Engineer’s HandbookPaul Iusztin und Maxime LabonnePackung2024
The Hundred-Page Language Models BookAndriy BurkovSelbstveröffentlichung2025
TitelAutor(en)HerausgeberJahr
Building Applications with AI AgentsMichael AlbadaO’Reilly2025
AI Agents and ApplicationsRoberto InfanteBesatzung2025
AI Agents in ActionMicheal LanhamBesatzung2025
TitelAutor(en)HerausgeberJahr
LLMs in ProductionChristopher Brousseau und Matthew SharpBesatzung2025
Building Reliable AI SystemsRush ShahaniBesatzung2025
The Developer’s Playbook for LLM SecuritySteve WilsonO’Reilly2024

👩‍🏫


📚


🎥


🤝

  • Lernen Sie Promping 40.000+ Mitglieder. Größte PE Discord mit Kursen, Hackathons, HackAPrompt Wettbewerben.
  • PromptsLab Discord - Gemeinschaft
  • Midjournal 1M+ Mitglieder. Primärer Hub für Text-to-Image promptes Teilen.
  • OpenAI Discord Offizielle Community mit Kanälen für GPTs, Sora, DALL-E und API Hilfe.
  • Anthropische Zwietracht - Offizielle Claude-Community für KI-Entwicklungszusammenarbeit.
  • Hugging Face Discord — Modelldiskussionen, Bibliotheksunterstützung, Community-Events.
  • FlowGPT 33K+ Mitglieder. 100K + Aufforderungen über ChatGPT, DALL-E, Stable Diffusion, Claude.
  • r/PromptEngineering - Dediziertes Subreddit für schnelle Handwerkstechniken und Diskussionen.
  • r/ChatGPT 10M+ Mitglieder. Primärer hub für chatgpt-benutzer und promptes teilen.
  • r/LocalLLaMA - Hochtechnische Community für den lokalen Betrieb von Open-Source-LMs.
  • r/ClaudeAI — Claude Community von Anthropic: promptes Teilen, API-Tipps, Modellvergleiche.
  • r/MachineLearning — Akademisch orientierte ML-Forschungsdiskussionen.
  • r/OpenAI — OpenAI Produkt- und API-Diskussionen.
  • r/StableDiffusion 450K+ Mitglieder für AI Art Inputing und Workflows.
  • r/ChatGPTPromptGenius 35K+ Mitglieder teilen und verfeinern Eingabeaufforderungen.
  • LangChain - Open-Source LLM App Framework. 100K+ Sterne.
  • Promptslab — Generative Modelle | Prompt-Engineering | LLMs
  • Gesicht umarmen Zentraler Hub: Transformatoren, Diffusoren, Datensätze, TRL.
  • DSPy (Stanford NLP) Wachsende Community für systematische prompte Optimierung.
  • OpenAI Open-Source-Modelle, Benchmarks und Tools.

Auto-Synced von awesome-autoresearch · Zuletzt synchronisiert: 2026-10-03

  • Kayba-ai/rekursiv verbessern Rekursives Selbstverbesserungs-Framework, bei dem Agenten Ausführungsspuren erfassen, Fehlermuster analysieren und gezielte Korrekturen mit Keep-or-Revert-Bewertung anwenden.
  • vukros/auto-Forschung - Docs-only-Kontrollebene für ein offenes autonomes KI-Forschungslabor - dateibasiertes Betriebsmodell für die Ausführung menschlicher Anweisungen und Agenten.
  • uditgoenka/autoresearch Claude Code Skill, der die Autoresearch in eine wiederverwendbare Schleife für Software, Dokumente, Sicherheit, Versand, Debugging und andere messbare Ziele verallgemeinert.
  • leo-lilinxiao/codex-autoresearch Codex-native Autoresearch-Fähigkeiten mit Unterstützung von Lebensläufen, Lektionen über Läufe hinweg, optionale parallele Experimente und modusspezifische Workflows.
  • junjunjunbong/research loop Autoresearch-style Agent Skill für Codex und Claude Code mit einem deterministischen Läufer, Plan-Hash-Genehmigung, isolierten Git-Worktrees, autoritativer metrischer Auswertung und einem reinen Append-Experiment-Ledger.
  • Xieyulai/Steer - Reguliertes Experiment-Framework, in dem Codierungsagenten Trainingscode bearbeiten und Runden laufen, während die Aufgabe, der Scorer und die Beweise festgelegt bleiben.
  • SeeleAI/Thoth - Dashboard-erste Claude Code- und Codex-Laufzeit für Autoresearch mit dauerhaften Läufen, gesperrten Arbeitselementen, sichtbaren Ledgern und überprüfbaren Urteilen.
  • supratikpm/gemini-autoresearch Gemini CLI Fertigkeit, die Autoresearch auf jedes messbare Ziel verallgemeinert. Gemini-native: verwendet Google Search Grounding als Live-Verifizierungsquelle innerhalb der Schleife, den echten Headless-Night-Modus über —yolo —prompt und den 1M-Token-Kontext. Funktioniert auch in Antigravitations-IDE über .agents/skills/.
  • davebcn87/pi-autoresearch — pi Erweiterung plus Dashboard für persistente Experiment-Loops, Live-Metriken, Konfidenz-Tracking und resumierbare Autorecherche-Sitzungen.
  • drivelineresearch/autoresearch-claude-code — Claude Code Plugin/Skill Port von pi-autoresearch, mit einem sauberen Experiment-Loop-Workflow und einer konkreten Biomechanik Fallstudie.
  • greyhaven-ai/autocontext - Closed-Loop-Kontrollebene für wiederholte Agentenverbesserung mit Auswertung, anhaltendem Wissen, gestufter Validierung und optionaler Destillation zu günstigeren lokalen Laufzeiten.
  • Necmttn/ax Lokale Retro-Schleife für KI-Codierungsagenten: Erfasst Sitzungsspuren, verwandelt wiederholte Reibung in Vorschläge und verfolgt akzeptierte Fixes als Experimente.
  • jmilinovich/goal-md Verallgemeinert autoresearch in eine GOAL.md Muster für Repos, bei denen der Agent zuerst eine messbare Fitnessfunktion aufbauen muss, bevor er optimieren kann.
  • james-s-tayler/fauler Entwickler - Claude Code Skill, der Autoresearch über eine priorisierte Abfolge von Optimierungszielen (Abdeckung, Testgeschwindigkeit, Build-Geschwindigkeit, Komplexität, LOC, Leistung) mit GOAL.md als Engine orchestriert. Unterstützt Standalone und Ralph Mode Multi-Instance Execution.
  • mutable-state-inc/autoresearch-at-home - Collaborative Fork der Upstream-Autoresearch, die Experimente mit Anspruch, gemeinsame Best-Config-Synchronisierung, Hypothesenaustausch und Schwarmkoordination über viele Single-GPU-Agenten hinweg hinzufügt.
  • zkarimi22/autoresearch-anything Verallgemeinert Autoresearch jede messbare Metrik — Systemaufforderungen, API-Performance, Zielseiten, Testsuiten, Config-Tuning, SQL-Abfragen. “Wenn Sie es messen können, können Sie es optimieren.”
  • Entrpi/autoresearch-überall - Plattformübergreifende Erweiterung, die die Hardware-Konfiguration automatisch erkennt und die Schleife startet. Die “Klebstoff und Verallgemeinerung” Hälfte der Autoforschung.
  • ShengranHu/ADAS — Automatisiertes Design von Agentensystemen ICLR 2025. Meta-Agenten, die neuartige Agentenarchitekturen erfinden, indem sie sie in Code programmieren.
  • MaximeRobeyns / selbst_Verbesserung_Kodierung_Agent — SICASelbstverbessernde Codierung Agent, der seine eigene Codebasis bearbeitet. ICLR 2025 Workshop Paper demonstriert Selbstverbesserung auf Gerüstebene bei Codierungsbenchmarks.
  • peterskoett/selbstverbessernder Wirkstoff Alternative selbstverbessernde Agentenarchitektur mit Reflexions- und Meta-Lernzyklen.
  • Metauto-ai/HGM — Huxley-Gödel-Maschine für Codierungsagenten — wendet Selbstverbesserung auf SWE-Bench-Leistung durch Meta-Level-Optimierung.
  • gepa-ai/gepa — GEPA (Genetic-Pareto) — ICLR 2026 Oral. Reflektierende prompte Entwicklung, die RL (GRPO) bei Benchmarks übertrifft. Optimiert alle textuellen Parameter gegen jede Metrik mit Hilfe der natürlichen Sprachreflexion.
  • sentient-agi/EvoSkill Automatisierte Fertigkeitserkennung für Codieragenten: Entwickelt wiederverwendbare Fähigkeiten und Eingabeaufforderungen aus fehlgeschlagenen Trajektorien gegen Benchmarks mit Unterstützung für Claude Code, Codex CLI, OpenCode, OpenHands und Goose.
  • MrTsepa/autoevolve GEPA-inspirierte Autorecherche für Selbstspiel: mutierte Codestrategien, bewerten Kopf-an-Kopf, bewerten mit Elo / Bradley-Terry, Verzweigung von der Pareto-Front. Agent liest Match-Spuren zu Zielmutationen. Funktioniert als Claude Code Skill.
  • HKUDS/ClawTeam - Agent swarm intelligence for autoresearch - erzeugt parallele GPU-Forschungsrichtungen, verteilt die Arbeit auf Agenten und aggregiert Ergebnisse.
  • Orchester-Forschung/AI-Forschung-SKILLs - Umfassende Fertigkeitsbibliothek einschließlich Autoresearch-Orchestrierung mit Zwei-Schleifen-Architektur (innere Optimierung + äußere Synthese).
  • WecoAI/aideml — AIDE: Tree-Search ML Engineering Agent, der die Modellleistung durch iterative Codegenerierung und -auswertung autonom verbessert.
  • weco.ai — WecoCloud-Plattform für AIDE mit Beobachtbarkeit, Experiment-Tracking und Managed Runs bringt die Autoresearch-Schleife in die Produktion.
  • targeting-lab/AutoResearchClaw End-to-End-Forschungspipeline, die ein Thema in Literaturrecherche, Experimente, Analysen, Peer-Review und Papierentwürfe verwandelt; breiter als Autorecherche, aber eindeutig in der gleichen Linie.
  • OpenLAIR/Dr-Klaue Open-Source-Forschungsarbeitsplatz mit sequentiellen Ideen-zu-Papier-Pipelines und integrierten Autoresearch-Toolpacks.
  • OpenRaiser / NanoResearch End-to-End autonome Forschungsmaschine, die Experimente plant, Code generiert, Jobs lokal oder auf SLURM ausführt, reale Ergebnisse analysiert und Papiere schreibt, die auf diesen Ergebnissen basieren.
  • kaust-ark/ARK — ARK (Automatic Research Kit): Idee + Veranstaltungsort → Papierpipeline orchestriert 6 Agenten - Vorschlagsanalyse, Literatursuche, Slurm-Experimente, LaTeX-Entwurf, iterative Peer Review. Angesteuert über CLI, Web-Dashboard oder Telegramm.
  • wanshuiyin/Auto-claude-code-research-in-sleep Markdown-erste Forschungsworkflows für Claude Code und andere Agenten, die sich auf autonome Literaturrecherche, Experimente, Papier-Iteration und modellübergreifende Kritik konzentrieren.
  • skyllwt/AutoSci Wiki-zentrierte Full-Lifecycle-Forschungsplattform, die auf Claude Code basiert und Karpathys LLM-Wiki-Vision realisiert. 20+ Fähigkeiten decken die volle Schleife ab: ingest → ideate → novelty check → experiment design / run / eval → paper writing. Forschungsstaat lebt in einem strukturierten Wissenswiki mit einem interaktiven Graphen.
  • Sibyl-Research-Team/AutoResearch-SibylSystem Vollständig autonomer KI-Wissenschaftler, der auf Claude Code aufbaut, mit expliziter AutoResearch-Linie, Multi-Agenten-Forschungsiteration, GPU-Experimentausführung und einer sich selbst entwickelnden äußeren Schleife.
  • wjc2830/Easy-AutoResearch-for-DeepLearning - Claude Code-Fähigkeit, die eine Autoresearch-Stil, Mensch-gated Deep-Learning-Schleife über sechs Rollen, versionierte Experimente und evidenzgeprüfte Abschluss läuft.
  • eimenhmdt/autoresearcher Frühes Open-Source-Paket zur Automatisierung wissenschaftlicher Arbeitsabläufe, das sich derzeit auf die Generierung von Literaturreviews mit dem Ziel einer breiteren autonomen Forschung konzentriert.
  • Hyperspaceai/Agi Verteiltes, Peer-to-Peer-Forschungsnetzwerk, in dem autonome Agenten Experimente durchführen, Klatschbefunde durchführen, CRDT-Bestenlisten verwalten und Ergebnisse für GitHub in mehreren Forschungsdomänen archivieren.
  • Human-Agent-Gesellschaft/CORAL — KORREAutonome Multiagenten-Evolution für eine offene Entdeckung ()arXiv:2604.01658. Langlaufende Agenten mit gemeinsamem persistentem Gedächtnis, asynchroner Ausführung und Herzschlag-basierten Interventionen; SOTA auf 10 mathematischen / algorithmischen / Systemaufgaben.
  • SakanaAI/AI-Wissenschaftler — Der AI ScientistErstes umfassendes System zur vollautomatischen wissenschaftlichen Entdeckung. Von der Ideengenerierung bis zum Papierschreiben mit minimaler menschlicher Aufsicht.
  • SakanaAI/AI-Wissenschaftler-v2 - Automatisierte wissenschaftliche Entdeckung auf Workshop-Ebene durch agentische Baumsuche. Entfernt die Abhängigkeit von Vorlagen von v1, verallgemeinert sich über Forschungsdomänen hinweg.
  • AweAI-Team/AiScientist — AiScientistLanghorizon-ML-Forschungslabor mit hierarchischer Orchestrierung und File-as-Bus-Koordination - Workspace-Dateien fungieren als dauerhaftes Aufzeichnungssystem. Steuert autonome Papierreproduktion (PaperBench) und MLE-Bench-Iterationsschleifen im Wettbewerbsstil unter festen Rechen- / Zeitbudgets.arXiv 2604.13018)
  • HKUDS/AI-Forscher NeurIPS 2025 Papier. Vollständige End-to-End-Forschungsautomatisierung: Hypothese → Experimente → Manuskript → Peer-Review. Produktionsversion am novix.science.
  • openags/Auto-Research — OpenAGsOrchestriert ein Team von KI-Agenten über den gesamten Forschungslebenszyklus - Lit Review, Hypothesengenerierung, Experimente, Manuskriptschreiben und Peer Review.
  • SamuelSchmidgall/AgentLabor - Ende-zu-Ende autonomer Forschungsworkflow: Idee → Literaturrecherche → Experimente → Bericht. Unterstützt sowohl autonome als auch Co-Pilot-Modi.
  • AgentRxiv - Kollaboratives autonomes Forschungs-Framework, bei dem Agentenlabors einen Preprint-Server gemeinsam nutzen, um auf der Arbeit des anderen iterativ aufzubauen.
  • JinheonBaek/ResearchAgent Iterative Forschung Ideengenerierung über wissenschaftliche Literatur mit LLMs. Multi-Agent Review und Feedback Loops.
  • du-nlp-lab/MLR-Copilot - Autonomes ML-Forschungsrahmenwerk - generiert Ideen, implementiert Experimente und analysiert Ergebnisse.
  • MASWorks/ML-Agent - Verstärkung von LLM-Agenten für autonomes ML-Engineering. Lernt aus Versuch und Irrtum, um die Modellleistung zu verbessern.
  • PouriaRouzrokh/LatteReview Low-Code Python Paket für Automatisierte systematische Literaturrecherche über AI-powered Agenten.
  • LitLLM/LitLLM - KI-gestützter Literaturrechercheassistent mit RAG für genaue, gut strukturierte verwandte Arbeitsabschnitte im akademischen Schreiben.
  • Agentenlaboratorium — Drei-Phasen-Forschungspipeline: Literature Review → Experimentation → Report Writing, mit spezialisierten Agenten für jede Phase.
  • happyhappy-jun/writing-driven-autoresearch - Autoresearch-Stil-Geschirr, das ein einsendebares Papier von der ersten Minute an hält und jedes Experiment aus den Ansprüchen in diesem Entwurf antreibt, indem es Modifizierung → Maßnahme → Verifizierung → Überarbeitung durchführt. 1. Platz am Ralphthon@ICML 2026 autonomer Forschungs-Hackathon.
  • AutoResearch-Fabrik/Agon - End-to-End-Forschungsorchestrator, der auf einem Eckpfeilerprinzip aufgebaut ist, Prompt Economy (wiederverwendbare Schleifen, keine einmaligen Eingabeaufforderungen), plus fünf unterstützende Regeln; führt Wissenschaftler / Coder / Auditor-Schleifen in 10+ Disziplinen durch, die gleiche Wiederverwendbare Schleifenlinie wie Autoresearch, aber skaliert auf vollständige Forschungsprogramme.
  • gianfrancopiana/openclaw-autoresearch - OpenClaw-Port von pi-autoresearch; autonome Experimentierschleife für jedes Optimierungsziel mit statistischer Konfidenzbewertung.
  • miolini/autoresearch-macos - Weit verbreiteter macOS-Fork, der Upstream-Autoresearch für Apple Silicon / MPS anpasst und gleichzeitig die ursprüngliche Schleifenform beibehält.
  • trevin-creator/autoresearch-mlx - MLX-nativer Apple Silicon Port, der das vorgelagerte Fixed-Budget hält val_bpb Schleife, während die PyTorch/CUDA-Abhängigkeit vollständig entfernt wird.
  • jsegov/autoresearch-win-rtx Windows-native RTX-Fork konzentriert sich auf NVIDIA-GPUs für Verbraucher mit expliziten VRAM-Etagen und einem praktischen Desktop-Setup-Pfad.
  • iii-hq/n-autoresearch Multi-GPU-Autoresearch-Infrastruktur mit strukturiertem Experiment-Tracking, adaptiver Suchstrategie, Crash-Recovery und abfragbarer Orchestrierung rund um den Klassiker train.py Schleife.
  • lucasgelfond/autoresearch-webgpu Browser / WebGPU-Port, mit dem Agenten Trainingscode generieren, Experimente im Browser ausführen und Ergebnisse ohne Python-Setup in die Schleife zurückführen können.
  • tonitangpotato/autoresearch engram Gabel mit Persistentes kognitives Gedächtnis — frequenzgewichtetes Abrufen von sitzungsübergreifendem Wissen für eine verbesserte Experimentkontinuität.
  • Colab/Kaggle T4-Port - Passt Autoresearch für kostenlose T4-GPUs (Google Colab / Kaggle) mit null Kosten und null lokaler Einrichtung an. Wichtige Änderungen: Flash Attention 3 → PyTorch SDPA, entfernt H100-only-Kernelabhängigkeit.
  • ArmanJR-Labor/Autoautorensuche Jetson AGX Orin Port mit einem Direktor - eine Go-Binärdatei, die als “kreativer Direktor” fungiert und Neuheiten (Arxiv-Papiere + DeepSeek Reasoner) in die Schleife einführt, um lokalen Minima zu entkommen. Beinhaltet Multi-Experiment-Vergleich (Baseline vs Director-guided) mit detaillierter Stall-Analyse.
  • mattprusak/autoresearch geneealogy - Wendet das Autorecherche-Muster auf die Genealogie an und verwendet strukturierte Eingabeaufforderungen, Archivleitfäden, Quellenüberprüfungen und Gewölbe-Workflows, um die Familiengeschichtenforschung iterativ zu erweitern und zu verifizieren.
  • ArchishmanSengupta/Autovoiceevals Verwendet gegnerische Anrufer sowie sofortige Änderungen, um Voice AI-Agenten in Vapi, Smallest AI und ElevenLabs zu härten.
  • chrisworsey55/atlas-gic - Wendet die Autoresearch-Kee-or-Revert-Schleife auf Handelsagenten an, optimiert Eingabeaufforderungen und Portfolio-Orchestrierung gegen rollende Sharpe-Ratio anstelle von Modellverlust.
  • RightNow-AI/Autokern - Wendet die Autoresearch-Schleife auf die GPU-Kerneloptimierung an: Profilengpässe, Bearbeiten eines Kernels, Benchmark, Keep or Revert, Repeat.
  • ElliotXie/Autozym Multi-Agent-Framework, das die Autoresearch Keep-or-Revert-Schleife auf die CPU-seitige wissenschaftliche Software anwendet: Profilieren Sie eine Zielfunktion, generieren Sie einen Optimierungskandidaten, Benchmark für die Geschwindigkeit bei Beibehaltung der ursprünglichen Ausgaben, Keep oder Revert, wiederholen Sie.
  • Agent-Analytics/autoresearch-growth - Wendet Autoresearch auf Landing-Page-Positionierung und A / B-Testkandidaten an, wobei Analyse-Snapshots und gemessene Experimentergebnisse verwendet werden, um nachfolgende Runden zu erstellen.
  • Rkcr7/autoresearch-sudoku - Verbesserter Autoresearch-Workflow, bei dem ein KI-Agent einen Rust-Sudoku-Solver iterativ umschreibt und benchmarket, was letztendlich führende, von Menschen gebaute Solver bei harten Benchmark-Sets schlägt.
  • jeongph/autospec Lesen Sie natürlichsprachige Geschäftsregeln und erstellen Sie autonom einen Spring Boot-Service mit Tests über die Keep-or-Revert-Schleife. Bewertet mit Gradle Build + JUnit XML. 119-Zeilen-Skelett auf 950 Zeilen in 5 Zyklen.
  • Vlasenkoalexey/tpu_Leistung_Autorecherche_Wiki - Wendet die Autoresearch-Kee-or-Revert-Schleife auf die TPU-Modellleistung (MFU / Tokens-per-sec) auf v6e-Hardware an: Profile laufen jeweils über einen XProf MCP-Server, nehmen eine Modellcodeänderung pro Experiment vor und halten oder kehren gegen gemessene MFU zurück. Kombiniert die Schleife mit einem LLM-Wiki im Karpathy-Stil für Domänenwissen und Per-Experiment-Optimierungsspuren; enthält Llama3-8B- und Qwen3-8B-Fallstudien über JAX- und Fackelspuren.
  • snap-stanford/MLAgentBench Benchmark-Suite zur Bewertung von KI-Agenten bei ML-Experimentieraufgaben. 13 Aufgaben von CIFAR-10 bis BabyLM.
  • OpenAI/Mle-Bench - OpenAIs Benchmark zur Messung der Leistung von KI-Agenten bei ML Engineering.
  • chchenhui/mlrbench MLR-Bench: Bewertung von KI-Agenten in der offenen ML-Forschung. 201 Aufgaben aus NeurIPS/ICLR/ICML Workshops.
  • gersteinlab/ML-Bench Bewertet LLMs und Agenten für ML-Aufgaben auf Repository-Level-Code.
  • THUDM/AgentBench Umfassender Benchmark für die LLM-as-Agent-Bewertung in 8 verschiedenen Umgebungen. ICLR 2024.

Wir freuen uns über Beiträge zu dieser Liste! Bevor Sie einen Beitrag leisten, nehmen Sie sich bitte einen Moment Zeit, um unsere BeitragsleitlinienDiese Leitlinien werden dazu beitragen, dass Ihre Beiträge mit unseren Zielen übereinstimmen und unseren Qualitäts- und Relevanzstandards entsprechen.

Was wir suchen:

  • Neue hochwertige Papiere, Tools oder Ressourcen mit einer kurzen Beschreibung, warum sie wichtig sind
  • Updates zu bestehenden Einträgen (gebrochene Links, veraltete Informationen)
  • Korrekturen zu Sternzahlen, Preisen oder Modelldetails
  • Übersetzungen und Verbesserungen der Zugänglichkeit

Qualitätsstandards:

  • Alle Tools sollten aktiv gewartet werden (aktualisiert innerhalb der letzten 6 Monate)
  • Papiere sollten von Peer-Review-Locations stammen oder signifikante Community-Adoption haben
  • Datensätze sollten öffentlich zugänglich sein
  • Bitte geben Sie eine einzeilige Beschreibung an, in der erläutert wird, warum die Ressource wertvoll ist

Vielen Dank für Ihr Interesse, zu diesem Projekt beizutragen!


gepflegt durch PromptsLab · Star dieses Repo Wenn Sie es nützlich finden!

HagiCode

HagiCode ist ein agentischer Coding-Arbeitsplatz. Vielseitige, komfortable Interaktionen in der Benutzeroberfläche machen Planung, Agent-Ausführung und Projektarbeit zugänglich und leicht nachvollziehbar – für ein ansprechendes Entwicklungserlebnis.

Entdecken Sie ein ansprechendes Entwicklungserlebnis mit vielseitigen, komfortablen Interaktionen in der Benutzeroberfläche.

HagiCode besuchenDokumentation lesen
  • IntelligentOpenSpec-Workflows machen aus einer Absicht einen umsetzbaren Weg vom Vorschlag über Design und Aufgaben bis zur Auslieferung.
  • EffizientMulti-Agent-Ausführung führt Recherche, Umsetzung und Prüfung parallel aus, über mehrere Repositories und die Agent CLIs, die Sie bereits nutzen.
  • InteressantVielseitige, komfortable Interaktionen in der Benutzeroberfläche machen Planung, Agent-Ausführung und Projektarbeit zugänglich und leicht nachvollziehbar.

Für Windows herunterladen

Im Microsoft Store erhaltenAlle Downloads

Aus Ideen wird ausgelieferte Software.

HagiCode ist ein agentischer Coding-Arbeitsplatz: OpenSpec-Workflows planen die Änderung, Multi-Agent-Ausführung setzt sie um, und Hero Scenario macht den langen Weg sichtbar, bis aus der Idee ausgelieferte Software wird.

Intelligent
OpenSpec-Workflows machen aus einer Absicht einen Weg vom Vorschlag bis zur Auslieferung.
Effizient
Multi-Agent-Ausführung treibt Recherche, Umsetzung und Prüfung parallel voran.
Unterhaltsam
UI-Interaktionen erleichtern Planung, Agent-Ausführung und Projektarbeit.

Awesome Site verlassen?

Du bist dabei, eine externe Website aufzurufen. Wir haben keine Kontrolle über deren Inhalte oder Datenschutzpraktiken.

Ziel

Zur Website wechseln