
LLM
Source: https://github.com/Hannibal046/Awesome-LLM at
538eed00fcb0
License: CC0-1.0
Read the English original
This edition is an AI-assisted translation.
Awesome-LLM 
Abschnitt betitelt „Awesome-LLM “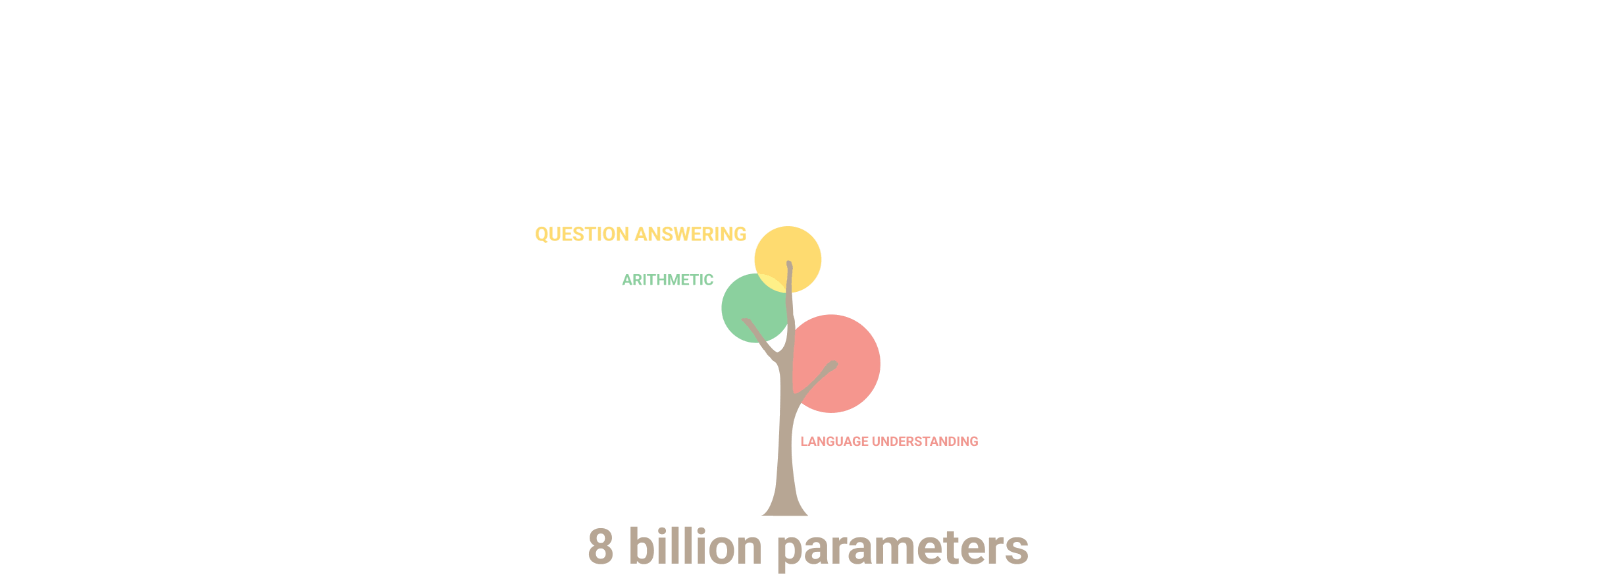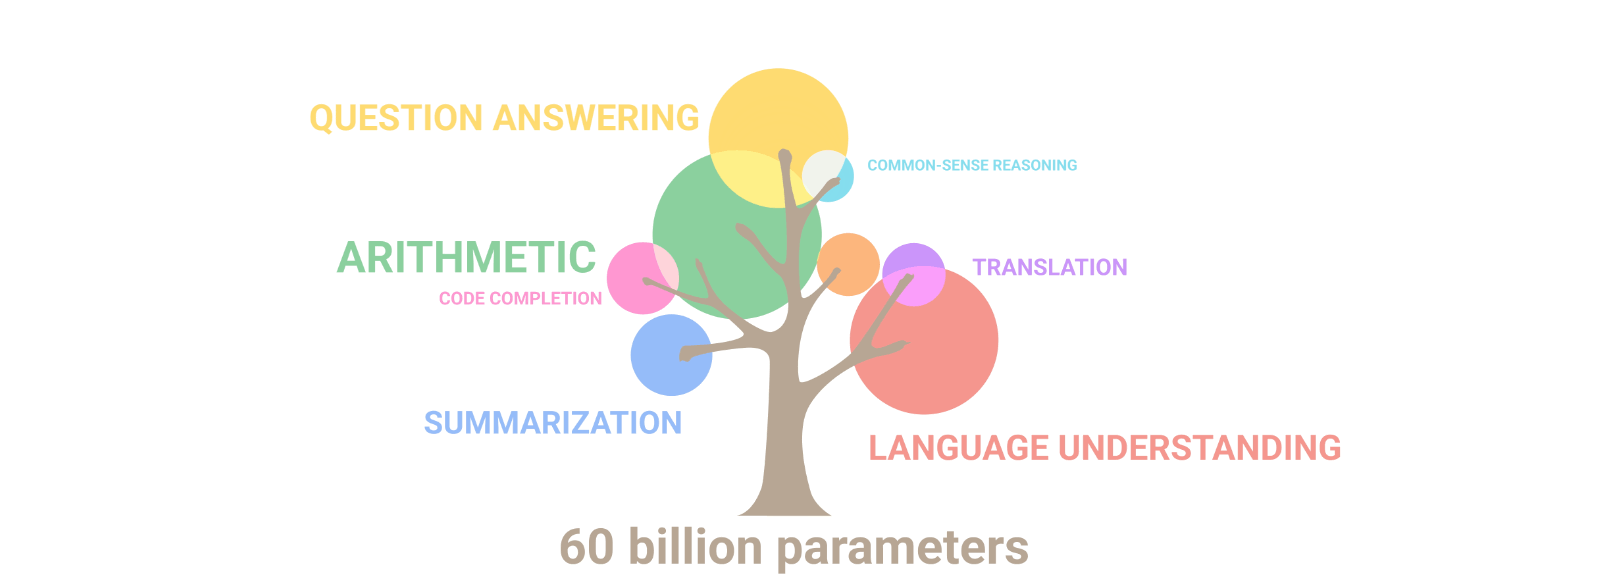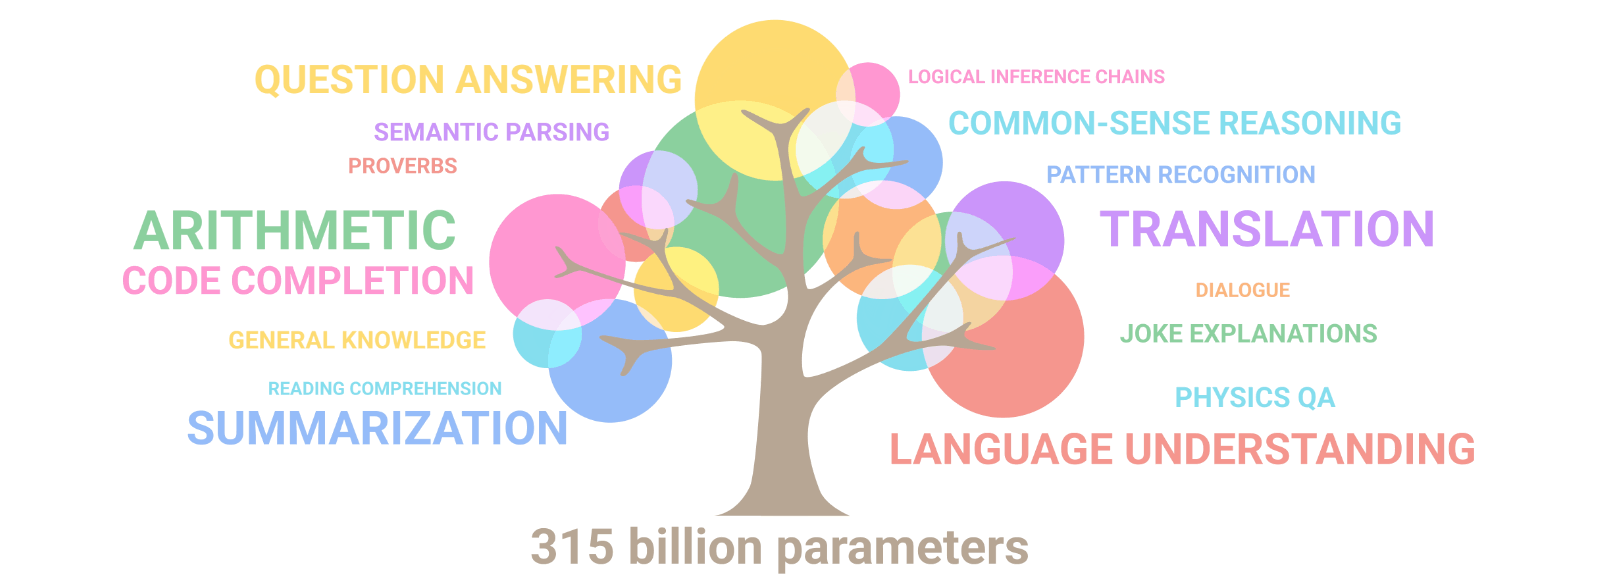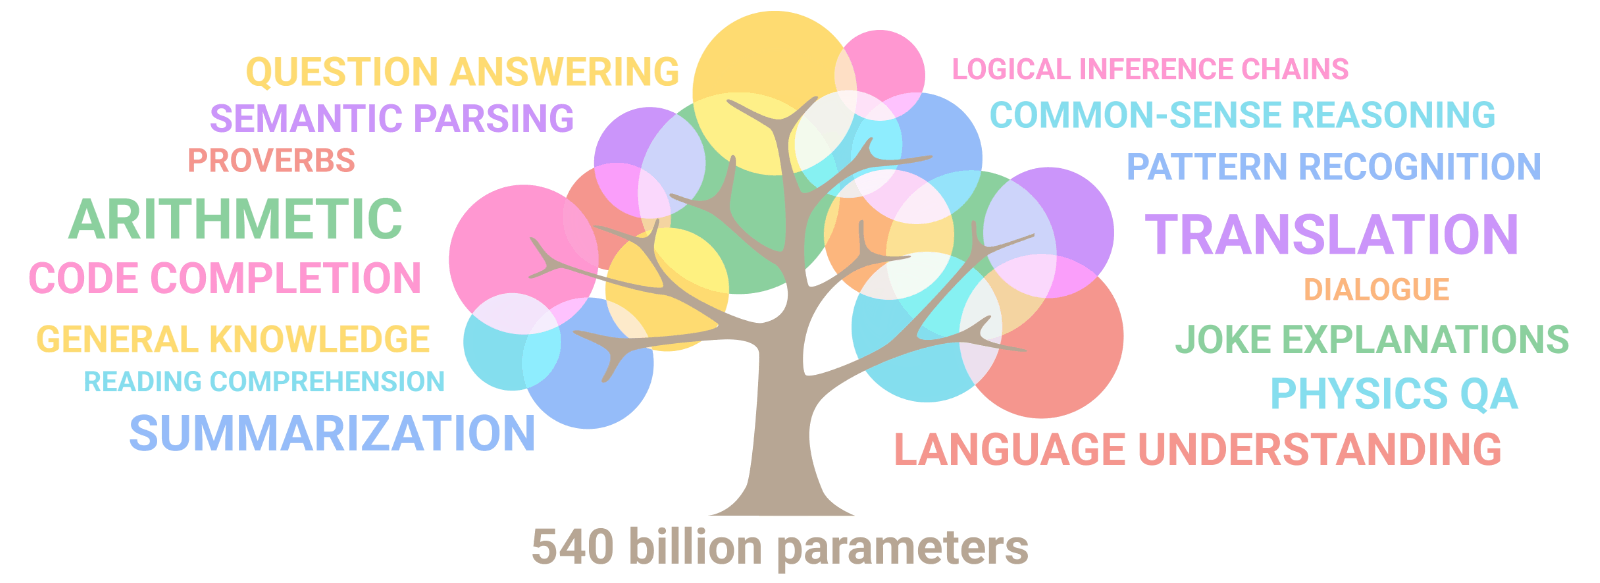
🔥 Large Language Models (LLM) haben die NLP-Gemeinschaft KI-Gemeinschaft ganze Welt im Sturm erobert. Hier ist eine kuratierte Liste von Arbeiten zu Large Language Models, insbesondere mit Bezug zu ChatGPT. Sie enthält außerdem Frameworks für das Training von LLMs, Tools zur Bereitstellung von LLMs, Kurse und Tutorials zu LLMs sowie alle öffentlich verfügbaren LLM-Checkpoints und APIs.
Aktuelle LLM-Projekte
Abschnitt betitelt „Aktuelle LLM-Projekte“- TinyZero - Saubere, minimale und leicht zugängliche Reproduktion von DeepSeek R1-Zero
- open-r1 - Vollständig offene Reproduktion von DeepSeek-R1
- DeepSeek-R1 - Reasoning-Modelle der ersten Generation von DeepSeek.
- Qwen2.5-Max - Erkundung der Intelligenz eines groß angelegten MoE-Modells.
- OpenAI o3-mini - Die Grenzen kosteneffizienten Reasonings verschieben.
- DeepSeek-V3 - Das erste als Open Source veröffentlichte Modell auf dem Niveau von GPT-4o.
- Kimi-K2 - MoE-Sprachmodell mit 32B aktiven und insgesamt 1T Parametern.
Inhaltsverzeichnis
Abschnitt betitelt „Inhaltsverzeichnis“Meilenstein-Arbeiten
Abschnitt betitelt „Meilenstein-Arbeiten“Meilenstein-Arbeiten
Weitere Arbeiten
Abschnitt betitelt „Weitere Arbeiten“[!NOTE] Wenn Sie sich für das Gebiet der LLMs interessieren, kann Ihnen die obige Liste der Meilenstein-Arbeiten dabei helfen, seine Geschichte und den aktuellen Stand der Technik zu erkunden. Jeder Teilbereich der LLM-Forschung bietet jedoch eigene Erkenntnisse und Beiträge, die für das Verständnis des Gesamtgebiets wesentlich sind. Eine detaillierte Liste von Arbeiten aus verschiedenen Teilgebieten finden Sie unter folgendem Link:
weitere Arbeiten
-
Awesome-LLM-hallucination - Liste von Arbeiten zu LLM-Halluzinationen.
-
awesome-hallucination-detection - Liste von Arbeiten zur Erkennung von Halluzinationen in LLMs.
-
LLMsPracticalGuide - Eine kuratierte Liste praktischer Ressourcen zu LLMs.
-
Awesome ChatGPT Prompts - Eine Sammlung von Prompt-Beispielen für das ChatGPT-Modell.
-
awesome-chatgpt-prompts-zh - Eine chinesische Sammlung von Prompt-Beispielen für das ChatGPT-Modell.
-
Awesome ChatGPT - Kuratierte Sammlung von Ressourcen zu ChatGPT und GPT-3 von OpenAI.
-
Chain-of-Thoughts Papers - Ein Trend, der mit „Chain of Thought Prompting Elicits Reasoning in Large Language Models“ begann.
-
Awesome Deliberative Prompting - So lassen sich LLMs zu verlässlichem Reasoning und begründungsabhängigen Entscheidungen anleiten.
-
Instruction-Tuning-Papers - Ein Trend, der mit
Natrural-Instruction(ACL 2022),FLAN(ICLR 2022) undT0(ICLR 2022) begann. -
LLM Reading List - Eine Liste von Arbeiten und Ressourcen zu Large Language Models.
-
Reasoning using Language Models - Sammlung von Arbeiten und Ressourcen zum Reasoning mit Language Models.
-
Chain-of-Thought Hub - Messung der Reasoning-Leistung von LLMs.
-
Awesome GPT - Eine kuratierte Liste hervorragender Projekte und Ressourcen zu GPT, ChatGPT, OpenAI, LLMs und mehr.
-
Awesome GPT-3 - Eine Sammlung von Demos und Artikeln zur OpenAI GPT-3 API.
-
Awesome LLM Human Preference Datasets - Eine Sammlung menschlicher Präferenzdatensätze für das Instruction-Tuning, RLHF und die Evaluierung von LLMs.
-
RWKV-howto - Möglicherweise nützliche Materialien und Tutorials zum Erlernen von RWKV.
-
ModelEditingPapers - Eine Liste von Arbeiten und Ressourcen zum Model Editing für Large Language Models.
-
Awesome LLM Security - Eine kuratierte Sammlung hervorragender Tools, Dokumente und Projekte zur LLM-Sicherheit.
-
Awesome-Align-LLM-Human - Eine Sammlung von Arbeiten und Ressourcen zur Ausrichtung von Large Language Models (LLMs) an menschlichen Präferenzen.
-
Awesome-Code-LLM - Eine kuratierte Liste der besten Code-LLMs für die Forschung.
-
Awesome-LLM-Compression - Hervorragende Forschungsarbeiten und Tools zur LLM-Komprimierung.
-
Awesome-LLM-Systems - Hervorragende Forschungsarbeiten zu LLM-Systemen.
-
awesome-llm-webapps - Eine Sammlung quelloffener, aktiv gepflegter Web-Apps für LLM-Anwendungen.
-
awesome-japanese-llm - Überblick über japanische LLMs.
-
Awesome-LLM-Healthcare - Die Liste der Arbeiten aus der Übersichtsarbeit zu LLMs in der Medizin.
-
Awesome-LLM-Inference - Eine kuratierte Liste hervorragender Arbeiten zur LLM-Inferenz samt Code.
-
Awesome-LLM-3D - Eine kuratierte Liste multimodaler Large Language Models in der 3D-Welt, einschließlich 3D-Verständnis, Reasoning, Generierung und verkörperter Agenten.
-
LLMDatahub - Eine kuratierte Sammlung von Datensätzen speziell für das Chatbot-Training, einschließlich Links, Größe, Sprache, Nutzung und Kurzbeschreibung jedes Datensatzes.
-
Awesome-Chinese-LLM - Zusammenstellung quelloffener chinesischer Large Language Models, vorwiegend kleinerer Modelle, die sich privat bereitstellen lassen und geringe Trainingskosten haben; darunter Basismodelle, Feinabstimmungen und Anwendungen für bestimmte Fachgebiete sowie Datensätze und Tutorials.
-
LLM4Opt - Die Anwendung von Large Language Models (LLMs) auf verschiedene Optimierungsaufgaben (Opt) ist ein aufstrebendes Forschungsgebiet. Dies ist eine Sammlung von Referenzen und Arbeiten zu LLM4Opt.
-
awesome-language-model-analysis - Diese Arbeitsliste konzentriert sich auf die theoretische oder empirische Analyse von Language Models, etwa Lerndynamik, Ausdrucksfähigkeit, Interpretierbarkeit, Verallgemeinerung und weitere interessante Themen.
LLM-Bestenliste
Abschnitt betitelt „LLM-Bestenliste“- Chatbot Arena Leaderboard - Eine Benchmark-Plattform für Large Language Models (LLMs) mit anonymen, zufällig zusammengestellten Duellen im Crowdsourcing-Verfahren.
- LiveBench - Ein anspruchsvoller, kontaminationsfreier LLM-Benchmark.
- Open LLM Leaderboard - Zielt darauf ab, LLMs und Chatbots nach ihrer Veröffentlichung zu verfolgen, einzuordnen und zu evaluieren.
- AlpacaEval - Ein automatischer Evaluator für Language Models, die Anweisungen befolgen, auf Basis der Benchmark-Suite von Nous.
weitere Bestenlisten
- ACLUE - Ein Evaluierungsbenchmark mit Schwerpunkt auf dem Verständnis der altchinesischen Sprache.
- BeHonest - Ein wegweisender Benchmark, der speziell für die umfassende Beurteilung der Ehrlichkeit von LLMs entwickelt wurde.
- Berkeley Function-Calling Leaderboard - Bewertet die Fähigkeit von LLMs, externe Funktionen und Tools aufzurufen.
- Chinese Large Model Leaderboard - Ein von Experten entwickelter Benchmark für chinesische LLMs.
- CompassRank - CompassRank widmet sich der Erforschung der fortschrittlichsten Sprach- und Bildmodelle und bietet der Industrie und Forschung eine umfassende, objektive und neutrale Bewertungsgrundlage.
- CompMix - Ein Benchmark zur Bewertung von QA-Methoden, die mit einer Mischung heterogener Eingabequellen arbeiten (KB, Text, Tabellen, Infoboxen).
- DreamBench++ - Ein Benchmark zur Bewertung der Leistung von Large Language Models (LLMs) bei Aufgaben zur textuellen und visuellen Vorstellungskraft.
- FELM - Ein Meta-Benchmark, der bewertet, wie gut Evaluatoren für Faktentreue die Ausgaben von Large Language Models (LLMs) beurteilen.
- InfiBench - Ein Benchmark zur gezielten Bewertung von Large Language Models anhand ihrer Fähigkeit, reale Fragen zum Programmieren zu beantworten.
- LawBench - Ein Benchmark zur Evaluierung von Large Language Models im Rechtsbereich.
- LLMEval - Befasst sich damit, wie diese Modelle in verschiedenen Szenarien abschneiden, und analysiert die Ergebnisse aus der Perspektive der Interpretierbarkeit.
- M3CoT - Ein Benchmark zur Bewertung von Large Language Models bei verschiedenen multimodalen Reasoning-Aufgaben, darunter Sprache, Natur- und Sozialwissenschaften, physikalischer und sozialer Alltagsverstand, zeitliches Reasoning, Algebra und Geometrie.
- MathEval - Eine umfassende Benchmark-Plattform zur Bewertung der mathematischen Fähigkeiten großer Modelle in 20 Fachgebieten anhand von fast 30.000 Mathematikaufgaben.
- MixEval - Ein dynamischer, auf Ground Truth basierender Benchmark, der aus frei verfügbaren Benchmark-Mischungen abgeleitet wurde. Er bewertet LLMs mit einem leistungsfähigen Modellranking (d. h. einer Korrelation von 0,96 mit Chatbot Arena) und läuft dabei lokal und schnell (bei 6 % der Laufzeit und Kosten von MMLU).
- MMedBench - Ein Benchmark zur Bewertung der Fähigkeit von Large Language Models, medizinische Fragen in mehreren Sprachen zu beantworten.
- MMToM-QA - Ein multimodaler Frage-Antwort-Benchmark zur Bewertung der kognitiven Fähigkeit von KI-Modellen, menschliche Überzeugungen und Ziele zu verstehen.
- OlympicArena - Ein Benchmark zur Bewertung von KI-Modellen in mehreren akademischen Disziplinen wie Mathematik, Physik, Chemie, Biologie und mehr.
- PubMedQA - Ein biomedizinischer Frage-Antwort-Benchmark, der Forschungsfragen anhand von PubMed-Abstracts beantwortet.
- SciBench - Ein Benchmark zur Bewertung von Large Language Models (LLMs) beim Lösen komplexer wissenschaftlicher Aufgaben auf Hochschulniveau, etwa aus Chemie, Physik und Mathematik.
- SuperBench - Eine Benchmark-Plattform zur Evaluierung von Large Language Models (LLMs) für eine Reihe von Aufgaben, insbesondere hinsichtlich natürlichem Sprachverständnis, Reasoning und Verallgemeinerung.
- SuperLim - Ein Benchmark zum Verständnis der schwedischen Sprache, der NLP-Modelle anhand verschiedener Aufgaben wie Argumentationsanalyse, semantischer Ähnlichkeit und Textimplikation bewertet.
- TAT-DQA - Ein umfangreicher Datensatz für Document Visual Question Answering (VQA), der komplexes Dokumentenverständnis insbesondere anhand von Finanzberichten untersucht.
- TAT-QA - Ein umfangreicher Frage-Antwort-Benchmark zu realen Finanzdaten, der tabellarische und textuelle Informationen zusammenführt.
- VisualWebArena - Ein Benchmark zur Beurteilung der Leistung multimodaler Web-Agenten bei realistischen, visuell fundierten Aufgaben.
- We-Math - Ein Benchmark, der große multimodale Modelle (LMMs) danach bewertet, wie gut sie menschenähnliches mathematisches Reasoning leisten.
- WHOOPS! - Ein Benchmark-Datensatz, der anhand von Bildern, die normalen Erwartungen widersprechen, die Fähigkeit von KI zum visuellen Alltagsverstand testet.
Offene LLMs
Abschnitt betitelt „Offene LLMs“DeepSeek
Alibaba
- Qwen-1.8B|7B|14B|72B
- Qwen1.5-0.5B|1.8B|4B|7B|14B|32B|72B|110B|MoE-A2.7B
- Qwen2-0.5B|1.5B|7B|57B-A14B-MoE|72B
- Qwen2.5-0.5B|1.5B|3B|7B|14B|32B|72B
- CodeQwen1.5-7B
- Qwen2.5-Coder-1.5B|7B|32B
- Qwen2-Math-1.5B|7B|72B
- Qwen2.5-Math-1.5B|7B|72B
- Qwen-VL-7B
- Qwen2-VL-2B|7B|72B
- Qwen2-Audio-7B
- Qwen2.5-VL-3|7|72B
- Qwen2.5-1M-7|14B
Meta
Mistral AI
Apple
Microsoft
AllenAI
xAI
Cohere
01-ai
Baichuan
Nvidia
BLOOM
Zhipu AI
RWKV Foundation
- RWKV-v4|5|6minicpm-2b-65d48bf958302b9fd25b698f)
ElutherAI
Stability AI
BigCode
DataBricks
Shanghai AI Laboratory
Moonshot AI
LLM-Daten
Abschnitt betitelt „LLM-Daten“Referenz: LLMDataHub
- IBM data-prep-kit - Open-Source-Toolkit für die effiziente Verarbeitung unstrukturierter Daten mit vorgefertigten Modulen und Skalierung vom lokalen Rechner bis zum Cluster.
- Datatrove - Befreit die Datenverarbeitung vom Skriptchaos und stellt dafür eine Reihe plattformunabhängiger, anpassbarer Pipeline-Bausteine bereit.
- Dingo - Ein umfassendes Tool zur Bewertung der Datenqualität.
- FastDatasets - Ein leistungsstarkes Tool zur Erstellung hochwertiger Trainingsdatensätze für Large Language Models.
LLM-Evaluierung:
Abschnitt betitelt „LLM-Evaluierung:“- lm-evaluation-harness - Ein Framework zur Few-Shot-Evaluierung von Language Models.
- lighteval - Eine schlanke Evaluierungs-Suite für LLMs, die Hugging Face intern verwendet.
- simple-evals - Evaluierungstools von OpenAI.
weitere Evaluierungs-Frameworks
- OLMO-eval - Ein Repository zur Evaluierung offener Language Models.
- MixEval - Eine zuverlässige Evaluierungs-Suite, die sofort einsatzbereit und sowohl mit Open-Source- als auch proprietären Modellen kompatibel ist und MixEval sowie weitere Benchmarks unterstützt.
- HELM - Holistic Evaluation of Language Models (HELM), ein Framework zur Verbesserung der Transparenz von Language Models.
- instruct-eval - Dieses Repository enthält Code zur quantitativen Evaluierung von instruction-getunten Modellen wie Alpaca und Flan-T5 anhand zurückgehaltener Aufgaben.
- Giskard - Test- und Evaluierungsbibliothek für LLM-Anwendungen, insbesondere RAG-Systeme.
- LangSmith - Eine einheitliche Plattform des LangChain-Frameworks für Evaluierung, Zusammenarbeit mit Menschen in der Schleife (HITL), Protokollierung und Überwachung von LLM-Anwendungen.
- Ragas - Ein Framework zur Evaluierung von Retrieval-Augmented-Generation-Pipelines (RAG).
LLM-Trainings-Frameworks
Abschnitt betitelt „LLM-Trainings-Frameworks“- Meta Lingua - Eine schlanke, effiziente und leicht anpassbare Codebasis für die LLM-Forschung.
- Litgpt - Über 20 leistungsstarke LLMs mit Anleitungen für Vortraining, Feinabstimmung und Bereitstellung im großen Maßstab.
- nanotron - Minimalistisches Training großer Language Models mit 3D-Parallelisierung.
- DeepSpeed - DeepSpeed ist eine Bibliothek zur Optimierung von Deep Learning, die verteiltes Training und Inferenz einfach, effizient und leistungsfähig macht.
- Megatron-LM - Laufende Forschung zum Training von Transformer-Modellen im großen Maßstab.
- torchtitan - Eine native PyTorch-Bibliothek für das Training großer Modelle.
weitere Frameworks
- Megatron-DeepSpeed - Die DeepSpeed-Version von NVIDIA Megatron-LM, die zusätzliche Unterstützung für Funktionen wie MoE-Modelltraining, Curriculum Learning, 3D-Parallelisierung und weitere bietet.
- torchtune - Eine native PyTorch-Bibliothek zur Feinabstimmung von LLMs.
- ROLL - Eine effiziente und benutzerfreundliche Skalierungsbibliothek für Reinforcement Learning mit Large Language Models.
- veRL - veRL ist ein flexibles und effizientes RL-Framework für LLMs.
- NeMo Framework - Generatives KI-Framework für Forschende und PyTorch-Entwickler, die mit Large Language Models (LLMs), multimodalen Modellen (MMs), automatischer Spracherkennung (ASR), Text-to-Speech (TTS) und Computer Vision (CV) arbeiten.
- Colossal-AI - Macht große KI-Modelle kostengünstiger, schneller und zugänglicher.
- BMTrain - Effizientes Training großer Modelle.
- Mesh Tensorflow - Mesh TensorFlow: Modellparallelisierung leicht gemacht.
- maxtext - Ein einfaches, leistungsstarkes und skalierbares Jax-LLM!
- GPT-NeoX - Eine Implementierung modellparalleler autoregressiver Transformer auf GPUs auf Basis der DeepSpeed-Bibliothek.
- Transformer Engine - Eine Bibliothek zur Beschleunigung des Trainings von Transformer-Modellen auf NVIDIA-GPUs.
- OpenRLHF - Ein benutzerfreundliches, skalierbares und leistungsstarkes RLHF-Framework (70B+ PPO Full Tuning, iteratives DPO, LoRA, RingAttention und RFT).
- TRL - TRL ist eine umfassende Bibliothek mit Tools zum Training von Transformer-Sprachmodellen mittels Reinforcement Learning – vom überwachten Feinabstimmungsschritt (SFT) über Reward Modeling (RM) bis zur Proximal Policy Optimization (PPO).
- unslothai - Ein Framework mit Schwerpunkt auf effizienter Feinabstimmung. Auf der GitHub-Seite finden Sie sofort nutzbare Fine-Tuning-Vorlagen für verschiedene LLMs, mit denen Sie Ihre eigenen Daten kostenlos in der Google-Colab-Cloud trainieren können.
- Axolotl - Open-Source-Framework zur Feinabstimmung und Evaluierung von LLMs. Es vereinfacht das Experimentieren mit verschiedenen Trainingskonfigurationen und die Reproduktion und Weitergabe von Ergebnissen. Unterstützt werden unter anderem LoRA, QLoRA, DeepSpeed, PEFT und Multi-GPU-Setups.
LLM-Inferenz
Abschnitt betitelt „LLM-Inferenz“Referenz: llm-inference-solutions
- SGLang - Schnelles Serving-Framework für Large Language Models und Vision-Language-Modelle.
- vLLM - Eine Inferenz- und Serving-Engine für LLMs mit hohem Durchsatz und effizientem Speicherverbrauch.
- llama.cpp - LLM-Inferenz in C/C++.
- ollama - Legen Sie mit Llama 3, Mistral, Gemma und weiteren Large Language Models sofort los.
- TGI - Ein Toolkit zur Bereitstellung und zum Serving von Large Language Models (LLMs).
- TensorRT-LLM - NVIDIA-Framework für LLM-Inferenz.
weitere Bereitstellungstools
- FasterTransformer - NVIDIA-Framework für LLM-Inferenz (zu TensorRT-LLM übergegangen).
- MInference - Beschleunigt die Inferenz von LLMs mit langem Kontext durch näherungsweise dynamische Sparse-Berechnung der Attention. Dadurch sinkt die Inferenzlatenz beim Prefill auf einer A100 um bis zu das Zehnfache, bei gleichbleibender Genauigkeit.
- exllama - Eine speichereffizientere Neufassung der HF-Transformers-Implementierung von Llama zur Verwendung mit quantisierten Gewichten.
- FastChat - Ein verteiltes Serving-System für mehrere LLMs mit Web-UI und OpenAI-kompatiblen REST-APIs.
- mistral.rs - Blitzschnelle LLM-Inferenz.
- SkyPilot - Führen Sie LLMs und Batch-Jobs in jeder Cloud aus. Profitieren Sie von maximalen Kosteneinsparungen, höchster GPU-Verfügbarkeit und verwalteter Ausführung – alles über eine einfache Schnittstelle.
- Haystack - Ein quelloffenes NLP-Framework, mit dem Sie LLMs und Transformer-Modelle von Hugging Face, OpenAI und Cohere nutzen können, um mit Ihren eigenen Daten zu arbeiten.
- OpenLLM - Feinabstimmung, Serving, Bereitstellung und Überwachung beliebiger Open-Source-LLMs im Produktivbetrieb. Wird bei BentoML für LLM-basierte Anwendungen produktiv eingesetzt.
- DeepSpeed-Mii - MII ermöglicht latenzarme Inferenz mit hohem Durchsatz, ähnlich wie vLLM, unterstützt von DeepSpeed.
- Text-Embeddings-Inference - Inferenz für Text-Embeddings in Rust; HFOIL-Lizenz.
- Infinity - Inferenz für Text-Embeddings in Python.
- LMDeploy - Ein Inferenz- und Serving-Framework mit hohem Durchsatz und niedriger Latenz für LLMs und VLs.
- Liger-Kernel - Effiziente Triton-Kernels für das Training von LLMs.
- prima.cpp - Eine verteilte Implementierung von llama.cpp, mit der sich LLMs der 70B-Klasse auf Alltagsgeräten ausführen lassen.
- deploy-llms-with-ansible - Stellen Sie beliebige LLMs mit Ansible und minimaler Konfiguration einfach auf einer VM bereit.
LLM-Anwendungen
Abschnitt betitelt „LLM-Anwendungen“Referenz: awesome-llm-apps
- dspy - DSPy: Das Framework zum Programmieren – nicht Prompten – von Basismodellen.
- LangChain — Eine beliebte Python-/JavaScript-Bibliothek zum Verketten von Sequenzen von Prompts für Language Models.
- LlamaIndex — Eine Python-Bibliothek zur Erweiterung von LLM-Anwendungen um Daten.
weitere Anwendungen
-
MLflow - MLflow: Ein Open-Source-Framework für den gesamten Lebenszyklus des maschinellen Lernens. Es unterstützt Entwickler dabei, Experimente zu verfolgen, Modelle und Prompts zu evaluieren, Modelle bereitzustellen und durch Tracing Einblick in den Betrieb zu erhalten.
-
Swiss Army Llama - Ein umfassendes Toolset für verschiedene Aufgaben mit lokalen LLMs.
-
LiteChain - Eine leichtgewichtige Alternative zu LangChain zum Zusammenstellen von LLMs.
-
magentic - Nahtlose Integration von LLMs als Python-Funktionen.
-
wechat-chatgpt - ChatGPT über wechaty in WeChat verwenden.
-
promptfoo - Testen Sie Ihre Prompts. Evaluieren und vergleichen Sie LLM-Ausgaben, erkennen Sie Regressionen und verbessern Sie die Prompt-Qualität.
-
Agenta - Erstellen, versionieren, evaluieren und veröffentlichen Sie mühelos LLM-gestützte Anwendungen.
-
Serge - Eine mit llama.cpp entwickelte Chat-Oberfläche zum Ausführen von Alpaca-Modellen. Keine API-Schlüssel, vollständig selbst gehostet!
-
Langroid - Nutzen Sie LLMs mit Multi-Agent-Programmierung.
-
Embedchain - Framework zum Erstellen von ChatGPT-ähnlichen Bots auf Basis Ihres Datensatzes.
-
Opik - Evaluieren, testen und veröffentlichen Sie LLM-Anwendungen zuverlässig – mit einer Suite von Observability-Tools, die Ausgaben von Language Models während Entwicklung und Produktion abstimmt.
-
IntelliServer - Vereinfacht die Evaluierung von LLMs durch einen einheitlichen Microservice für den Zugriff auf und das Testen mehrerer KI-Modelle.
-
Langchain-Chatchat - Früher langchain-ChatGLM: eine lokale, wissensbasierte QA-Anwendung mit LLMs wie ChatGLM und LangChain.
-
Search with Lepton - Erstellen Sie mit weniger als 500 Codezeilen Ihre eigene dialogbasierte Suchmaschine mit LeptonAI.
-
Robocorp - Erstellen, veröffentlichen und betreiben Sie mit Python überall Actions, um Ihre KI-Agenten und Assistenten zu verbessern. Mit einer umfangreichen Auswahl an Bibliotheken, Hilfsfunktionen und Protokollierung ist alles enthalten.
-
Tune Studio - Spielwiese für Entwickler, um LLMs feinabzustimmen und bereitzustellen.
-
LLocalSearch - Lokal ausgeführte Websuche mit LLM-Ketten.
-
AI Gateway — Das Gateway optimiert Anfragen an über 100 offene und proprietäre Modelle über eine einheitliche API. Es ist produktionsreif und unterstützt Caching, Fallbacks, Wiederholungen, Timeouts und Lastverteilung; außerdem lässt es sich für minimale Latenz am Edge bereitstellen.
-
talkd.ai dialog - Einfache API zur Bereitstellung beliebiger RAG- oder LLM-Lösungen mit Plugins.
-
Wllama - WebAssembly-Bindung für llama.cpp – ermöglicht LLM-Inferenz direkt im Browser.
-
GPUStack - Ein quelloffener GPU-Cluster-Manager zum Ausführen von LLMs.
-
MNN-LLM — Ein Inferenz-Framework für Geräte, einschließlich LLM-Inferenz direkt auf Geräten (Mobiltelefon/PC/IoT).
-
CAMEL - Das erste LLM-Multi-Agent-Framework.
-
QA-Pilot - Ein interaktives Chat-Projekt, das Ollama-/OpenAI-/MistralAI-LLMs nutzt, um GitHub-Code-Repositories oder komprimierte Dateien schnell zu verstehen und zu durchsuchen.
-
Shell-Pilot - Interagieren Sie unter Linux oder macOS über reine Shell-Skripte mit LLMs mithilfe von Ollama-Modellen (oder OpenAI, MistralAI) und verbessern Sie so die intelligente Systemverwaltung ganz ohne Abhängigkeiten.
-
MindSQL - Ein Python-Paket für Text-zu-SQL mit Self-Hosting-Funktionen und REST-APIs, kompatibel mit proprietären und quelloffenen LLMs.
-
Langfuse - Open-Source-Plattform für LLM-Engineering 🪢: Tracing, Evaluierungen, Prompt-Verwaltung und Playground.
-
AdalFlow - AdalFlow: Die Bibliothek zum Erstellen und automatischen Optimieren von LLM-Anwendungen.
-
Guidance — Eine praktische Python-Bibliothek von Microsoft, die Handlebars-Templates nutzt, um Generierung, Prompting und logische Steuerung zu verknüpfen.
-
Evidently — Ein Open-Source-Framework zur Evaluierung, zum Testen und zur Überwachung ML- und LLM-gestützter Systeme.
-
Chainlit — Eine Python-Bibliothek zum Erstellen von Chatbot-Oberflächen.
-
Guardrails.ai — Eine Python-Bibliothek zur Validierung von Ausgaben und Wiederholung fehlgeschlagener Vorgänge. Sie befindet sich noch in der Alpha-Phase; rechnen Sie daher mit Ecken, Kanten und Fehlern.
-
Semantic Kernel — Eine Python-/C#-/Java-Bibliothek von Microsoft mit Unterstützung für Prompt-Templates, Funktionsverkettung, vektorisiertes Gedächtnis und intelligente Planung.
-
Prompttools — Open-Source-Python-Tools zum Testen und Evaluieren von Modellen, Vektordatenbanken und Prompts.
-
Outlines — Eine Python-Bibliothek mit einer domänenspezifischen Sprache, die Prompting vereinfacht und die Generierung einschränkt.
-
Promptify — Eine kleine Python-Bibliothek, mit der sich Language Models für NLP-Aufgaben einsetzen lassen.
-
Scale Spellbook — Ein kostenpflichtiges Produkt zum Erstellen, Vergleichen und Veröffentlichen von Language-Model-Anwendungen.
-
PromptPerfect — Ein kostenpflichtiges Produkt zum Testen und Verbessern von Prompts.
-
Weights & Biases — Ein kostenpflichtiges Produkt zur Nachverfolgung von Modelltraining und Prompt-Engineering-Experimenten.
-
OpenAI Evals — Eine Open-Source-Bibliothek zur Evaluierung der Aufgabenleistung von Language Models und Prompts.
-
Arthur Shield — Ein kostenpflichtiges Produkt zur Erkennung von toxischen Inhalten, Halluzinationen, Prompt Injection usw.
-
LMQL — Eine Programmiersprache für die Interaktion mit LLMs, mit Unterstützung für typisiertes Prompting, Kontrollfluss, Einschränkungen und Tools.
-
ModelFusion - Eine TypeScript-Bibliothek zum Erstellen von Anwendungen mit LLMs und anderen ML-Modellen (Sprache-zu-Text, Text-zu-Sprache, Bildgenerierung).
-
OneKE — Ein zweisprachiges chinesisch-englisches Modell zur Wissensextraktion mit Wissensgraphen und Technologien zur Verarbeitung natürlicher Sprache.
-
llm-ui - Eine React-Bibliothek zum Erstellen von LLM-Oberflächen.
-
Wordware - Eine webbasierte IDE, in der Fachleute ohne technischen Hintergrund gemeinsam mit KI-Entwicklern aufgabenspezifische KI-Agenten erstellen. Prompting wird dabei als neue Programmiersprache statt als Baukasten aus No-Code-/Low-Code-Blöcken betrachtet.
-
Wallaroo.AI - Stellen Sie beliebige Modelle in jeder Umgebung – von der Cloud bis zum Edge – bereit, verwalten und optimieren Sie sie. So gelangen Sie in wenigen Minuten vom Python-Notebook zur Inferenz.
-
Dify - Eine Open-Source-Plattform zur Entwicklung von LLM-Anwendungen mit einer intuitiven Oberfläche, die KI-Workflows, Modellverwaltung und Bereitstellung in der Produktion vereinfacht.
-
LazyLLM - Eine Open-Source-LLM-App zum einfachen und unkomplizierten Erstellen von Multi-Agent-LLM-Anwendungen; unterstützt Modellbereitstellung und Feinabstimmung.
-
MemFree - Quelloffene hybride KI-Suchmaschine: Erhalten Sie sofort präzise Antworten aus dem Internet, Lesezeichen, Notizen und Dokumenten. Unterstützt die Bereitstellung mit einem Klick.
-
AutoRAG - Open-Source-AutoML-Tool für RAG. Optimiert die Qualität von RAG-Antworten automatisch – von der Erstellung eines Generierungs-Evaluierungsdatensatzes bis zur Bereitstellung einer optimierten RAG-Pipeline.
-
Epsilla - Eine All-in-one-Plattform für LLM-Agenten mit Ihren privaten Daten und Ihrem Wissen, die vom ersten Tag an produktionsreife KI-Agenten bereitstellt.
-
Arize-Phoenix - Ein Open-Source-Tool für ML-Observability, das in Ihrer Notebook-Umgebung läuft. Überwachen und optimieren Sie LLMs, CV- und Tabular-Modelle.
-
LLM - Ein CLI-Tool und eine Python-Bibliothek zur Interaktion mit Large Language Models – sowohl über Remote-APIs als auch mit Modellen, die auf dem eigenen Rechner installiert und ausgeführt werden können.
-
Just-Chat - Erstellen Sie Ihren LLM-Agenten und chatten Sie einfach und schnell mit ihm!
-
Agentic Radar - Open-Source-CLI-Sicherheitsscanner für agentische Workflows. Analysiert den Quellcode Ihres Workflows, erkennt Schwachstellen und erstellt eine interaktive Visualisierung samt ausführlichem Sicherheitsbericht. Unterstützt LangGraph, CrewAI, n8n, OpenAI Agents und mehr.
-
LangWatch - Open-Source-Plattform für LLM-Observability, Prompt-Evaluierung und Prompt-Optimierung.
-
TensorZero - TensorZero ist ein Open-Source-Framework zum Erstellen produktionsreifer LLM-Anwendungen. Es vereint ein LLM-Gateway, Observability, Optimierung, Evaluierungen und Experimente.
LLM-Tutorials und -Kurse
Abschnitt betitelt „LLM-Tutorials und -Kurse“- Andrej Karpathy Series - Mein Favorit!
- Umar Jamil Series - Hochwertige und lehrreiche Videos, die Sie nicht verpassen sollten.
- Alexander Rush Series - Hochwertige und lehrreiche Materialien, die Sie nicht verpassen sollten.
- llm-course - Kurs zum Einstieg in Large Language Models (LLMs) mit Roadmaps und Colab-Notebooks.
- UWaterloo CS 886 - Neueste Entwicklungen bei Basismodellen.
- CS25-Transformers United
- ChatGPT Prompt Engineering
- Princeton: Understanding Large Language Models
- CS324 - Large Language Models
- State of GPT
- A Visual Guide to Mamba and State Space Models
- Let’s build GPT: from scratch, in code, spelled out.
- minbpe - Minimalistischer, sauberer Code für den Byte-Pair-Encoding- (BPE-)Algorithmus, der häufig bei der Tokenisierung von LLMs verwendet wird.
- femtoGPT - Eine reine Rust-Implementierung eines minimalistischen Generative Pretrained Transformers.
- Neurips2022-Foundational Robustness of Foundation Models
- ICML2022-Welcome to the “Big Model” Era: Techniques and Systems to Train and Serve Bigger Models
- GPT in 60 Lines of NumPy
- LLM‑RL‑Visualized (EN) | LLM‑RL‑Visualized (中文) - Über 100 Übersichten zu LLM- und RL-Algorithmen📚.
LLM-Bücher
Abschnitt betitelt „LLM-Bücher“- Generative AI with LangChain: Build large language model (LLM) apps with Python, ChatGPT, and other LLMs - Enthält ein GitHub-Repository, das viele der Funktionen veranschaulicht.
- Build a Large Language Model (From Scratch) - Eine Anleitung zum Bau eines eigenen funktionsfähigen LLM.
- BUILD GPT: HOW AI WORKS - Erklärt, wie man einen Generative Pre-trained Transformer (GPT) von Grund auf programmiert.
- Hands-On Large Language Models: Language Understanding and Generation - Entdecken Sie die Welt der Large Language Models anhand von über 275 eigens erstellten Abbildungen in diesem illustrierten Leitfaden!
- The Chinese Book for Large Language Models - Ein einführendes LLM-Lehrbuch auf Grundlage von A Survey of Large Language Models.
Interessante Gedanken zu LLMs
Abschnitt betitelt „Interessante Gedanken zu LLMs“- Why did all of the public reproduction of GPT-3 fail?
- A Stage Review of Instruction Tuning
- LLM Powered Autonomous Agents
- Why you should work on AI AGENTS!
- Google “We Have No Moat, And Neither Does OpenAI”
- AI competition statement
- Prompt Engineering
- Noam Chomsky: The False Promise of ChatGPT
- Is ChatGPT 175 Billion Parameters? Technical Analysis
- The Next Generation Of Large Language Models
- Large Language Model Training in 2023
- How does GPT Obtain its Ability? Tracing Emergent Abilities of Language Models to their Sources
- Open Pretrained Transformers
- Scaling, emergence, and reasoning in large language models
Verschiedenes
Abschnitt betitelt „Verschiedenes“- Emergent Mind - Die neuesten KI-Nachrichten, von GPT-4 kuratiert und erläutert.
- ShareGPT - Teilen Sie Ihre unterhaltsamsten ChatGPT-Unterhaltungen mit nur einem Klick.
- Major LLMs + Data Availability
- 500+ Best AI Tools
- Cohere Summarize Beta - Cohere Summarize Beta wird vorgestellt: ein neuer Endpunkt für Textzusammenfassungen.
- chatgpt-wrapper - ChatGPT Wrapper ist eine inoffizielle Open-Source-Python-API und ein CLI-Tool für die Interaktion mit ChatGPT.
- Cursor - Schreiben, bearbeiten und besprechen Sie Ihren Code mit einer leistungsstarken KI.
- AutoGPT - Eine experimentelle Open-Source-Anwendung, die die Fähigkeiten des Sprachmodells GPT-4 demonstriert.
- OpenAGI - Wenn LLM auf Fachexperten trifft.
- EasyEdit - Ein benutzerfreundliches Framework zum Bearbeiten großer Language Models.
- chatgpt-shroud - Eine Chrome-Erweiterung für OpenAI ChatGPT, die den Datenschutz verbessert, indem sie das einfache Ein- und Ausblenden des Chatverlaufs ermöglicht. Ideal zum Schutz der Privatsphäre bei Bildschirmfreigaben.
- AI For Developers - Liste von KI-Tools und Agenten für Entwickler.
Mitwirken
Abschnitt betitelt „Mitwirken“Dies ist ein aktives Repository, und Ihre Beiträge sind jederzeit willkommen!
Ich lasse einige Pull Requests offen, wenn ich mir nicht sicher bin, ob sie für LLMs großartig sind. Sie können darüber abstimmen, indem Sie ihnen ein 👍 hinzufügen.
Wenn Sie Fragen zu dieser kuratierten Liste haben, wenden Sie sich gerne an mich unter chengxin1998@stu.pku.edu.cn.
HagiCode
HagiCode ist ein agentischer Coding-Arbeitsplatz. Vielseitige, komfortable Interaktionen in der Benutzeroberfläche machen Planung, Agent-Ausführung und Projektarbeit zugänglich und leicht nachvollziehbar – für ein ansprechendes Entwicklungserlebnis.
Entdecken Sie ein ansprechendes Entwicklungserlebnis mit vielseitigen, komfortablen Interaktionen in der Benutzeroberfläche.

- IntelligentOpenSpec-Workflows machen aus einer Absicht einen umsetzbaren Weg vom Vorschlag über Design und Aufgaben bis zur Auslieferung.
- EffizientMulti-Agent-Ausführung führt Recherche, Umsetzung und Prüfung parallel aus, über mehrere Repositories und die Agent CLIs, die Sie bereits nutzen.
- InteressantVielseitige, komfortable Interaktionen in der Benutzeroberfläche machen Planung, Agent-Ausführung und Projektarbeit zugänglich und leicht nachvollziehbar.
Für Windows herunterladen
HagiCode teilen

Aus Ideen wird ausgelieferte Software.
HagiCode ist ein agentischer Coding-Arbeitsplatz: OpenSpec-Workflows planen die Änderung, Multi-Agent-Ausführung setzt sie um, und Hero Scenario macht den langen Weg sichtbar, bis aus der Idee ausgelieferte Software wird.
- Intelligent
- OpenSpec-Workflows machen aus einer Absicht einen Weg vom Vorschlag bis zur Auslieferung.
- Effizient
- Multi-Agent-Ausführung treibt Recherche, Umsetzung und Prüfung parallel voran.
- Unterhaltsam
- UI-Interaktionen erleichtern Planung, Agent-Ausführung und Projektarbeit.
© 2026 HagiCode | Powered By hagilight-starlight@0.21.0 | Branch: main | Commit: 745b50b | Built: