
RLHF
Source: https://github.com/opendilab/awesome-RLHF at
96acdd4571e7
License: Apache-2.0
Read the English original
This edition is an AI-assisted translation.
뚱 베어 RLHF (인적 피드백을 가진 RL)
섹션 제목: “뚱 베어 RLHF (인적 피드백을 가진 RL)”


** 인간 피드백을 가진 보강 학습 ** (RLHF). 그리고 저장소는 지속적으로 frontier를 추적하기 위해 업데이트 될 것입니다 RLHF.
팔로우 및 스타에 오신 것을 환영합니다!
본문 바로가기
섹션 제목: “본문 바로가기”회사연혁 RLHF
섹션 제목: “회사연혁 RLHF”의 아이디어 RLHF reinforcement Learning의 방법을 사용하여 인간 피드백으로 언어 모델을 최적화합니다. RLHF 텍스트 데이터의 일반적인 corpus에서 복잡한 인간 값으로 훈련 된 모델을 정렬하기 시작합니다.
- RLHF 큰 언어 모형을 위해 (LLM)
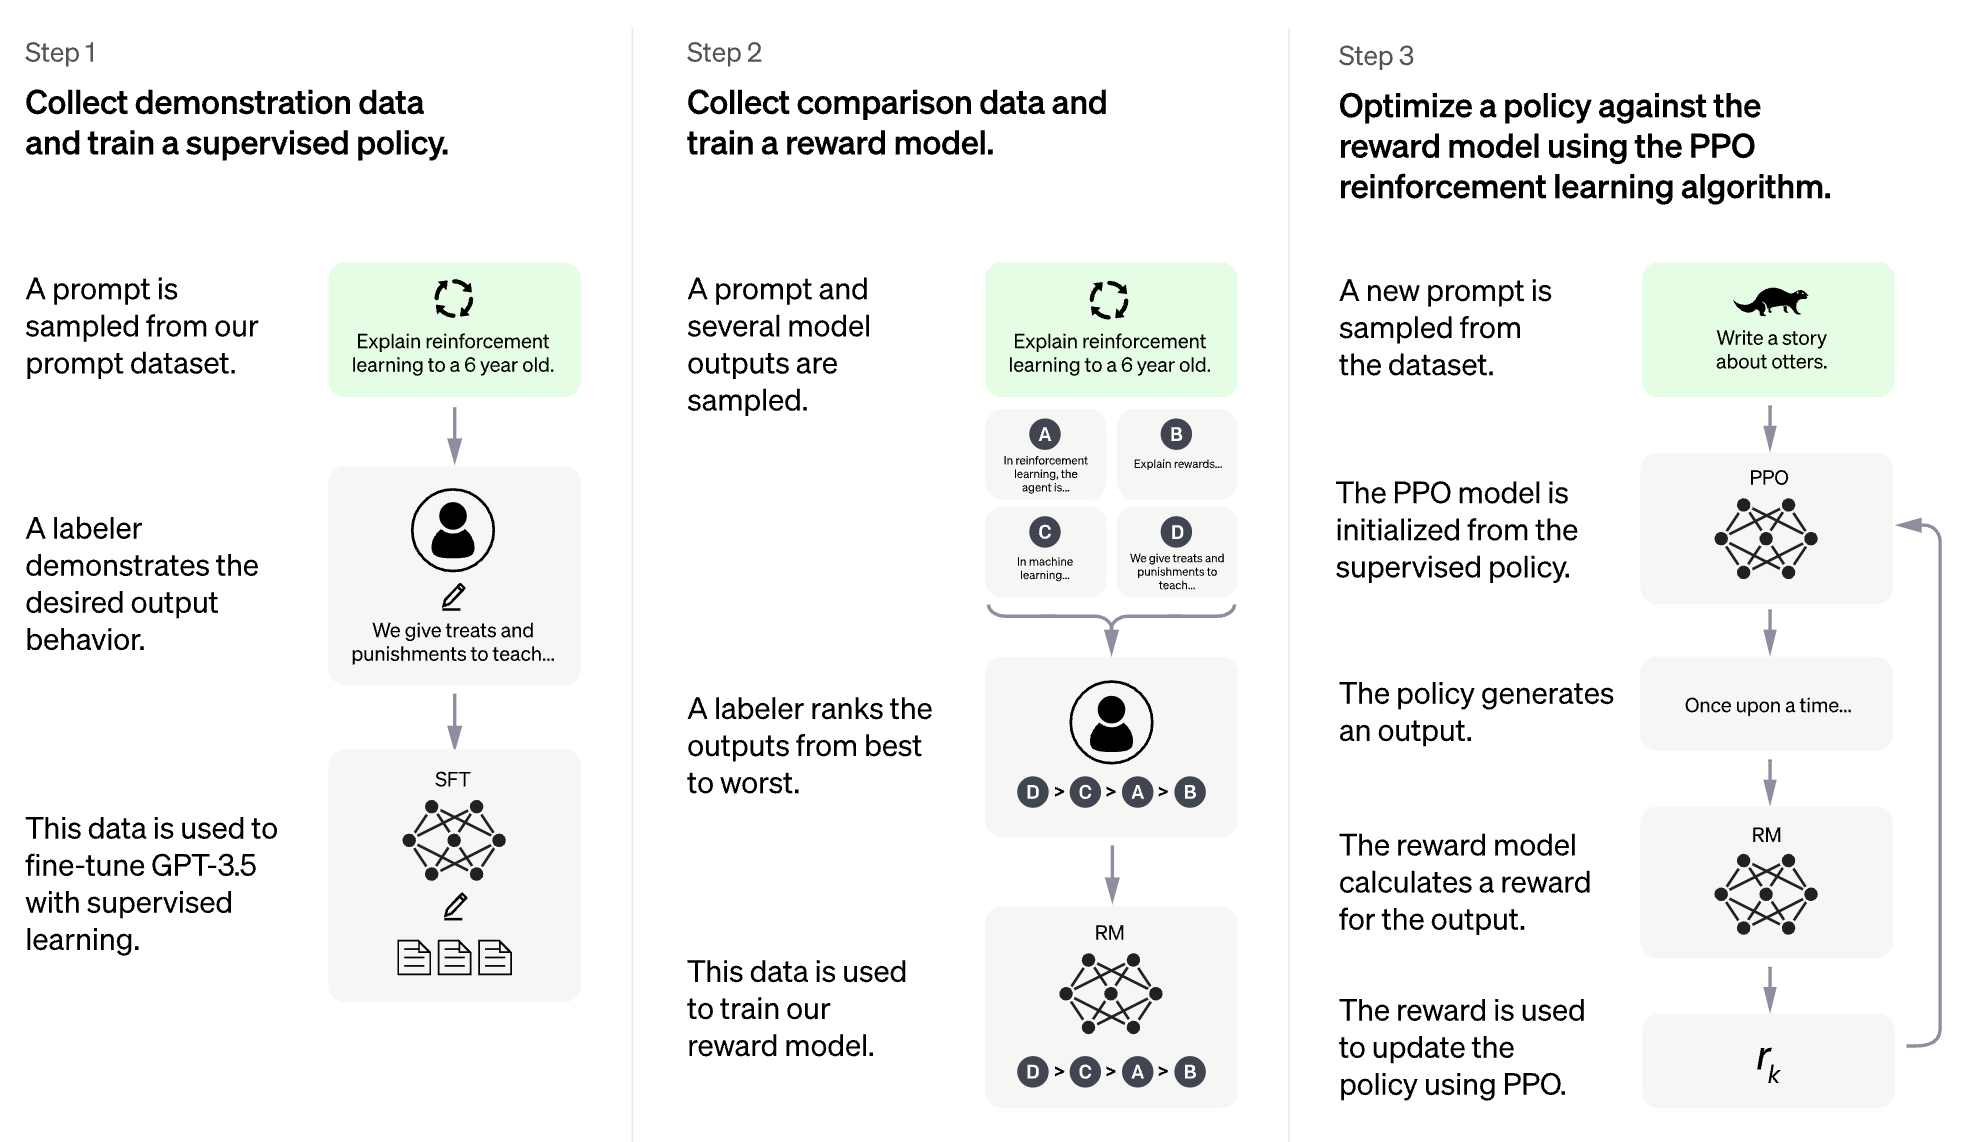
- RLHF 비디오 게임 (e.g. Atari)
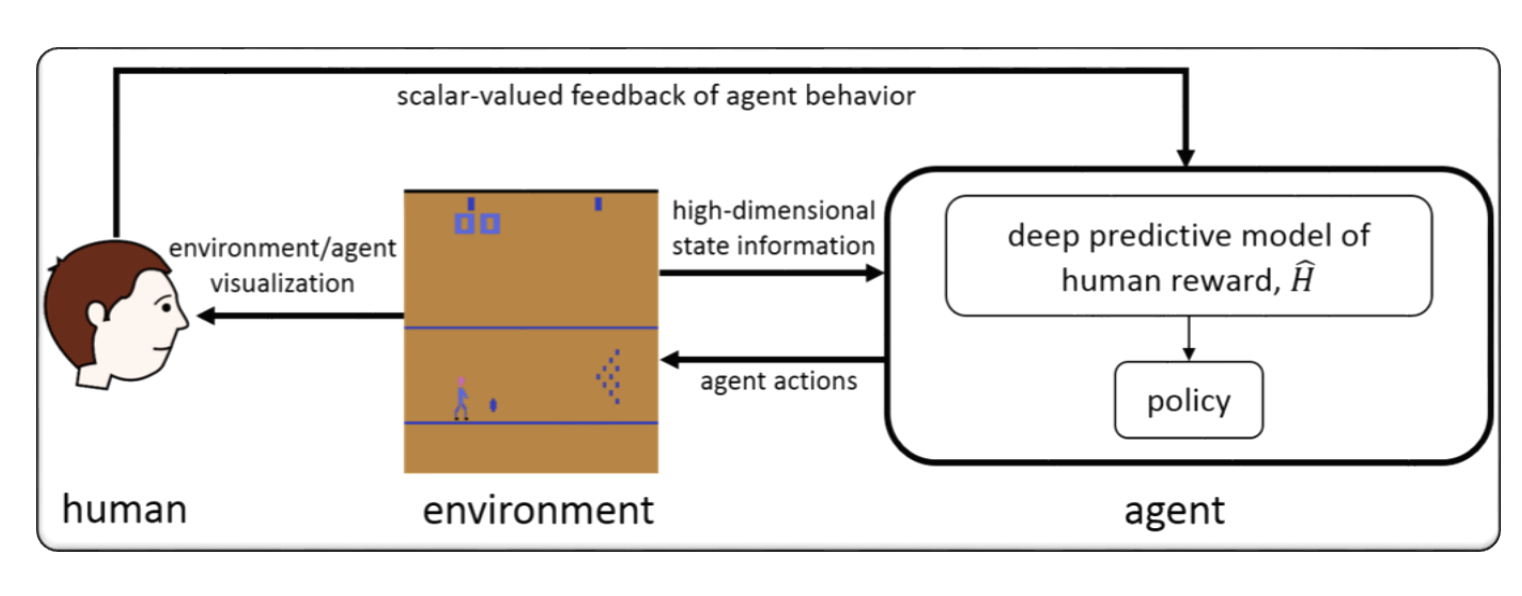
상세 설명
섹션 제목: “상세 설명”(다음 섹션은 자동으로 생성되었습니다. ChatGPT)
RLHF 일반적으로 “Human Feedback을 통한 보강 학습”을 말한다. Reinforcement Learning (RL)은 환경에 대한 피드백을 바탕으로 의사 결정을 내릴 수있는 기계 학습 유형입니다. 내 계정 RLHF, 대리인은 또한 그것의 행동의 등급 또는 평가의 모양에 있는 인간에게서 의견, 그것을 빨리 배우고 정확하게 배울 수 있는 것을 도울 수 있습니다.
RLHF 인공 지능의 활성 연구 영역, 로봇, 게임 및 개인화 된 권장 시스템과 같은 분야에서 응용 프로그램. RL의 도전 과제를 해결하는 것을 추구합니다. 에이전트가 환경에 대한 피드백을 제한하고 인간의 입력을 사용하여 성능 향상.
인간 피드백을 가진 보강 학습 (Reinforcement Learning)RLHF)는 인공 지능에 있는 연구의 급속한 발전 지역이고, 개발된 몇몇 선진 기술이의 성과를 개량하기 위하여 개발되었습니다 RLHF 시스템. 다음은 몇 가지 예입니다.
-
Inverse Reinforcement Learning (IRL): IRL 에이전트가 인간 피드백에서 보상 기능을 배우는 것을 허용하는 기술은 사전 정의 보상 기능에 의존하는 것보다 오히려. 더 복잡한 피드백 신호를 배우기 위해 에이전트를 사용할 수 있습니다. -
Apprenticeship Learning: Apprenticeship 학습은 결합하는 기술입니다. IRL 인간 피드백과 전문가의 데모를 통해 에이전트를 활성화 할 수 있습니다. 이것은 에이전트가 더 빨리 배우고 효과적으로, 그것은 긍정적과 부정적인 피드백에서 배울 수 있기 때문에. -
Interactive Machine Learning (IML): IML 에이전트와 인간 전문가 사이의 적극적인 상호 작용을 포함하는 기술은 전문가가 실시간으로 에이전트의 행동에 대한 피드백을 제공 할 수 있습니다. 이것은 에이전트가 학습 프로세스의 각 단계에서의 작업에 대한 피드백을받을 수 있기 때문에 신속하고 효율적으로 학습 할 수 있습니다. -
Human-in-the-Loop Reinforcement Learning (HITLRL): HITLRL 보상 쉐이핑, 액션 선택 및 정책 최적화와 같은 여러 수준에서 인간의 피드백을 통합하는 기술입니다. 이것은 효율성과 효율성을 개량하는 것을 도울 수 있습니다 RLHF 인간과 기계 둘 다의 힘의 이점을 가지고 가는 체계.
다음은 인간 피드백을 가진 보강 학습의 몇 가지 예입니다 (RLHF):
-
Game Playing: 게임 플레이에서, 인간 피드백은 다른 게임 시나리오에서 효과적인 에이전트 학습 전략과 전술을 도울 수 있습니다. 예를 들어, Go의 인기있는 게임에서 인간의 전문가들은 이동에 대한 에이전트에 대한 피드백을 제공 할 수 있으며 게임 플레이와 의사 결정의 개선을 돕습니다. -
Personalized Recommendation Systems: 권장 시스템에서, 인간 피드백은 에이전트가 개인 사용자의 선호도를 배우는 데 도움이 될 수 있습니다. 개인 권장 사항을 제공 할 수 있습니다. 예를 들어, 에이전트는 권장된 제품에서 피드백을 사용할 수 있습니다. -
Robotics: 로봇에서 인간 피드백은 에이전트가 안전하고 효율적인 방식으로 물리적 환경과 상호 작용하는 방법을 배울 수 있습니다. 예를 들어, 로봇은 가장 좋은 경로에서 인간 운영자로부터 피드백을 통해 새로운 환경을 더 빠르게 탐색하는 것을 배울 수 있습니다. -
Education: 교육에서 인간 피드백은 더 효과적으로 학생들을 가르치는 방법을 배울 수 있습니다. 예를 들어 AI 기반 튜터는 학습 경험을 개인화하는 데 도움이 다른 학생들과 전략을 잘 가르치는 교사의 피드백을 사용할 수 있습니다.
회사 소개
섹션 제목: “회사 소개”당신은 또한 할 수 있습니다 이 링크를 방문 AI-enhanced 종이 읽기 경험을 얻기 위해.
format:- [title](paper link) [links] - author1, author2, and author3... - publisher - keyword - code - experiment environments and datasets2026
섹션 제목: “2026”-
Why DPO is a Misspecified Estimator and How to Fix It
- Aditya Gopalan, Sayak Ray Chowdhury, Debangshu Banerjee
- 키워드: DPO, RLHF, Preference, Alignment, LLM
-
What’s In My Human Feedback? Learning Interpretable Descriptions of Preference Data
- Rajiv Movva, Smitha Milli, Sewon Min, Emma Pierson
- 키워드: RLHF, Preference, Alignment, Safety, Human Feedback
-
Multiplayer Nash Preference Optimization
- Fang Wu, Xu Huang, Weihao Xuan, Zhiwei Zhang, Yijia Xiao, Guancheng Wan, Xiaomin Li, Bing Hu, Peng Xia, Jure Leskovec, Yejin Choi
- 키워드: PPO, RLHF, Preference, Alignment, LLM
-
Token-Importance Guided Direct Preference Optimization
- Ning Yang, Hai Lin, Yibo Liu, Baoliang Tian, Guoqing Liu, Haijun Zhang
- 키워드: DPO, RLHF, Preference, Alignment, LLM
-
SafeDPO: A Simple Approach to Direct Preference Optimization with Enhanced Safety
- Geon-Hyeong Kim, Yu Jin Kim, Byoungjip Kim, Honglak Lee, Kyunghoon Bae, Youngsoo Jang, Moontae Lee
- 키워드: DPO, RLHF, Reward Model, Preference, Alignment
-
BaseReward: A Strong Baseline for Multimodal Reward Model
- YiFan Zhang, Haihua Yang, Huanyu Zhang, Yang Shi, Zezhou Chen, Haochen Tian, Chaoyou Fu, Kai WU, Bo Cui, Xu Wang, Jianfei Pan, Haotian Wang, Zhang Zhang, Liang Wang
- 키워드: RLHF, Reward Model, Preference, Multimodal, LLM
-
The Alignment Auditor: A Bayesian Framework for Verifying and Refining LLM Objectives
- Matthieu Bou, Nyal Patel, Arjun Jagota, Satyapriya Krishna, Sonali Parbhoo
- 키워드: RLHF, Preference, Alignment, Safety, LLM
-
Uni-DPO: A Unified Paradigm for Dynamic Preference Optimization of LLMs
- Shangpin Peng, Weinong Wang, Zhuotao Tian, Senqiao Yang, Xing W, Haotian Xu, Chengquan Zhang, Takashi Isobe, Baotian Hu, Min Zhang
- 키워드: DPO, RLHF, Preference, Multimodal, LLM
-
Learning to summarize user information for personalized reinforcement learning from human feedback
- HyunJi Nam, Yanming Wan, Mickel Liu, Peter F. Ahnn, Jianxun Lian, Natasha Jaques
- 키워드: RLHF, Reward Model, Preference, Alignment, LLM
-
Token-Guard: Towards Token-Level Hallucination Control via Self-Checking Decoding
- Yifan Zhu, Huiqiang Rong, Haoran Luo
- 키워드: RLHF, LLM, Token-level, Reinforcement Learning, Human Feedback
-
Pretrain Value, Not Reward: Decoupled Value Policy Optimization
- Chenghua Huang, Lu Wang, Fangkai Yang, Pu Zhao, Qingwei Lin, Dongmei Zhang, Saravan Rajmohan
- 키워드: RLHF, Reward Model, Preference, LLM, Optimization
-
- ruipeng zhang, Zhihao Li, Haozhang Yuan, C.L.Philip Chen, Tong Zhang
- 키워드: DPO, Preference, Optimization, Human Feedback
-
Unifying Stable Optimization and Reference Regularization in RLHF
- Li He, Qiang Qu, He Zhao, Stephen Wan, Dadong Wang, Lina Yao, Tongliang Liu
- 키워드: RLHF, Preference, Alignment, Optimization, Reinforcement Learning
-
Text2Grad: Reinforcement Learning from Natural Language Feedback
- Hanyang Wang, Lu Wang, Chaoyun Zhang, Tianjun Mao, Si Qin, Qingwei Lin, Saravan Rajmohan, Dongmei Zhang
- 키워드: RLHF, Reward Model, Alignment
-
ARMOR: Aligning Secure and Safe Large Language Models via Meticulous Reasoning
- Zhengyue Zhao, YingziYingzi Ma, Somesh Jha, Marco Pavone, Patrick McDaniel, Chaowei Xiao
- 키워드: RLHF, Alignment, Safety, LLM, Optimization
-
Reward Model Routing in Alignment
- Xinle Wu, Yao Lu
- 키워드: RLHF, Reward Model, Preference, Alignment, LLM
-
- Shuhang Chen, Yunqiu Xu, Junjie Xie, Aojun Lu, Tao Feng, ZEYING HUANG, ZHANG NING, Yi Sun, Yi Yang, Hangjie Yuan
- 키워드: Reward Model, Multimodal, Optimization
-
All Roads Lead to Likelihood: The Value of Reinforcement Learning in Fine-Tuning
- Gokul Swamy, Sanjiban Choudhury, Wen Sun, Steven Wu, Drew Bagnell
- 키워드: PPO, Reward Model, Preference, Reinforcement Learning
-
General Exploratory Bonus for Optimistic Exploration in RLHF
- Wendi Li, Changdae Oh, Sharon Li
- 키워드: RLHF, Alignment, Reinforcement Learning, Human Feedback
-
RE-PO: Robust Enhanced Policy Optimization as a General Framework for LLM Alignment
- Xiaoyang Cao, Zelai Xu, Mo Guang, Kaiwen Long, Michiel A. Bakker, Yu Wang, Chao Yu
- 키워드: DPO, RLHF, Preference, Alignment, LLM
-
Learning Correlated Reward Models: Statistical Barriers and Opportunities
- Yeshwanth Cherapanamjeri, Constantinos Costis Daskalakis, Gabriele Farina, Sobhan Mohammadpour
- 키워드: RLHF, Reward Model, Preference, Reinforcement Learning, Human Feedback
-
Verification and Co-Alignment via Heterogeneous Consistency for Preference-Aligned LLM Annotations
- Cheng Chen, Haiyan Yin, Ivor Tsang
- 키워드: RLHF, Preference, Alignment, LLM
-
Disentangling Length Bias in Preference Learning via Response-Conditioned Modeling
- Jianfeng Cai, Jinhua Zhu, Ruopei Sun, Yue Wang, Li Li, Wengang Zhou, Houqiang Li
- 키워드: DPO, RLHF, Reward Model, Preference, LLM
-
Enforcing Axioms for AI Alignment under Loss-Based Rules
- Alexandros Hollender, Sonja Kraiczy
- 키워드: RLHF, Reward Model, Preference, Alignment, Reinforcement Learning
-
OPPO: Accelerating PPO-based RLHF via Pipeline Overlap
- Kaizhuo Yan, YingJie Yu, Yifan Yu, Haizhong Zheng, Fan Lai
- 키워드: PPO, RLHF, Reward Model, Preference, LLM
-
QuRL: Rubrics As Judge For Open-Ended Question Answering
- Xiyu Wei, Qingwei Zong, Xiaoguang Li, Eugene J. Yu, Sujian Li
- 키워드: LLM, Optimization, Reinforcement Learning, Human Feedback
-
Translate Policy to Language: Flow Matching Generated Rewards for LLM Explanations
- Xinyi Yang, Liang Zeng, Heng Dong, Chao Yu, Xiaoran Wu, Huazhong Yang, Yu Wang, Milind Tambe, Tonghan Wang
- 키워드: RLHF, LLM, Reinforcement Learning
-
Skywork-Reward-V2: Scaling Preference Data Curation via Human-AI Synergy
- Chris Yuhao Liu, Liang Zeng, Yuzhen Xiao, Jujie He, Jiacai Liu, Chaojie Wang, Rui Yan, Wei Shen, Fuxiang Zhang, Jiacheng Xu, Yang Liu
- 키워드: RLHF, Reward Model, Preference, Alignment, Safety
-
Stackelberg Learning from Human Feedback: Preference Optimization as a Sequential Game
- Barna Pásztor, Thomas Kleine Buening, Andreas Krause
- 키워드: RLHF, Preference, Alignment, Nash, Optimization
-
Swap-guided Preference Learning for Personalized Reinforcement Learning from Human Feedback
- Gihoon Kim, Euntai Kim
- 키워드: RLHF, Reward Model, Preference, Reinforcement Learning, Human Feedback
-
Beyond Binary Preferences: A Principled Framework for Reward Modeling with Ordinal Feedback
- Amirhossein Afsharrad, Ruida Zhou, Luca Viano, Sanjay Lall, Mohammad Ghavamzadeh
- 키워드: Reward Model, Preference, Safety, Human Feedback
-
RLBFF: Binary Flexible Feedback to bridge between Human Feedback & Verifiable Rewards
- Zhilin Wang, Jiaqi Zeng, Olivier Delalleau, Ellie Evans, Daniel Egert, Hoo-Chang Shin, Felipe Soares, Yi Dong, Oleksii Kuchaiev
- 키워드: RLHF, Reward Model, Preference, Alignment, LLM
-
Reward Models Inherit Value Biases from Pretraining
- Brian Christian, Jessica A F Thompson, Elle, Vincent Adam, Hannah Rose Kirk, Christopher Summerfield, Tsvetomira Dumbalska
- 키워드: Reward Model, Preference, Alignment, Safety, LLM
-
Semantic-aware Wasserstein Policy Regularization for Large Language Model Alignment
- Byeonghu Na, Hyungho Na, Yeongmin Kim, Suhyeon Jo, HeeSun Bae, Mina Kang, Il-chul Moon
- 키워드: RLHF, Preference, Alignment, LLM, Reinforcement Learning
-
RewardBench 2: Advancing Reward Model Evaluation
- Saumya Malik, Valentina Pyatkin, Sander Land, Jacob Morrison, Noah A. Smith, Hannaneh Hajishirzi, Nathan Lambert
- 키워드: RLHF, Reward Model, Preference, Alignment, Safety
-
Causally Robust Reward Learning from Reason-Augmented Preference Feedback
- Minjune Hwang, Yigit Korkmaz, Daniel Seita, Erdem Biyik
- 키워드: Reward Model, Preference
-
COMAL: A Convergent Meta-Algorithm for Aligning LLMs with General Preferences
- Yixin Liu, Argyris Oikonomou, Weiqiang Zheng, Yang Cai, Arman Cohan
- 키워드: RLHF, Preference, Alignment, Nash, Optimization
-
Displacement-Resistant Extensions of DPO with Nonconvex $f$-Divergences
- Idan Pipano, Shoham Sabach, Kavosh Asadi, Mohammad Ghavamzadeh
- 키워드: DPO, RLHF
-
Keep the Best, Forget the Rest: Reliable Alignment with Order-Aware Preference Optimization
- Jiahui Zhu, Yuanjie Shi, Xiyue Peng, Xin Liu, Yan Yan, Honghao Wei
- 키워드: DPO, PPO, RLHF, Preference, Alignment
-
Cultivating Pluralism In Algorithmic Monoculture: The Community Alignment Dataset
- Lily H Zhang, Smitha Milli, Karen Long Jusko, Jonathan Smith, Brandon Amos, Wassim Bouaziz, Manon Revel, Jack Kussman, Yasha Sheynin, Lisa Titus, Bhaktipriya Radharapu, Jane Yu, Vidya Sarma, Kristopher Rose, Maximilian Nickel
- 키워드: Preference, Alignment, LLM
-
Fair Reinforcement Learning for Just AI
- Ezgi Korkmaz
- 키워드: Preference, Alignment, Optimization, Reinforcement Learning, Human Feedback
-
Robust Reward Modeling via Causal Rubrics
- Pragya Srivastava, Harman Singh, Rahul Madhavan, Gandharv Patil, Sravanti Addepalli, Arun Suggala, Rengarajan Aravamudhan, Soumya Sharma, Anirban Laha, Aravindan Raghuveer, Karthikeyan Shanmugam, Doina Precup
- 키워드: DPO, Reward Model, Alignment, Safety, LLM
-
Escaping Policy Contraction: Contraction-Aware PPO (CaPPO) for Stable Language Model Fine-Tuning
- Dun Yuan, Di Wu, Xue Liu
- 키워드: PPO, RLHF, Alignment, Optimization, Reinforcement Learning
-
Beyond Pairwise: Empowering LLM Alignment With (Ranked) Choice Modeling
- Yuxuan Tang, Yifan Feng
- 키워드: DPO, PPO, Preference, Alignment, LLM
-
Learning Ordinal Probabilistic Reward from Preferences
- Longze Chen, Lu Wang, Renke Shan, Ze Gong, Run Luo, Jiaming Li, Jing Luo, Qiyao Wang, Min Yang
- 키워드: Reward Model, LLM
-
Eliminating Inductive Bias in Reward Models with Information-Theoretic Guidance
- Zhuo Li, Pengyu Cheng, Zhechao Yu, FeifeiTong, Anningzhe Gao, Tsung-Hui Chang, Xiang Wan, erchao.zec, xiaoxi jiang, guanjunjiang
- 키워드: RLHF, Reward Model, Preference, LLM, Optimization
-
Alignment-Weighted DPO: A principled reasoning approach to improve safety alignment
- Mengxuan Hu, Vivek Datla, Anoop Kumar, Zihan Guan, Sheng Li, Alfy Samuel, Daben Liu
- 키워드: DPO, RLHF, Preference, Alignment, Safety
-
Evaluating and Improving Cultural Awareness of Reward Models for LLM Alignment
- Hongbin Zhang, Kehai Chen, Xuefeng Bai, Yang Xiang, Min Zhang
- 키워드: Reward Model, Preference, Alignment, LLM, Reinforcement Learning
-
Balancing the Experts: Unlocking LoRA-MoE for GRPO via Mechanism-Aware Rewards
- Changlian Ma, Zizheng Huang, Xiangyu Zeng, Yi Wang, Cheng Liang, Kun Tian, Xinhai Zhao, Limin Wang
- 키워드: Alignment, Multimodal, Optimization, Reinforcement Learning
-
Bradley-Terry and Multi-Objective Reward Modeling Are Complementary
- Zhiwei Zhang, Hui Liu, Xiaomin Li, Zhenwei Dai, Jingying Zeng, Fali Wang, Minhua Lin, Ramraj Chandradevan, Linlin Wu, Zhen Li, Chen Luo, Zongyu Wu, Xianfeng Tang, Qi He, Suhang Wang
- 키워드: RLHF, Reward Model, Preference, LLM, Reinforcement Learning
-
Beyond RLHF and NLHF: Population-Proportional Alignment under an Axiomatic Framework
- Kihyun Kim, Jiawei Zhang, Asuman E. Ozdaglar, Pablo A. Parrilo
- 키워드: Preference, Alignment
-
ActiveDPO: Active Direct Preference Optimization for Sample-Efficient Alignment
- Xiaoqiang Lin, Arun Verma, Zhongxiang Dai, Daniela Rus, See-Kiong Ng, Bryan Kian Hsiang Low
- 키워드: DPO, Reward Model, Preference, Alignment, LLM
-
BranchGRPO: Stable and Efficient GRPO with Structured Branching in Diffusion Models
- Yuming Li, Yikai Wang, Yuying zhu, Zhongyu Zhao, Ming Lu, Qi She, Shanghang Zhang
- 키워드: Preference, Alignment, Optimization
-
Safety Game: Inference-Time Alignment of Black-Box LLMs via Constrained Optimization
- Tuan Nguyen, Long Tran-Thanh
- 키워드: Alignment, Safety, LLM, Reinforcement Learning, Human Feedback
-
Threshold-Guided Optimization for Visual Generative Models
- Jinbin Bai, Yu Lei, Qingyu Shi, Aosong Feng, Yi Xin, Zhuoran Zhao, Fei Shen, Kaidong Yu, Xiangtai Li
- 키워드: Reward Model, Preference, Alignment, Diffusion, Optimization
-
Noise-corrected GRPO: From Noisy Rewards to Unbiased Gradients
- Omar Elmansouri, Fathinah Izzati, Mohamed El Amine Seddik, Salem Lahlou
- 키워드: RLHF, Reward Model, LLM, Optimization, Reinforcement Learning
-
Controllable and explainable personality sliders for LLMs at inference time
- Florian Hoppe, David Khachaturov, Robert Mullins, Mark Huasong Meng
- 키워드: PPO, RLHF, Alignment, LLM, Optimization
-
PS-PPO : Prefix-Sampling PPO for Critic-Free RLHF
- Doo Hwan Hwang, Kee-Eung Kim
- 키워드: PPO, RLHF, Optimization, Reinforcement Learning, Human Feedback
-
Unbiased Reward Modeling from Implicit Preference
- Eric Wang, Haocheng Yang, Licheng Pan, Lei Shen, Xiaoxi Li, Yinuo Wang, Zhichao Chen, Yuan Lu, Haoxuan Li, Zhouchen Lin
- 키워드: RLHF, Reward Model, Preference, Reinforcement Learning, Human Feedback
-
- Itai Shapira, Gerdus Benade, Ariel Procaccia
- 키워드: Preference, Alignment, Optimization, Human Feedback
-
Real-Time Aligned Reward Model beyond Semantics
- Zixuan Huang, Xin Xia, Yuxi Ren, Jianbin Zheng, Xuefeng Xiao, Hongyan Xie, Huaqiu Li, Songshi Liang, Zhongxiang Dai, Fuzhen Zhuang, Jianxin Li, Yikun Ban, deqing wang
- 키워드: RLHF, Reward Model, Preference, Alignment, LLM
-
Chasing Moving Targets with Online Self-Play Reinforcement Learning for Safer Language Models
- Mickel Liu, Liwei Jiang, Yancheng Liang, Simon Du, Yejin Choi, Tim Althoff, Natasha Jaques
- 키워드: RLHF, Reward Model, Alignment, Safety, LLM
-
B-Spar: Bayesian Sparse-Reward Modeling for RL-based Image Editing
- shusong xu, Peiye Liu, Yongbin Liu, Bangjie Yin, Zhaomang Sun, Zhenyu Chen, Tianyi Zheng, Peng-Tao Jiang, Jian Zhang, Yuzhao Wang, Jinwei Chen, Zhen Gu, Bo Li
- 키워드: Reward Model, Alignment, Multimodal, LLM, Optimization
-
Calibrated Preference Learning: The Case of Label Ranking
- Santo Thies, Viktor Bengs, Timo Kaufmann, Sebastian Vollmer, Eyke Hüllermeier
- 키워드: RLHF, Reward Model, Alignment
-
Understanding the Performance Gap in Preference Learning: A Dichotomy of RLHF and DPO
- Ruizhe Shi, Minhak Song, Runlong Zhou, Zihan Zhang, Maryam Fazel, Simon Du
- 키워드: DPO, RLHF, Reward Model, Preference, Optimization
-
DARC: Disagreement-Aware Alignment via Risk-Constrained Decoding
- mingxi Zou, Jiaxiang Chen, Junfan Li, Langzhang Liang, Qifan Wang, Xu Yinghui, Zenglin Xu
- 키워드: DPO, RLHF, Preference, Alignment, Optimization
-
The Personality Illusion: Revealing Dissociation Between Self-Reports & Behavior in LLMs
- Pengrui Han, Rafal Kocielnik, Peiyang Song, Ramit Debnath, Dean Mobbs, Anima Anandkumar, R. Michael Alvarez
- 키워드: RLHF, Alignment, LLM
-
Distributionally Robust Reinforcement Learning with Human Feedback
- Debmalya Mandal, Paulius Sasnauskas, Goran Radanovic
- 키워드: DPO, RLHF, Reward Model, Preference, LLM
-
Automatically Finding Reward Model Biases
- Atticus Wang, Iván Arcuschin, Arthur Conmy
- 키워드: Reward Model, LLM, Reinforcement Learning, Human Feedback
-
- Zichao Li, Jie Lou, Fangchen Dong, Zhiyuan Fan, Mengjie Ren, Hongyu Lin, Xianpei Han, Debing Zhang, Le Sun, Yaojie Lu, XingYu
- 키워드: RLHF, LLM, Optimization, Reinforcement Learning
-
Convex Optimization for Alignment and Preference Learning on a Single GPU
- Miria Feng, Mert Pilanci
- 키워드: DPO, RLHF, Preference, Alignment, LLM
-
MMKU-Bench: A Multimodal Update Benchmark for Diverse Visual Knowledge
- Baochen Fu, Yuntao Du, Cheng Chang, Baihao Jin, Wenzhi Deng, Muhao Xu, Hongmei Yan, Weiye Song, Yi Wan
- 키워드: RLHF, Multimodal, Reinforcement Learning, Human Feedback
-
Pushing Forward Pareto Frontiers of Proactive Agents with Behavioral Agentic Optimization
- Yihang Yao, Zhepeng Cen, Haohong Lin, Shiqi Liu, Zuxin Liu, Jiacheng Zhu, Zhang-Wei Hong, Laixi Shi, Ding Zhao
- 키워드: LLM, Reinforcement Learning, Human Feedback
-
Unbiased Alignment for Large Language Models with Noisy Preferences
- Jialiang Wang, Xianming Liu, Xiong Zhou, Hui Liu, Haoliang Li
- 키워드: DPO, Reward Model, Preference, Alignment, Optimization
-
Unbiased Principles, Robust Rewards
- Qingnan Ren, Zhen Fang, Shiting Huang, Yu Zeng, Lin Chen, Zehui Chen, Feng Zhao
- 키워드: RLHF, Reward Model, Reinforcement Learning, Human Feedback
-
The Secret Engine Behind RLHF: It’s Contarstive Learning All Along
- Xufei Lv, Kehai Chen, Haoyuan Sun, Xuefeng Bai, Min zhang, Houde Liu
- 키워드: DPO, RLHF, Preference, Alignment, LLM
-
When Distance Distracts: Representation Distance Bias in BT-Loss for Reward Models
- Tong Xie, Ching-Yuan Bai, Yuanhao Ban, Yunqi Hong, Haoyu Li, Cho-Jui Hsieh
- 키워드: RLHF, Reward Model, Alignment, LLM
-
Multi-Objective Preference Optimization: Improving Human Alignment of Generative Models
- Akhil Agnihotri, Rahul Jain, Deepak Ramachandran, Zheng Wen
- 키워드: DPO, RLHF, Preference, Alignment, Safety
-
TUR-DPO: Topology- and Uncertainty-Aware Direct Preference Optimization
- Abdulhady abas, Fatemeh Daneshfar, Seyedali Mirjalili, Mourad Oussalah
- 키워드: DPO, PPO, RLHF, Preference, Multimodal
-
Asymptotic Universal Alignment: A New Alignment Framework via Test-Time Scaling
- Yang Cai, Weiqiang Zheng
- 키워드: PPO, Preference, Alignment, LLM, Nash
-
Reward Modeling from Natural Language Human Feedback
- Zongqi Wang, Rui Wang, Yuchuan Wu, Yiyao Yu, Pinyi Zhang, Shaoning Sun, Yujiu Yang, Yongbin Li
- 키워드: Reward Model, Preference, Reinforcement Learning, Human Feedback
-
Efficient Preference Poisoning Attack on Offline RLHF
- Chenye Yang, Weiyu Xu, Lifeng Lai
- 키워드: DPO, RLHF, Preference, Optimization, Reinforcement Learning
-
Position: Agentic Safety is an Epistemic Property, Not a Behavioral One
- Charles Wang, Keir Dorchen, Peter Jin
- 키워드: RLHF, Preference, Alignment, Safety, Optimization
-
Position: Large Language Models Should Learn Personalized Rather Than Aggregated Human Preferences
- Cristina Garbacea
- 키워드: RLHF, Reward Model, Preference, Safety, Reinforcement Learning
-
- Yucong Huang, Xiucheng Li, Kaiqi Zhao, Jing Li
- 키워드: PPO, RLHF, Preference, Alignment, Nash
-
Factored Causal Representation Learning for Robust Reward Modeling in RLHF
- Yupei Yang, Lin Yang, Wanxi Deng, Lin Qu, Fan Feng, Biwei Huang, Shikui Tu, Lei Xu
- 키워드: RLHF, Reward Model, Preference, LLM, Reinforcement Learning
-
- Jabin Koo, Hoyoung Kim, Minwoo Jang, Jungseul Ok
- 키워드: RLHF, Reward Model, Preference, Alignment, LLM
-
Online Compatible Reward Identification from Preference Feedback
- Simone Drago, Marco Mussi, Alberto Maria Metelli
- 키워드: Preference, Safety, Reinforcement Learning, Human Feedback
-
$f$-Divergence Regularized RLHF: Two Tales of Sampling and Unified Analyses
- Di Wu, Chengshuai Shi, Jing Yang, Cong Shen
- 키워드: RLHF, Reinforcement Learning, Human Feedback
-
- Dongyoon Hahm, Dylan Hadfield-Menell, Kimin Lee
- 키워드: RLHF, Reward Model, Preference, Alignment, LLM
-
IRPM: Intergroup Relative Preference Modeling for Pointwise Generative Reward Models
- Haonan Song, Qingchen Xie, Huan Zhu, Feng Xiao, Luxi Xing, Liu Kang, Fuzhen Li, Zhiyong Zheng, Feng Jiang, Ziheng Li, Kun Yan, Qingyi Si, Yanghua Xiao, Hongcheng Guo, Fan Yang
- 키워드: RLHF, Reward Model, Preference, Reinforcement Learning, Human Feedback
-
Implicit Preference Alignment for Human Image Animation
- Yuanzhi Wang, Xuhua Ren, Jiaxiang Cheng, bing ma, Kai Yu, Tianxiang Zheng, Qinglin Lu, Zhen Cui
- 키워드: Preference, Alignment, Optimization, Reinforcement Learning, Human Feedback
-
Multilingual Safety Alignment Via Sparse Weight Editing
- Jiaming Liang, Zhaoxin Wang, Handing Wang
- 키워드: RLHF, Alignment, Safety, LLM, Reinforcement Learning
-
- Johannes Ackermann, Michael Noukhovitch, Takashi Ishida, Masashi Sugiyama
- 키워드: RLHF, Reward Model, LLM, Reinforcement Learning, Human Feedback
-
Graph-Preference Learning: Debiasing Network-Sampled Human Feedback for Target Welfare Estimation
- Guangrui Fan, DanDan Liu, AZNUL SABRI, Pan Lihu
- 키워드: DPO, RLHF, Reward Model, Preference
-
COLLIE: Guiding Skill Discovery in Semantically Coherent Latent Space
- Yao Luan, Ni Mu, Hanfei Ge, Yiqin Yang, Bo XU, Qing-Shan Jia
- 키워드: Human Feedback
-
Optimal Transport for Reward Modeling from Noisy Feedback
- Eric Wang, Licheng Pan, Haocheng Yang, Yunsheng Lu, Yongqi Tong, Yinuo Wang, Shijian Wang, Zhixuan Chu, Lei Shen, Haoxuan Li, Yuan Lu
- 키워드: RLHF, Reward Model, Preference, Reinforcement Learning, Human Feedback
-
Reliability-Aware LLM Alignment from Inconsistent Human Feedback
- Jingyi Huang, Ruohan Zong, Yujun Feng, Liran Ma, Lanyu Shang, Yang Zhang
- 키워드: DPO, RLHF, Preference, Alignment, LLM
-
Position: We Need Large Language Models Optimized For Our Well-Being
- Ashton Anderson, Harsh Kumar, Louis Tay, Karina Vold
- 키워드: RLHF, Preference, Optimization, Reinforcement Learning, Human Feedback
-
Implicit Safety Alignment from Crowd Preferences
- Qian Lin, Daniel S Brown
- 키워드: RLHF, Reward Model, Preference, Safety, Reinforcement Learning
-
Contrastive Weak-to-Strong Generalization
- Houcheng Jiang, Junfeng Fang, Jiaxin Wu, Tianyu Zhang, Chen Gao, Xiang Wang, Xiangnan He, Yang Deng
- 키워드: Reward Model, Alignment, LLM, Human Feedback
-
Distortion of AI Alignment Revisited: RLHF is a Decent Utilitarian Aligner
- Kazusato Oko, Annie Ulichney, Nika Haghtalab, Han Bao
- 키워드: RLHF, Preference, Reinforcement Learning, Human Feedback
-
- Yuan Sui, Bryan Hooi
- 키워드: LLM, Optimization, Human Feedback
-
Unifying Adversarial Robustness and Training Across Text Scoring Models
- Manveer Tamber, Hosna Oyarhoseini, Jimmy Lin
- 키워드: PPO, RLHF, Reward Model, LLM
-
ActiveUltraFeedback: Efficient Preference Data Generation using Active Learning
- Davit Melikidze, Marian Schneider, Jessica Lam, Martin Wertich, Ido Hakimi, Barna Pasztor, Andreas Krause
- 키워드: RLHF, Preference, Alignment, LLM, Reinforcement Learning
-
- Mengyang Li, Shuang Liu, Zhong Zhang
- 키워드: DPO, RLHF, Preference, Optimization
-
The Sign Estimator: Preference Modeling for LLM Alignment under Heterogeneity
- Aymane El Gadarri, Ali Aouad, Vivek Farias
- 키워드: RLHF, Reward Model, Preference, Alignment, LLM
-
Leveraging Machine Unlearning for Cost-Efficient Preference Alignment
- XiaoHua Feng, Yuyuan Li, HuWei Ji, Li Zhang, Jiaming Zhang, Tianyu Du, Chaochao Chen
- 키워드: Preference, Alignment, LLM, Optimization, Reinforcement Learning
-
Regularization in the Axiomatic Approach to Learning from Human Preferences
- Ezgi Korkmaz
- 키워드: RLHF, Preference, Reinforcement Learning, Human Feedback
-
- Wenxuan Zhou, Shujian Zhang, brice magdalou, John Lambert, Ehsan Amid, Richard Nock, Andrew Hard
- 키워드: DPO, PPO, RLHF, Reward Model, Preference
-
Conditional Equivalence of DPO and RLHF: Assumptions, Failure Modes, and Provable Alignment
- Yonggang Zhang, Zhiqin Yang, Wei Xue, Dong Fang, Bo Han, Yike Guo
- 키워드: DPO, RLHF, Preference, Alignment, Optimization
-
A Regret Minimization Framework on Preference Learning in Large Language Models
- Suhwan Kim, Taehyun Cho, Youngsoo Jang, Geon-Hyeong Kim, Yu Jin Kim, Moontae Lee, Jungwoo Lee
- 키워드: RLHF, Preference, Optimization, Reinforcement Learning, Human Feedback
-
Position: Measuring Human Preferences in RLHF is a Social Science Problem
- Bijean Ghafouri, Eun Cheol Choi, Priyanka Dey, Emilio Ferrara
- 키워드: RLHF, Preference, Alignment
-
Mitigating Reward Hacking in RLHF via Bayesian Non-negative Reward Modeling
- Zhibin Duan, Guowei Rong, Zhuo Li, Bo Chen, Mingyuan Zhou, Dandan Guo
- 키워드: Reward Model, Preference, LLM, Optimization, Reinforcement Learning
2025
섹션 제목: “2025”-
Position: The Complexity of Perfect AI Alignment — Formalizing the RLHF Trilemma
- Subramanyam Sahoo, Aman Chadha, Vinija Jain, Divya Chaudhary
- 키워드: Alignment Bias, Safety, Interpretability
-
What’s In My Human Feedback? Learning Interpretable Descriptions of Preference Data
- Rajiv Movva, Smitha Milli, Sewon Min, Emma Pierson
- 키워드: Sparse Autoencoders, Interpretable Data Curation, Reward Hacking, Feature Attribution
- 코드: Official
-
Towards Efficient Online Exploration for Reinforcement Learning with Human Feedback
- Gen Li, Yuling Yan
- 키워드: Online RL, Multi-armed Bandit, LLMs
-
OpenRLHF: A Ray-based Easy-to-use, Scalable and High-performance RLHF Framework
- Jian Hu, Xibin Wu, Wei Shen, Jason Klein Liu, Weixun Wang, Songlin Jiang, Haoran Wang, Hao Chen, Bin Chen, Wenkai Fang, Xianyu, Yu Cao, Haotian Xu, Yiming Liu
- 키워드: Framework
- 코드: Official
-
Language Models Learn to Mislead Humans via RLHF
- Jiaxin Wen, Ruiqi Zhong, Akbir Khan, Ethan Perez, Jacob Steinhardt, Minlie Huang, Sam Bowman, He He, Shi Feng
- 키워드: Open-ended Task, Human Reward, Alignment Method, LLMs
-
A Simple and Effective Reinforcement Learning Method for Text-to-Image Diffusion Fine-tuning
- Shashank Gupta, Chaitanya Ahuja, Tsung-Yu Lin, Sreya Dutta Roy, Harrie Oosterhuis, Maarten de Rijke, and Satya Narayan Shukla
- 키워드: Diffusion Model, REINFORCE, PPO
-
Differential Information: An Information-Theoretic Perspective on Preference Optimization
- Yunjae Won, Hyunji Lee, Hyeonbin Hwang, Minjoon Seo
- 키워드: Preference Optimization, Information-Theoretic Analysis, Log-Ratio Reward Parameterization, Data Distribution, Log-Likelihood Displacement
-
Generalist Reward Models: Found Inside Large Language Models
- Yi-Chen Li, Tian Xu, Yang Yu, Xuqin Zhang, Xiong-Hui Chen, Zhongxiang Ling, Ningjing Chao, Lei Yuan, Zhi-Hua Zhou
- 키워드: Offline Inverse RL, LLM-as-a-judge, Training-free, Alignment
-
A Unified Pairwise Framework for RLHF: Bridging Generative Reward Modeling and Policy Optimization
- Wenyuan Xu, Xiaochen Zuo, Chao Xin, Yu Yue, Lin Yan, Yonghui Wu
- 키워드: Generative Pairwise Reward Model, Policy Optimization, Framework
-
Exploring Data Scaling Trends and Effects in Reinforcement Learning from Human Feedback
- Wei Shen, Guanlin Liu, Zheng Wu, Ruofei Zhu, Qingping Yang, Chao Xin, Yu Yue, Lin Yan
- 키워드: Data Scaling, Reward Hacking, LLMs
-
RLTHF: Targeted Human Feedback for LLM Alignment
- Yifei Xu, Tusher Chakraborty, Emre Kıcıman, Bibek Aryal, Eduardo Rodrigues, Srinagesh Sharma, Roberto Estevao, Maria Angels de Luis Balaguer, Jessica Wolk, Rafael Padilha, Leonardo Nunes, Shobana Balakrishnan, Songwu Lu, Ranveer Chandra
- 키워드: Human-AI Hybrid Framework, Efficient, Alignment, LLMs
-
Equilibrate RLHF: Towards Balancing Helpfulness-Safety Trade-off in Large Language Models
- Yingshui Tan, Yilei Jiang, Yanshi Li, Jiaheng Liu, Xingyuan Bu, Wenbo Su, Xiangyu Yue, Xiaoyong Zhu, Bo Zheng
- 키워드: Safety, Framework, Adaptive Message-wise Alignment Method, LLMs
-
MM-RLHF: The Next Step Forward in Multimodal LLM Alignment
- Yi-Fan Zhang, Tao Yu, Haochen Tian, Chaoyou Fu, Peiyan Li, Jianshu Zeng, Wulin Xie, Yang Shi, Huanyu Zhang, Junkang Wu, Xue Wang, Yibo Hu, Bin Wen, Fan Yang, Zhang Zhang, Tingting Gao, Di Zhang, Liang Wang, Rong Jin, Tieniu Tan
- 키워드: Critique-based Reward Model, Dynamic Reward, Dataset
- 코드: Official
-
Test-Time Preference Optimization: On-the-Fly Alignment via Iterative Textual Feedback
- Yafu Li, Xuyang Hu, Xiaoye Qu, Linjie Li, Yu Cheng
- 키워드: Test-Time Optimization, Preference Learning, Iterative Feedback
- 코드: Official
-
Segmenting Text and Learning Their Rewards for Improved RLHF in Language Model
- Yueqin Yin, Shentao Yang, Yujia Xie, Ziyi Yang, Yuting Sun, Hany Awadalla, Weizhu Chen, and Mingyuan Zhou
- 키워드: Segment-level Reward Model, Dense Reward RLHF Framework, Improved PPO training for LLMs
- 코드: Official
-
REINFORCE++: A Simple and Efficient Approach for Aligning Large Language Models
- Jian Hu
- 키워드: Efficient, Alignment, Reinforcement Learning
- 코드: Official
2024
섹션 제목: “2024”-
DPO Meets PPO: Reinforced Token Optimization for RLHF
- Han Zhong, Zikang Shan, Guhao Feng, Wei Xiong, Xinle Cheng, Li Zhao, Di He, Jiang Bian, Liwei Wang
- 키워드: Token-wise Reward, DPO, PPO, RLHF
- 코드: Official
-
Reward-Augmented Data Enhances Direct Preference Alignment of LLMs
- Shenao Zhang, Zhihan Liu, Boyi Liu, Yufeng Zhang, Yingxiang Yang, Yongfei Liu, Liyu Chen, Tao Sun, Zhaoran Wang
- 키워드: Reward-Augmented Data, DPO, LLMs
- 코드: Official
-
The Accuracy Paradox in RLHF: When Better Reward Models Don’t Yield Better Language Models
- Yanjun Chen, Dawei Zhu, Yirong Sun, Xinghao Chen, Wei Zhang, Xiaoyu Shen
- 키워드: Reward Model Evaluation, Accuracy Paradox, LLM Alignment
- 코드: Official
-
Align Anything: Training All-Modality Models to Follow Instructions with Language Feedback
- Jiaming Ji, Jiayi Zhou, Hantao Lou, Boyuan Chen, Donghai Hong, Xuyao Wang, Wenqi Chen, Kaile Wang, Rui Pan, Jiahao Li, Mohan Wang, Josef Dai, Tianyi Qiu, Hua Xu, Dong Li, Weipeng Chen, Jun Song, Bo Zheng, Yaodong Yang
- 키워드: Multi-modality Alignment, Dataset, Training-evaluation Framework
- 코드: Official
-
REvolve: Reward Evolution with Large Language Models using Human Feedback
- Rishi Hazra, Alkis Sygkounas, Andreas Persson, Amy Loutfi, Pedro Zuidberg Dos Martires
- 키워드: Improved Reward Model with LLMs, Framework
- 코드: Official
-
Zeroth-Order Policy Gradient for Reinforcement Learning from Human Feedback without Reward Inference
- Qining Zhang, Lei Ying
- 키워드: Reward inference-free RLHF, Zeroth-order optimization, Policy gradient
-
Learning Reward and Policy Jointly from Demonstration and Preference Improves Alignment
- Chenliang Li, Siliang Zeng, Zeyi Liao, Jiaxiang Li, Dongyeop Kang, Alfredo Garcia, Mingyi Hong
- 키워드: Joint Reward and Policy, Efficiency, Framework
-
MA-RLHF: Reinforcement Learning from Human Feedback with Macro Actions
- Yekun Chai, Haoran Sun, Huang Fang, Shuohuan Wang, Yu Sun, Hua Wu
- 키워드: Macro action-level Reward, Efficiency, Framework
- 코드: Official
-
Reward Modeling with Ordinal Feedback: Wisdom of the Crowd
- Shang Liu, Yu Pan, Guanting Chen, and Xiaocheng Li
- 키워드: Reward Modeling, Ordinal Feedback, Human Preference Dataset
- 코드: Official
-
Aligning Few-Step Diffusion Models with Dense Reward Difference Learning
- Ziyi Zhang, Li Shen, Sen Zhang, Deheng Ye, Yong Luo, Miaojing Shi, Bo Du, Dacheng Tao
- 키워드: Diffusion Models, Text-to-Image, Alignment, Reinforcement Learning
- 코드: Official
-
HybridFlow: A Flexible and Efficient RLHF Framework
- Guangming Sheng, Chi Zhang, Zilingfeng Ye, Xibin Wu, Wang Zhang, Ru Zhang, Yanghua Peng, Haibin Lin, Chuan Wu
- 키워드: Flexible, Efficient, RLHF framework
- 코드: Official
-
ALaRM: Align Language Models via Hierarchical Rewards Modeling
- Yuhang Lai, Siyuan Wang, Shujun Liu, Xuanjing Huang, Zhongyu Wei
- 키워드: Hierarchical Reward, Open Text Generation Tasks
- 코드: Official
-
TLCR: Token-Level Continuous Reward for Fine-grained Reinforcement Learning from Human Feedback
- Eunseop Yoon, Hee Suk Yoon, SooHwan Eom, Gunsoo Han, Daniel Wontae Nam, Daejin Jo, Kyoung-Woon On, Mark A. Hasegawa-Johnson, Sungwoong Kim, Chang D. Yoo
- 키워드: Token-Level Continuous Reward, RLHF
- 코드: Official
-
Aligning Large Multimodal Models with Factually Augmented RLHF
- Zhiqing Sun, Sheng Shen, Shengcao Cao, Haotian Liu, Chunyuan Li, Yikang Shen, Chuang Gan, Liang-Yan Gui, Yu-Xiong Wang, Yiming Yang, Kurt Keutzer, Trevor Darrell
- 키워드: Factually Augmented RLHF, Vision & Language, Human Preference Dataset
- 코드: Official
-
Direct Large Language Model Alignment Through Self-Rewarding Contrastive Prompt Distillation
- Aiwei Liu, Haoping Bai, Zhiyun Lu, Xiang Kong, Simon Wang, Jiulong Shan, Meng Cao, Lijie Wen
- 키워드: Without Human Preference Data, Self-Reward, DPO
- 코드: Official
-
- Haoxiang Wang, Yong Lin, Wei Xiong, Rui Yang, Shizhe Diao, Shuang Qiu, Han Zhao, Tong Zhang
- 키워드: User Preference, Multi-objective Reward Model, Rejection Sampling Finetuning
- 코드: Official
-
Back to Basics: Revisiting REINFORCE Style Optimization for Learning from Human Feedback in LLMs
- Arash Ahmadian, Chris Cremer, Matthias Gallé, Marzieh Fadaee, Julia Kreutzer, Olivier Pietquin, Ahmet Üstün, Sara Hooker
- 키워드: Online RL Optimization, Low Computational Cost
- 코드: Official
-
- Zhipeng Chen, Kun Zhou, Wayne Xin Zhao, Junchen Wan, Fuzheng Zhang, Di Zhang, Ji-Rong Wen
- 키워드: Token-level Reward, LLM
- 코드: Official
-
RLAIF vs. RLHF: Scaling Reinforcement Learning from Human Feedback with AI Feedback
- Harrison Lee, Samrat Phatale, Hassan Mansoor, Thomas Mesnard, Johan Ferret, Kellie Ren Lu, Colton Bishop, Ethan Hall, Victor Carbune, Abhinav Rastogi, Sushant Prakash
- 키워드: RL from AI Feedback
- 코드: official
-
Principled Penalty-based Methods for Bilevel Reinforcement Learning and RLHF
- Han Shen, Zhuoran Yang, Tianyi Chen
- 키워드: Bilevel optimization
- 코드: official
-
Dense Reward for Free in Reinforcement Learning from Human Feedback
- Alex James Chan, Hao Sun, Samuel Holt, Mihaela Van Der Schaar
- 키워드: reward shaping, RLHF
- 코드: official
-
A Minimaximalist Approach to Reinforcement Learning from Human Feedback
- Gokul Swamy, Christoph Dann, Rahul Kidambi, Steven Wu, Alekh Agarwal
- 키워드: Minimax Winner, Self-Play Preference Optimization
- 코드: official
-
- Tianyu Yu, Yuan Yao, Haoye Zhang, Taiwen He, Yifeng Han, Ganqu Cui, Jinyi Hu, Zhiyuan Liu, Hai-Tao Zheng, Maosong Sun, Tat-Seng Chua
- 키워드: Multimodal Large Language Models, Hallucination Problem, Reinforcement Learning from Human Feedback
- 코드: official
-
RLHF Workflow: From Reward Modeling to Online RLHF
- Hanze Dong, Wei Xiong, Bo Pang, Haoxiang Wang, Han Zhao, Yingbo Zhou, Nan Jiang, Doyen Sahoo, Caiming Xiong, Tong Zhang
- 키워드: Online Iterative RLHF, Preference Modeling, Large Language Models
- 코드: official
-
MaxMin-RLHF: Towards equitable alignment of large language models with diverse human preferences
- Souradip Chakraborty, Jiahao Qiu, Hui Yuan, Alec Koppel, Furong Huang, Dinesh Manocha, Amrit Singh Bedi, Mengdi Wang
- 키워드: mixture of preference distributions, MaxMin alignment objective
- 코드: official
-
Dataset Reset Policy Optimization for RLHF
- Jonathan D. Chang, Wenhao Zhan, Owen Oertell, Kianté Brantley, Dipendra Misra, Jason D. Lee, Wen Sun
- 키워드: Dataset Reset Policy Optimization
- 코드: official
-
A Dense Reward View on Aligning Text-to-Image Diffusion with Preference
- Shentao Yang, Tianqi Chen, Mingyuan Zhou
- 키워드: RLHF for Text-to-Image Generation, Dense Reward Improvement of DPO, Efficient Alignment
- 코드: official
-
Self-Play Fine-Tuning Converts Weak Language Models to Strong Language Models
- Zixiang Chen, Yihe Deng, Huizhuo Yuan, Kaixuan Ji, Quanquan Gu
- 키워드: Self-Play Fine-Tuning
- 코드: official
-
RLHF Deciphered: A Critical Analysis of Reinforcement Learning from Human Feedback for LLMs
- Shreyas Chaudhari, Pranjal Aggarwal, Vishvak Murahari, Tanmay Rajpurohit, Ashwin Kalyan, Karthik Narasimhan, Ameet Deshpande, Bruno Castro da Silva
- 키워드: RLHF, Oracular Reward, Reward Model Analysis, Survey
-
- Ziyi Zhang, Sen Zhang, Yibing Zhan, Yong Luo, Yonggang Wen, Dacheng Tao
- 키워드: Diffusion Models, Alignment, Reinforcement Learning, RLHF, Reward Overoptimization, Primacy Bias
- 코드: official
-
On Diversified Preferences of Large Language Model Alignment
- Dun Zeng, Yong Dai, Pengyu Cheng, Tianhao Hu, Wanshun Chen, Nan Du, Zenglin Xu
- 키워드: Aligning shared preference, Reward modeling metrics, LLM
- 코드: official
-
Aligning Crowd Feedback via Distributional Preference Reward Modeling
- Dexun Li, Cong Zhang, Kuicai Dong, Derrick Goh Xin Deik, Ruiming Tang, Yong Liu
- 키워드: RLHF, Preference distribution, Aligning, LLM
-
Beyond One-Preference-Fits-All Alignment: Multi-Objective Direct Preference Optimization
- Zhanhui Zhou, Jie Liu, Chao Yang, Jing Shao, Yu Liu, Xiangyu Yue, Wanli Ouyang, Yu Qiao
- 키워드: Multi-objective RLHF without reward modeling, DPO
- 코드: official
-
Emulated Disalignment: Safety Alignment for Large Language Models May Backfire!
- Zhanhui Zhou, Jie Liu, Zhichen Dong, Jiaheng Liu, Chao Yang, Wanli Ouyang, Yu Qiao
- 키워드: LLM inference-time attack, DPO, Producing harmful LLMs without training
- 코드: official
-
A Theoretical Analysis of Nash Learning from Human Feedback under General KL-Regularized Preference
- Chenlu Ye, Wei Xiong, Yuheng Zhang, Nan Jiang, Tong Zhang
- 키워드: Game-based RLHF, Nash Learning, Alignment under reward-model-free oracle
-
Mitigating the Alignment Tax of RLHF
- Yong Lin, Hangyu Lin, Wei Xiong, Shizhe Diao, Jianmeng Liu, Jipeng Zhang, Rui Pan, Haoxiang Wang, Wenbin Hu, Hanning Zhang, Hanze Dong, Renjie Pi, Han Zhao, Nan Jiang, Heng Ji, Yuan Yao, Tong Zhang
- 키워드: RLHF, Alignment tax, Catastrophic forgetting
-
Training Diffusion Models with Reinforcement Learning
- Kevin Black, Michael Janner, Yilun Du, Ilya Kostrikov, Sergey Levine
- 키워드: reinforcement learning, RLHF, diffusion models
- 코드: official
-
AlignDiff: Aligning Diverse Human Preferences via Behavior-Customisable Diffusion Model
- Zibin Dong, Yifu Yuan, Jianye Hao, Fei Ni, Yao Mu, Yan Zheng,Yujing Hu, Tangjie Lv, Changjie Fan, Zhipeng Hu
- 키워드: Reinforcement learning; Diffusion models; RLHF; Preference aligning
- 코드: official
-
Dense Reward for Free in Reinforcement Learning from Human Feedback
- Alex J. Chan, Hao Sun, Samuel Holt, Mihaela van der Schaar
- 키워드: RLHF
- 코드: official
-
Transforming and Combining Rewards for Aligning Large Language Models
- Zihao Wang, Chirag Nagpal, Jonathan Berant, Jacob Eisenstein, Alex D’Amour, Sanmi Koyejo, Victor Veitch
- 키워드: RLHF, Aligning, LLM
-
Parameter Efficient Reinforcement Learning from Human Feedback
- Hakim Sidahmed, Samrat Phatale, Alex Hutcheson, Zhuonan Lin, Zhang Chen, Zac Yu, Jarvis Jin, Simral Chaudhary, Roman Komarytsia, Christiane Ahlheim, Yonghao Zhu, Bowen Li, Saravanan Ganesh, Bill Byrne, Jessica Hoffmann, Hassan Mansoor, Wei Li, Abhinav Rastogi, Lucas Dixon
- 키워드: RLHF, Parameter Efficient method, Low Computational Cost, LLM, VLM
-
Improving Reinforcement Learning from Human Feedback with Efficient Reward Model Ensemble
- Shun Zhang, Zhenfang Chen, Sunli Chen, Yikang Shen, Zhiqing Sun, Chuang Gan
- 키워드: RLHF, Reward Ensemble, Efficient Ensemble Method
-
RIME: Robust Preference-based Reinforcement Learning with Noisy Human Preferences
- Jie Cheng, Gang Xiong, Xingyuan Dai, Qinghai Miao, Yisheng Lv, Fei-Yue Wang
- 키워드:
- 코드: official
2023
섹션 제목: “2023”-
The Trickle-down Impact of Reward (In-)consistency on RLHF
- Lingfeng Shen, Sihao Chen, Linfeng Song, Lifeng Jin, Baolin Peng, Haitao Mi, Daniel Khashabi, Dong Yu
- 키워드: Reward model, RLHF, Reward hacking
- 코드: official
-
A General Theoretical Paradigm to Understand Learning from Human Preferences
- Mohammad Gheshlaghi Azar, Mark Rowland, Bilal Piot, Daniel Guo, Daniele Calandriello, Michal Valko, Rémi Munos
- 키워드: RLHF, Pairwise Preference
-
Fine-Grained Human Feedback Gives Better Rewards for Language Model Training
- Zeqiu Wu, Yushi Hu, Weijia Shi, Nouha Dziri, Alane Suhr, Prithviraj Ammanabrolu, Noah A. Smith, Mari Ostendorf, Hannaneh Hajishirzi
- 키워드: RLHF, Sentence-level Reward, LLM
- 코드: official
-
Preference-grounded Token-level Guidance for Language Model Fine-tuning
- Shentao Yang, Shujian Zhang, Congying Xia, Yihao Feng, Caiming Xiong, Mingyuan Zhou
- 키워드: RLHF, Token-level Training Guidance, Alternate/Online Training Framework, Minimalist Training Objectives
- 코드: official
-
- Yihao Feng*, Shentao Yang*, Shujian Zhang, Jianguo Zhang, Caiming Xiong, Mingyuan Zhou, Huan Wang
- 키워드: RLHF, Genralized Reward Function Learning, Reward Function Utilization, Task-oriented Dialogue System, Learning-to-rank
- 코드: official
-
Inverse Preference Learning: Preference-based RL without a Reward Function
- Joey Hejna, Dorsa Sadigh
- 키워드: Inverse Preference Learning, without reward model
- 코드: official
-
AlpacaFarm: A Simulation Framework for Methods that Learn from Human Feedback
- Yann Dubois, Chen Xuechen Li, Rohan Taori, Tianyi Zhang, Ishaan Gulrajani, Jimmy Ba, Carlos Guestrin, Percy S. Liang, Tatsunori B. Hashimoto
- 키워드: RLHF, Simulation Framework
- 코드: official
-
Adversarial Preference Optimization
- Pengyu Cheng, Yifan Yang, Jian Li, Yong Dai, Nan Du
- 키워드: RLHF, GAN, Adversarial Games
- 코드: official
-
- Wei Xiong, Hanze Dong, Chenlu Ye, Ziqi Wang, Han Zhong, Heng Ji, Nan Jiang, Tong Zhang
- 키워드: RLHF, Iterative DPO, Mathematical foundation
-
Sample Efficient Reinforcement Learning from Human Feedback via Active Exploration
- Viraj Mehta, Vikramjeet Das, Ojash Neopane, Yijia Dai, Ilija Bogunovic, Jeff Schneider, Willie Neiswanger
- 키워드: RLHF, sample efficience, exploration
-
Reinforcement Learning from Statistical Feedback: the Journey from AB Testing to ANT Testing
- Feiyang Han, Yimin Wei, Zhaofeng Liu, Yanxing Qi
- 키워드: RLHF, AB testing, RLSF
-
- Ben Pikus, Will LeVine, Tony Chen, Sean Hendryx
- 키워드: RLHF, OOD, Distribution Shift
-
Data-Efficient Alignment of Large Language Models with Human Feedback Through Natural Language
- Di Jin, Shikib Mehri, Devamanyu Hazarika, Aishwarya Padmakumar, Sungjin Lee, Yang Liu, Mahdi Namazifar
- 키워드: RLHF, data-efficient, Alignment
-
- Sarah Pan, Vladislav Lialin, Sherin Muckatira, Anna Rumshisky
- 키워드: RLHF, reasoning
-
Direct Preference-based Policy Optimization without Reward Modeling
- Gaon An, Junhyeok Lee, Xingdong Zuo, Norio Kosaka, Kyung-Min Kim, Hyun Oh Song
- 키워드: RLHF without reward modeling, Contrastive learning, Offline refinforcement learning
-
AlignDiff: Aligning Diverse Human Preferences via Behavior-Customisable Diffusion Model
- Zibin Dong, Yifu Yuan, Jianye Hao, Fei Ni, Yao Mu, Yan Zheng, Yujing Hu, Tangjie Lv, Changjie Fan, Zhipeng Hu
- 키워드: RLHF, Alignment, Diffusion model
-
Eureka: Human-Level Reward Design via Coding Large Language Models
- Yecheng Jason Ma, William Liang, Guanzhi Wang, De-An Huang, Osbert Bastani, Dinesh Jayaraman, Yuke Zhu, Linxi Fan, Anima Anandkumar
- 키워드: LLM based, reward functions design
-
Safe RLHF: Safe Reinforcement Learning from Human Feedback
- Josef Dai, Xuehai Pan, Ruiyang Sun, Jiaming Ji, Xinbo Xu, Mickel Liu, Yizhou Wang, Yaodong Yang
- 키워드: Sale RL, LLM fine-ture
-
Quality Diversity through Human Feedback
- Li Ding, Jenny Zhang, Jeff Clune, Lee Spector, Joel Lehman
- 키워드: Quality Diversity, Diffusion model
-
- Ziniu Li, Tian Xu, Yushun Zhang, Yang Yu, Ruoyu Sun, Zhi-Quan Luo
- 키워드: computational efficiency, variance-reduction technique
-
Tuning computer vision models with task rewards
- André Susano Pinto, Alexander Kolesnikov, Yuge Shi, Lucas Beyer, Xiaohua Zhai
- 키워드: Reward tuning in Computer Vision
-
The Wisdom of Hindsight Makes Language Models Better Instruction Followers
- Tianjun Zhang, Fangchen Liu, Justin Wong, Pieter Abbeel, Joseph E. Gonzalez
- 키워드: Hindsight Instruction Relabeling, RLHF System, No Value Network Required
- 코드: official
-
Language Instructed Reinforcement Learning for Human-AI Coordination
- Hengyuan Hu, Dorsa Sadigh
- 키워드: Human-AI coordination, Human preference alignment, Instruction conditioned RL
-
Aligning Language Models with Offline Reinforcement Learning from Human Feedback
- Jian Hu, Li Tao, June Yang, Chandler Zhou
- 키워드: Decision Transformer-based Alignment, Offline Reinforcement Learning, RLHF System
-
Preference Ranking Optimization for Human Alignment
- Feifan Song, Bowen Yu, Minghao Li, Haiyang Yu, Fei Huang, Yongbin Li and Houfeng Wang
- 키워드: Supervised Human Preference Alignment, Preference Ranking Extension
- 코드: official
-
Bridging the Gap: A Survey on Integrating (Human) Feedback for Natural Language Generation
- Patrick Fernandes, Aman Madaan, Emmy Liu, António Farinhas, Pedro Henrique Martins, Amanda Bertsch, José G. C. de Souza, Shuyan Zhou, Tongshuang Wu, Graham Neubig, André F. T. Martins
- 키워드: Natural Language Generation, Human Feedback Integration, Feedback Formalization and Taxonomy, AI Feedback and Principles-Based Judgments
-
- OpenAI
- 키워드: A large-scale, multimodal model, Transformerbased model, Fine-tuned used RLHF
- 코드: official
- 데이터셋: DROP, WinoGrande, HellaSwag, ARC, HumanEval, GSM8K, MMLU, TruthfulQA
-
RAFT: Reward rAnked FineTuning for Generative Foundation Model Alignment
- Hanze Dong, Wei Xiong, Deepanshu Goyal, Rui Pan, Shizhe Diao, Jipeng Zhang, Kashun Shum, Tong Zhang
- 키워드: Rejection Sampling Finetuning, Alternative to PPO, Diffusion Model
- 코드: official
-
RRHF: Rank Responses to Align Language Models with Human Feedback without tears
- Zheng Yuan, Hongyi Yuan, Chuanqi Tan, Wei Wang, Songfang Huang, Fei Huang
- 키워드: New paradigm for RLHF
- 코드: official
-
Few-shot Preference Learning for Human-in-the-Loop RL
- Joey Hejna, Dorsa Sadigh
- 키워드: Preference Learning, Interactive Learning, Multi-task Learning, Expanding the pool of available data by viewing human-in-the-loop RL
- 코드: official
-
Better Aligning Text-to-Image Models with Human Preference
- Xiaoshi Wu, Keqiang Sun, Feng Zhu, Rui Zhao, Hongsheng Li
- 키워드: Diffusion Model, Text-to-Image, Aesthetic
- 코드: official
-
ImageReward: Learning and Evaluating Human Preferences for Text-to-Image Generation
- Jiazheng Xu, Xiao Liu, Yuchen Wu, Yuxuan Tong, Qinkai Li, Ming Ding, Jie Tang, Yuxiao Dong
- 키워드: General-purpose text-to-Image human preference RM, Evaluating Text-to-Image Generative Models
- 코드: official
- 데이터셋: COCO, DiffusionDB
-
Aligning Text-to-Image Models using Human Feedback
- Kimin Lee, Hao liu, MoonKyung Ryu, Olivia Watkins, Yuqing Du, Craig Boutilier, Pieter Abbeel, Mohammad Ghavamzadeh, Shixiang Shane Gu
- 키워드: Text-to-Image, Stable diffusion model, Reward function that predicts human feedback
-
Visual ChatGPT: Talking, Drawing and Editing with Visual Foundation Models
- Chenfei Wu, Shengming Yin, Weizhen Qi, Xiaodong Wang, Zecheng Tang, Nan Duan
- 키워드: Visual Foundation Models, Visual ChatGPT
- 코드: official
-
Pretraining Language Models with Human Preferences (PHF)
- Tomasz Korbak, Kejian Shi, Angelica Chen, Rasika Bhalerao, Christopher L. Buckley, Jason Phang, Samuel R. Bowman, Ethan Perez
- 키워드: Pretraining, offline RL, Decision transformer
- 코드: official
-
Aligning Language Models with Preferences through f-divergence Minimization (f-DPG)
- Dongyoung Go, Tomasz Korbak, Germán Kruszewski, Jos Rozen, Nahyeon Ryu, Marc Dymetman
- 키워드: f-divergence, RL with KL penalties
-
Principled Reinforcement Learning with Human Feedback from Pairwise or K-wise Comparisons
- Banghua Zhu, Jiantao Jiao, Michael I. Jordan
- 키워드: Pessimistic MLE, Max-entropy IRL
-
The Capacity for Moral Self-Correction in Large Language Models
- Anthropic
- 키워드: Improve moral self-correction capability by increasing RLHF training
- Dataset; BBQ
2022
섹션 제목: “2022”- Is Reinforcement Learning (Not) for Natural Language Processing?: Benchmarks, Baselines, and Building Blocks for Natural Language Policy Optimization (NLPO)
- Rajkumar Ramamurthy, Prithviraj Ammanabrolu, Kianté,Brantley, Jack Hessel, Rafet Sifa, Christian Bauckhage, Hannaneh Hajishirzi, Yejin Choi
- 키워드: Optimizing language generators with RL, Benchmark, Performant RL algorithm
- 코드: official
- 데이터셋: IMDB, CommonGen, CNN Daily Mail, ToTTo, WMT-16 (en-de),NarrativeQA, DailyDialog
- Scaling Laws for Reward Model Overoptimization
- Leo Gao, John Schulman, Jacob Hilton
- 키워드: Gold reward model train proxy reward model, Dataset size, Policy parameter size, BoN, PPO
- Improving alignment of dialogue agents via targeted human judgements (Sparrow)
- Amelia Glaese, Nat McAleese, Maja Trębacz, et al.
- 키워드: Information-seeking dialogue agent, Break down the good dialogue into natural language rules, DPC, Interact with the model to elicit violation of a specific rule (Adversarial Probing)
- 데이터셋: Natural Questions, ELI5, QuALITY, TriviaQA, WinoBias, BBQ
- Red Teaming Language Models to Reduce Harms: Methods, Scaling Behaviors, and Lessons Learned
- Deep Ganguli, Liane Lovitt, Jackson Kernion, et al.
- 키워드: Red team language model, Investigate scaling behaviors, Read teaming Dataset
- 코드: official
- Dynamic Planning in Open-Ended Dialogue using Reinforcement Learning
- Deborah Cohen, Moonkyung Ryu, Yinlam Chow, Orgad Keller, Ido Greenberg, Avinatan Hassidim, Michael Fink, Yossi Matias, Idan Szpektor, Craig Boutilier, Gal Elidan
- 키워드: Real-time, Open-ended dialogue system, Pairs the succinct embedding of the conversation state by language models, CAQL, CQL, BERT
- Quark: Controllable Text Generation with Reinforced Unlearning
- Ximing Lu, Sean Welleck, Jack Hessel, Liwei Jiang, Lianhui Qin, Peter West, Prithviraj Ammanabrolu, Yejin Choi
- 키워드: Fine-tuning the language model on signals of what not to do, Decision Transformer, LLM tuning with PPO
- 코드: official
- 데이터셋: WRITINGPROMPTS, SST-2, WIKITEXT-103
- Training a Helpful and Harmless Assistant with Reinforcement Learning from Human Feedback
- Yuntao Bai, Andy Jones, Kamal Ndousse, et al.
- 키워드: Harmless assistants, Online mode, Robustness of RLHF training, OOD detection.
- 코드: official
- 데이터셋: TriviaQA, HellaSwag, ARC, OpenBookQA, LAMBADA, HumanEval, MMLU, TruthfulQA
- Teaching language models to support answers with verified quotes (GopherCite)
- Jacob Menick, Maja Trebacz, Vladimir Mikulik, John Aslanides, Francis Song, Martin Chadwick, Mia Glaese, Susannah Young, Lucy Campbell-Gillingham, Geoffrey Irving, Nat McAleese
- 키워드: Generate answers which citing specific evidence, Abstain from answering when unsure
- 데이터셋: Natural Questions, ELI5, QuALITY, TruthfulQA
- Training language models to follow instructions with human feedback (InstructGPT)
- Long Ouyang, Jeff Wu, Xu Jiang, et al.
- 키워드: Large Language Model, Align Language Model with Human Intent
- 코드: official
- 데이터셋: TruthfulQA, RealToxicityPrompts
- Constitutional AI: Harmlessness from AI Feedback
- Yuntao Bai, Saurav Kadavath, Sandipan Kundu, Amanda Askell, Jackson Kernion, et al.
- 키워드: RL from AI feedback(RLAIF), Training a harmless AI assistant through selfimprovement, Chain-of-thought style, Control AI behavior more precisely
- 코드: official
- Discovering Language Model Behaviors with Model-Written Evaluations
- Ethan Perez, Sam Ringer, Kamilė Lukošiūtė, Karina Nguyen, Edwin Chen, et al.
- 키워드: Automatically generate evaluations with LMs, More RLHF makes LMs worse, LM-written evaluations are highquality
- 코드: official
- 데이터셋: BBQ, Winogender Schemas
- Non-Markovian Reward Modelling from Trajectory Labels via Interpretable Multiple Instance Learning
- Joseph Early, Tom Bewley, Christine Evers, Sarvapali Ramchurn
- 키워드: Reward Modelling (RLHF), Non-Markovian, Multiple Instance Learning, Interpretability
- 코드: official
- SURF: Semi-supervised Reward Learning with Data Augmentation for Feedback-efficient Preference-based Reinforcement Learning
- Jongjin Park, Younggyo Seo, Jinwoo Shin, Honglak Lee, Pieter Abbeel, Kimin Lee
- 키워드: Semi-supervised Reward Learning, Preference Data Augmentation, RLHF Efficiency
- Reward Uncertainty for Exploration in Preference-based Reinforcement Learning
- Xinran Liang, Katherine Shu, Kimin Lee, Pieter Abbeel
- 키워드: Preference-based RL (PbRL), Exploration, Reward Uncertainty, Feedback Efficiency
- 코드: official
2021
섹션 제목: “2021”- WebGPT: Browser-assisted question-answering with human feedback (WebGPT)
- Reiichiro Nakano, Jacob Hilton, Suchir Balaji, et al.
- 키워드: Model search the web and provide reference, Imitation learning, BC, long form question
- 데이터셋: ELI5, TriviaQA, TruthfulQA
- Recursively Summarizing Books with Human Feedback
- Jeff Wu, Long Ouyang, Daniel M. Ziegler, Nisan Stiennon, Ryan Lowe, Jan Leike, Paul Christiano
- 키워드: Model trained on small task to assist human evaluate broader task, BC
- 데이터셋: Booksum, NarrativeQA
- Revisiting the Weaknesses of Reinforcement Learning for Neural Machine Translation
- PEBBLE: Feedback-Efficient Interactive Reinforcement Learning via Relabeling Experience and Unsupervised Pre-training
- Kimin Lee, Laura Smith, Pieter Abbeel
- 키워드: Preference-based RL (PbRL), Data Efficiency, Unsupervised Pretraining, Reward Relabeling
- 코드: official
- B-Pref: Benchmarking Preference-Based Reinforcement Learning
- Kimin Lee, Laura Smith, Anca Dragan, Pieter Abbeel
- 키워드: Benchmark, Preference-based RL, Simulated Human Feedback, Robustness Evaluation
- 코드: official
2020년 전
섹션 제목: “2020년 전”- Learning to summarize from human feedback
- Fine-Tuning Language Models from Human Preferences
- Scalable agent alignment via reward modeling: a research direction
- Jan Leike, David Krueger, Tom Everitt, Miljan Martic, Vishal Maini, Shane Legg
- 키워드: Agent alignment problem, Learn reward from interaction, Optimize reward with RL, Recursive reward modeling
- 코드: official
- 환경: Atari
- Reward learning from human preferences and demonstrations in Atari
- Borja Ibarz, Jan Leike, Tobias Pohlen, Geoffrey Irving, Shane Legg, Dario Amodei
- 키워드: Expert demonstration trajectory preferences reward hacking problem, Noise in human label
- 코드: official
- 환경: Atari
- Deep TAMER: Interactive Agent Shaping in High-Dimensional State Spaces
- Garrett Warnell, Nicholas Waytowich, Vernon Lawhern, Peter Stone
- 키워드: High dimension state, Leverage the input of Human trainer
- 코드: third party
- 환경: Atari
- Deep reinforcement learning from human preferences
- Paul Christiano, Jan Leike, Tom B. Brown, Miljan Martic, Shane Legg, Dario Amodei
- 키워드: Explore goal defined in human preferences between pairs of trajectories segmentation, Learn more complex thing than human feedback
- 코드: official
- 환경: Atari, MuJoCo
- Interactive Learning from Policy-Dependent Human Feedback
- James MacGlashan, Mark K Ho, Robert Loftin, Bei Peng, Guan Wang, David Roberts, Matthew E. Taylor, Michael L. Littman
- 키워드: Decision is influenced by current policy rather than human feedback, Learn from policy dependent feedback that converges to a local optimal
코드베이스
섹션 제목: “코드베이스”format:- [title](codebase link) [links] - author1, author2, and author3... - keyword - experiment environments, datasets or tasks- Reinforcement Learning from Human Feedback (RLHF) in Notebooks
- Ashwani Kumar
- step-by-step, Video tutorial, Jupyter notebooks, GPT-2, Reward Model, PPO, Pedagogical
- 데이터셋: stanfordnlp/sst2
- 작업: 긍정적 인 감정과 텍스트 생성
- 환경: Google Colab
- veRL: Volcano Engine Reinforcement Learning for LLM
- ByteDance Seed MLSys Team & HKU: Guangming Sheng, Chi Zhang, Zilingfeng Ye, Xibin Wu, Wang Zhang, Ru Zhang, Yanghua Peng, Haibin Lin, Chuan Wu
- 키워드: Flexible, Efficient, RLHF framework
- 작업: RLHF, 수학 및 관련 업무 code.
- OpenRLHF
- OpenRLHF
- 키워드: 70B, RLHF, DeepSpeed, Ray, vLLM
- 작업: 사용하기 쉬운, 확장 가능 및 고성능 RLHF 프레임 워크 (지원 70B + 풀 튜닝 & LoRA & Mixtral & KTO).
- Potato
- David Jurgens et al.
- 키워드: Annotation, Human Evaluation, Quality Control, AI-Assisted Labeling
- 작업: 인간 평가 및 피드백 수집을위한 휴대용 표기 플랫폼 20 + 주석 유형 및 에이전트 추적 평가
- PaLM + RLHF - Pytorch
- Phil Wang, Yachine Zahidi, Ikko Eltociear Ashimine, Eric Alcaide
- 키워드: Transformers, PaLM architecture
- 데이터셋: enwik8
- lm-human-preferences
- following-instructions-human-feedback
- Long Ouyang, Jeff Wu, Xu Jiang, et al.
- 키워드: Large Language Model, Align Language Model with Human Intent
- 데이터셋: TruthfulQA RealToxicityPrompts
- Transformer Reinforcement Learning (TRL)
- Leandro von Werra, Younes Belkada, Lewis Tunstall, et al.
- 키워드: Train LLM with RL, PPO, Transformer
- 작업: IMDB sentiment
- Transformer Reinforcement Learning X (TRLX)
- Jonathan Tow, Leandro von Werra, et al.
- 키워드: Distributed training framework, T5-based language models, Train LLM with RL, PPO, ILQL
- 작업: 연락처 LLM 제공된 보상 기능 또는 보상 라벨 데이터 세트를 사용하여 RL
- RL4LMs (A modular RL library to fine-tune language models to human preferences)
- Rajkumar Ramamurthy, Prithviraj Ammanabrolu, Kianté,Brantley, Jack Hessel, Rafet Sifa, Christian Bauckhage, Hannaneh Hajishirzi, Yejin Choi
- 키워드: Optimizing language generators with RL, Benchmark, Performant RL algorithm
- 데이터셋: IMDB, CommonGen, CNN Daily Mail, ToTTo, WMT-16 (en-de), NarrativeQA, DailyDialog
- LaMDA-rlhf-pytorch
- Phil Wang
- 키워드: LaMDA, Attention-mechanism
- 작업: PyTorch에서 Google의 LaMDA 연구 논문의 오픈 소스 사전 훈련 실시
- TextRL
- Eric Lam
- 키워드: huggingface’s transformer
- 작업: 텍스트 생성
- 환경: PFRL, gym
- minRLHF
- Thomfoster
- 키워드: PPO, Minimal library
- 작업: 교육 목적
- DeepSpeed-Chat
- Microsoft
- 키워드: Affordable RLHF Training
- Dromedary
- IBM
- 키워드: Minimal human supervision, Self-aligned
- 작업: 소형 인간적인 감독으로 훈련된 각자 맞추는 언어 모형
- FG-RLHF
- Zeqiu Wu, Yushi Hu, Weijia Shi, et al.
- 키워드: Fine-Grained RLHF, providing a reward after every segment, Incorporating multiple RMs associated with different feedback types
- 작업: 밀도와 여러 RMs에서 잘 grained 보상 기능에서 훈련 및 학습을 가능하게하는 프레임 워크 -Safe-RLHF
- Xuehai Pan, Ruiyang Sun, Jiaming Ji, et al.
- 키워드: Support popular pre-trained models, Large human-labeled dataset, Multi-scale metrics for safety constraints verification, Customized parameters
- 작업: 변형 된 가치 - 정렬 LLM Safe를 통해 RLHF
- VinePPO
- Amirhossein Kazemnejad, Milad Aghajohari, et al.
- 키워드: Performant Implementation of RL algorithms for Reasoning, PPO, DPO, RestEM, Monte Carlo Value Estimation
- 작업: MATH 및 GSM8K를 포함한 재조합 작업
데이터셋
섹션 제목: “데이터셋”format:- [title](dataset link) [links] - author1, author2, and author3... - keyword - experiment environments or tasks- HH-RLHF
- Ben Mann, Deep Ganguli
- 키워드: Human preference dataset, Red teaming data, machine-written
- 작업: 인간적인 선호 데이터에 대한 오픈 소스 데이터셋
- Stanford Human Preferences Dataset(SHP)
- Ethayarajh, Kawin and Zhang, Heidi and Wang, Yizhong and Jurafsky, Dan
- 키워드: Naturally occurring and human-written dataset,18 different subject areas
- 작업: 훈련을 위해 사용될 예정 RLHF 보상 모델
- PromptSource
- Stephen H. Bach, Victor Sanh, Zheng-Xin Yong et al.
- 키워드: Prompted English datasets, Mapping a data example into natural language
- 작업: Toolkit for making, Sharing and using natural language prompts – 품질 협력 업체 중국에서
- Structured Knowledge Grounding(SKG) Resources Collections
- Tianbao Xie, Chen Henry Wu, Peng Shi et al.
- 키워드: Structured Knowledge Grounding
- 작업: Datasets 컬렉션은 구조화된 지식 접지와 관련이 있습니다.
- The Flan Collection
- Longpre Shayne, Hou Le, Vu Tu et al.
- 작업: 컬렉션은 Flan 2021, P3, Super-Natural Instructions의 데이터 세트를 컴파일
- rlhf-reward-datasets
- Yiting Xie
- 키워드: Machine-written dataset
- webgpt_comparisons
- OpenAI
- 키워드: Human-written dataset, Long form question answering
- 작업: 인간의 선호도와 일치하기 위해 긴 양식 질문에 답하는 모델
- summarize_from_feedback
- OpenAI
- 키워드: Human-written dataset, summarization
- 작업: 인간의 선호도와 일치하기 위해 summarization 모델을 훈련
- Dahoas/synthetic-instruct-gptj-pairwise
- Dahoas
- 키워드: Human-written dataset, synthetic dataset
- Stable Alignment - Alignment Learning in Social Games
- Ruibo Liu, Ruixin (Ray) Yang, Qiang Peng
- 키워드: Interaction data used for alignment training, Run in Sandbox
- 작업: 기록 된 상호 작용 데이터를 시뮬레이션 된 소셜 게임에서 기차
- LIMA
- Meta AI
- 키워드: without any RLHF, few carefully curated prompts and responses
- 작업: LIMA 모형 훈련을 위해 사용되는 Dataset
블로그
섹션 제목: “블로그”- [OpenAI] ChatGPT: Optimizing Language Models for Dialogue
- [Hugging Face] Illustrating Reinforcement Learning from Human Feedback (RLHF)
- [ZhiHu] 通向AGI之路:大型语言模型 (LLM) 技术精要
- [ZhiHu] 大语言模型的涌现能力:现象与解释
- [ZhiHu] 中文hh-rlhf数据集上的ppo实践
- [W&B Fully Connected] Understanding Reinforcement Learning from Human Feedback (RLHF)
- [Deepmind] Learning through human feedback
- [Notion] 深入理解语言模型的突现能力
- [Notion] 拆解追溯 GPT-3.5 各项能力的起源
- [gist] Reinforcement Learning for Language Models
- [YouTube] John Schulman - Reinforcement Learning from Human Feedback: Progress and Challenges
- [OpenAI / Arize] OpenAI on Reinforcement Learning With Human Feedback
- [Encord] Guide to Reinforcement Learning from Human Feedback (RLHF) for Computer Vision
- [hijkzzz] A Survey of Reinforcement Learning from Human Feedback (RLHF)
- [Weixun Wang] Overview of RL(HF)+LLM
- [Lilian Weng] Reward Hacking in Reinforcement Learning
한국어
섹션 제목: “한국어”- Reinforcement Learning from Human Feedback by Nathan Lambert
- Reinforcement Learning for Business
- The RLHF Book
다른 언어 지원
섹션 제목: “다른 언어 지원”관련 기사
섹션 제목: “관련 기사”우리의 목적은 더 나은 이 repo를 만들기 위한 것입니다. 기여에 관심이 있다면, HERE 관련 기사
이름 *
섹션 제목: “이름 *”뚱 베어 RLHF Apache 2.0 라이선스에 따라 배포됩니다.
HagiCode
HagiCode는 에이전트 코딩 작업 공간입니다. 풍부하고 편리한 UI 상호작용으로 계획 수립, 에이전트 실행, 프로젝트 작업을 쉽게 시작하고 따라가며 개발을 더 흥미로운 경험으로 만듭니다.
풍부하고 편리한 UI 상호작용으로 계획부터 프로젝트 작업까지 쉽게 따라갈 수 있습니다.

- 스마트OpenSpec 워크플로는 의도를 제안, 설계, 작업을 거쳐 배포까지 이어지는 실행 가능한 경로로 바꿉니다.
- 효율적다중 에이전트 실행으로 조사, 구현, 검토를 병렬로 진행하며 여러 저장소와 익숙한 Agent CLI를 지원합니다.
- 흥미로운풍부하고 편리한 UI 상호작용으로 계획 수립, 에이전트 실행, 프로젝트 작업을 쉽게 시작하고 따라갈 수 있습니다.
Windows용 다운로드
HagiCode 공유


아이디어를 실제로 배포되는 소프트웨어로.
HagiCode는 에이전트 코딩 작업 공간입니다. OpenSpec 워크플로로 변경을 계획하고, 다중 에이전트 실행으로 진행하며, Hero Scenario로 긴 작업의 진행 상황을 한눈에 보여 아이디어를 실제로 배포되는 소프트웨어로 만듭니다.
- 스마트
- OpenSpec 워크플로는 의도를 제안부터 배포까지 이어지는 실행 가능한 경로로 바꿉니다.
- 효율적
- 다중 에이전트 실행으로 조사, 구현, 검토를 병렬로 진행합니다.
- 즐거운
- 편리한 UI 상호작용으로 계획, 에이전트 실행, 프로젝트 작업을 쉽게 따라갈 수 있습니다.
© 2026 HagiCode | Powered By hagilight-starlight@0.21.0 | Branch: main | Commit: 745b50b | Built: