
Production Machine Learning
Source: https://github.com/EthicalML/awesome-production-machine-learning at
4efc0a16249c
License: MIT
Read the English original
This edition is an AI-assisted translation.


Awesome Production Machine Learning
섹션 제목: “Awesome Production Machine Learning”이 저장소에는 운영 환경의 머신러닝을 배포·모니터링·버전 관리·확장·보호하는 데 도움이 되는 훌륭한 오픈 소스 라이브러리를 엄선해 정리했습니다 🚀
이 GitHub 저장소를 지켜보면 매달 새로 추가되는 운영 ML 라이브러리 요약을 릴리스에서 확인할 수 있습니다 🤩
또한 도구 체인을 빠르게 탐색할 수 있도록 돕는 검색 툴킷을 제공합니다.
Quick links to sections on this page
섹션 제목: “Quick links to sections on this page”Contributing to the list
섹션 제목: “Contributing to the list”목록을 깔끔하고 최신 상태로 유지할 수 있도록 PR을 제출하기 전에 CONTRIBUTING.md의 요구 사항을 확인해 주세요. 꾸준한 성장에 힘을 보태 주시는 커뮤니티에 감사드립니다 🚀
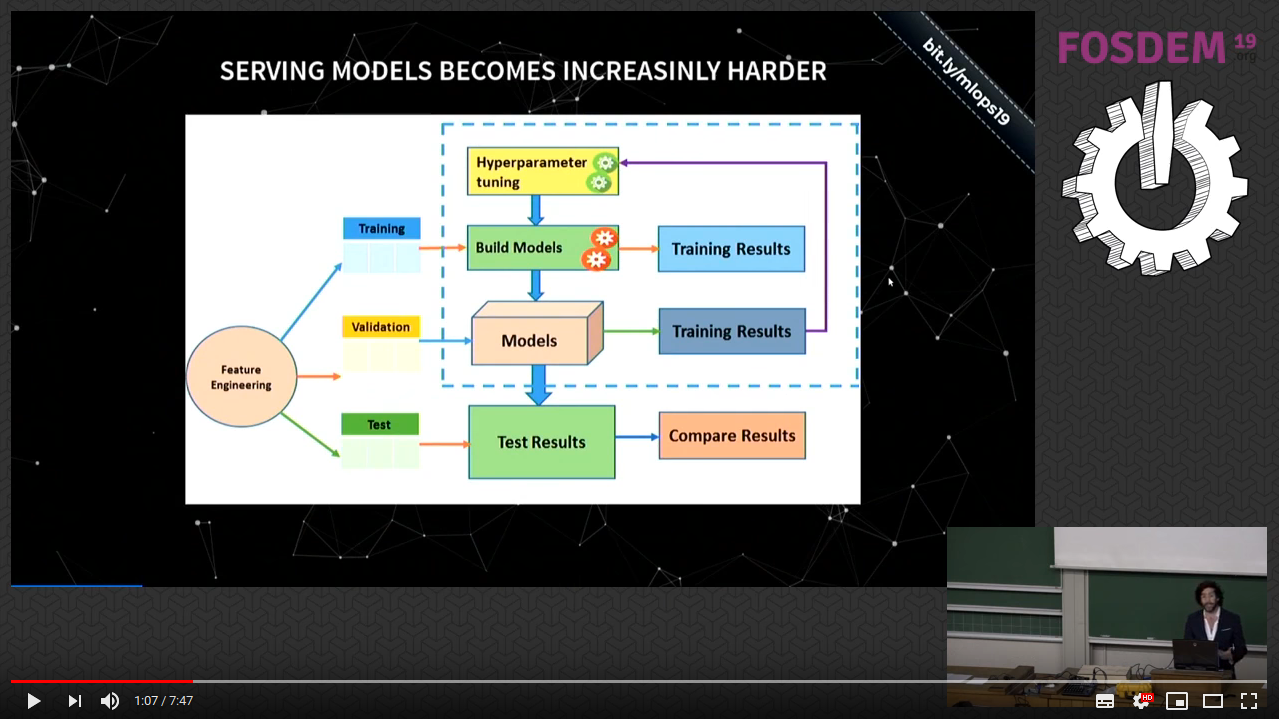
10 Min Video Overview
섹션 제목: “10 Min Video Overview”| 이 10분 동영상은 머신러닝 운영의 동기와 이 저장소에 있는 일부 도구를 개괄적으로 소개합니다. 이 최신 동영상은 2024년 MLOps 현황을 업데이트해 다룹니다. |
|
Want to receive recurrent updates on this repo and other advancements?
섹션 제목: “Want to receive recurrent updates on this repo and other advancements?”| Machine Learning Engineer 뉴스레터에 가입할 수 있습니다. 운영 머신러닝에 관한 엄선된 기사와 튜토리얼을 매주 받아보는 70,000명 이상의 ML 전문가 및 애호가와 함께하세요. |
|
| 생성형 인공지능 애플리케이션과 시스템을 배포·모니터링·버전 관리·확장하는 데 유용한 오픈 소스 라이브러리를 엄선해 정리하는 Awesome Production GenAI 목록도 확인해 보세요. |
|
Main Content
섹션 제목: “Main Content”AutoML
섹션 제목: “AutoML”- AIDE
 - AIDE는 트리 탐색 알고리즘을 사용해 머신러닝 작업의 해결 전략을 자율적으로 탐색하고 구현 및 평가하는 오픈 소스 ML 엔지니어링 에이전트입니다.
- AutoGluon
 - 인기 머신러닝 라이브러리(Scikit-Learn, LightGBM, CatBoost, PyTorch, MXNet)를 기반으로 표 형식, 이미지 및 텍스트 데이터의 특성·모델·하이퍼파라미터를 자동으로 선택합니다.
- Autokeras
 - “Auto-Keras: Efficient Neural Architecture Search with Network Morphism” 논문을 기반으로 한 Keras용 AutoML 라이브러리입니다. “Auto-Keras: Efficient Neural Architecture Search with Network Morphism”
- auto-sklearn
 - sklearn의 알고리즘과 하이퍼파라미터 튜닝을 자동화하는 프레임워크입니다.
- Ax
 - 적응형 실험을 이해하고 관리하며 배포하고 자동화하기 위한 접근성 높은 범용 플랫폼입니다.
- BoTorch
 - PyTorch 기반 베이지안 최적화 라이브러리입니다.
- EvalML
 - 도메인별 목적 함수를 사용해 머신러닝 파이프라인을 구축하고 최적화하며 평가하는 AutoML 라이브러리입니다.
- Feature Engine
 - 머신러닝 모델에 사용할 특성을 만들기 위한 여러 변환기를 제공하는 Python 라이브러리입니다.
- Featuretools
 - 자동 특성 엔지니어링을 위한 오픈 소스 프레임워크입니다.
- FLAML
 - 자동 머신러닝 및 튜닝을 위한 빠른 라이브러리입니다.
- HEBO
 - 하이퍼파라미터 튜닝 작업으로 검증된 NeurIPS 2020 Black-Box Optimisation Challenge 우승 제출작을 포함한 오픈 소스 하이퍼파라미터 최적화 프레임워크 모음입니다.
- Katib
 - 하이퍼파라미터 튜닝과 신경망 아키텍처 탐색을 위한 Kubernetes 기반 시스템입니다.
- keras-tuner
 - 사용하기 쉽고 분산 가능한 하이퍼파라미터 최적화 프레임워크로, 하이퍼파라미터 탐색의 어려움을 해결합니다. 검색 공간을 쉽게 정의하고 내장 알고리즘을 활용해 최적의 하이퍼파라미터 값을 찾을 수 있습니다.
- Optuna
 - 머신러닝을 위해 특별히 설계된 자동 하이퍼파라미터 최적화 소프트웨어 프레임워크입니다.
- OSS Vizier
 - 대규모로 작동하도록 설계된 최초의 하이퍼파라미터 튜닝 서비스 중 하나인, 블랙박스 최적화와 연구를 위한 Python 기반 서비스입니다.
- Perpetual
 - 모델 복잡도를 제어하는 간단한 예산 매개변수를 갖추어 하이퍼파라미터 최적화가 필요 없는 그래디언트 부스팅 머신입니다.
- TPOT
 - 특성 선택, 전처리기 등을 포함해 sklearn 파이프라인 생성을 자동화합니다.
- tsfresh
 - 시계열에서 관련 특성을 자동으로 추출합니다.
Computation and Communication Optimisation
섹션 제목: “Computation and Communication Optimisation”- Accelerate
 - Accelerate는 멀티 GPU/TPU 및 혼합 정밀도와 관련된 상용구 코드만 추상화하고 나머지 코드는 변경하지 않습니다.
- Adapters
 - 매개변수 효율적인 모듈형 전이 학습을 위한 통합 라이브러리입니다.
- Cache-DiT
 - Diffusers를 기반으로 거의 모든 DiT를 지원합니다. DBCache, TaylorSeer, SCM 등의 하이브리드 캐시 가속과 컨텍스트·텐서·하이브리드 2D/3D 병렬 처리를 포함한 포괄적인 병렬화 최적화를 제공하며 컴파일, CPU 오프로딩, 양자화와 호환됩니다.
- Colossal-AI
 - 대형 모델 시대에 사용자가 대규모 AI 모델의 학습과 추론을 효율적이고 빠르게 배포하도록 돕는 통합 딥러닝 시스템입니다.
- Composer
 - 신경망을 더 빠르고 저렴하게, 더 높은 정확도로 학습할 수 있게 해 주는 PyTorch 라이브러리입니다.
- CuDF
 - Apache Arrow 컬럼형 메모리 형식을 기반으로 하며, 데이터를 불러오고 결합·집계·필터링하는 등 조작하기 위한 GPU DataFrame 라이브러리입니다.
- CuML
 - 다른 RAPIDS 프로젝트와 호환되는 API를 공유하는 머신러닝 알고리즘 및 수학 기본 연산 라이브러리 모음입니다.
- CuPy
 - CUDA에서 NumPy 호환 다차원 배열을 구현한 라이브러리입니다. 핵심 다차원 배열 클래스 cupy.ndarray와 이를 위한 다양한 함수로 구성됩니다.
- DEAP
 - 아이디어를 신속하게 프로토타이핑하고 테스트하기 위한 새로운 진화 연산 프레임워크입니다. 알고리즘을 명시적으로, 데이터 구조를 투명하게 만드는 것을 목표로 합니다. multiprocessing 및 SCOOP과 같은 병렬화 메커니즘과도 완벽하게 연동됩니다.
- DeepEP
 - Mixture-of-Experts(MoE)와 전문가 병렬 처리(EP)에 특화된 통신 라이브러리입니다. MoE 디스패치 및 결합이라고도 하는 높은 처리량과 낮은 지연 시간의 all-to-all GPU 커널을 제공합니다. FP8을 비롯한 저정밀 연산도 지원합니다.
- DGL
 - 그래프 딥러닝을 위한 사용하기 쉽고 성능이 뛰어나며 확장 가능한 Python 패키지입니다.
- DLRover
 - 대형 AI 모델의 분산 학습을 쉽고 안정적이며 빠르고 친환경적으로 만듭니다.
- Dask
 - Pandas 및 NumPy 연산을 위한 분산 병렬 처리 프레임워크입니다.
- DeepSpeed
 - 분산 학습과 추론을 쉽고 효율적이며 효과적으로 만드는 딥러닝 최적화 라이브러리입니다.
- FlagGems
 - OpenAI Triton으로 구현한 고성능 범용 연산자 라이브러리입니다. 다양한 하드웨어 플랫폼에서 LLM 학습과 추론을 가속하도록 설계된 백엔드 중립 커널 모음을 기반으로 합니다.
- Flashlight
 - Facebook AI Research와 Torch, TensorFlow, Eigen, Deep Speech의 제작자들이 만든, 전적으로 C++로 작성된 빠르고 유연한 머신러닝 라이브러리입니다.
- Flax
 - 유연성을 위해 설계된 JAX용 신경망 라이브러리 및 생태계입니다.
- GPUStack
 - AI 모델 실행을 위한 오픈 소스 GPU 클러스터 관리자입니다.
- Hivemind
 - PyTorch를 사용한 분산 딥러닝입니다.
- Jax
 - Python+NumPy 프로그램에 조합 가능한 변환을 제공합니다. 미분, 벡터화, GPU/TPU JIT 컴파일 등을 지원합니다.
- Kompute
 - 고급 GPU 데이터 처리 사용 사례에 최적화된 초고속·경량의 모바일 지원 Vulkan 컴퓨팅 프레임워크입니다.
- Liger Kernel
 - LLM 학습을 위해 특별히 설계된 Triton 커널 모음입니다.
- LightGBM
 - 트리 기반 학습 알고리즘을 사용하는 그래디언트 부스팅 프레임워크입니다.
- MLX
 - Apple 실리콘에서 머신러닝을 위한 배열 프레임워크입니다.
- Modin
 - 코드 한 줄만 바꿔 Pandas 워크플로의 속도를 높입니다.
- NVIDIA TensorRT
 - NVIDIA GPU 및 딥러닝 가속기에서 고성능 추론을 위한 C++ 라이브러리입니다.
- Nevergrad
 - 그래디언트가 필요 없는 최적화 플랫폼입니다.
- Norse
 - Norse는 인공 신경망과 근본적으로 다른 희소하고 이벤트 기반인 생체 모방 신경 구성 요소의 장점을 활용하는 것을 목표로 합니다.
- Numba
 Python 배열 및 수치 함수를 위한 컴파일러입니다.
- Optimum
 - Transformers와 Diffusers를 확장해 사용하기 쉬운 상태를 유지하면서 대상 하드웨어에서 모델을 최대한 효율적으로 학습하고 실행하도록 돕는 최적화 도구 모음을 제공합니다.
- PEFT
 - 매개변수 효율적 미세 조정(PEFT) 방법을 사용하면 사전 학습 언어 모델(PLM)의 모든 매개변수를 미세 조정하지 않고도 다양한 다운스트림 응용 분야에 효율적으로 적용할 수 있습니다.
- PaddlePaddle
 - 수백 개 노드에 분산된 데이터 소스를 사용해 대규모 심층 신경망 학습을 수행하는 프레임워크입니다.
- PyG
 - PyTorch 기반 라이브러리로, 구조화된 데이터와 관련된 다양한 응용 분야에서 그래프 신경망(GNN)을 쉽게 작성하고 학습할 수 있습니다.
- PyTorch Lightning
 - 코드를 전혀 변경하지 않고 여러 GPU와 TPU에서 AI 모델을 사전 학습·미세 조정·배포합니다.
- PyTorch
 - 신경망 기반 딥러닝 모델을 개발하고 학습하기 위한 라이브러리입니다.
- Ray
 - 머신러닝을 위한 유연하고 고성능인 분산 실행 프레임워크입니다.
- SetFit
 - Sentence Transformers의 소량 학습(few-shot) 미세 조정을 위한 효율적이고 프롬프트가 필요 없는 프레임워크입니다.
- Sonnet
 - 머신러닝 연구를 위한 간단하고 조합 가능한 추상화를 제공하도록 설계된 TensorFlow 2 기반 라이브러리입니다.
- Streaming
 - 효율적인 신경망 학습을 위한 데이터 스트리밍 라이브러리입니다.
- TensorFlow
 - 최첨단 머신러닝 애플리케이션을 개발하고 배포하도록 설계된 선도적인 라이브러리입니다.
- ThunderKittens
 CUDA에서 빠른 딥러닝 커널을 쉽게 작성할 수 있게 해 주는 프레임워크입니다.
- TorchOpt
 - PyTorch 기반의 미분 가능한 최적화를 위한 효율적인 라이브러리입니다.
- Triton
 - 고효율 맞춤형 딥러닝 기본 연산을 작성하기 위한 언어 및 컴파일러입니다. CUDA보다 높은 생산성으로 빠른 코드를 작성하면서도 기존 DSL보다 유연한 오픈 소스 환경을 제공하는 것이 목표입니다.
- Vaex
 지연 평가 방식의 아웃오브코어 DataFrame(Pandas와 유사)을 처리하고, 메모리 매핑·메모리 복사 없는 정책·지연 계산으로 메모리 낭비 없이 대규모 표 형식 데이터셋을 시각화하고 탐색하는 고성능 Python 라이브러리입니다.
- Vowpal Wabbit
 온라인 학습, 해싱, allreduce, reduction, learning2search, 능동 학습 및 상호작용 학습 등의 기법으로 머신러닝의 한계를 넓히는 머신러닝 시스템입니다.
- XGBoost
 - 효율성·유연성·이식성이 뛰어나도록 설계된 최적화 분산 그래디언트 부스팅 라이브러리입니다.
- YDF
 - Random Forest, Gradient Boosted Decision Trees, CART, Isolation Forest 모델을 학습·평가·해석·서비스하기 위한 라이브러리입니다.
- bitsandbytes
 - CUDA 맞춤 함수(특히 8비트 옵티마이저, 행렬 곱셈(LLM.int8()), 8비트 및 4비트 양자화 함수)를 가볍게 감싼 Python 래퍼 라이브러리입니다.
- einops
 - 읽기 쉽고 신뢰할 수 있는 코드를 위한 유연하고 강력한 텐서 연산입니다.
- scikit-learn
 - 데이터 접근과 준비, 통계 모델 구축을 위한 다양한 모듈을 제공하는 강력한 머신러닝 라이브러리입니다.
- snnTorch
 - 스파이킹 신경망을 사용하는 딥러닝 및 온라인 학습 라이브러리입니다.
- torchdistill
 - 다양한 최첨단 지식 증류 방법을 제공하며, Python 코드 대신 선언형 YAML 설정 파일만 편집해 새로운 실험을 쉽게 설계할 수 있습니다.
- torchkeras
 Keras 스타일로 PyTorch 신경망을 간단히 학습하기 위한 라이브러리입니다.
- veScale
 - PyTorch 네이티브 LLM 학습 프레임워크입니다.
- yellowbrick
 - scikit-learn 및 기타 머신러닝 라이브러리를 위한 matplotlib 기반 모델 평가 플롯입니다.
Data Annotation and Synthesis
섹션 제목: “Data Annotation and Synthesis”- Argilla
 - 도메인 전문가와 데이터 팀이 더 짧은 시간에 더 나은 NLP 데이터셋을 구축하도록 돕습니다.
- cleanlab
 - 데이터 중심 AI용 Python 라이브러리입니다. 잘못된 레이블과 이상치를 자동으로 찾고, 다중 주석 데이터셋의 합의도 및 주석자 품질을 추정하며, 다음에 재레이블링할 최적의 데이터를 제안합니다.
- COCO Annotator
 - 객체 탐지, 위치 추정 및 키포인트를 위한 웹 기반 이미지 분할 도구입니다.
- CVAT
 - 이미지와 동영상 모두를 위한 OpenCV의 웹 기반 컴퓨터 알고리즘 주석 도구입니다.
- Doccano
 - 감성 분석, 개체명 인식, 기계 번역 기능을 제공하는 오픈 소스 인간용 텍스트 주석 도구입니다.
- Label Studio
 - 표준화된 출력 형식을 갖춘 다중 도메인 데이터 레이블링 및 주석 도구입니다.
- LightlyStudio
 - 이미지와 동영상 비전 데이터셋을 선별·주석·관리하기 위한 오픈 소스 도구입니다. 임베딩 기반 자동 선택, 주석, 바운딩 박스 및 분할 자동 레이블링을 지원합니다.
- NeMo Curator
 - 효율적인 대규모 언어 모델 데이터 큐레이션을 위한 GPU 가속 프레임워크입니다.
- refinery
 - 자연어 데이터를 확장하고 평가하며 유지 관리하기 위해 데이터 과학자가 선택할 수 있는 오픈 소스 도구입니다.
- SDV
 - 단일 테이블, 다중 테이블 및 시계열 데이터셋을 학습한 다음 원본과 동일한 형식 및 통계적 특성을 지닌 합성 데이터를 쉽게 생성할 수 있는 합성 데이터 생성 라이브러리 생태계입니다.
- Semantic Segmentation Editor
 - 카메라 및 LiDAR 데이터 레이블링을 위한 Hitachi의 오픈 소스 도구입니다.
- synthcity
 - 합성 표 형식 데이터를 생성하고 평가하는 라이브러리입니다.
- TabGAN
 - 적대적 필터링, 개인정보 보호 지표, sklearn 통합을 갖춘 GAN(CTGAN), 확산 모델 및 LLM 기반 합성 표 형식 데이터 생성 도구입니다.
- ViPE
 - 원본 동영상에서 카메라 포즈와 고밀도 깊이 맵에 주석을 달기 위한 공간 AI 도구입니다.
- YData Synthetic
 - 최첨단 생성 모델을 활용해 합성 표 형식 및 시계열 데이터를 생성하는 패키지입니다.
Data Pipeline
섹션 제목: “Data Pipeline”- Apache Airflow
 - 스케줄러, DAG 정의 및 시각화 UI를 포함하는 Python 기반 데이터 파이프라인 프레임워크입니다.
- Apache Nifi
 - 데이터 흐름을 위해 만들어졌습니다. 데이터 라우팅, 변환 및 시스템 중재 로직을 위한 고도로 구성 가능한 방향성 그래프를 지원합니다.
- Argo Workflows
 - Kubernetes에서 병렬 작업을 오케스트레이션하는 오픈 소스 컨테이너 네이티브 워크플로 엔진입니다. Kubernetes CRD(Custom Resource Definition)로 구현됩니다.
- Couler
 - Argo Workflows, Tekton Pipelines, Apache Airflow 등 다양한 워크플로 엔진에서 머신러닝 워크플로를 구성하고 관리하기 위한 통합 인터페이스입니다.
- DataTrove
 - 대규모 텍스트 데이터를 처리·필터링·중복 제거하기 위한 라이브러리입니다.
- Dagster
 - 머신러닝, 분석 및 ETL을 위한 데이터 오케스트레이터입니다.
- DBT
 - 데이터 웨어하우스 내에서 변환을 실행하는 ETL 도구입니다.
- Flyte
 - Lyft의 클라우드 네이티브 머신러닝 및 데이터 처리 플랫폼입니다. (Demo)
- Genie
 - Hadoop 기반 시스템에서 작업 실행을 연동하고 시작하는 작업 오케스트레이션 엔진입니다.
- Hamilton
 - 데이터 흐름 정의를 위한 마이크로 오케스트레이션 프레임워크입니다. Python이 실행되는 모든 곳(Jupyter, FastAPI, Spark, Ray, Dask 등)에서 작동합니다. 사용자가 복잡한 세부 사항을 몰라도 소프트웨어 엔지니어링 모범 사례를 적용합니다. 특성 엔지니어링 변환, 종단 간 모델 파이프라인 및 LLM 워크플로 정의에 사용할 수 있습니다. Kedro, Luigi, Airflow, dbt 등의 매크로 오케스트레이션 시스템을 대체하는 대신 해당 시스템의 매크로 작업 안쪽 코드를 대체해 보완합니다. 계보·출처, 실행 원격 측정 및 데이터 요약을 수집하고 자동으로 채워지는 카탈로그를 구축하는 자체 호스팅 UI도 제공하며, 개발 및 운영 환경 모두에서 사용할 수 있습니다.
- Instill VDP
 - 처음부터 끝까지 데이터 처리 파이프라인을 간소화하는 것을 목표로 합니다.
- Instructor
 - GPT-3.5, GPT-4, GPT-4-Vision 및 오픈 소스 모델 등의 LLM에서 JSON과 같은 구조화된 데이터를 쉽게 얻을 수 있습니다.
- Kedro
 - 견고하고 확장 가능하며 배포·재현·버전 관리가 가능한 데이터 파이프라인 구축을 돕는 워크플로 개발 도구입니다.
- Luigi
 - 의존성 해결, 워크플로 관리, 시각화 등을 처리하여 복잡한 배치 작업 파이프라인 구축을 돕는 Python 모듈입니다.
- Metaflow
 - 데이터 과학자가 실제 데이터 과학 프로젝트를 쉽게 구축하고 관리하도록 돕는 프레임워크입니다.
- Pachyderm
 - 주로 운영 머신러닝 파이프라인의 동적 구축에 초점을 둔 Kubernetes 기반 오픈 소스 분산 처리 프레임워크입니다. (Video)
- Pixeltable
 멀티모달 AI 워크로드 구축 및 관리를 위한 선언형 증분 데이터 인프라를 제공하는 오픈 소스 Python 라이브러리입니다.
- Prefect Core
 - 재시도, 로깅, 동적 매핑, 캐싱, 실패 알림 등의 의미론을 데이터 파이프라인에 쉽게 추가하는 워크플로 관리 시스템입니다.
- SeqIO
 - 다운스트림 시퀀스 모델에 입력할 순차 데이터를 처리하는 라이브러리입니다.
- Snakemake
 - 재현 가능하고 확장 가능한 데이터 분석을 위한 워크플로 관리 시스템입니다.
- Towhee
 - 하나 이상의 ML 모델을 사용해 임베딩 벡터를 생성하는 범용 머신러닝 파이프라인입니다.
- unstructured
 - PDF, HTML, Word 문서 등을 비롯한 이미지 및 텍스트 문서를 수집하고 전처리하여 LLM 데이터 처리 워크플로를 간소화하고 최적화합니다.
- ZenML
 - 자동 메타데이터 추적, 캐싱 및 다양한 도구 통합에 중점을 두고 재현 가능한 ML 파이프라인을 만드는 확장 가능한 오픈 소스 MLOps 프레임워크입니다.
Data Science Notebook
섹션 제목: “Data Science Notebook”- Apache Zeppelin
 - SQL, Scala 등을 활용한 데이터 중심의 대화형 분석과 협업 문서를 지원하는 웹 기반 노트북입니다.
- Deepnote
 - AI 우선 설계, 세련된 UI, 새로운 블록 및 네이티브 데이터 통합을 갖춘 Jupyter 대체 제품입니다. 즐겨 쓰는 IDE에서 Python, R, SQL을 로컬로 사용한 뒤 Deepnote 클라우드로 확장해 실시간 협업, Deepnote 에이전트 및 배포 가능한 데이터 앱을 활용할 수 있습니다.
- Jupyter Notebooks
 - 재현 가능한 개발을 위한 웹 인터페이스 기반 Python 샌드박스 환경입니다.
- Marimo
 - 재현 가능한 실험을 실행하고, 스크립트로 실행하며, 앱으로 배포하고, Git으로 버전 관리할 수 있는 반응형 Python 노트북입니다.
- Papermill
 - 노트북에 매개변수를 지정하고 Python 스크립트처럼 실행하는 라이브러리입니다.
- Polynote
 - 실험적인 다중 언어 노트북 환경입니다. 현재 Scala와 Python(Spark 사용 여부 무관), SQL, Vega를 지원합니다.
- RMarkdown
 - Pandoc을 기반으로 한 차세대 R Markdown 구현 패키지입니다.
- Stencila
 - 데이터 기반 콘텐츠를 만들고 협업하며 공유하는 플랫폼입니다. 투명하고 재현 가능한 콘텐츠를 제공합니다.
- Voilà
 - Jupyter 노트북을 대시보드 등으로 사용할 수 있는 독립형 웹 애플리케이션으로 변환합니다.
Data Storage Optimisation
섹션 제목: “Data Storage Optimisation”- AIStore
 - 스토리지 노드를 추가할 때마다 선형 확장할 수 있으며 페타스케일 딥러닝에 특히 중점을 둔 경량 객체 스토리지 시스템입니다.
- Alluxio
 - 컴퓨팅 프레임워크와 스토리지 시스템 사이의 간극을 잇는 가상 분산 스토리지 시스템입니다.
- Apache Arrow
 - Pandas, Hadoop 기반 시스템 등과 호환되는 메모리 내 컬럼형 데이터 표현 형식입니다.
- Apache Druid
 - 고성능 실시간 분석 데이터베이스입니다. 입문은 article을 참고하세요.
- Apache Hudi
 - 데이터 레이크에 핵심 웨어하우스 및 데이터베이스 기능을 직접 제공하는 트랜잭션 데이터 레이크 플랫폼입니다. 스트리밍 워크로드에 적합하며 효율적인 증분 배치 파이프라인도 만들 수 있습니다. Spark, Flink, Presto, Trino, Hive 등을 포함한 주요 쿼리 엔진을 지원합니다. 자세한 내용은 here를 참고하세요.
- Apache Iceberg
 - 수십 페타바이트 규모의 분석 테이블을 위해 구축된 ACID 호환 고성능 형식입니다. SQL 테이블의 안정성과 단순성을 빅데이터에 제공하며 Spark, Trino, Flink, Presto, Hive, Impala 등의 엔진이 같은 테이블을 동시에 안전하게 사용할 수 있습니다. 자세한 내용은 here를 참고하세요.
- Apache Ignite
 - 페타바이트 규모의 메모리 속도를 제공하는 트랜잭션·분석·스트리밍 워크로드용 메모리 중심 분산 데이터베이스, 캐싱 및 처리 플랫폼입니다. Demo
- Apache Parquet
 - Pandas, Hadoop 기반 시스템 등과 호환되는 디스크 저장용 컬럼형 데이터 표현 형식입니다.
- Apache Pinot
 - 실시간 분산 OLAP 데이터 저장소입니다. 빅데이터용 오픈 소스 OLAP 시스템인 ClickHouse, Druid, Pinot의 비교는 here에서 볼 수 있습니다.
- Casibase
 - 웹 UI와 엔터프라이즈 SSO를 갖춘 LangChain 유사 RAG(검색 증강 생성) 지식 데이터베이스입니다.
- Chroma
 - 오픈 소스 임베딩 데이터베이스입니다.
- ClickHouse
 - 오픈 소스 컬럼 지향 데이터베이스 관리 시스템입니다.
- Delta Lake
 - Apache Spark 및 기타 빅데이터 엔진에 확장 가능한 ACID 트랜잭션을 제공하는 스토리지 계층입니다.
- EdgeDB
 - 현대적인 데이터 모델, 그래프 쿼리, 인증 및 AI 솔루션 등을 통해 Postgres를 강화합니다.
- GPTCache
 - 대규모 언어 모델 쿼리를 위한 시맨틱 캐시를 만드는 라이브러리입니다.
- InfluxDB
 메트릭, 이벤트 및 실시간 분석을 위한 확장 가능한 데이터 저장소입니다.
- Milvus
 머신러닝 모델과 신경망이 생성한 임베딩 벡터를 관리하는 클라우드 네이티브 오픈 소스 벡터 데이터베이스입니다.
- Marqo
 종단 간 벡터 검색 엔진입니다.
- pgvector
 Postgres에서 벡터 유사도 검색을 지원합니다.
- PostgresML
 SQL 쿼리를 사용해 텍스트 및 표 형식 데이터의 학습과 추론을 수행할 수 있는 PostgreSQL용 머신러닝 확장 기능입니다.
- Redis
 벡터 유사도 검색을 지원하는 오픈 소스 인메모리 데이터 저장소로, 시맨틱 검색 및 추천 시스템과 같은 AI/ML 애플리케이션에 적합합니다.
- Safetensors
 텐서를 저장하고 배포하는 간단하고 안전한 방법입니다.
- TimescaleDB
 빠른 수집과 복잡한 쿼리에 최적화된 오픈 소스 시계열 SQL 데이터베이스이며 PostgreSQL 확장 기능으로 제공됩니다. (Video)
- Weaviate
 - 다양한 미디어 유형을 기본 지원하는 저지연 벡터 검색 엔진(GraphQL, RESTful)입니다. 시맨틱 검색, Q&A, 분류, 사용자 지정 모델(PyTorch/TensorFlow/Keras) 등을 위한 모듈을 포함합니다.
- Zarr
 - 병렬 컴퓨팅에 사용하도록 설계된 청크형 압축 N차원 배열의 Python 구현입니다.
Data Stream Processing
섹션 제목: “Data Stream Processing”- Apache Beam
 배치 및 스트리밍을 위한 통합 프로그래밍 모델입니다.
- Apache Flink
 - 강력한 스트림 및 배치 처리 기능을 갖춘 오픈 소스 스트림 처리 프레임워크입니다.
- Apache Kafka
 - 입출력이 Kafka 클러스터에 저장되는 애플리케이션과 마이크로서비스를 구축하기 위한 Kafka 클라이언트 라이브러리입니다.
- Apache Samza
 - 메시징에는 Apache Kafka를, 내결함성·프로세서 격리·보안·리소스 관리에는 Apache Hadoop YARN을 사용하는 분산 스트림 처리 프레임워크입니다.
- Apache Spark
 - Apache Spark를 백엔드로 사용하는 스트림 마이크로 배치 처리로, 상태 기반 정확히 한 번 처리 의미론을 지원합니다.
- Bytewax
 - Rust 엔진 기반의 유연한 Python 중심 상태형 스트림 처리 프레임워크입니다.
- FastStream
 - FastAPI에서 영감을 받아 다른 웹 프레임워크와 쉽게 통합되는 최신 브로커 독립형 스트리밍 Python 프레임워크입니다. Apache Kafka, RabbitMQ, NATS 프로토콜을 지원합니다.
- MOA
 - 빅데이터 스트림 마이닝을 위한 오픈 소스 프레임워크입니다.
- MosaicML Streaming - 분산 모델 학습을 위해 클라우드 스토리지에서 대규모 데이터셋을 빠르고 결정론적으로 스트리밍합니다.
- RisingWave
 - 스트림 처리와 저지연 서빙을 통합하는 분산 SQL 스트리밍 데이터베이스로, 온라인 머신러닝용 특성을 구축하고 제공하는 데 적합합니다.
- TensorStore
 - 대규모 다차원 배열을 읽고 쓰는 라이브러리입니다.
Deployment and Serving
섹션 제목: “Deployment and Serving”- Agenta
 - LLMOps 워크플로 전체를 위한 종단 간 도구를 제공합니다. 구축(LLM 플레이그라운드, 평가), 배포(프롬프트 및 구성 관리), 관측 가능성과 추적을 지원합니다.
- AirLLM
 - 추론 메모리 사용량을 최적화하여 양자화, 증류, 가지치기 없이도 단일 4GB GPU 카드에서 70B 대규모 언어 모델을 추론할 수 있게 합니다.
- AITemplate
 - 심층 신경망을 초고속 추론 서빙용 CUDA(NVIDIA GPU)/HIP(AMD GPU) C++ 코드로 변환하는 Python 프레임워크입니다.
- BentoML
 - 고성능 ML 모델 서빙을 위한 오픈 소스 프레임워크입니다.
- Bifrost
 - 23개 이상의 LLM 제공업체에서 OpenAI 호환 API 하나로 사용할 수 있는 AI 게이트웨이입니다. 자동 대체, 부하 분산, 시맨틱 캐싱, 예산 관리 및 Prometheus 메트릭을 제공합니다.
- BISHENG
 - 엔터프라이즈 시나리오에 중점을 둔 개방형 LLM 애플리케이션 개발·운영 플랫폼입니다.
- CosmoEdge
 - RTSP 수신, CV/VLM 추론, 시각적 오케스트레이션, 경보 및 이벤트 전달을 결합해 Sophon 및 Rockchip NPU에서 운영 배포를 지원하는 C++ 엣지 비디오 AI 엔진입니다.
- DeepDetect
 - Jolibrain이 개발하고 유지 관리하는, TensorFlow·XGBoost·Caffe 모델용 C++ 머신러닝 운영 서버입니다.
- Dynamo
 - 다중 노드 분산 환경에서 생성형 AI 및 추론 모델을 제공하기 위한 고처리량·저지연 추론 프레임워크입니다.
- exo
 - 일상적으로 사용하는 기기로 집에서 AI 클러스터를 실행할 수 있게 합니다.
- Genkit
 - 익숙한 코드 중심 패턴을 사용해 AI 기반 앱을 구축하는 오픈 소스 프레임워크입니다. 관측 가능성 및 평가 기능과 함께 AI 기능을 쉽게 개발·통합·테스트할 수 있습니다.
- GoModel
 - OpenAI 호환 통합 API를 OpenAI, Anthropic, Gemini, Groq, xAI, Ollama 등의 제공업체에 노출하는 Go 기반 자체 호스팅 AI 게이트웨이입니다. 라우팅, 사용량 추적, 속도 제한 및 가드레일을 지원합니다.
- Inference
 - 다양한 인기 아키텍처와 미세 조정 모델을 배포할 수 있는 빠르고 운영 환경에 적합한 컴퓨터 비전 추론 서버입니다. Docker를 사용해 자체 하드웨어에서 YOLOv5, YOLOv8, CLIP, SAM, CogVLM 등의 모델을 배포할 수 있습니다.
- Infinity
 - 텍스트 임베딩, 재순위화 모델 및 CLIP을 제공하는 고처리량·저지연 REST API입니다.
- LiteLLM
 - Bedrock, Azure, OpenAI, VertexAI, Cohere, Anthropic, Sagemaker, HuggingFace, Replicate, Groq 등 100개 이상의 LLM API를 OpenAI 형식으로 호출하는 Python SDK 및 프록시 서버(LLM 게이트웨이)입니다.
- LiteRT
 - 이전 TensorFlow Lite인 LiteRT는 모바일·임베디드·엣지 장치에 머신러닝 모델을 배포할 수 있도록 하는 Google의 고성능 온디바이스 AI 추론 런타임입니다.
- LiteRT-LM
 - Android, iOS, Web, Desktop, IoT를 지원하며 엣지 장치에서 대규모 언어 모델을 배포하는 Google의 운영 환경용 고성능 추론 프레임워크입니다.
- LitServe
 - FastAPI를 기반으로 구축된 유연한 AI 모델 서빙 엔진입니다. 모델용 맞춤 추론 엔진, 에이전트, 멀티모달 시스템, RAG 및 복잡한 ML 파이프라인을 지원합니다.
- jevos
 - 예/아니요 판단을 위한 TypeSafe의 Jev 대체 오픈 소스 도구입니다. 10억 매개변수 이진 분류기(GGUF, llama.cpp)를 Jev 호환 FastAPI HTTP API로 제공하며 노트북에서 CPU만으로 실행됩니다.
- Jina-serve
 - gRPC, HTTP, WebSockets로 통신하는 AI 서비스를 구축하고 배포하는 프레임워크입니다.
- Kiln
 - LLM 미세 조정, 합성 데이터 생성, 데이터셋 협업을 위한 오픈 소스 도구입니다.
- KServe
 - 예측 및 생성형 ML을 제공하기 위한 Kubernetes 사용자 지정 리소스 정의를 제공합니다.
- KTransformers
 - 최첨단 LLM 추론 최적화를 경험하기 위한 유연한 프레임워크입니다.
- Langtrace
 - LLM 애플리케이션을 위한 오픈 소스 OpenTelemetry 기반 종단 간 관측 도구로, 인기 LLM, LLM 프레임워크, 벡터 DB 등을 대상으로 실시간 추적·평가·메트릭을 제공합니다.
- Lepton AI
 - Python 코드로 AI 서비스를 쉽게 구축할 수 있게 해 주는 LeptonAI Python 라이브러리입니다.
- LightLLM
 - 경량 설계, 쉬운 확장성 및 빠른 성능으로 주목받는 Python 기반 LLM 추론 및 서빙 프레임워크입니다.
- llama.cpp
 - Llama와 같은 다양한 대규모 언어 모델의 추론을 수행하는 오픈 소스 소프트웨어 라이브러리입니다.
- llmfit
 - 시스템의 RAM, CPU 및 GPU에 맞는 LLM 모델 크기를 제안하는 터미널 도구입니다. 하드웨어를 감지하고 품질·속도·적합성·컨텍스트 차원에서 각 모델을 평가해 실제로 원활히 실행될 모델을 알려 줍니다.
- LMCache
 - LLM 추론을 가속하는 고성능 KV 캐시 계층입니다.
- LMDeploy
 - LLM을 압축·배포·서빙하기 위한 툴킷입니다.
- LM Studio
 - 최소 요구 사항을 충족하면 비교적 사양이 낮은 컴퓨터에서도 LLM 모델을 로컬로 배포할 수 있는 도구입니다.
- LocalAI
 - 로컬 추론용 OpenAI API 사양 호환 REST API 대체 제품입니다.
- MindsDB
 - 데이터베이스, 벡터 저장소 및 애플리케이션 데이터에서 실시간으로 모델을 생성·제공·미세 조정하는 플랫폼입니다.
- mini-sglang
 - 대규모 언어 모델을 위한 경량 고효율 서빙 프레임워크입니다.
- MLRun
 - 연속적인 ML 및 생성형 AI 애플리케이션의 전체 생애주기에 걸쳐 신속하게 구축하고 관리하기 위한 개방형 MLOps 프레임워크입니다.
- MLServer
 - 여러 프레임워크 및 멀티 모델 서빙 등을 지원하는 머신러닝 모델 추론 서버입니다.
- Model Runner
 - Docker Hub 또는 OCI 호환 레지스트리에서 직접 가져온 LLM 및 기타 AI 모델을 포함해 Docker로 AI 모델을 쉽게 관리·실행·서빙합니다.
- Mosec
 - 동적 배칭 등을 제공하는 Rust 기반 다단계 파이프라인 모델 서버입니다. 마이크로서비스로 구현하고 배포하기 쉽습니다.
- nano-vllm
 - 처음부터 작성된 경량 vLLM 구현으로, 프리픽스 캐싱·텐서 병렬화·CUDA 그래프 등의 최적화 기법을 활용해 빠른 오프라인 추론을 제공합니다.
- nndeploy
 - 사용하기 쉽고 고성능인 AI 배포 프레임워크입니다.
- Nuclio
 - 데이터·I/O·컴퓨팅 집약적 워크로드에 중점을 둔 고성능 서버리스 프레임워크입니다. Jupyter 및 Kubeflow 등의 데이터 과학 도구와 잘 통합되고 다양한 데이터 및 스트리밍 소스를 지원하며 CPU와 GPU에서 실행할 수 있습니다.
- OpenLLM
 - 개발자는 단일 명령으로 모든 오픈 소스 LLM(Llama 3.1, Qwen2, Phi3 등) 또는 사용자 지정 모델을 OpenAI 호환 API로 실행할 수 있습니다.
- OpenVINO
 - AI 추론을 최적화하고 배포하기 위한 오픈 소스 툴킷입니다.
- Open WebUI
 - 완전히 오프라인으로 작동하도록 설계된 확장 가능하고 풍부한 기능의 사용자 친화적 자체 호스팅 AI 플랫폼입니다. Ollama와 OpenAI 호환 API 등의 LLM 러너 및 RAG용 내장 추론 엔진을 지원해 강력한 AI 배포 솔루션을 제공합니다.
- OptiLLM
 - 학습이나 미세 조정 없이 추론 작업에서 LLM의 정확도와 성능을 크게 높이는 20개 이상의 최첨단 기법을 구현한 OpenAI API 호환 추론 최적화 프록시입니다.
- PowerInfer
 - 장치의 활성화 지역성을 활용하는 CPU/GPU LLM 추론 엔진입니다.
- Prompt2Model
 - ChatGPT 등 LLM에 쓰는 프롬프트와 같은 자연어 작업 설명을 입력받아 배포에 적합한 소규모 특수 목적 모델을 학습하는 시스템입니다.
- RamaLama
 - OCI 컨테이너로 AI 모델 추론을 로컬에서 사용하고 서빙하는 일을 간소화하는 오픈 소스 도구로, 호스트 시스템을 구성할 필요가 없습니다.
- RunAnywhere
 - iOS, Android, React Native, Flutter에서 LLM·음성 인식·음성 합성 모델을 장치 내에서 실행하기 위한 운영 환경용 SDK입니다. 비공개·오프라인·고속 모바일 AI 앱을 구현할 수 있습니다.
- Seldon Core
 - Kubernetes에서 머신러닝 모델을 배포하는 오픈 소스 플랫폼입니다. (Video)
- SGLang
 - 대규모 언어 모델 및 비전 언어 모델을 위한 빠른 서빙 프레임워크입니다.
- SIE
 - 임베딩·재순위화·추출을 위한 오픈 소스 추론 서버이자 운영 클러스터입니다. 밀집·희소·다중 벡터·비전·재순위화·추출 모델 85개 이상을 미리 구성해 제공합니다. Helm, KEDA 자동 확장, Grafana 대시보드, Terraform이 포함됩니다.
- SkyPilot
 - 모든 클라우드에서 LLM, AI 및 배치 작업을 실행하는 프레임워크로, 최대 비용 절감, 높은 GPU 가용성 및 관리형 실행을 제공합니다.
- Tensorflow Serving
 - 코어당 초당 10만 건의 요청을 처리할 수 있으며 gRPC 프로토콜로 TensorFlow 모델을 제공하는 고성능 프레임워크입니다.
- torchtune
 - LLM을 쉽게 작성하고 사후 학습하며 실험하기 위한 PyTorch 라이브러리입니다.
- Transformer Lab
 - 다양한 추론 엔진과 플랫폼에서 로컬로 모델을 미세 조정·평가·내보내기·테스트하는 오픈 소스 LLM 작업 공간입니다.
- Triton Inference Server
 - GPU 및 CPU에서 어떤 프레임워크의 AI 모델이든 높은 활용률로 배포할 수 있는 고성능 오픈 소스 서빙 소프트웨어입니다.
- Vercel AI
 - Next.js, React, Svelte, Vue 등의 프레임워크와 Node.js 런타임을 사용해 AI 기반 애플리케이션을 구축하도록 돕는 TypeScript 툴킷입니다.
- Vespa
 - 서빙 시점과 규모에 관계없이 벡터·텐서·텍스트·구조화된 데이터를 검색하고 추론하며 구성합니다.
- vLLM
 - LLM을 위한 고처리량·메모리 효율적인 추론 및 서빙 엔진입니다.
Evaluation and Monitoring
섹션 제목: “Evaluation and Monitoring”- AlpacaEval
 - 지시 따르기 언어 모델을 자동으로 평가하는 도구입니다.
- ANN-Benchmarks
 - 근사 최근접 이웃 검색 알고리즘을 위한 벤치마크 환경입니다.
- ARES
 - 검색 증강 생성(RAG) 모델을 자동으로 평가하는 프레임워크입니다.
- BEIR
 - 다양한 정보 검색 작업을 포함한 이종 벤치마크입니다. 벤치마크에서 NLP 기반 검색 모델을 평가하기 위한 공통의 간편한 프레임워크도 제공합니다.
- Code Generation LM Evaluation Harness
 - 코드 생성 모델 평가를 위한 프레임워크입니다.
- COMET
 - 머신러닝 평가를 위한 오픈 소스 프레임워크입니다.
- C-Eval
 - 기반 모델을 위한 포괄적인 중국어 평가 모음입니다.
- Deepchecks
 - 연구부터 운영까지 데이터와 모델을 철저히 테스트해 AI 및 ML 검증 요구를 모두 충족하는 종합적인 오픈 소스 솔루션입니다.
- DeepEval
 - LLM 애플리케이션을 위한 사용하기 쉬운 오픈 소스 평가 프레임워크입니다.
- EvalAI
 - AI 알고리즘을 대규모로 평가하고 비교하는 오픈 소스 플랫폼입니다.
- Evalchemy
 - 사후 학습 언어 모델을 평가하기 위한 통합형 사용하기 쉬운 툴킷입니다.
- EvalPlus
 - 확장된 HumanEval+ 및 MBPP+ 벤치마크, 효율성 평가(EvalPerf), 안전하고 확장 가능한 평가 툴킷을 제공하는 LLM4Code용 강건한 평가 프레임워크입니다.
- Evals
 - OpenAI 모델 평가 프레임워크이자 오픈 소스 벤치마크 레지스트리입니다.
- EvalScope
 - 효율적인 대규모 모델 평가 및 성능 벤치마킹을 위한 간소화되고 사용자 지정 가능한 프레임워크입니다.
- Evaluate
 - 모델을 평가·비교하고 성능을 더 쉽고 표준화된 방식으로 보고하는 라이브러리입니다.
- Evidently
 - ML 및 LLM 기반 시스템을 평가·테스트·모니터링하는 오픈 소스 프레임워크입니다.
- Future AGI
 - LLM 및 AI 에이전트 애플리케이션용 추적, 평가, 시뮬레이션, 데이터셋, 게이트웨이, 가드레일을 통합한 자체 호스팅 가능한 종단 간 에이전트 엔지니어링 및 최적화 오픈 소스 플랫폼입니다.
- GAOKAO-Bench
 - 중국 대학 입학시험(GAOKAO) 문제를 데이터셋으로 활용해 대형 모델의 언어 이해 및 논리적 추론 능력을 평가하는 프레임워크입니다.
- Giskard
 - AI 애플리케이션의 성능·편향·보안 문제를 자동으로 감지하는 오픈 소스 Python 라이브러리입니다.
- guidellm
 - 대규모 언어 모델 추론 시스템을 위한 벤치마킹 및 성능 평가 도구입니다.
- Harbor
 - 내장 벤치마크 및 환경 관리와 함께 컨테이너 환경 전반의 병렬 실험을 지원하며 에이전트 및 언어 모델을 평가하고 최적화하는 프레임워크입니다.
- HumanEval
 - 단위 테스트가 포함된 Python 프로그래밍 문제를 사용해 코드 생성 모델의 기능적 정확도를 평가하는 벤치마크입니다.
- Helicone
 - 올인원 오픈 소스 LLM 개발자 플랫폼입니다.
- HELM
 - 표준화된 데이터셋, 다양한 모델을 위한 통합 API, 여러 지표, 공정성 교란, 프롬프트 구성 프레임워크 및 통합 모델 액세스 프록시 서버 등 언어 모델을 종합적으로 평가하기 위한 도구를 제공합니다.
- Inspect
 - 대규모 언어 모델 평가 프레임워크입니다.
- IsaacLab-Arena
 - 조합 가능한 환경을 만들고 로봇 정책을 대규모로 평가하기 위한 NVIDIA Isaac Lab 오픈 소스 확장 기능입니다.
- JiWER
 - 자동 음성 인식 시스템을 평가하기 위한 간단하고 빠른 Python 패키지입니다.
- Laminar
 - AI 제품용 LLM 데이터를 추적·평가·레이블링·분석하는 오픈 소스 플랫폼입니다.
- Langfuse
 - LLM 기반 애플리케이션을 위한 관측 가능성 및 분석 솔루션입니다.
- LangTest
 - NLP 모델을 위한 포괄적인 평가 툴킷입니다.
- Language Model Evaluation Harness
 - 다양한 평가 작업에 생성형 언어 모델을 테스트하는 프레임워크입니다.
- LangWatch
 - DSPy의 시각적 인터페이스이자 공정 코드 배포 모델을 갖춘 완전한 LLM Ops 플랫폼입니다. LLM 파이프라인의 모니터링, 실험, 측정 및 개선을 지원합니다.
- Latitude
 - 시맨틱 추적 검색 및 이슈 추적 기능을 갖춘 AI 에이전트 관측 가능성 오픈 소스 플랫폼입니다.
- LightEval
 - 경량 LLM 평가 모음입니다.
- lmms-eval
 - LMM을 일관되고 효율적으로 평가하도록 세심하게 제작된 평가 프레임워크입니다.
- Melting Pot
 - 다중 에이전트 강화 학습을 위한 테스트 시나리오 모음입니다.
- Meta-World
 - 서로 다른 50개의 로봇 조작 작업으로 구성된 메타 강화 학습 및 다중 작업 학습용 오픈 소스 시뮬레이션 벤치마크입니다.
- mir_eval
 - 음악 정보 검색 시스템을 투명하고 표준화된 간단한 방식으로 평가하는 Python 라이브러리입니다.
- MLPerf Inference
 - 다양한 배포 시나리오에서 시스템의 모델 실행 속도를 측정하는 벤치마크 모음입니다.
- Massive Text Embedding Benchmark - 8가지 임베딩 작업, 58개 데이터셋 및 112개 언어에 걸쳐 텍스트 임베딩 모델 성능을 평가하는 포괄적인 평가 프레임워크입니다.
- NannyML
 - 대상값에 접근하지 않고도 배포 후 모델 성능을 추정하고 데이터 드리프트를 감지하며, 드리프트 경보를 모델 성능 변화와 지능적으로 연결하는 라이브러리입니다.
- OGB
 - 그래프 머신러닝을 위한 벤치마크 데이터셋, 데이터 로더 및 평가기 모음입니다.
- Ollama Grid Search
 - 사용 사례에 가장 적합한 모델·프롬프트·추론 매개변수를 선택하는 과정을 자동화합니다. 조합을 반복 실행하고 결과를 시각적으로 검토할 수 있습니다.
- onWatch
 - Anthropic Pro/Max Plans, Codex, Gemini CLI, Synthetic, Z.ai, GitHub Copilot, MiniMax Coding/Token Plan, Antigravity, OpenRouter 등 여러 제공업체의 AI API 할당량 사용량을 실시간으로 추적하는 경량 Go CLI입니다. 소비율 전망, 과거 사용량 그래프 및 주기별 추적 기능을 제공합니다.
- OpenCompass
 - 50개 이상의 데이터셋에서 LLaMA, LLaMa2, ChatGLM2, ChatGPT, Claude 등 다양한 모델을 지원하는 LLM 평가 플랫폼입니다.
- OpenLIT
 - 관측 가능성, 모니터링, 가드레일, 평가 및 원활한 통합 기능으로 LLM 워크플로를 간소화하는 오픈 소스 AI 엔지니어링 플랫폼입니다.
- OpenLLMetry
 - 성능 모니터링, 실행 추적 및 디버깅 기능을 통해 대규모 언어 모델 애플리케이션을 심층적으로 파악할 수 있게 합니다.
- Opik
 - LLM 애플리케이션을 평가·테스트·모니터링하는 오픈 소스 플랫폼입니다.
- Overcooked-AI
 - 매우 인기 있는 비디오 게임 Overcooked를 기반으로 한 완전 협력형 인간-AI 작업 수행 벤치마크 환경입니다.
- Phoenix
 - 실험, 평가 및 문제 해결을 위해 설계된 오픈 소스 AI 관측 가능성 플랫폼입니다.
- Promptfoo
 - CI/CD 통합으로 탈옥, 프롬프트 인젝션 및 기타 취약점을 테스트하는 LLM 레드팀 및 평가 프레임워크입니다.
- Prometheus-Eval
 - LLM 프로젝트의 관리 및 최적화를 개선하도록 설계된 종합 플랫폼입니다.
- RagaAI Catalyst
 - 다른 언어 모델을 평가하는 데 특화된 언어 모델의 학습·평가·사용을 위한 도구 모음입니다.
- Ragas
 - RAG 파이프라인 평가 프레임워크입니다.
- RewardBench
 - 보상 모델의 역량과 안전성을 평가하도록 설계된 벤치마크입니다.
- RLBench
 - 강화 학습, 모방 학습, 다중 작업 학습, 기하학적 컴퓨터 비전, 특히 소량 학습을 비롯한 여러 시각 유도 조작 연구 분야를 지원하도록 설계된 야심 찬 대규모 벤치마크 및 학습 환경입니다.
- SimplerEnv
 - 실제 로봇 설정을 위한 시뮬레이션 조작 정책 평가 환경입니다.
- SwanLab
 - AI 학습 추적 및 시각화 도구입니다.
- Speech-to-Text Benchmark
 - 여러 음성 인식 엔진을 벤치마킹하기 위한 최소한의 확장 가능한 프레임워크입니다.
- TensorFlow Model Analysis
 - 학습기에서 정의한 동일한 메트릭을 사용해 대량의 데이터에서 TensorFlow 모델을 분산 방식으로 평가하는 라이브러리입니다.
- TorchBench
 - PyTorch 성능 평가에 사용하는 오픈 소스 벤치마크 모음입니다.
- TruLens
 - LLM 실험을 평가하고 추적하기 위한 도구 모음입니다.
- TrustLLM
 - 원칙, 설문조사 및 벤치마크를 포함해 대규모 언어 모델의 신뢰성을 평가하는 포괄적인 프레임워크입니다.
- VBench
 - 비디오 생성 모델을 위한 포괄적인 벤치마크 모음입니다.
- VLMEvalKit
 - 대규모 비전-언어 모델(LVLM)을 위한 오픈 소스 평가 툴킷입니다.
Explainability and Fairness
섹션 제목: “Explainability and Fairness”- Aequitas
 - 데이터 과학자, 머신러닝 연구자 및 정책 입안자가 머신러닝 모델의 차별과 편향을 감사하고 예측 위험 평가 도구의 개발·배포에 관해 정보에 기반한 공정한 결정을 내릴 수 있도록 지원하는 오픈 소스 편향 감사 툴킷입니다.
- AI Explainability 360
 - 데이터와 머신러닝 모델의 해석 가능성 및 설명 가능성을 위한 종합적인 알고리즘 모음으로, 설명의 다양한 차원과 대리 설명 가능성 지표를 다룹니다.
- AI Fairness 360
 - 데이터셋 및 머신러닝 모델을 위한 포괄적인 공정성 지표와 이에 대한 설명, 데이터 및 모델의 편향을 완화하는 알고리즘을 제공합니다.
- Alibi
 - 머신러닝 모델을 검사하고 해석하기 위한 오픈 소스 Python 라이브러리입니다. 초기에는 블랙박스 및 개별 사례 기반 모델 설명에 중점을 둡니다.
- captum
 - Facebook이 개발한 PyTorch 모델의 해석 가능성 및 이해를 위한 라이브러리입니다. PyTorch 모델을 대상으로 통합 그래디언트, 돌출 맵, smoothgrad, vargrad 등의 범용 구현을 포함합니다.
- Fairlearn
 - 머신러닝 모델의 불공정성을 평가하고 완화하는 Python 툴킷입니다.
- InterpretML
 - 해석 가능한 모델을 학습하고 블랙박스 시스템을 설명하기 위한 오픈 소스 패키지입니다.
- Lightly
 - 이미지 자기 지도 학습을 위한 Python 프레임워크입니다. 학습된 표현은 레이블이 없는 데이터의 분포를 분석하고 데이터셋 균형을 재조정하는 데 사용할 수 있습니다.
- LOFO Importance
 - 선택한 모델과 평가 지표를 기준으로 각 특성을 하나씩 제거하고, 선택한 검증 방식으로 모델 성능을 평가하는 과정을 반복해 특성 집합의 중요도를 계산합니다.
- mljar-supervised
 - 특성 엔지니어링, 하이퍼파라미터 튜닝, 설명 및 자동 문서화를 갖춘 표 형식 데이터용 AutoML Python 패키지입니다.
- Quantus
 - 신경망 설명을 책임감 있게 평가하기 위한 설명 가능한 AI 툴킷입니다.
- SHAP
 - 모든 머신러닝 모델의 출력을 설명하는 통합 접근법입니다.
- SHAPash
 - 누구나 이해할 수 있는 명시적 레이블을 표시하는 여러 유형의 시각화를 제공하는 Python 라이브러리입니다.
- WhatIf
 - 블랙박스 분류 또는 회귀 ML 모델에 대한 이해를 높이는 사용하기 쉬운 인터페이스입니다.
Feature Store
섹션 제목: “Feature Store”- FEAST
 - 기존 인프라를 활용해 분석 데이터를 모델 학습 및 온라인 추론을 위한 운영 환경으로 전환하는 가장 빠른 경로를 제공하는 오픈 소스 특성 저장소입니다.
- Featureform
 - 기존 인프라에 쉽게 연결하는 가상 특성 저장소입니다. 데이터 과학자가 검증한 검색, 거버넌스, 계보 및 협업 기능을 pip 설치만으로 사용할 수 있습니다. pandas, Python, Spark, SQL 및 주요 클라우드 공급업체 통합을 지원합니다.
- Hopsworks Feature Store
 - ML용 오프라인/온라인 특성 저장소입니다. (Video)
Industry-strength Anomaly Detection
섹션 제목: “Industry-strength Anomaly Detection”- Alibi Detect
 - 이상치, 적대적 사례 및 개념 드리프트 감지에 중점을 둔 Python 패키지입니다.
- Darts
 - 시계열 예측 및 이상 감지를 위한 사용하기 쉬운 라이브러리입니다.
- Deequ
 - 대규모 데이터셋의 데이터 품질을 측정하는 “데이터 단위 테스트”를 정의하기 위한 Apache Spark 기반 라이브러리입니다.
- PyOD
 - 확장 가능한 이상치(이상 현상) 탐지를 위한 Python 툴박스입니다.
- TFDV
 - 머신러닝 데이터 탐색 및 검증 라이브러리입니다.
Industry Strength Computer Vision
섹션 제목: “Industry Strength Computer Vision”- CameraTraps
 - 대규모 카메라 트랩 데이터셋으로 학습한 탐지 및 분류 모델을 제공하는 야생동물 이미지 분석용 협업 딥러닝 프레임워크입니다.
- Deep Lake
 - 컴퓨터 비전에 최적화된 데이터 인프라입니다.
- DeepForest
 - 딥러닝을 활용해 항공 RGB 이미지에서 개별 나무 수관과 수종을 학습하고 예측하는 Python 패키지입니다.
- Detectron2
 - 최첨단 탐지 및 분할 알고리즘을 제공하는 Facebook AI Research의 차세대 라이브러리입니다.
- Kornia
 - 이미지 처리 및 기하학적 비전 알고리즘을 위한 다양한 미분 가능한 기능을 제공하는 PyTorch 기반 미분 가능한 컴퓨터 비전 라이브러리입니다.
- libcom
 - 이미지 합성 툴박스입니다.
- LightlyTrain
 - 산업 응용 분야를 위해 레이블이 없는 데이터로 컴퓨터 비전 모델을 사전 학습합니다.
- MMCV
 - OpenMMLab의 기반 컴퓨터 비전 라이브러리로 이미지·동영상 처리, 데이터 변환 및 증강, CNN 아키텍처, 최적화된 CUDA 연산 등의 필수 기능을 제공합니다.
- SuperGradients
 - PyTorch 기반 컴퓨터 비전 모델 학습을 위한 오픈 소스 라이브러리입니다.
- supervision
 - 컴퓨터 비전 파이프라인을 효율적으로 관리하기 위한 Python 라이브러리로 주석, 시각화 및 모델 모니터링 도구를 제공합니다.
- VideoSys
 - 다양한 가속 기법을 통해 여러 확산 모델을 지원하며, 이를 더 빠르게 실행하고 메모리를 적게 사용하게 합니다.
Industry Strength Information Retrieval
섹션 제목: “Industry Strength Information Retrieval”- AutoRAG
 - 데이터에 최적화된 RAG 파이프라인을 자동으로 찾는 RAG AutoML 도구입니다.
- BGE
 - 검색 및 RAG를 위한 올인원 검색 툴킷을 구축합니다.
- EmbedAnything
 - 텍스트, 이미지, 오디오, PDF 및 기타 미디어에서 임베딩을 생성하는 Rust 기반 미니멀·경량·고성능 임베딩 파이프라인으로, 밀집·희소·ONNX·후기 상호작용 임베딩을 지원합니다.
- Faiss
 - 밀집 벡터의 효율적인 유사도 검색 및 클러스터링을 위한 라이브러리입니다.
- GraphRAG
 - LLM을 활용해 비정형 텍스트에서 의미 있고 구조화된 데이터를 추출하도록 설계된 데이터 파이프라인 및 변환 도구 모음입니다.
- HippoRAG
 - 인간의 장기 기억 신경생물학에서 영감을 얻은 새로운 RAG 프레임워크로, LLM이 외부 문서의 지식을 지속적으로 통합할 수 있게 합니다.
- JamAI Base
 - 내장형 데이터베이스(SQLite)와 벡터 데이터베이스(LanceDB), 관리형 메모리 및 RAG 기능을 통합한 오픈 소스 RAG 백엔드 플랫폼입니다. 내장 LLM, 벡터 임베딩, 재순위화 오케스트레이션 및 관리를 제공하며 편리하고 직관적인 스프레드시트형 UI와 간단한 REST API로 사용할 수 있습니다.
- LangExtract
 - 사용자 정의 지침을 바탕으로 LLM을 사용해 비정형 텍스트 문서에서 구조화된 정보를 추출하는 Python 라이브러리입니다. 임상 기록이나 보고서 같은 자료에서 핵심 세부 정보를 찾아 정리하고, 추출한 데이터가 원문에 근거하도록 보장합니다.
- LightRAG
 - 간단하고 빠른 검색 증강 생성 프레임워크입니다.
- llmware
 - RAG, 에이전트 등의 LLM 기반 애플리케이션 구축을 위한 통합 프레임워크입니다. 비공개로 배포하고 기업 지식 소스에 안전하게 통합할 수 있는 소형 특화 모델을 활용하며 모든 비즈니스 프로세스에 비용 효율적으로 조정할 수 있습니다.
- Mem0
 - 지능형 메모리 계층을 통해 AI 어시스턴트와 에이전트의 개인화된 AI 상호작용을 강화합니다.
- NGT
 - 고차원 벡터 데이터 공간의 대용량 데이터를 대상으로 고속 근사 최근접 이웃 검색을 수행하는 명령어와 라이브러리를 제공합니다.
- NMSLIB
 - 효율적인 유사도 검색 라이브러리이자 일반 비계량 공간에서 k-NN 방법을 평가하는 툴킷입니다.
- Qdrant
 - 확장된 필터링을 지원하는 오픈 소스 벡터 유사도 검색 엔진입니다.
- R2R
 - 하이브리드 검색, 멀티모달 지원, 고급 관측 가능성을 갖추고 RAG 애플리케이션을 구축·배포·확장하기 위한 종합 플랫폼입니다.
- RAGFlow
 - 심층 문서 이해를 기반으로 한 RAG 엔진입니다.
- RAGxplorer
 - RAG 시각화를 구축하기 위한 도구입니다.
- RAG-FiT
 - 특별히 제작된 RAG 증강 데이터셋으로 모델을 미세 조정하여 외부 정보를 활용하는 LLM의 능력을 개선하는 라이브러리입니다.
- TextWorld
 - 강화 학습(RL) 에이전트의 학습 및 테스트를 위한 텍스트 기반 게임 생성기이자 확장 가능한 샌드박스 학습 환경입니다.
- Zvec
 - 저지연 유사도 검색을 위한 오픈 소스 프로세스 내 벡터 데이터베이스입니다.
Industry Strength Natural Language Processing
섹션 제목: “Industry Strength Natural Language Processing”- aisuite
 - 여러 생성형 AI 제공업체를 위한 간단하고 통합된 인터페이스입니다.
- Align-Anything
 - LLM, VLM 및 기타 임의-임의(any-to-any) 모델을 포함해 모든 양식의 대형 모델을 인간의 의도와 가치에 맞추는 것을 목표로 합니다.
- BERTopic
 - 트랜스포머와 c-TF-IDF를 활용해 밀집 클러스터를 만들고 중요한 단어는 유지하면서 쉽게 해석할 수 있는 주제를 생성하는 토픽 모델링 기법입니다.
- Burr
 - 챗봇·에이전트·시뮬레이션 등 의사결정 애플리케이션 개발을 돕습니다. 운영 환경용 기능(원격 측정, 영속성, 배포 등)과 오픈 소스 무료 로컬 우선 UI를 제공합니다.
- Context7
 - 프롬프트 및 AI 코딩 에이전트에 최신 코드 문서를 제공합니다.
- Dify
 - 에이전트형 AI 워크플로, RAG 파이프라인, 에이전트 기능, 모델 관리, 관측 가능성 등을 직관적인 인터페이스에 결합한 오픈 소스 LLM 앱 개발 플랫폼으로 프로토타입에서 운영 환경까지 빠르게 전환할 수 있습니다.
- dspy
 - 기반 모델을 프로그래밍하기 위한 프레임워크입니다.
- Dust
 - 대규모 언어 모델 앱의 설계와 배포를 지원합니다.
- ESPnet
 - 종단 간 음성 처리 툴킷입니다.
- FastChat
 - 대규모 언어 모델 기반 챗봇의 학습·서빙·평가를 위한 개방형 플랫폼입니다.
- Flair
 - Zalando가 개발한 최첨단 NLP용 간단한 프레임워크로 PyTorch를 직접 기반으로 합니다.
- FunASR
 - 내장 VAD, 구두점 삽입, 화자 분리 및 감정 인식을 지원하는 운영 환경용 ASR 툴킷입니다. 50개 이상의 언어를 지원하며 Docker/WebSocket/REST 배포와 ONNX 런타임을 제공합니다.
- Fun-ASR
 - 중국어 방언을 포함해 31개 언어를 지원하는 LLM 기반 ASR이며 구두점, 타임스탬프, 화자 분리를 기본 제공합니다.
- Gensim
 - 대규모 코퍼스의 토픽 모델링, 문서 인덱싱 및 유사도 검색을 위한 Python 라이브러리입니다.
- gpt-fast
 - 간단하고 효율적인 PyTorch 네이티브 트랜스포머 텍스트 생성입니다.
- Haystack
 - Transformer 모델과 LLM(GPT-3 등)을 사용해 데이터와 상호작용하는 오픈 소스 NLP 프레임워크입니다. ChatGPT 같은 질의응답, 시맨틱 검색, 텍스트 생성 등을 신속히 구축할 수 있는 운영 환경용 도구를 제공합니다.
- Interactive Composition Explorer
 - 언어 모델 프로그램을 위한 Python 라이브러리 및 추적 시각화 도구입니다.
- Jan
 - 컴퓨터에서 완전히 오프라인으로 실행되는 오픈 소스 ChatGPT 대안으로, 완전한 제어와 개인정보 보호를 유지하면서 LLM을 내려받아 로컬로 실행할 수 있습니다.
- Lamini
 - 모델을 빠르게 사용자 지정하는 LLM 엔진입니다.
- LangChain
 - 조합 가능성을 통해 LLM 애플리케이션 구축을 지원합니다.
- LlamaIndex
 - LLM 애플리케이션을 위한 데이터 프레임워크입니다.
- LLaMA
 - LLaMA(arXiv) 모델을 불러와 추론을 실행하는 최소한의 변경 가능하고 이해하기 쉬운 예제를 제공하는 것이 목표입니다.
- LLaMA-Factory
 - 코드 없이 CLI 및 웹 UI만으로 100개 이상의 대규모 언어 모델을 쉽게 미세 조정합니다.
- LLMBox
 - 통합 학습 파이프라인과 포괄적인 모델 평가를 포함한 LLM 구현용 종합 라이브러리입니다.
- LLaMA2-Accessory
 - 대규모 언어 모델(LLM) 및 멀티모달 LLM의 사전 학습·미세 조정·배포를 위한 오픈 소스 툴킷입니다.
- LMFlow
 - 대규모 머신러닝 모델 미세 조정을 위한 확장 가능하고 편리하며 효율적인 툴박스입니다.
- Megatron-LM
 - 대규모 언어 모델 학습을 위한 고도로 최적화되고 효율적인 라이브러리입니다.
- MindNLP
 - Hugging Face 모델 및 데이터셋과 호환되는 MindSpore 기반의 사용하기 쉽고 고성능인 NLP 및 LLM 프레임워크입니다.
- MLC LLM
 - 다양한 하드웨어 백엔드와 네이티브 애플리케이션에 어떤 언어 모델이든 네이티브 배포할 수 있는 범용 솔루션입니다. 누구나 자신의 사용 사례에 맞춰 모델 성능을 추가 최적화할 수 있는 생산적인 프레임워크도 제공합니다.
- mlx-lm
 - MLX를 사용해 Apple 실리콘에서 텍스트 생성 및 대규모 언어 모델 미세 조정을 수행하는 Python 패키지입니다. Hugging Face Hub 통합, 양자화 및 분산 추론을 지원합니다.
- Ollama
 - 대규모 언어 모델을 로컬에서 바로 실행할 수 있습니다.
- olmOCR
 - 실제 환경의 PDF 문서를 처리하는 언어 모델 학습용 툴킷입니다.
- PaddleNLP
 - PaddlePaddle 딥러닝 프레임워크 기반 LLM 개발 도구 모음으로, 다양한 하드웨어에서 효율적인 대형 모델 학습, 손실 없는 압축 및 고성능 추론을 지원합니다.
- Promptise Foundry
 - 자율 런타임, 메모리, 도구 통합, 거버넌스(예산·상태·미션·비밀), 가드레일, 시맨틱 캐싱 및 관측 가능성을 다루는 에이전트형 AI 및 MCP 서버용 운영 환경급 Python 프레임워크입니다.
- Semantic Kernel
 - OpenAI, Azure OpenAI, Hugging Face 등의 대규모 언어 모델을 C#, Python, Java 같은 기존 프로그래밍 언어와 통합하는 SDK입니다. 몇 줄의 코드로 연결할 수 있는 플러그인을 정의할 수 있습니다.
- Sentence Transformers
 - 문장, 단락 및 이미지의 밀집 벡터 표현을 쉽게 계산할 수 있습니다.
- SpaCy
 - Python 및 Cython 기반 고급 자연어 처리 라이브러리입니다.
- SWIFT
 - 딥러닝 모델 미세 조정을 위한 확장 가능한 경량 인프라입니다.
- Tensorflow Lingvo
 - 특히 시퀀스 모델에 중점을 둔 TensorFlow 신경망 구축 프레임워크입니다.
- Tensorflow Text
 - TensorFlow 2.0에서 바로 사용할 수 있는 텍스트 관련 클래스 및 연산 모음입니다.
- ToolBench
 - 도구 학습용 대규모 언어 모델의 학습·서빙·평가를 위한 개방형 플랫폼입니다.
- Transformers
 - 자연어 처리(NLP)를 위한 최첨단 사전 학습 모델 라이브러리입니다.
Industry Strength Recommender System
섹션 제목: “Industry Strength Recommender System”- EasyRec
 - 대규모 추천 알고리즘을 위한 프레임워크입니다.
- Gorse
 - 다양한 온라인 서비스에 빠르게 도입할 수 있는 범용 오픈 소스 추천 시스템을 지향합니다.
- Merlin
 - 특성 엔지니어링 및 전처리부터 딥러닝 모델 학습과 운영 환경 추론까지 종단 간 GPU 가속 추천 시스템을 제공하는 오픈 소스 라이브러리입니다.
- Recommenders
 - Jupyter 노트북으로 제공되는 추천 시스템 구축용 벤치마크 및 모범 사례 모음입니다.
- TorchRec
 - 대규모 추천 시스템(RecSys)에 필요한 공통 희소성 및 병렬 처리 기본 요소를 제공하기 위해 구축된 PyTorch 도메인 라이브러리입니다.
Industry Strength Reinforcement Learning
섹션 제목: “Industry Strength Reinforcement Learning”- Acme
 - 간단하고 효율적이며 읽기 쉬운 에이전트를 제공하는 데 중점을 둔 강화 학습(RL) 구성 요소 라이브러리입니다.
- AReaL
 - 강화 학습 라이브러리입니다.
- ChatLearn
 - FSDP2 및 Megatron 분산 학습 엔진과 vLLM 및 SGLang 추론 엔진을 지원하며 GRPO, GSPO 등 최신 RL 알고리즘을 제공하는 유연하고 효율적인 대규모 언어 모델 강화 학습 프레임워크입니다.
- CleanRL
 - 연구에 적합한 고품질 단일 파일 구현을 제공하는 심층 강화 학습 라이브러리입니다. 구현은 깔끔하고 단순하지만 AWS Batch를 사용해 수천 개의 실험을 확장 실행할 수 있습니다.
- d3rlpy
 - 실무자와 연구자를 위한 오프라인 심층 강화 학습 라이브러리입니다.
- D4RL
 - 오프라인 강화 학습을 위한 오픈 소스 벤치마크입니다.
- Dopamine
 - 강화 학습 알고리즘을 빠르게 프로토타이핑하기 위한 연구 프레임워크입니다. 사용자가 파격적인 아이디어를 자유롭게 실험할 수 있는 작고 쉽게 이해되는 코드베이스(탐색적 연구)에 대한 요구를 충족하는 것이 목표입니다.
- EvoTorch
 - NNAISENSE가 개발하고 PyTorch를 기반으로 구축한 오픈 소스 진화 연산 라이브러리입니다.
- FinRL
 - 금융 강화 학습의 큰 가능성을 보여 준 최초의 오픈 소스 프레임워크입니다.
- Gymnasium
 - 학습 알고리즘과 환경이 통신하는 표준 API와 해당 API를 준수하는 표준 환경 모음을 제공하는 강화 학습 알고리즘 개발 및 비교용 오픈 소스 Python 라이브러리입니다.
- Gymnasium-Robotics
 - Gymnasium API를 사용하는 강화 학습 로봇 환경 모음입니다. 환경은 MuJoCo 물리 엔진과 유지 관리되는 mujoco Python 바인딩으로 실행됩니다.
- Jumanji
 - 산업 주도 연구를 위해 깔끔한 하드웨어 가속 환경을 제공하는 JAX 기반 강화 학습 환경 모음입니다.
- MARLlib
 - RLlib 기반의 종합적인 다중 에이전트 강화 학습 알고리즘 라이브러리입니다. MARL 연구 커뮤니티에 알고리즘을 구축·학습·평가하는 통합 플랫폼을 제공합니다.
- Mava
 - JAX에서 분산 다중 에이전트 강화 학습을 위한 프레임워크입니다.
- Melting Pot - 다중 에이전트 강화 학습용 테스트 시나리오 모음입니다.
- MetaDrive
 - 일반화 가능한 RL을 위해 다양한 주행 시나리오를 조합하는 운전 시뮬레이터입니다.
- Minigrid
 - 강화 학습 연구를 위한 이산 그리드월드 환경 모음입니다. 환경은 Gymnasium 표준 API를 따르며 경량·고속이고 쉽게 사용자 지정할 수 있도록 설계되었습니다.
- MiniWorld
 - 강화 학습 및 로봇 공학 연구용 미니멀 3D 실내 환경 시뮬레이터입니다.
- ML-Agents
 - 게임 및 시뮬레이션을 강화 학습 지능형 에이전트 학습 환경으로 활용할 수 있는 오픈 소스 프로젝트입니다.
- MushroomRL
 - 모듈성 덕분에 텐서 계산용 유명 Python 라이브러리(PyTorch, TensorFlow 등)와 RL 벤치마크(OpenAI Gym, PyBullet, DeepMind Control Suite 등)를 쉽게 사용할 수 있는 Python 강화 학습 라이브러리입니다.
- OmniSafe
 - 안전한 강화 학습(RL) 연구를 가속하도록 설계된 기반 프레임워크입니다.
- OpenRLHF
 - 인간 피드백 기반 강화 학습(RLHF)을 위한 오픈 소스 프레임워크입니다.
- PARL
 - 유연하고 효율성이 높은 강화 학습 프레임워크입니다.
- PettingZoo
 - Gymnasium의 다중 에이전트 버전과 유사한 다중 에이전트 강화 학습 연구용 Python 라이브러리입니다.
- ranx
 - 고속 벡터 연산 및 자동 병렬화를 위해 Numba를 활용해 Python으로 구현한 빠른 순위 평가 지표 라이브러리입니다.
- RL4CO
 - 조합 최적화(CO)를 위한 모든 강화 학습 기능을 제공하는 PyTorch 라이브러리입니다.
- RL2
 - 강화 학습 라이브러리입니다.
- RLinf
 - 강화 학습 라이브러리입니다.
- ROLL
 - 강화 학습 라이브러리입니다.
- skrl
 - 알고리즘 구현의 가독성·단순성·투명성에 중점을 두고 PyTorch로 작성된 모듈형 오픈 소스 강화 학습 라이브러리입니다.
- SkyRL
 - 모듈형 학습 프레임워크, 크로스 플랫폼 추론 백엔드, 에이전트 파이프라인 및 장기 실세계 RL 작업용 Gymnasium 환경을 제공하는 풀스택 강화 학습 라이브러리입니다.
- slime
 - RL 스케일링을 위한 LLM 사후 학습 프레임워크입니다.
- Stable Baselines
 - OpenAI Baselines의 포크로 강화 학습 알고리즘을 구현합니다.
- TF-Agents
 - 문맥형 밴딧 및 강화 학습을 위한 안정적이고 확장 가능하며 사용하기 쉬운 TensorFlow 라이브러리입니다.
- TorchRL
 - PyTorch용 오픈 소스 강화 학습(RL) 라이브러리입니다.
- TRL
 - 강화 학습으로 트랜스포머 언어 모델을 학습합니다.
- veRL
 - LLM을 위해 설계된 유연하고 효율적이며 산업 수준의 RL(HF) 학습 프레임워크입니다.
Industry Strength Robotics
섹션 제목: “Industry Strength Robotics”- AI2-THOR
 - AI 에이전트를 위한 실사에 가까운 상호작용형 프레임워크입니다.
- Genesis
 - 체화형 AI 및 로봇 시뮬레이션을 위한 물리 플랫폼입니다.
- Habitat-Sim
 - 체화형 AI 연구를 위한 유연하고 고성능인 3D 시뮬레이터입니다.
- IsaacLab
 - NVIDIA Isaac Sim을 활용하는 통합 모듈형 로봇 학습 프레임워크입니다.
- LeRobot
 - 실제 로봇 공학 및 모방 학습을 위한 모델, 데이터셋, 도구를 제공합니다.
- robosuite
 - 로봇 학습을 위한 MuJoCo 물리 엔진 기반 시뮬레이션 프레임워크입니다.
- RoboVerse
 - 다양한 환경을 갖춘 종합 로봇 시뮬레이션 플랫폼입니다.
Industry Strength Visualisation
섹션 제목: “Industry Strength Visualisation”- Apache ECharts
 - 브라우저용 강력한 대화형 차트 및 데이터 시각화 라이브러리입니다.
- Apache Superset
 - 현대적이며 엔터프라이즈 환경에 적합한 비즈니스 인텔리전스 웹 애플리케이션입니다.
- Bokeh
 - 최신 웹 브라우저에서 아름답고 의미 있는 데이터를 시각적으로 표현하는 Python 대화형 시각화 라이브러리입니다.
- Bread Dataset Viewer - IDE 충돌 없이 편집기 내에서 CSV, JSON, Parquet 등의 대규모 머신러닝 데이터셋을 직접 보고 탐색하는 VS Code 확장 기능입니다.
- Bread WandB Viewer - Weights & Biases 실험, 로그 및 아티팩트를 IDE에서 확인하는 VS Code 확장 기능입니다. 웹 UI로 전환할 필요가 없으며 완전히 오프라인으로 작동해 데이터 개인정보를 보호합니다.
- Data Formulator
 - AI와 반복적으로 데이터를 변환하고 풍부한 시각화를 만듭니다.
- ggplot2
 - R용 그래픽 문법 구현입니다.
- gradio
 - Python만 작성해 모델 데모를 빠르게 만들고 공유할 수 있습니다. 브라우저에서 대화형으로 모델을 디버그하고 협업자의 피드백을 받으며 배포하지 않고도 공개 링크를 생성할 수 있습니다.
- Kangas
 - 대규모 멀티미디어 데이터를 탐색·분석·시각화하는 도구입니다. 대규모 데이터 테이블을 기록하는 간단한 Python API와 데이터셋을 대상으로 복잡한 쿼리를 수행하는 직관적인 시각 인터페이스를 제공합니다.
- matplotlib
 - 다양한 플랫폼의 여러 인쇄 형식과 대화형 환경에서 출판 품질의 그림을 생성하는 Python 2D 플로팅 라이브러리입니다.
- Model Explorer
 - 모델 구조를 이해하고 계층 세부 정보를 살펴보며 대규모 신경망을 탐색하도록 직관적인 그래프 기반 뷰를 제공하는 머신러닝 모델 시각화 및 탐색 도구입니다.
- Netron
 - 신경망, 딥러닝 및 머신러닝 모델 뷰어입니다.
- Perspective
 WebAssembly 기반 스트리밍 피벗 시각화입니다.
- Plotly
 - Python용 대화형 오픈 소스 브라우저 기반 그래프 작성 라이브러리입니다.
- Redash
 - 여러 백엔드를 활용해 대규모 데이터셋에 쉽게 접근할 수 있도록 설계된 오픈 소스 시각화 프레임워크입니다.
- Rerun
 - 로봇 공학, 컴퓨터 비전 및 공간 AI를 위해 설계된 멀티모달 데이터를 로깅·저장·쿼리·시각화하는 오픈 소스 SDK입니다.
- seaborn
 - matplotlib 기반 Python 시각화 라이브러리로, 매력적인 통계 그래픽을 그리는 고수준 인터페이스를 제공합니다.
- Spotlight
 - 중요한 데이터 세그먼트와 모델 실패 유형을 식별하는 데 도움을 줍니다. 고품질 데이터셋을 선별해 신뢰할 수 있는 머신러닝 모델을 구축하고 유지할 수 있습니다.
- Streamlit
 - 간단한 Python 스크립트로 머신러닝 프로젝트용 앱을 만듭니다. 핫 리로딩을 지원해 파일을 편집하고 저장하면 앱이 실시간으로 업데이트됩니다.
- tensorboardX
 - 간단한 함수 호출로 TensorBoard 이벤트를 기록합니다.
- TensorBoard
 - 머신러닝 실험의 호스팅, 추적 및 공유를 쉽게 해 주는 시각화 툴킷입니다.
- Torchvista
 - 노트북 내에서 PyTorch 모델의 순전파를 계산 그래프로 시각화하는 대화형 노트북 기반 도구입니다. 접을 수 있는 중첩 모듈과 오류를 견디는 부분 시각화를 지원합니다.
- Transformer Explainer
 - GPT와 같은 트랜스포머 기반 모델의 작동 방식을 누구나 학습할 수 있도록 설계된 대화형 시각화 도구입니다.
- Vega-Altair
 - Python 선언형 통계 시각화 라이브러리입니다.
- ydata-profiling
 - 일관되고 빠른 솔루션으로 한 줄만 사용해 탐색적 데이터 분석(EDA)을 수행할 수 있게 합니다.
Metadata Management
섹션 제목: “Metadata Management”- Apache Atlas
 - 기업이 Hadoop 내 규정 준수 요구 사항을 효과적이고 효율적으로 충족할 수 있도록 하며 기업 전체 데이터 생태계와 통합하는 확장 가능한 핵심 데이터 거버넌스 서비스 프레임워크입니다.
- DataHub
 - LinkedIn의 범용 메타데이터 검색 및 탐색 도구입니다.
- Marquez
 - 데이터 생태계 메타데이터의 수집·통합·시각화를 위한 오픈 소스 메타데이터 서비스입니다.
- Metacat
 - 통합 메타데이터 탐색 API 서비스입니다. 메타데이터 시스템의 연합 뷰, 임의의 데이터셋 메타데이터 저장, 메타데이터 검색 문제 해결에 중점을 둡니다.
- ML Metadata
 - ML 개발자 및 데이터 과학자 워크플로와 관련된 메타데이터를 기록하고 검색하는 라이브러리입니다.
Model, Data and Experiment Management
섹션 제목: “Model, Data and Experiment Management”- Aim
 - AI 실험을 기록·검색·비교하는 매우 쉬운 방법입니다.
- ClearML
 - AI를 위한 자동화된 실험 관리자 및 버전 제어 도구입니다(이전 명칭 Trains).
- DataHub - 현대적 데이터 스택을 위한 오픈 소스 데이터 카탈로그입니다.
- Dolt
 - Git 저장소처럼 포크, 복제, 브랜치, 병합, 푸시 및 풀을 수행할 수 있는 SQL 데이터베이스입니다.
- DVC
 - 모델 버전 관리를 지원하는 Git 포크인 DVC(Data Version Control)입니다.
- HuggingFace Model Downloader
 - Hugging Face 웹사이트에서 모델과 데이터셋을 내려받는 유틸리티 도구입니다. LFS 파일의 멀티스레드 다운로드와 SHA256 체크섬 검증으로 다운로드한 모델의 무결성을 보장합니다.
- Keepsake
 - 머신러닝용 버전 제어입니다.
- KitOps
 - 이미 사용하는 AI/ML, 개발 및 DevOps 도구와 함께 작동하는 개방형 표준 기반 AI/ML 프로젝트 패키징 및 버전 관리 시스템입니다.
- lakeFS
 - 객체 스토리지 위에서 반복 가능하고 원자적이며 버전 관리되는 데이터 레이크입니다.
- MLflow
 - 실험, 재현성 및 배포를 포함한 ML 생애주기 관리를 위한 오픈 소스 플랫폼입니다.
- Polyaxon
 - Kubernetes에서 재현 가능하고 확장 가능한 머신러닝 및 딥러닝을 위한 플랫폼입니다. (Video)
- Quilt
 - 데이터와 모델의 버전 관리, 재현성 및 배포를 지원합니다.
- Sacred
 - 머신러닝 실험의 구성·정리·로깅·재현을 돕는 도구입니다.
- TerminusDB
 - Git처럼 데이터를 저장하는 그래프 데이터베이스 관리 시스템입니다.
- Weights & Biases
 - 머신러닝 실험 추적, 데이터셋 버전 관리, 하이퍼파라미터 검색, 시각화 및 협업 도구입니다.
Model Training and Orchestration
섹션 제목: “Model Training and Orchestration”- AutoTrain Advanced
 - 몇 번의 클릭만으로 머신러닝 모델을 학습할 수 있는 코드 없는 솔루션입니다.
- Avalanche
 - 지속 학습 알고리즘의 빠른 프로토타이핑·학습·재현 가능한 평가를 위한 공동 협업 오픈 소스(MIT 라이선스) 코드베이스를 제공하는 종단 간 지속 학습 라이브러리입니다.
- Axolotl
 - 여러 구성과 아키텍처를 지원해 다양한 AI 모델의 미세 조정을 간소화하도록 설계된 도구입니다.
- BindsNET
 - 머신러닝용 생물학적 영감 알고리즘 개발에 초점을 둔 스파이킹 신경망 시뮬레이션 라이브러리입니다.
- CML
 - 머신러닝 프로젝트에서 지속적 통합 및 배포(CI/CD)를 구현하기 위한 오픈 소스 라이브러리입니다.
- CoreNet
 - 연구자와 엔지니어가 CLIP 및 LLM 같은 기반 모델, 객체 분류·탐지·시맨틱 분할 등 다양한 작업을 위한 표준 및 새로운 소규모·대규모 모델을 학습할 수 있는 심층 신경망 툴킷입니다.
- DataLinter
 - 플러그인을 통해 데이터와 코드에 종속되지 않도록 설계된 오픈 소스 데이터·코드 문맥 기반 린터입니다.
- Determined
 - 분산 학습, 하이퍼파라미터 튜닝 및 모델 관리를 통합 지원하는 딥러닝 학습 플랫폼입니다(TensorFlow 및 PyTorch 지원).
- dstack
 - 워크로드 오케스트레이션을 간소화하고 ML 팀의 GPU 활용률을 높이는 오픈 소스 컨테이너 오케스트레이터입니다.
- envd
 - 데이터 과학 및 AI/ML 엔지니어링 팀을 위한 머신러닝 개발 환경입니다.
- Fire-Flyer File System
 - AI 학습 및 추론 워크로드의 문제를 해결하도록 설계된 고성능 분산 파일 시스템입니다. 최신 SSD와 RDMA 네트워크를 활용해 분산 애플리케이션 개발을 간소화하는 공유 스토리지 계층을 제공합니다.
- H2O-3
 - 딥러닝, 그래디언트 부스팅 및 XGBoost, Random Forest, 일반화 선형 모델(로지스틱 회귀, Elastic Net), K-Means, PCA, Stacked Ensembles, AutoML 등을 갖춘 빠르고 확장 가능한 머신러닝 플랫폼입니다.
- Hopsworks
 - 머신러닝 파이프라인의 설계와 운영을 위한 데이터 집약적 플랫폼입니다.
- Ignite
 - PyTorch에서 신경망을 유연하고 투명하게 학습 및 평가할 수 있도록 돕는 고수준 라이브러리입니다.
- Kubeflow
 - Google의 내부 머신러닝 파이프라인을 기반으로 한 클라우드 네이티브 머신러닝 플랫폼입니다.
- Ludwig
 - LLM 및 기타 심층 신경망과 같은 맞춤형 AI 모델을 구축하는 로우코드 프레임워크입니다.
- MFTCoder
 - LLM, 특히 코드 작업용 언어 모델인 Code-LLM의 정확하고 효율적인 다중 작업 미세 조정(MFT)을 위한 CodeFuse 오픈 소스 프로젝트입니다.
- MLeap
 - Spark, TensorFlow 및 sklearn을 위한 파이프라인 및 모델 직렬화 표준화입니다.
- Nanotron
 - 3D 병렬화를 사용해 다양한 모델을 효율적으로 학습하는 분산 기본 요소를 제공합니다.
- NeMo
 - 대규모 언어 모델(LLM), 멀티모달 모델(MM), 자동 음성 인식(ASR), 음성 합성(TTS), 컴퓨터 비전(CV) 분야의 연구자 및 PyTorch 개발자를 위해 구축된 확장 가능한 클라우드 네이티브 생성형 AI 프레임워크입니다. 기존 코드와 사전 학습 모델 체크포인트를 활용해 새 생성형 AI 모델을 효율적으로 생성·사용자 지정·배포하도록 설계되었습니다.
- Prime
 - 인터넷을 통해 전 세계에 분산된 AI 모델 학습을 효율적으로 수행하는 프레임워크입니다.
- PyCaret
 ) - scikit-learn, XGBoost, LightGBM, spaCy 등의 모델을 학습하고 배포하는 로우코드 라이브러리입니다.
- Sematic
 - 간단한 Python으로 리소스 집약적 파이프라인을 구축하는 플랫폼입니다.
- Skaffold
 - Kubernetes 애플리케이션의 지속적 개발을 지원하는 명령줄 도구입니다. 애플리케이션 소스 코드를 로컬에서 반복 수정한 다음 로컬 또는 원격 Kubernetes 클러스터에 배포할 수 있습니다.
- TFX
 - 모니터링 및 모델 버전 관리를 포함하는 TensorFlow 기반 운영 환경 지향 ML 구성 프레임워크입니다.
- unsloth
 - LLM을 위한 미세 조정 및 강화 학습입니다. OpenAI gpt-oss, DeepSeek-R1, Qwen3, Gemma 3를 학습하고 TTS를 VRAM 70% 적게 사용하면서 2배 빠르게 실행합니다.
Model Storage Optimisation
섹션 제목: “Model Storage Optimisation”- AWQ
 - LLM 압축 및 가속을 위한 활성화 인식 가중치 양자화입니다.
- GGML
 - 특히 대규모 언어 모델에 최적화된 CPU 효율적 추론을 지원하는 고성능 머신러닝 텐서 라이브러리입니다.
- neural-compressor
 - 주요 프레임워크에서 양자화, 가지치기(희소성), 증류 및 신경망 아키텍처 검색 등 널리 쓰이는 모델 압축 기법을 제공합니다.
- NNEF - Neural Network Exchange Format(NNEF)은 서로 다른 머신러닝 프레임워크와 플랫폼 간 상호 운용성 및 이식성을 지원하는 신경망 모델 표현용 개방형 표준입니다.
- ONNX
 - ONNX(Open Neural Network Exchange)는 서로 다른 프레임워크 및 플랫폼 간 머신러닝 모델의 상호 운용성과 이식성을 촉진하도록 설계된 오픈 소스 형식입니다.
- PFA - PFA(Portable Format for Analytics)는 이식 가능한 JSON 기반 형식으로 예측 모델과 분석 워크플로를 표현하고 교환하는 표준입니다.
- PMML - PMML(Predictive Model Markup Language)은 서로 다른 애플리케이션 간 예측 모델을 표현하고 공유하는 XML 기반 표준입니다.
- Quanto
 - 딥러닝 모델의 양자화를 간소화하는 것을 목표로 합니다.
Privacy and Safety
섹션 제목: “Privacy and Safety”- AI Gateway
 - 가드레일이 통합된 매우 빠른 AI 게이트웨이입니다.
- ART
 - 회피·오염·추출·추론 위협으로부터 머신러닝 모델 및 애플리케이션을 방어하고 평가할 수 있는 도구를 개발자와 연구자에게 제공합니다.
- CipherChat
 - LLM 안전 정렬의 일반화 능력을 평가하는 프레임워크입니다.
- DeepTeam
 - 대규모 언어 모델 시스템의 침투 테스트 및 보호를 위한 사용하기 쉬운 오픈 소스 LLM 레드팀 프레임워크입니다.
- FATE
 - 기업과 기관이 데이터 보안 및 개인정보를 보호하면서 협업하도록 지원하는 세계 최초의 산업용 연합 학습 오픈 소스 프레임워크입니다.
- FedML
 - 어디서나 어떤 규모로든 연합/분산 머신러닝을 수행할 수 있는 연구 및 운영 통합 엣지-클라우드 플랫폼을 제공합니다.
- Flower
 - 통합된 접근 방식을 갖춘 연합 학습 프레임워크입니다. 모든 ML 워크로드, 프레임워크 및 프로그래밍 언어의 연합 학습을 지원합니다.
- Google’s Differential Privacy
 - 개인정보 또는 민감한 정보가 포함된 숫자 데이터셋의 집계 통계를 생성하는 데 사용할 수 있는 ε-차등 개인정보 보호 알고리즘을 제공하는 C++ 라이브러리입니다.
- Guardrails
 - 대규모 언어 모델의 출력에 구조·유형·품질 보장을 추가하는 패키지입니다.
- NeMo Guardrails
 - LLM 기반 대화형 시스템에 프로그래밍 가능한 가드레일을 쉽게 추가하는 오픈 소스 툴킷입니다.
- Opacus
 - 차등 개인정보 보호를 적용해 PyTorch 모델을 학습할 수 있는 라이브러리입니다. 클라이언트 코드 변경을 최소화하고 학습 성능에 미치는 영향이 적으며, 사용한 개인정보 보호 예산을 실시간으로 추적할 수 있습니다.
- OpenFL
 - 연합 학습을 위한 Python 프레임워크입니다. 데이터 과학자를 위해 유연하고 확장 가능하며 배우기 쉬운 도구로 설계되었으며 Intel Internet of Things Group(IOTG) 및 Intel Labs가 개발했습니다.
- PySyft
 - PyTorch 내 다자간 계산(MPC)을 사용해 비공개 데이터를 모델 학습과 분리하는 안전하고 비공개적인 딥러닝용 Python 라이브러리입니다.
- Tensorflow Privacy
 - 차등 개인정보 보호를 적용해 머신러닝 모델을 학습하는 TensorFlow 옵티마이저 구현을 포함한 Python 라이브러리입니다.
- TF Encrypted
 - TensorFlow에서 암호화된 데이터를 이용하는 기밀 머신러닝 프레임워크입니다.
Other Awesome Lists
섹션 제목: “Other Awesome Lists”- Awesome Agentic Engineering Resources
 - 에이전트형 AI 시스템 구축을 위한 자료, 도구 및 참고 자료를 선별해 모은 컬렉션입니다.
- Awesome AI Gateway
 - 비용, 규정 준수, 자체 호스팅, 라우팅 기준으로 AI 게이트웨이 및 LLM 프록시(LiteLLM, OpenRouter, Portkey, Kong, Higress, new-api)를 비교하는 선별된 영중문 목록입니다. 의사결정 트리, 재현 가능한 비용 벤치마크 및 선택 점수표를 포함합니다.
- Awesome AI Regulation
 - 다양한 관할권에서 책임 있는 ML 시스템 배포에 필수적인 거버넌스, 규정 준수 및 규제 프레임워크를 다룹니다.
- Awesome AI Tokenomics
 - 모니터링, 최적화, 캐싱, 모델 선택 및 컨텍스트 관리를 포함해 AI 시스템의 토큰 비용과 효율성을 다룹니다.
- Awesome Production GenAI
 - LLM 운영, 프롬프트 엔지니어링, 생성형 AI 전용 모니터링 및 안전 도구를 포함한 생성형 AI 배포에 특히 중점을 둡니다.
- Awesome RAG Production
 - 확장 가능한 RAG 시스템 구축을 위한 운영 환경급 도구 및 모범 사례를 선별한 목록입니다.
Contributors
섹션 제목: “Contributors”HagiCode
HagiCode는 에이전트 코딩 작업 공간입니다. 풍부하고 편리한 UI 상호작용으로 계획 수립, 에이전트 실행, 프로젝트 작업을 쉽게 시작하고 따라가며 개발을 더 흥미로운 경험으로 만듭니다.
풍부하고 편리한 UI 상호작용으로 계획부터 프로젝트 작업까지 쉽게 따라갈 수 있습니다.

- 스마트OpenSpec 워크플로는 의도를 제안, 설계, 작업을 거쳐 배포까지 이어지는 실행 가능한 경로로 바꿉니다.
- 효율적다중 에이전트 실행으로 조사, 구현, 검토를 병렬로 진행하며 여러 저장소와 익숙한 Agent CLI를 지원합니다.
- 흥미로운풍부하고 편리한 UI 상호작용으로 계획 수립, 에이전트 실행, 프로젝트 작업을 쉽게 시작하고 따라갈 수 있습니다.
Windows용 다운로드
HagiCode 공유

아이디어를 실제로 배포되는 소프트웨어로.
HagiCode는 에이전트 코딩 작업 공간입니다. OpenSpec 워크플로로 변경을 계획하고, 다중 에이전트 실행으로 진행하며, Hero Scenario로 긴 작업의 진행 상황을 한눈에 보여 아이디어를 실제로 배포되는 소프트웨어로 만듭니다.
- 스마트
- OpenSpec 워크플로는 의도를 제안부터 배포까지 이어지는 실행 가능한 경로로 바꿉니다.
- 효율적
- 다중 에이전트 실행으로 조사, 구현, 검토를 병렬로 진행합니다.
- 즐거운
- 편리한 UI 상호작용으로 계획, 에이전트 실행, 프로젝트 작업을 쉽게 따라갈 수 있습니다.
© 2026 HagiCode | Powered By hagilight-starlight@0.21.0 | Branch: main | Commit: 745b50b | Built: