
Chinese NLP
Source: https://github.com/crownpku/Awesome-Chinese-NLP at
923e20ae6872
License: Apache-2.0
Read the English original
This edition is an AI-assisted translation.
Chinese NLP
섹션 제목: “Chinese NLP”
중국어 자연어 처리(NLP)를 위한 엄선된 자료 목록.
중국어 자연어 처리 관련 자료
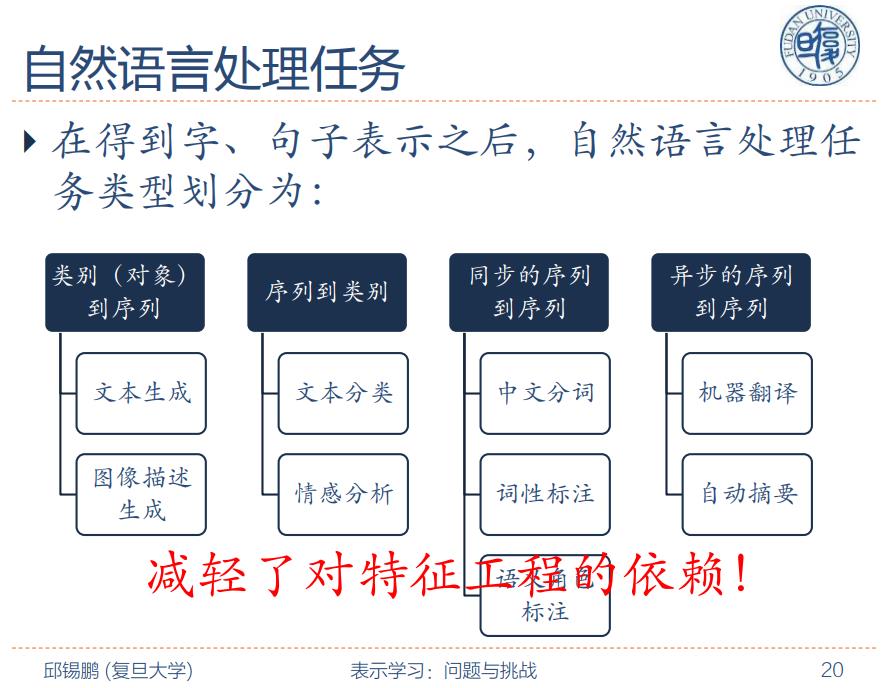
이미지는 푸단대학 척희붕 교수가 제공함
목차 Contents
섹션 제목: “목차 Contents”중국어 NLP 도구 Chinese NLP Toolkits
섹션 제목: “중국어 NLP 도구 Chinese NLP Toolkits”종합 NLP 도구 모음 Toolkits
섹션 제목: “종합 NLP 도구 모음 Toolkits”-
THULAC 中文词法分析工具包 by 清华 (C++/Java/Python)
-
NLPIR by 中科院 (Java)
-
LTP 语言技术平台 by 哈工大 (C++) pylyp LTP의 Python 래퍼
-
FudanNLP by 复旦 (Java)
-
BaiduLac by 百度 Baidu의 오픈소스 중국어 형태소 분석 도구. 단어 분절, 품사 태깅, 개체명 인식을 포함.
-
HanLP (Java)
-
FastNLP (Python) 가벼운 NLP 처리 패키지.
-
SnowNLP (Python) 중국어 텍스트를 처리하는 Python 라이브러리
-
YaYaNLP (Python) 순수 Python으로 작성된 중국어 자연어 처리 패키지. 「아아 학어(배우기)」에서 이름을 딴 것
-
小明NLP (Python) 가벼운 중국어 자연어 처리 도구
-
DeepNLP (Python) Tensorflow 위에 구현된, 중국어 사전학습 모델을 갖춘 딥러닝 NLP 파이프라인.
-
chinese_nlp (C++ & Python) 중국어 자연어 처리 도구와 예제
-
lightNLP (Python) Pytorch와 torchtext 기반 자연어 처리 딥러닝 프레임워크
-
Chinese-Annotator (Python) 중국어 텍스트 주석 도구 Annotator for Chinese Text Corpus
-
Poplar (Typescript) 자연어 처리(NLP)를 위한 웹 기반 주석 도구
-
Jiagu (Python) Jiagu는 BiLSTM 등 모델을 기반으로 대규모 말뭉치로 학습됨. 중국어 분절, 품사 태깅, 개체명 인식, 감성 분석, 지식 그래프 관계 추출, 키워드 추출, 텍스트 요약, 신어 발견 등을 제공.
-
SmoothNLP (Python & Java) 해석 가능한 NLP 기술에 중점
-
FoolNLTK (Python & Java) 중국어 자연어 도구 모음 A Chinese Nature Language Toolkit
일반적인 영어 또는 다국어 NLP 도구 모음 Popular NLP Toolkits for English/Multi-Language
섹션 제목: “일반적인 영어 또는 다국어 NLP 도구 모음 Popular NLP Toolkits for English/Multi-Language”-
CoreNLP by Stanford (Java) 핵심 NLP 도구의 Java 모음.
-
Stanza by Stanford (Python) 여러 인간 언어를 위한 Python NLP 라이브러리
-
NLTK (Python) Natural Language Toolkit
-
textacy (Python) spaCy 전후에 쓰이는 NLP
-
OpenNLP (Java) 기계 학습 기반 자연어 텍스트 처리 도구 모음.
-
gensim (Python) Gensim은 토픽 모델링, 문서 인덱싱, 대규모 말뭉치 유사도 검색을 위한 Python 라이브러리.
-
Kashgari - 간단하고 강력한 NLP 프레임워크. 5분 만에 개체명 인식(NER), 품사 태깅(PoS), 텍스트 분류용 최신 모델을 구축. BERT와 word2vec 포함.
중국어 단어 분절 Chinese Word Segment
섹션 제목: “중국어 단어 분절 Chinese Word Segment”-
Jieba 结巴中文分词 (Python 및 다수의 다른 언어 파생) 최고의 Python 중국어 분절 컴포넌트
-
北大中文分词工具 (Python) 고정밀 중국어 분절 도구. 사용이 쉽고 기존 오픈소스 대비 분절 정확도를 크게 향상.
-
kcws 深度学习中文分词 (Python) BiLSTM+CRF 및 IDCNN+CRF
-
ID-CNN-CWS (Python) 중국어 단어 분절을 위한 반복 팽창 합성곱 Iterated Dilated Convolutions for Chinese Word Segmentation
-
Genius 中文分词 (Python) Genius는 CRF(조건부 무작위 장) 알고리즘을 사용하는 오픈소스 Python 중국어 분절 컴포넌트.
-
loso 中文分词 (Python)
-
yaha “哑哈”中文分词 (Python)
-
ChineseWordSegmentation (Python) 말뭉치가 필요 없는 중국어 분절 알고리즘 Chinese word segmentation algorithm without corpus
-
Go 언어 고성능 분절 (Go) 효율적인 Go 텍스트 분절. 영어, 중국어, 일본어 등 지원.
-
Ansj中文分词 (java) n-Gram+CRF+HMM 기반 중국어 분절의 Java 구현
정보 추출 Information Extraction
섹션 제목: “정보 추출 Information Extraction”-
MITIE (C++) 정보 추출을 위한 라이브러리와 도구
-
Duckling (Haskell) 입력 문자열에 대해 조합 가능한 언어 규칙을 표현·테스트·평가하기 위한 언어, 엔진, 도구.
-
IEPY (Python) IEPY는 관계 추출에 중점을 둔 오픈소스 정보 추출 도구.
-
Snorkel 정보 추출에 중점을 둔 학습 데이터 생성 및 관리 시스템
-
bert-chinese-ner 사전학습 언어 모델 BERT로 중국어 NER 수행
-
Information-Extraction-Chinese IDCNN/biLSTM+CRF로 중국어 개체명 인식, biGRU+2ATT로 관계 추출 中文实体识别与关系提取
-
Familia Baidu 제작의 A Toolkit for Industrial Topic Modeling
-
Text Classification 딥러닝 기반 다양한 텍스트 분류 모델 등. 테스트 데이터로 Zhihu Q&A 말뭉치 사용.
-
ComplexEventExtraction 중국어 복합 사건의 개념과 명시적 패턴. 조건·인과·연속·반전 사건 등의 추출과 사건 그래프 구축.
-
TextRank4ZH 중국어 텍스트에서 키워드와 요약을 자동 추출
질의응답 및 챗봇 QA & Chatbot
섹션 제목: “질의응답 및 챗봇 QA & Chatbot”-
Rasa NLU (Python) 자연어를 구조화된 데이터로 변환. 중국어 포크는 Rasa NLU Chi
-
Rasa Core (Python) 대화형 소프트웨어를 위한 기계 학습 기반 대화 엔진
-
Chatstack 중국어 NLU 시스템 구축을 위한 전체 파이프라인 UI
-
Snips NLU (Python) Snips NLU는 자연어 문장을 구문 분석하고 구조화된 정보를 추출하는 Python 라이브러리.
-
DeepPavlov (Python) 엔드투엔드 대화 시스템 구축과 챗봇 학습을 위한 오픈소스 라이브러리.
-
ChatScript 자연어 도구/대화 관리자. 규칙 기반 챗봇 엔진.
-
Chatterbot (Python) ChatterBot은 챗봇 생성을 위한 기계 학습 대화 엔진.
-
Chatbot (Python) 벡터 매칭 기반 상황형 챗봇
-
Tipask (PHP) Laravel 기반 오픈소스 PHP 질의응답 시스템. 확장 쉽고 높은 부하能力与 안정성.
-
QuestionAnsweringSystem (Java) 질문을 자동 분석해 후보 답을 제시하는 Java 기반 인간-기계 질의응답 시스템.
-
QA-Snake (Python) 여러 검색 엔진과 딥러닝 기술에 기반한 자동 질의응답
-
딥러닝으로 구현한 중국어 독해 질의응답 시스템 (Python)
-
AnyQ by Baidu FAQ 모음 대상 질의응답 시스템 프레임워크와 텍스트 의미 일치 도구 SimNet을 중심으로 포함.
-
DuReader 중국어 독해 Baseline 코드 (Python)
-
SmartQQ 기반 자동 봇 프레임워크 (Python)
-
QASystemOnMedicalKG (Python) 질병 중심의 일정 규모 의료 지식 그래프로 자동 질의응답과 분석 서비스 제공.
-
GPT2-chitchat (Python) 중국어 잡담용 GPT2 모델
-
CDial-GPT (Python) 대규모 중국어 대화 데이터세트와 그 위의 중국어 대화 사전학습 모델(중국어 GPT 모델) 제공
다중 모달 표현 및 검색 Multi-Modal Representation & Retrieval
섹션 제목: “다중 모달 표현 및 검색 Multi-Modal Representation & Retrieval”- Chinese-CLIP (Python) Chinese-CLIP은 중국어 다중 모달 이미지-텍스트 표현 사전학습 모델. OpenAI의 CLIP 구조 기반으로 대규모 중국어 네이티브 이미지-텍스트 말뭉치로 사전학습. 여러 모델 규모를 오픈소스화하고 기술 보고서와 검색 데모 공개.
중국어 말뭉치 Corpus
섹션 제목: “중국어 말뭉치 Corpus”-
농업 지식 그래프 농업 분야 정보 검색, 개체명 인식, 관계 추출, 분류 트리 구축, 데이터 마이닝
-
서로 다른 말뭉치·모델(BERT, GPT 등) 기반 중국어 사전학습 모델 서로 다른 말뭉치·인코더·작업을 지원하는 중국어 사전학습 모델 프레임워크(from RUC and Tencent)
-
OpenCLaP 다분야 오픈소스 중국어 사전학습 언어 모델 저장소(from Tsinghua)
-
UDChinese (spaCy PoS 학습용)
-
Tencent AI Lab Embedding Corpus for Chinese Words and Phrases
-
중국어 GPT2 학습 코드 시, 뉴스, 소설 작성이나 일반 언어 모델 학습 가능.
-
중국어 언어 이해 벤치마크 ChineseGLUE 대표 데이터세트, 기준(사전학습) 모델, 말뭉치, 리더보드 포함.
-
중화 신화 사전 데이터베이스 속담, 성어, 단어, 한자 포함.
-
Synonyms: 중국어 유의어 도구 모음 중국어 Wikipedia와 word2vec으로 학습한 유의어 라이브러리를 Python 패키지로 포장.
-
Chinese_conversation_sentiment 감성 분석에 유용한 중국어 감성 데이터세트.
-
중국어 긴급 상황 말뭉치 Chinese Emergency Corpus
-
dgk_lost_conv 중국어 대화 말뭉치 chinese conversation corpus
-
중영 대화 시스템 학습용 말뭉치 Datasets for Training Chatbot System
-
중국 주식 공시 정보 크롤러 Python 스크립트로 거창 네트워크 서버에서 중국 주식(sz, sh) 공시(상장사 및 규제 기관) 수집
-
tushare 금융 데이터 인터페이스 TuShare는 무료 오픈소스 Python 금융 데이터 인터페이스 패키지.
-
금융 텍스트 데이터세트 SmoothNLP 金融文本数据集(公开) Public Financial Datasets for NLP Researches
-
보험 업계 말뭉치 [52nlp 소개 Blog] 기계 학습 작업용 보험 분야 공개 데이터 OpenData in insurance area for Machine Learning Tasks
-
가장 완전한 중화 고대 시사 데이터베이스 당·송 양대 약 14000명의 시인, 약 5.5만 수의 당시와 26만 수의 송시. 송대 1564명의 사(詞) 작자, 21050수의 사.
-
중국어 소규모 말뭉치 중국어 개체명 인식, 관계 인식, 독해 등 소량 데이터 포함
-
Chinese-Literature-NER-RE-Dataset 중국어 문학 텍스트용 담화 수준 개체명 인식 및 관계 추출 데이터세트 A Discourse-Level Named Entity Recognition and Relation Extraction Dataset for Chinese Literature Text
-
ChineseTextualInference 중국어 텍스트 함의 프로젝트. 88만 쌍의 텍스트 함의 데이터세트 번역·구축과 딥러닝 기반 함의 판정 모델 구축 포함.
-
대규모 중국어 자연어 처리 말뭉치 Wikipedia (wiki2019zh), 뉴스 (news2016zh), 백과 Q&A (baike2018qa)
-
중국어 인명 말뭉치 중국어 성명, 성, 이름, 호칭, 일본인명, 번역인명, 영문명.
-
기업명·기관명 말뭉치 기업 약칭, 약어, 브랜드어, 기업명.
-
중국어 금지어 사전 금지어 필터 여러 구현 + 약 1만 단어 금지어 사전
-
중국어 약어 데이터세트 부정 완전형을 포함한 중국어 약어 말뭉치 A corpus of Chinese abbreviation, including negative full forms.
-
중국어 데이터 전처리 자료 중국어 분절 사전과 중국어 불용어
-
SentiBridge: 중국어 개체 감성 지식 베이스 사람들이 개체를 어떻게 묘사하는지 기술. 뉴스, 여행, 요식 포함 총 30만 쌍.
-
OpenCorpus 자유롭게 이용 가능한 (중국어) 말뭉치 모음.
-
ChineseNlpCorpus 감성/의견/댓글 경향 분석, 중국어 개체명 인식, 추천 시스템
-
FinancialDatasets SmoothNLP 金融文本数据集(公开) Public Financial Datasets for NLP Researches Only
-
People’s Daily & Children’s Fairy Tale PD&CFT: 중국어 독해 데이터세트 A Chinese Reading Comprehension Dataset
중국어 NLP 학술 기관 및 대회 Organizations
섹션 제목: “중국어 NLP 학술 기관 및 대회 Organizations”-
NLP Conference Calender NLP 커뮤니티의 주요 학회, 저널, 워크숍, 공유 작업.
-
2017 AI-Challenger 이미지 중국어 설명 주어진 이미지의 주요 정보를 한 문장으로 설명, 중국어 문맥에서의 이미지 이해 과제.
-
2017 AI-Challenger 영중 기계 텍스트 번역 대규모 데이터로 영중 텍스트 기계 번역 모델 능력 향상.
-
2017 Zhihu Kanshan Cup 기계 학습 챌린지 Zhihu의 질문과 토픽 태그 연결 학습 데이터로 미라벨 데이터 자동 태깅 모델 학습.
-
2018 개방 도메인 중국어 질의응답 작업 주어진 중국어 질문에 대해 시스템이 지식 베이스에서 실체나 속성값을 답으로 선택.
-
2018 WeBank 지능형 고객센터 문장 매칭 대회 중국어 실제 고객센터 말뭉치 대상 의도 매칭. 두 문장이 주어지면 의도 유사 여부 판정.
중국어 NLP 상용 서비스 Industry
섹션 제목: “중국어 NLP 상용 서비스 Industry”-
화웨이 클라우드 NLP 기업 및 개발자를 위한 텍스트 분석·마이닝 클라우드 서비스. 텍스트를 효율적으로 처리.
-
바이두 클라우드 NLP 업계 선도적 자연어 처리 기술, 고품질 텍스트 처리 및 이해 기술 제공
-
알리바바 클라우드 NLP 기업 및 개발자를 위한 텍스트 분석·마이닝 핵심 도구
-
텐센트 클라우드 NLP 병렬 계산과 분산 크롤러에 고유 의미 분석 기술을 결합, NLP·트랜스코딩·추출·데이터 수집 일괄 충족
-
iFlytek 개방 플랫폼 음성 상호작용을 핵심으로 하는 AI 개방 플랫폼
-
Sogou 실험실 분절과 품사 태깅
-
보슨 데이터 상하이 보슨 데이터 기술. 중국어 의미 분석 기술 전문.
-
윈푸 기술 NLP 도구 모음, 지식 그래프, 텍스트 마이닝, 대화 시스템, 여론 분석 등
-
즈옌 기술 딥러닝과 지식 그래프 기술에 주력하는 AI 기업
-
줘이 기술 딥러닝과 자연어 처리를 주력으로 함
학습 자료 Learning Materials
섹션 제목: “학습 자료 Learning Materials”-
Stanford CS224n Natural Language Processing with Deep Learning 2017
-
[Georgia Tech CS 4650 및 7650 「Natural Language」 강좌 자료] (https://github.com/jacobeisenstein/gt-nlp-class)
-
Speech and Language Processing by Dan Jurafsky and James H. Martin
-
텍스트 처리 실습 강좌 자료 텍스트 특징 추출(TF-IDF), 텍스트 분류, 클러스터링, word2vec 단어 벡터 학습, 유의어 사전 중국어 단어 유사도 계산, 문서 자동 요약, 정보 추출, 감성 분석과 의견 마이닝 등 실험 포함.
-
nlp_tasks Natural Language Processing Tasks and Selected References
-
NLP 연구 입문의 길 칭화대 류즈위안 교수가 제공
-
Chinese NLP 중국어 자연어 처리를 위한 공유 과제, 데이터셋 및 최신 성과
HagiCode
HagiCode는 에이전트 코딩 작업 공간입니다. 풍부하고 편리한 UI 상호작용으로 계획 수립, 에이전트 실행, 프로젝트 작업을 쉽게 시작하고 따라가며 개발을 더 흥미로운 경험으로 만듭니다.
풍부하고 편리한 UI 상호작용으로 계획부터 프로젝트 작업까지 쉽게 따라갈 수 있습니다.

- 스마트OpenSpec 워크플로는 의도를 제안, 설계, 작업을 거쳐 배포까지 이어지는 실행 가능한 경로로 바꿉니다.
- 효율적다중 에이전트 실행으로 조사, 구현, 검토를 병렬로 진행하며 여러 저장소와 익숙한 Agent CLI를 지원합니다.
- 흥미로운풍부하고 편리한 UI 상호작용으로 계획 수립, 에이전트 실행, 프로젝트 작업을 쉽게 시작하고 따라갈 수 있습니다.
Windows용 다운로드
HagiCode 공유

아이디어를 실제로 배포되는 소프트웨어로.
HagiCode는 에이전트 코딩 작업 공간입니다. OpenSpec 워크플로로 변경을 계획하고, 다중 에이전트 실행으로 진행하며, Hero Scenario로 긴 작업의 진행 상황을 한눈에 보여 아이디어를 실제로 배포되는 소프트웨어로 만듭니다.
- 스마트
- OpenSpec 워크플로는 의도를 제안부터 배포까지 이어지는 실행 가능한 경로로 바꿉니다.
- 효율적
- 다중 에이전트 실행으로 조사, 구현, 검토를 병렬로 진행합니다.
- 즐거운
- 편리한 UI 상호작용으로 계획, 에이전트 실행, 프로젝트 작업을 쉽게 따라갈 수 있습니다.
© 2026 HagiCode | Powered By hagilight-starlight@0.21.0 | Branch: main | Commit: 745b50b | Built: