
Production Machine Learning
Source: https://github.com/EthicalML/awesome-production-machine-learning at
4efc0a16249c
License: MIT
Read the English original
This edition is an AI-assisted translation.


Awesome Production Machine Learning
Section titled “Awesome Production Machine Learning”このリポジトリには、機械学習を本番環境にデプロイ、監視、バージョン管理、スケーリング、保護するのに役立つ、優れたオープンソースライブラリを厳選して掲載しています 🚀
この GitHub リポジトリをウォッチすると、毎月追加される本番 ML ライブラリの概要をリリースで受け取り、最新情報を確認できます 🤩
さらに、ツールチェーンをすばやく検索できる検索ツールキットも提供しています。
このページの各セクションへのクイックリンク
Section titled “このページの各セクションへのクイックリンク”リストへの貢献
Section titled “リストへの貢献”リストを整理された最新の状態に保つため、PR を送信する際はCONTRIBUTING.mdの要件をご確認ください。着実な成長を支えてくださるコミュニティの皆さん、ありがとうございます 🚀
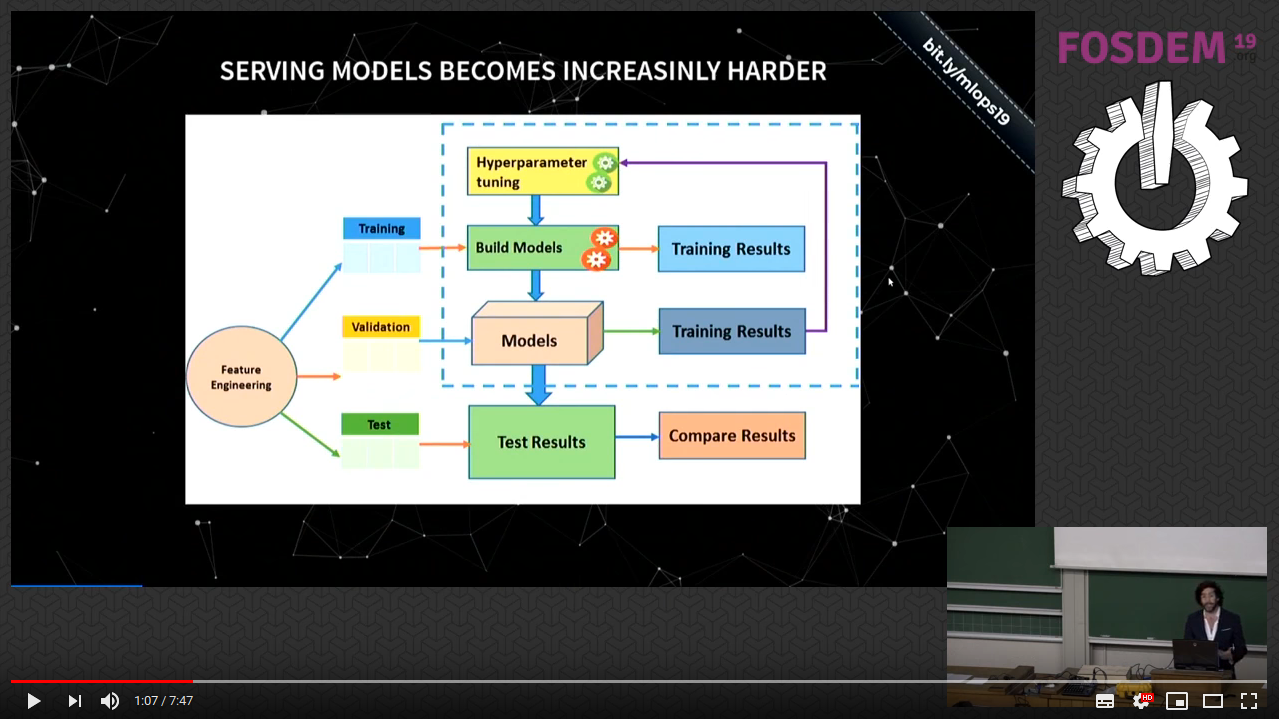
10 分間の動画による概要
Section titled “10 分間の動画による概要”| この10 分間の動画では、機械学習運用が必要とされる背景と、このリポジトリにあるツールの概要を紹介します。新しい動画では、2024 年版に更新された MLOps の現状を取り上げています。 |
|
このリポジトリやその他の進展に関する定期的な最新情報を受け取りませんか?
Section titled “このリポジトリやその他の進展に関する定期的な最新情報を受け取りませんか?”| Machine Learning Engineer ニュースレターに登録できます。本番機械学習に関する記事やチュートリアルを毎週厳選して受け取る 70,000 人以上の ML 専門家や愛好家に加わりましょう。 |
|
| また、Awesome Production GenAI リストもご覧ください。生成 AI アプリケーションやシステムをデプロイ、監視、バージョン管理、スケーリングするための優れたオープンソースライブラリを厳選してまとめています。 |
|
メインコンテンツ
Section titled “メインコンテンツ”AutoML
Section titled “AutoML”- AIDE
 - AIDE は、機械学習タスクの解決策を自律的に探索、実装、評価するために木探索アルゴリズムを用いる、オープンソースの ML エンジニアリングエージェントです。
- AutoGluon
 - 人気の機械学習ライブラリ(Scikit-Learn、LightGBM、CatBoost、PyTorch、MXNet)を基盤に、表形式、画像、テキストデータ向けの特徴量、モデル、ハイパーパラメーターの選択を自動化します。
- Autokeras
 - “Auto-Keras: Efficient Neural Architecture Search with Network Morphism”に基づく Keras 用 AutoML ライブラリです。
- auto-sklearn
 - sklearn のアルゴリズムとハイパーパラメーターの調整を自動化するフレームワークです。
- Ax
 - Ax は、適応的な実験を理解、管理、デプロイ、自動化するための、使いやすい汎用プラットフォームです。
- BoTorch
 - BoTorch は PyTorch 上に構築されたベイズ最適化ライブラリです。
- EvalML
 - EvalML は、ドメイン固有の目的関数を用いて機械学習パイプラインを構築、最適化、評価する AutoML ライブラリです。
- Feature Engine
 - Feature-engine は、機械学習モデルで使う特徴量を作成するための複数の変換器を備えた Python ライブラリです。
- Featuretools
 - 特徴量エンジニアリングを自動化するオープンソースフレームワークです。
- FLAML
 - FLAML は、自動機械学習とチューニングのための高速ライブラリです。
- HEBO
 - ハイパーパラメーター最適化フレームワークのオープンソース集です。NeurIPS 2020 Black-Box Optimisation Challengeの優勝提出物も含み、ハイパーパラメーター調整タスクでテストされています。
- Katib
 - ハイパーパラメーター調整とニューラルアーキテクチャ探索のための、Kubernetes ベースのシステムです。
- keras-tuner
 - Keras Tuner は使いやすく、分散実行可能なハイパーパラメーター最適化フレームワークで、ハイパーパラメーター探索に伴う課題を解決します。探索空間を簡単に定義し、付属のアルゴリズムを活用して最適なハイパーパラメーター値を見つけられます。
- Optuna
 - Optuna は、特に機械学習向けに設計された自動ハイパーパラメーター最適化ソフトウェアフレームワークです。
- OSS Vizier
 - OSS Vizier は、ブラックボックス最適化と研究のための Python ベースのサービスであり、大規模運用を想定して設計された初期のハイパーパラメーター調整サービスの 1 つです。
- Perpetual
 - ハイパーパラメーター最適化が不要で、シンプルな予算パラメーターによってモデルの複雑さを調整できる勾配ブースティングマシンです。
- TPOT
 - 特徴量選択や前処理などを含む sklearn パイプラインの作成を自動化します。
- tsfresh
 - 時系列から関連する特徴量を自動抽出します。
計算と通信の最適化
Section titled “計算と通信の最適化 ”- Accelerate
 - Accelerate は、マルチ GPU/TPU および混合精度に関する定型コードだけを抽象化し、それ以外のコードは変更せずに保ちます。
- Adapters
 - Adapters は、パラメーター効率の高いモジュール型転移学習のための統合ライブラリです。
- Cache-DiT
 - Diffusers 上に構築され、ほぼすべての DiT をサポートします。DBCache、TaylorSeer、SCM などによるハイブリッドキャッシュ高速化に加え、Context Parallelism、Tensor Parallelism、ハイブリッド 2D/3D 並列化などの包括的な最適化を提供し、コンパイル、CPU オフロード、量子化にも対応します。
- Colossal-AI
 - 大規模モデル時代に向けた統合ディープラーニングシステムで、大規模 AI モデルの学習と推論を効率的かつ迅速にデプロイできます。
- Composer
 - Composer は、ニューラルネットワークをより高速に、より低コストで、より高精度に学習できる PyTorch ライブラリです。
- CuDF
 - Apache Arrow の列指向メモリ形式を基盤とする cuDF は、データの読み込み、結合、集約、フィルタリングなどを行う GPU DataFrame ライブラリです。
- CuML
 - cuML は、他の RAPIDS プロジェクトと互換性のある API を備えた機械学習アルゴリズムおよび数学的プリミティブ関数を実装するライブラリ群です。
- CuPy
 - CUDA 上で NumPy 互換の多次元配列を実装しています。CuPy は中核となる多次元配列クラス cupy.ndarray と、それを扱う多数の関数で構成されます。
- DEAP
 - アイデアの迅速な試作と検証のための、新しい進化計算フレームワークです。アルゴリズムを明示的にし、データ構造を透明にすることを目指しています。multiprocessing や SCOOP などの並列化機構と完全に連携します。
- DeepEP
 - Mixture-of-Experts(MoE)と Expert Parallelism(EP)に特化した通信ライブラリです。MoE dispatch と combine とも呼ばれる、高スループットかつ低レイテンシの all-to-all GPU カーネルを提供します。FP8 などの低精度演算にも対応します。
- DGL
 - DGL は、グラフ上のディープラーニング向けに使いやすく、高性能でスケーラブルな Python パッケージです。
- DLRover
 - DLRover は、大規模 AI モデルの分散学習を簡単、安定、高速、かつ環境に配慮したものにします。
- Dask
 - Pandas と NumPy の計算向け分散並列処理フレームワークです。
- DeepSpeed
 - DeepSpeed は、分散学習と推論を簡単、効率的、効果的にするディープラーニング最適化ライブラリです。
- FlagGems
 - OpenAI Triton で実装された高性能な汎用演算子ライブラリです。多様なハードウェアプラットフォームで LLM の学習と推論を高速化することを目指す、バックエンドに依存しないカーネル群を基盤としています。
- Flashlight
 - Facebook AI Research と Torch、TensorFlow、Eigen、Deep Speech の開発者による、すべて C++ で書かれた高速で柔軟な機械学習ライブラリです。
- Flax
 - 柔軟性を重視して設計された、JAX 用ニューラルネットワークライブラリおよびエコシステムです。
- GPUStack
 - オープンソースの GPU クラスター管理ツールです。
- Hivemind
 - PyTorch による分散型ディープラーニングです。
- Jax
 - Python+NumPy プログラムに対する合成可能な変換を提供します。微分、ベクトル化、GPU/TPU 向け JIT コンパイルなどが可能です。
- Kompute
 - 高度な GPU データ処理の用途に最適化された、超高速で軽量、携帯電話にも対応する Vulkan 計算フレームワークです。
- Liger Kernel
 - LLM の学習専用に設計された Triton カーネル集です。
- LightGBM
 - LightGBM は、木ベースの学習アルゴリズムを用いる勾配ブースティングフレームワークです。
- MLX
 - Apple silicon 上で機械学習を行うための配列フレームワークです。
- Modin
 - コードを 1 行変更するだけで、Pandas のワークフローを高速化できます。
- NVIDIA TensorRT
 - NVIDIA GPU とディープラーニングアクセラレーター向けの高性能推論を実現する C++ ライブラリです。
- Nevergrad
 - 勾配を使わない最適化プラットフォームです。
- Norse
 - Norse は、生物に着想を得た疎でイベント駆動型という、人工ニューラルネットワークとは根本的に異なる性質を持つニューラル構成要素の利点を活用することを目指しています。
- Numba
 - Python の配列および数値関数向けコンパイラーです。
- Optimum
 - Transformers と Diffusers を拡張し、使いやすさを保ちながら、対象ハードウェア上でモデルを最大限効率よく学習・実行できる最適化ツールを提供します。
- PEFT
 - パラメーター効率の高いファインチューニング(PEFT)手法を使うと、事前学習済み言語モデル(PLM)の全パラメーターをファインチューニングせずに、さまざまな下流アプリケーションへ効率的に適応できます。
- PaddlePaddle
 - 数百のノードに分散したデータソースを使って、大規模なディープネットワークを学習するフレームワークです。
- PyG
 - PyG(PyTorch Geometric)は PyTorch を基盤とするライブラリで、構造化データに関連する幅広い用途向けに、グラフニューラルネットワーク(GNN)を簡単に記述・学習できます。
- PyTorch Lightning
 - コードを変更せずに複数の GPU や TPU 上で AI モデルの事前学習、ファインチューニング、デプロイを行えます。
- PyTorch
 - ニューラルネットワークベースのディープラーニングモデルを開発・学習するためのライブラリです。
- Ray
 - 機械学習向けの柔軟で高性能な分散実行フレームワークです。
- SetFit
 - Sentence Transformers の few-shot ファインチューニングを効率的に行える、プロンプト不要のフレームワークです。
- Sonnet
 - 機械学習研究向けに、シンプルで合成可能な抽象化を提供する TensorFlow 2 ベースのライブラリです。
- Streaming
 - ニューラルネットワークの効率的な学習を実現するデータストリーミングライブラリです。
- TensorFlow
 - 最先端の機械学習アプリケーションの開発とデプロイ向けに設計された主要ライブラリです。
- ThunderKittens
 CUDA で高速なディープラーニングカーネルを簡単に記述するためのフレームワークです。
- TorchOpt
 - PyTorch 上に構築された、微分可能な最適化のための効率的なライブラリです。
- Triton
 - 高効率なカスタム深層学習プリミティブを記述するための言語およびコンパイラーです。CUDA より高い生産性で高速なコードを書けるオープンソース環境を、既存の DSL より高い柔軟性とともに提供することを目指しています。
- Vaex
 Pandas に似た遅延評価型 Out-of-Core DataFrame を扱い、大規模な表形式データセットを可視化・探索するための高性能 Python ライブラリです。メモリマッピング、メモリコピーを行わないポリシー、遅延計算を用いて、メモリを無駄にせず最高の性能を実現します。
- Vowpal Wabbit
 オンライン学習、ハッシュ化、allreduce、reduction、learning2search、能動学習、対話型学習などの手法で機械学習の最前線を切り開くシステムです。
- XGBoost
 - 高効率、柔軟性、移植性を備えるよう設計された、最適化済みの分散勾配ブースティングライブラリです。
- YDF
 - YDF(Yggdrasil Decision Forests)は、Random Forest、Gradient Boosted Decision Trees、CART、Isolation Forest モデルの学習、評価、解釈、サービングを行うライブラリです。
- bitsandbytes
 - CUDA カスタム関数を扱う軽量な Python ラッパーライブラリで、特に 8 ビットオプティマイザー、行列積(LLM.int8())、8 ビットおよび 4 ビット量子化関数を提供します。
- einops
 - 読みやすく信頼性の高いコードのための、柔軟で強力なテンソル演算です。
- scikit-learn
 - データアクセス、データ準備、統計モデル構築のための幅広いモジュールを備えた強力な機械学習ライブラリです。
- snnTorch
 - スパイキングニューラルネットワークを用いた深層・オンライン学習ライブラリです。
- torchdistill
 - 最先端のさまざまな知識蒸留手法を提供します。Python コードではなく宣言的な YAML 設定ファイルを編集するだけで、新しい実験を簡単に設計できます。
- torchkeras
 torchkeras は、Keras 風の書き方で PyTorch のニューラルネットワークを学習するためのシンプルなツールです。
- veScale
 - PyTorch ネイティブの LLM 学習フレームワークです。
- yellowbrick
 - scikit-learn などの機械学習ライブラリ向けにモデル評価プロットを提供する、matplotlib ベースのライブラリです。
データのアノテーションと合成
Section titled “データのアノテーションと合成 ”- Argilla
 - Argilla は、ドメインの専門家やデータチームが、より短時間で優れた NLP データセットを構築できるよう支援します。
- cleanlab
 - データ中心 AI のための Python ライブラリです。誤ラベルデータや外れ値を自動検出し、複数アノテーターのデータセットで合意度やアノテーターの品質を推定し、次に再ラベルすべきデータを提案します。
- COCO Annotator
 - 物体検出、位置特定、キーポイント用の Web ベース画像セグメンテーションツールです。
- CVAT
 - CVAT(Computer Vision Annotation Tool)は、コンピュータービジョンアルゴリズム向けの、OpenCV の Web ベース動画・画像アノテーションツールです。
- Doccano
 - 感情分析、固有表現認識、機械翻訳の機能を備えた、オープンソースの人手によるテキストアノテーションツールです。
- Label Studio
 - 標準化された出力形式を備える、複数ドメイン向けのデータラベリング・アノテーションツールです。
- LightlyStudio
 - 画像や動画などのビジョンデータセットをキュレーション、アノテーション、管理するオープンソースツールです。埋め込みベースの自動選択、アノテーション、バウンディングボックスやセグメンテーションの自動ラベリングに対応します。
- NeMo Curator
 - 大規模言語モデル向けデータを効率的にキュレーションする、GPU 高速化フレームワークです。
- refinery
 - 自然言語データのスケーリング、評価、保守に最適な、データサイエンティスト向けオープンソースツールです。
- SDV
 - Synthetic Data Vault(SDV)は、単一テーブル、複数テーブル、時系列のデータセットを簡単に学習し、元データと同じ形式および統計的特性を持つ新しい合成データを生成できる、合成データ生成ライブラリのエコシステムです。
- Semantic Segmentation Editor
 - カメラおよび LiDAR データのラベリングに使える日立のオープンソースツールです。
- synthcity
 - 合成された表形式データを生成・評価するライブラリです。
- TabGAN
 - 敵対的フィルタリング、プライバシー指標、sklearn 連携を備え、GAN(CTGAN)、拡散モデル、LLM を使って合成表形式データを生成します。
- ViPE
 - 生動画からカメラ姿勢と高密度深度マップをアノテーションする空間 AI ツールです。
- YData Synthetic
 - 最先端の生成モデルを活用して、合成表形式データと時系列データを生成するパッケージです。
データパイプライン
Section titled “データパイプライン ”- Apache Airflow
 - スケジューラー、DAG 定義、可視化用 UI を備えた、Python 製のデータパイプラインフレームワークです。
- Apache Nifi
 - Apache NiFi はデータフロー向けに作られています。データのルーティング、変換、システム間連携ロジックを含む、高度に設定可能な有向グラフに対応します。
- Argo Workflows
 - Argo Workflows は、Kubernetes 上の並列ジョブをオーケストレーションする、オープンソースのコンテナネイティブなワークフローエンジンです。Kubernetes CRD(カスタムリソース定義)として実装されています。
- Couler
 - Argo Workflows、Tekton Pipelines、Apache Airflow など、異なるワークフローエンジン上で機械学習ワークフローを構築・管理するための統合インターフェースです。
- DataTrove
 - 大規模なテキストデータを処理、フィルタリング、重複排除するライブラリです。
- Dagster
 - 機械学習、分析、ETL 向けのデータオーケストレーターです。
- DBT
 - データウェアハウス内で変換処理を実行する ETL ツールです。
- Flyte
 - Lyft のクラウドネイティブな機械学習・データ処理プラットフォームです - (デモ)。
- Genie
 - Hadoop ベースのシステムからジョブを実行するためのインターフェースと起動を担う、ジョブオーケストレーションエンジンです。
- Hamilton
 - データフローを定義するマイクロオーケストレーションフレームワークです。Jupyter、FastAPI、Spark、Ray、Dask など、Python が動作するあらゆる場所で実行できます。意識せずともソフトウェアエンジニアリングのベストプラクティスを取り入れられます。特徴量エンジニアリング変換、エンドツーエンドのモデルパイプライン、LLM ワークフローの定義に使えます。Kedro、Luigi、Airflow、dbt などのマクロオーケストレーションシステムを補完し、それらのマクロタスク内のコードを置き換えます。系譜と来歴、実行テレメトリー、データの概要を記録し、自動で情報が蓄積されるカタログを構築するセルフホスト可能な UI を備え、開発・本番の両方で利用できます。
- Instill VDP
 - Instill VDP(Versatile Data Pipeline)は、データ処理パイプラインを立ち上げから完了まで効率化することを目指しています。
- Instructor
 - GPT-3.5、GPT-4、GPT-4-Vision、オープンソースモデルなどの LLM から、JSON のような構造化データを簡単に取得できます。
- Kedro
 - 堅牢でスケーラブル、デプロイ可能、再現可能かつバージョン管理可能なデータパイプラインの構築を支援する、ワークフロー開発ツールです。
- Luigi
 - 依存関係の解決、ワークフロー管理、可視化などを扱い、複雑なバッチジョブのパイプライン構築を支援する Python モジュールです。
- Metaflow
 - データサイエンティストが実際のデータサイエンスプロジェクトを簡単に構築・管理できるフレームワークです。
- Pachyderm
 - 主に本番機械学習パイプラインを動的に構築することに重点を置く、Kubernetes ベースのオープンソース分散処理フレームワークです - (動画)。
- Pixeltable
 マルチモーダル AI ワークロードの構築・管理に向けた、宣言的で増分処理に対応するデータ基盤を提供するオープンソース Python ライブラリです。
- Prefect Core
 - 再試行、ログ記録、動的マッピング、キャッシュ、失敗通知などの機能を追加してデータパイプラインを簡単に拡張できるワークフロー管理システムです。
- SeqIO
 - 後続の系列モデルに入力する系列データを処理するライブラリです。
- Snakemake
 - 再現可能でスケーラブルなデータ分析のためのワークフロー管理システムです。
- Towhee
 - 1 つ以上の ML モデルを使って埋め込みベクトルを生成する汎用機械学習パイプラインです。
- unstructured
 - PDF、HTML、Word 文書などの画像やテキストを取り込み前処理することで、LLM 向けデータ処理ワークフローを効率化・最適化します。
- ZenML
 - 再現可能な ML パイプラインを作成するための拡張可能なオープンソース MLOps フレームワークです。自動メタデータ追跡、キャッシュ、多数の他ツールとの統合を重視しています。
データサイエンスノートブック
Section titled “データサイエンスノートブック ”- Apache Zeppelin
 - SQL、Scala などを使ったデータ駆動型の対話的なデータ分析や共同編集ドキュメントを実現する Web ベースのノートブックです。
- Deepnote
 - Deepnote は、AI を第一に考えた設計、洗練された UI、新しいブロック、ネイティブなデータ統合を備えた、Jupyter の置き換えとしてすぐに使えるツールです。お気に入りの IDE で Python、R、SQL をローカル実行し、その後 Deepnote クラウドに拡張すれば、リアルタイム共同作業、Deepnote エージェント、デプロイ可能なデータアプリを利用できます。
- Jupyter Notebooks
 - 再現可能な開発のための Web ベースの Python サンドボックス環境です。
- Marimo
 - リアクティブな Python ノートブックです。再現可能な実験を実行し、スクリプトとして実行、アプリとしてデプロイし、Git でバージョン管理できます。
- Papermill
 - ノートブックのパラメーター化と Python スクリプトのような実行を行うライブラリです。
- Polynote
 - 実験的な多言語ノートブック環境です。現在は Scala と Python(Spark の有無を問わず)、SQL、Vega に対応しています。
- RMarkdown
 - Pandoc に基づく次世代の R Markdown 実装である rmarkdown パッケージです。
- Stencila
 - データ駆動型コンテンツを作成、共同編集、共有するためのプラットフォームです。透明性と再現性を備えたコンテンツを実現します。
- Voilà
 - Jupyter ノートブックを、ダッシュボードなどに利用できるスタンドアロンの Web アプリケーションに変換します。
データストレージの最適化
Section titled “データストレージの最適化 ”- AIStore
 - AIStore は軽量なオブジェクトストレージシステムです。ストレージノードを追加するたびに線形にスケールアウトでき、ペタスケールのディープラーニングに特化しています。
- Alluxio
 - 計算フレームワークとストレージシステムの間をつなぐ仮想分散ストレージシステムです。
- Apache Arrow
 - Pandas や Hadoop ベースのシステムなどと互換性のある、インメモリ列指向データ表現です。
- Apache Druid
 - 高性能なリアルタイム分析データベースです。概要についてはこちらの記事をご覧ください。
- Apache Hudi
 - Hudi は、データウェアハウスやデータベースの中核機能をデータレイクにもたらすトランザクション対応データレイクプラットフォームです。ストリーミング処理に適しており、効率的な増分バッチパイプラインも作成できます。Spark、Flink、Presto、Trino、Hive などの主要クエリエンジンに対応しています。詳細はこちら。
- Apache Iceberg
 - Iceberg は、非常に大規模な分析テーブル(数十ペタバイトのデータを含む)向けに構築された ACID 準拠の高性能フォーマットです。SQL テーブルの信頼性とシンプルさをビッグデータにもたらし、Spark、Trino、Flink、Presto、Hive、Impala などのエンジンが同じテーブルを同時に安全に利用できるようにします。詳細はこちら。
- Apache Ignite
 - トランザクション、分析、ストリーミングのワークロードに対応し、ペタバイト規模でインメモリ速度を実現する、メモリ中心の分散データベース、キャッシュ、処理プラットフォームです - デモ。
- Apache Parquet
 - Pandas や Hadoop ベースのシステムなどと互換性のある、ディスク上の列指向データ表現です。
- Apache Pinot
 - リアルタイム分散 OLAP データストアです。ClickHouse、Druid、Pinot などのオープンソース OLAP システムの比較はこちらをご覧ください。
- Casibase
 - Web UI とエンタープライズ SSO を備えた、LangChain に似た RAG(検索拡張生成)ナレッジデータベースです。
- Chroma
 - オープンソースの埋め込みデータベースです。
- ClickHouse
 - オープンソースの列指向データベース管理システムです。
- Delta Lake
 - Apache Spark などのビッグデータエンジンにスケーラブルな ACID トランザクションをもたらすストレージレイヤーです。
- EdgeDB
 - Postgres を拡張し、最新のデータモデル、グラフクエリ、認証、AI ソリューションなどを提供します。
- GPTCache
 - 大規模言語モデルのクエリ向けにセマンティックキャッシュを作成するライブラリです。
- InfluxDB
 メトリクス、イベント、リアルタイム分析のためのスケーラブルなデータストアです。
- Milvus
 機械学習モデルやニューラルネットワークが生成する埋め込みベクトルを管理する、クラウドネイティブなオープンソースのベクトルデータベースです。
- Marqo
 エンドツーエンドのベクトル検索エンジンです。
- pgvector
 Postgres のベクトル類似検索を支援します。
- PostgresML
 SQL クエリを使い、テキストデータや表形式データに対して学習と推論を実行できる PostgreSQL 用機械学習拡張機能です。
- Redis
 ベクトル類似検索に対応したオープンソースのインメモリデータストアで、セマンティック検索やレコメンデーションシステムなどの AI/ML アプリケーションに適しています。
- Safetensors
 テンソルを保存・配布するための、シンプルで安全な方法です。
- TimescaleDB
 高速な取り込みと複雑なクエリ向けに最適化され、PostgreSQL 拡張機能として提供されるオープンソースの時系列 SQL データベースです - (動画)。
- Weaviate
 - GraphQL と REST に対応する低レイテンシのベクトル検索エンジンで、さまざまなメディアタイプを標準でサポートします。モジュールにはセマンティック検索、Q&A、分類、カスタマイズ可能なモデル(PyTorch/TensorFlow/Keras)などがあります。
- Zarr
 - 並列計算での利用を想定して設計された、チャンク化・圧縮対応の N 次元配列の Python 実装です。
データストリーム処理
Section titled “データストリーム処理 ”- Apache Beam
 バッチ処理とストリーミングを統合するプログラミングモデルです。
- Apache Flink
 - 強力なストリーム処理・バッチ処理機能を備えたオープンソースのストリーム処理フレームワークです。
- Apache Kafka
 - 入力と出力を Kafka クラスターに保存するアプリケーションやマイクロサービスを構築するための Kafka クライアントライブラリです。
- Apache Samza
 - 分散ストリーム処理フレームワークです。メッセージングに Apache Kafka を使用し、Apache Hadoop YARN によってフォールトトレランス、プロセス分離、セキュリティ、リソース管理を実現します。
- Apache Spark
 - Apache Spark をバックエンドとしてストリームをマイクロバッチ処理し、状態を持つ exactly-once セマンティクスをサポートします。
- Bytewax
 - Rust エンジン上に構築された、柔軟で Python を中心とする状態管理型ストリーム処理フレームワークです。
- FastStream
 - FastAPI に着想を得て、Apache Kafka、RabbitMQ、NATS プロトコルに対応する、ブローカーに依存しない最新のストリーミング Python フレームワークです。他の Web フレームワークにも簡単に統合できます。
- MOA
 - MOA(Massive Online Analysis)は、ビッグデータのストリームマイニング向けオープンソースフレームワークです。
- MosaicML Streaming - 分散モデル学習向けに、クラウドストレージから大規模データセットを高速かつ決定論的にストリーミングします。
- RisingWave
 - ストリーム処理と低レイテンシサービングを統合した分散 SQL ストリーミングデータベースです。オンライン機械学習向けの特徴量の構築と提供に適しています。
- TensorStore
 - 大規模な多次元配列の読み書き用ライブラリです。
デプロイとサービング
Section titled “デプロイとサービング ”- Agenta
 - Agenta は、LLMOps ワークフロー全体を支援するエンドツーエンドのツールを提供します。構築(LLM プレイグラウンド、評価)、デプロイ(プロンプトと設定の管理)、運用(LLM の可観測性とトレーシング)に対応します。
- AirLLM
 - 推論時のメモリ使用量を最適化し、量子化、蒸留、枝刈りを行わずに、70B の大規模言語モデルを 4GB の GPU 1 枚で推論できます。
- AITemplate
 - AITemplate(AIT)は、ディープニューラルネットワークを CUDA(NVIDIA GPU)/HIP(AMD GPU)向けの C++ コードに変換し、極めて高速な推論サービングを実現する Python フレームワークです。
- BentoML
 - 高性能な ML モデルサービングのためのオープンソースフレームワークです。
- Bifrost
 - 23 以上の LLM プロバイダーで単一の OpenAI 互換 API を提供する AI ゲートウェイです。自動フォールバック、負荷分散、セマンティックキャッシュ、予算管理、Prometheus メトリクスに対応します。
- BISHENG
 - エンタープライズ用途に重点を置く、オープンな LLM アプリケーション DevOps プラットフォームです。
- CosmoEdge
 - 本番環境向けの C++ エッジ動画 AI エンジンです。RTSP 取り込み、CV/VLM 推論、ビジュアルオーケストレーション、アラーム、Sophon および Rockchip NPU を介したイベント配信を統合します。
- DeepDetect
 - Jolibrain が保守する、TensorFlow、XGBoost、Caffe モデル向けの C++ 製機械学習本番サーバーです。
- Dynamo
 - NVIDIA Dynamo は、マルチノード分散環境で生成 AI モデルや推論モデルをサービングするために設計された、高スループット・低レイテンシの推論フレームワークです。
- exo
 - 日常的なデバイスを使って、自宅で AI クラスターを構築・実行できます。
- Genkit
 - 使い慣れたコード中心のパターンで AI 搭載アプリを構築するためのオープンソースフレームワークです。Genkit を使うと、可観測性と評価機能を備えた AI 機能を簡単に開発、統合、テストできます。
- GoModel
 - Go で書かれたセルフホスト型 AI ゲートウェイです。OpenAI、Anthropic、Gemini、Groq、xAI、Ollama などのプロバイダーに対応する統合 OpenAI 互換 API を提供し、ルーティング、使用状況追跡、レート制限、ガードレールを備えています。
- Inference
 - 多数の一般的なモデルアーキテクチャとファインチューニング済みモデルのデプロイに対応した、高速で本番利用可能なコンピュータービジョン推論サーバーです。Docker を使って自社ハードウェア上に YOLOv5、YOLOv8、CLIP、SAM、CogVLM などのモデルをデプロイできます。
- Infinity
 - テキスト埋め込み、リランキングモデル、CLIP を提供する高スループット・低レイテンシの REST API です。
- LiteLLM
 - Bedrock、Azure、OpenAI、VertexAI、Cohere、Anthropic、Sagemaker、HuggingFace、Replicate、Groq など、100 以上の LLM API を OpenAI 形式で呼び出すための Python SDK およびプロキシサーバー(LLM ゲートウェイ)です。
- LiteRT
 - LiteRT(旧 TensorFlow Lite)は、モバイル、組み込み、エッジデバイスへの機械学習モデルのデプロイを可能にする、Google の高性能オンデバイス AI 推論ランタイムです。
- LiteRT-LM
 - LiteRT-LM は、Android、iOS、Web、デスクトップ、IoT にまたがるクロスプラットフォーム対応を備え、エッジデバイス上に大規模言語モデルをデプロイするための、Google の本番利用可能な高性能推論フレームワークです。
- LitServe
 - FastAPI 上に構築された、AI モデル向けの柔軟なサービングエンジンです。モデル、エージェント、マルチモーダルシステム、RAG、複雑な ML パイプライン向けに、カスタム推論エンジンをサポートします。
- jevos
 - はい/いいえ判定を行う TypeSafe の Jev のオープンソース代替です。1B パラメーターの二値分類器(GGUF、llama.cpp)を Jev 互換の FastAPI HTTP API で提供し、ノート PC 上で CPU のみで動作します。
- Jina-serve
 - gRPC、HTTP、WebSocket で通信する AI サービスを構築・デプロイするためのフレームワークです。
- Kiln
 - LLM モデルのファインチューニング、合成データ生成、データセットでの共同作業を行う OSS ツールです。
- KServe
 - 予測型および生成型 ML のサービングを可能にする Kubernetes カスタムリソース定義を提供します。
- KTransformers
 - 最先端の LLM 推論最適化を試すための柔軟なフレームワークです。
- Langtrace
 - OpenTelemetry ベースの、LLM アプリケーション向けエンドツーエンドのオープンソース可観測性ツールです。主要な LLM、LLM フレームワーク、ベクトル DB などのリアルタイムトレース、評価、メトリクスを提供します。
- Lepton AI
 - LeptonAI の Python ライブラリを使えば、Python コードから AI サービスを簡単に構築できます。
- LightLLM
 - 軽量設計、容易なスケーラビリティ、高速な性能を特長とする、Python ベースの LLM 推論・サービングフレームワークです。
- llama.cpp
 - Llama など、さまざまな大規模言語モデルの推論を行うオープンソースソフトウェアライブラリです。
- llmfit
 - システムの RAM、CPU、GPU に適したサイズの LLM を選定するターミナルツールです。ハードウェアを検出し、品質、速度、適合性、コンテキストの各観点からモデルを評価して、マシン上で実際に快適に動作するモデルを提示します。
- LMCache
 - LLM 推論を高速化する高性能 KV キャッシュレイヤーです。
- LMDeploy
 - LLM の圧縮、デプロイ、サービングのためのツールキットです。
- LM Studio
 - 最低要件を満たせば、比較的性能の控えめなマシンでも LLM モデルをローカルにデプロイできるツールです。
- LocalAI
 - OpenAI API 仕様に準拠した、ローカル推論用のドロップイン置き換え REST API です。
- MindsDB
 - データベース、ベクトルストア、アプリケーションデータから、リアルタイムでモデルを作成、サービング、ファインチューニングするプラットフォームです。
- mini-sglang
 - 大規模言語モデル向けの軽量で効率的なサービングフレームワークです。
- MLRun
 - ML と生成 AI アプリケーションのライフサイクル全体で、継続的な構築と管理をすばやく行えるオープン MLOps フレームワークです。
- MLServer
 - 複数のフレームワークやマルチモデルサービングなどに対応する、機械学習モデル向け推論サーバーです。
- Model Runner
 - Docker Model Runner を使えば、Docker Hub や OCI 準拠レジストリから取得した LLM などの AI モデルを Docker で簡単に管理、実行、サービングできます。
- Mosec
 - Rust を基盤とする多段パイプライン型モデルサーバーで、動的バッチ処理などに対応します。マイクロサービスとして簡単に実装・デプロイできます。
- nano-vllm
 - ゼロから構築された軽量な vLLM 実装です。プレフィックスキャッシュ、テンソル並列化、CUDA グラフなどの最適化技法により、高速なオフライン推論を実現します。
- nndeploy
 - 使いやすく高性能な AI デプロイフレームワークです。
- Nuclio
 - データ、I/O、計算負荷の高いワークロードに重点を置く高性能な「サーバーレス」フレームワークです。Jupyter や Kubeflow などの主要なデータサイエンスツールと緊密に統合され、多様なデータソースやストリーミングソースに対応し、CPU と GPU の両方で実行できます。
- OpenLLM
 - 開発者は OpenLLM を使い、Llama 3.1、Qwen2、Phi3 などのオープンソース LLM や独自モデルを、1 つのコマンドで OpenAI 互換 API として実行できます。
- OpenVINO
 - AI 推論の最適化とデプロイのためのオープンソースツールキットです。
- Open WebUI
 - 完全オフラインで動作するよう設計された、拡張性が高く機能豊富な使いやすいセルフホスト型 AI プラットフォームです。Ollama などの各種 LLM ランナーや OpenAI 互換 API に対応し、RAG 用の推論エンジンを内蔵する強力な AI デプロイソリューションです。
- OptiLLM
 - OpenAI API 互換の最適化推論プロキシです。20 以上の最先端技術を実装して推論タスクにおける LLM の精度と性能を大幅に高め、モデルの学習やファインチューニングは不要です。
- PowerInfer
 - デバイスのアクティベーション局所性を活用する CPU/GPU 対応 LLM 推論エンジンです。
- Prompt2Model
 - ChatGPT などの LLM に使うプロンプトのような自然言語のタスク記述を入力し、デプロイに適した小型の特化モデルを学習するシステムです。
- RamaLama
 - ホストシステムを設定する必要なく、OCI コンテナを通じた推論向け AI モデルのローカル利用とサービングを簡単にするオープンソースツールです。
- RunAnywhere
 - iOS、Android、React Native、Flutter 上で LLM、音声認識、音声合成などの AI モデルをデバイス上で動かす、本番利用可能な SDK です。プライベートでオフラインかつ高速なモバイル AI アプリを実現します。
- Seldon Core
 - Kubernetes で機械学習モデルをデプロイするためのオープンソースプラットフォームです - (動画)。
- SGLang
 - 大規模言語モデルおよび視覚言語モデル向けの高速サービングフレームワークです。
- SIE
 - 埋め込み、リランキング、抽出向けのオープンソース推論サーバー兼本番クラスターです。高密度・疎・マルチベクトル・ビジョン・リランカー・抽出器にわたる 85 以上の事前設定済みモデルを提供します。Helm、KEDA 自動スケーリング、Grafana ダッシュボード、Terraform が付属します。
- SkyPilot
 - あらゆるクラウドで LLM、AI、バッチジョブを実行できるフレームワークです。コストを最大限に抑え、GPU の利用可能性を高め、実行を管理します。
- Tensorflow Serving
 - gRPC プロトコルで TensorFlow モデルを提供する高性能フレームワークで、コアあたり毎秒 10 万リクエストを処理できます。
- torchtune
 - LLM の作成、事後学習、実験を簡単に行うための PyTorch ライブラリです。
- Transformer Lab
 - 推論エンジンやプラットフォームを問わず、モデルのファインチューニング、評価、エクスポート、ローカルテストを行うオープンソース LLM ワークスペースです。
- Triton Inference Server
 - GPU と CPU の使用率を最大化しながら、あらゆるフレームワークの AI モデルをデプロイする高性能なオープンソースサービングソフトウェアです。
- Vercel AI
 - Next.js、React、Svelte、Vue などの人気フレームワークや Node.js などのランタイムを使って AI 搭載アプリケーションを構築するための TypeScript ツールキットです。
- Vespa
 - サービング時に、あらゆる規模でベクトル、テンソル、テキスト、構造化データを検索、推論、整理できます。
- vLLM
 - LLM 向けの高スループットでメモリ効率に優れた推論・サービングエンジンです。
評価とモニタリング
Section titled “評価とモニタリング ”- AlpacaEval
 - 指示追従型言語モデル向けの自動評価器です。
- ANN-Benchmarks
 - 近似最近傍探索アルゴリズムの検索を評価するベンチマーク環境です。
- ARES
 - 検索拡張生成(RAG)モデルを自動評価するフレームワークです。
- BEIR
 - 多様な情報検索(IR)タスクを含む異種ベンチマークです。NLP ベースの検索モデルをベンチマーク内で評価するための共通かつ使いやすいフレームワークも提供します。
- Code Generation LM Evaluation Harness
 - コード生成モデルを評価するためのフレームワークです。
- COMET
 - 機械学習の評価を行うオープンソースフレームワークです。
- C-Eval
 - 基盤モデル向けの包括的な中国語評価スイートです。
- Deepchecks
 - AI と ML のあらゆる検証ニーズに対応する包括的なオープンソースソリューションであり、研究から本番環境までデータとモデルを徹底的にテストできます。
- DeepEval
 - LLM アプリケーション向けの、使いやすいオープンソース評価フレームワークです。
- EvalAI
 - AI アルゴリズムを大規模に評価・比較するためのオープンソースプラットフォームです。
- Evalchemy
 - 事後学習済み言語モデルの評価に使える、統合された使いやすいツールキットです。
- EvalPlus
 - HumanEval+ と MBPP+ の拡張ベンチマーク、効率評価(EvalPerf)、安全で拡張可能な評価ツールキットを備える、LLM4Code 用の堅牢な評価フレームワークです。
- Evals
 - OpenAI モデルの評価フレームワークであり、ベンチマークのオープンソースレジストリです。
- EvalScope
 - 大規模モデルの効率的な評価と性能ベンチマークを行うための、簡潔でカスタマイズ可能なフレームワークです。
- Evaluate
 - モデルの評価・比較と、その性能報告をより簡単かつ標準化された方法で行えるライブラリです。
- Evidently
 - ML および LLM 搭載システムの評価、テスト、モニタリングを行うオープンソースフレームワークです。
- Future AGI
 - LLM や AI エージェントのアプリケーション向けに、トレース、評価、シミュレーション、データセット、ゲートウェイ、ガードレールを統合した、セルフホスト可能なエンドツーエンドのオープンソースエージェント開発・最適化プラットフォームです。
- GAOKAO-Bench
 - 中国の大学入学統一試験(高考)の問題をデータセットとして用い、大規模モデルの言語理解力と論理的推論能力を評価するフレームワークです。
- Giskard
 - AI アプリケーションの性能、バイアス、セキュリティ上の問題を自動検出するオープンソース Python ライブラリです。
- guidellm
 - 大規模言語モデル推論システムのベンチマークと性能評価を行うツールです。
- Harbor
 - エージェントと言語モデルの評価・最適化フレームワークです。コンテナ環境全体での並列実験に対応し、ベンチマークと環境管理機能を内蔵しています。
- HumanEval
 - ユニットテストを含む Python プログラミング問題を使って、コード生成モデルの機能的正確性を評価するベンチマークです。
- Helicone
 - オールインワンのオープンソース LLM 開発者向けプラットフォームです。
- HELM
 - HELM(Holistic Evaluation of Language Models)は、標準化データセット、多様なモデルに対応する統合 API、多様な指標、公平性を検証する摂動機能、プロンプト構築フレームワーク、モデルに統一的にアクセスするプロキシサーバーなど、言語モデルを包括的に評価するツールを提供します。
- Inspect
 - 大規模言語モデル評価用のフレームワークです。
- IsaacLab-Arena
 - NVIDIA Isaac Lab を拡張し、構成可能な環境の作成とロボットポリシーの大規模評価を行うオープンソース拡張機能です。
- JiWER
 - 自動音声認識システムを評価するための、シンプルで高速な Python パッケージです。
- Laminar
 - AI 製品のための LLM データのトレース、評価、ラベル付け、分析を行うオープンソースプラットフォームです。
- Langfuse
 - LLM ベースのアプリケーション向け可観測性・分析ソリューションです。
- LangTest
 - NLP モデル用の包括的な評価ツールキットです。
- Language Model Evaluation Harness
 - 多数の異なる評価タスクで生成言語モデルをテストするフレームワークです。
- LangWatch
 - DSPy のビジュアルインターフェースであり、公正なコード配布モデルを採用した完全な LLM Ops プラットフォームです。LLM パイプラインのモニタリング、実験、測定、改善を行えます。
- Latitude
 - セマンティックなトレース検索と課題追跡を備えた、AI エージェントの可観測性向けオープンソースプラットフォームです。
- LightEval
 - 軽量な LLM 評価スイートです。
- lmms-eval
 - LMM を一貫して効率的に評価するために綿密に設計された評価フレームワークです。
- Melting Pot
 - マルチエージェント強化学習向けのテストシナリオ集です。
- Meta-World
 - メタ強化学習とマルチタスク学習のためのオープンソースシミュレーションベンチマークです。50 種類の異なるロボット操作タスクで構成されます。
- mir_eval
 - 音楽情報検索システムを透明性があり、標準化された簡単な方法で評価する Python ライブラリです。
- MLPerf Inference
 - さまざまなデプロイシナリオにおけるシステムのモデル実行速度を測定するベンチマークスイートです。
- Massive Text Embedding Benchmark - Massive Text Embedding Benchmark(MTEB)は、8 種類の埋め込みタスク、58 のデータセット、112 言語にわたる多様なタスクでテキスト埋め込みモデルの性能を評価する包括的なフレームワークです。
- NannyML
 - デプロイ後のモデル性能を(正解ラベルにアクセスせずに)推定し、データドリフトを検出し、ドリフトのアラートとモデル性能の変化を関連付けるライブラリです。
- OGB
 - Open Graph Benchmark(OGB)は、グラフ機械学習向けのベンチマークデータセット、データローダー、評価器のコレクションです。
- Ollama Grid Search
 - 特定の用途に最適なモデル、プロンプト、推論パラメーターを自動選択し、それらの組み合わせを反復処理して結果を視覚的に確認できます。
- onWatch
 - 複数プロバイダー(Anthropic Pro/Max Plans、Codex、Gemini CLI、Synthetic、Z.ai、GitHub Copilot、MiniMax Coding/Token Plan、Antigravity、OpenRouter)にわたる AI API の利用枠をリアルタイムで追跡する軽量な Go CLI です。消費率の予測、過去の利用グラフ、サイクルごとの追跡機能を備えています。
- OpenCompass
 - 50 以上のデータセットで、LLaMA、LLaMa2、ChatGLM2、ChatGPT、Claude など幅広いモデルをサポートする LLM 評価プラットフォームです。
- OpenLIT
 - 可観測性、モニタリング、ガードレール、評価、シームレスな統合により LLM ワークフローを簡素化するオープンソース AI エンジニアリングプラットフォームです。
- OpenLLMetry
 - 性能モニタリング、実行トレース、デバッグ機能を通じて、大規模言語モデルアプリケーションの詳細な可視性を開発者に提供します。
- Opik
 - LLM アプリケーションの評価、テスト、モニタリングを行うオープンソースプラットフォームです。
- Overcooked-AI
 - 人気ゲーム Overcooked を基にした、人間と AI の完全協調型タスク遂行ベンチマーク環境です。
- Phoenix
 - 実験、評価、トラブルシューティング向けに設計されたオープンソース AI 可観測性プラットフォームです。
- Promptfoo
 - CI/CD と統合して、ジェイルブレイク、プロンプトインジェクションなどの脆弱性をテストする LLM レッドチーミング・評価フレームワークです。
- Prometheus-Eval
 - LLM プロジェクトの管理と最適化を強化するために設計された包括的なプラットフォームです。
- RagaAI Catalyst
 - 他の言語モデルの評価に特化した言語モデルの学習、評価、利用のためのツール集です。
- Ragas
 - RAG パイプラインを評価するフレームワークです。
- RewardBench
 - 報酬モデルの能力と安全性を評価するために設計されたベンチマークです。
- RLBench
 - 強化学習、模倣学習、マルチタスク学習、幾何学的コンピュータービジョン、特に few-shot 学習など、視覚に基づく操作研究を促進する大規模ベンチマーク兼学習環境です。
- SimplerEnv
 - 実際のロボット構成を対象に、シミュレーション上で操作ポリシーを評価する環境です。
- SwanLab
 - AI 学習の追跡と可視化を行うツールです。
- Speech-to-Text Benchmark
 - さまざまな音声認識エンジンのベンチマークを行う、最小構成で拡張可能なフレームワークです。
- TensorFlow Model Analysis
 - TensorFlow Model Analysis(TFMA)は、トレーナーで定義したものと同じ指標を使い、分散方式で大量データ上の TensorFlow モデルを評価するライブラリです。
- TorchBench
 - PyTorch の性能評価に用いるオープンソースベンチマーク集です。
- TruLens
 - LLM 実験の評価と追跡を行うツール群を提供します。
- TrustLLM
 - 原則、調査、ベンチマークを含む、大規模言語モデルの信頼性を評価する包括的なフレームワークです。
- VBench
 - 動画生成モデル向けの包括的なベンチマークスイートです。
- VLMEvalKit
 - 大規模視覚言語モデル(LVLM)向けのオープンソース評価ツールキットです。
説明可能性と公平性
Section titled “説明可能性と公平性 ”- Aequitas
 - データサイエンティスト、機械学習研究者、政策立案者向けのオープンソースバイアス監査ツールキットです。機械学習モデルの差別やバイアスを監査し、予測型リスク評価ツールの開発・導入に関する情報に基づいた公平な意思決定を支援します。
- AI Explainability 360
 - さまざまな説明の側面を網羅する包括的なアルゴリズム群と、代理説明可能性指標を含む、データおよび機械学習モデルの解釈・説明可能性ツールです。
- AI Fairness 360
 - データセットと機械学習モデル向けの包括的な公平性指標、その説明、データセットとモデルのバイアスを軽減するアルゴリズムを提供します。
- Alibi
 - 機械学習モデルの検査と解釈を目的とするオープンソース Python ライブラリです。当初はブラックボックスモデルのインスタンスベース説明に重点を置いていました。
- captum
 - Facebook が開発した PyTorch 用モデル解釈・理解ライブラリです。PyTorch モデル向けに、Integrated Gradients、Saliency Maps、SmoothGrad、VarGrad などの汎用実装を含みます。
- Fairlearn
 - 機械学習モデルの不公平性を評価・軽減する Python ツールキットです。
- InterpretML
 - 解釈可能なモデルの学習とブラックボックスシステムの説明を行うオープンソースパッケージです。
- Lightly
 - 画像の自己教師あり学習向け Python フレームワークです。学習済み表現を使って、ラベルなしデータの分布を分析し、データセットを再調整できます。
- LOFO Importance
 - LOFO(Leave One Feature Out)Importance は、選択した指標とモデルを用いて、特徴量を 1 つずつ集合から取り除き、選択した検証方式でモデル性能を評価することで、特徴量の重要度を算出します。
- mljar-supervised
 - 特徴量エンジニアリング、ハイパーパラメーター調整、説明、ドキュメント自動生成を備えた、表形式データ向け AutoML Python パッケージです。
- Quantus
 - ニューラルネットワークの説明を責任ある形で評価するための説明可能 AI(XAI)ツールキットです。
- SHAP
 - あらゆる機械学習モデルの出力を説明する統一的な手法である SHapley Additive exPlanations です。
- SHAPash
 - 誰もが理解できる明示的なラベルを表示する、複数種類の可視化機能を備えた Python ライブラリです。
- WhatIf
 - ブラックボックス分類・回帰 ML モデルへの理解を深める、使いやすいインターフェースです。
特徴量ストア
Section titled “特徴量ストア ”- FEAST
 - Feast(Feature Store)は、機械学習向けのオープンソース特徴量ストアです。既存のインフラを活用して分析データを本番運用し、モデル学習やオンライン推論に利用するための最短経路を提供します。
- Featureform
 - 仮想特徴量ストアです。既存インフラにプラグアンドプレイで導入できます。データサイエンティストにも使いやすく、探索、ガバナンス、系譜管理、共同作業を pip install だけで利用できます。pandas、Python、Spark、SQL や主要なクラウドベンダーとの連携に対応します。
- Hopsworks Feature Store
 - ML 向けオフライン/オンライン特徴量ストアです (動画)。
産業用途向け異常検知
Section titled “産業用途向け異常検知 ”- Alibi Detect
 - 外れ値、敵対的攻撃、概念ドリフトの検出に特化した Python パッケージです。
- Darts
 - 時系列データの予測と異常検知を使いやすく行うライブラリです。
- Deequ
 - 大規模データセットのデータ品質を測定する「データのユニットテスト」を定義するための、Apache Spark ベースのライブラリです。
- PyOD
 - スケーラブルな外れ値検出(異常検知)向けの Python ツールボックスです。
- TFDV
 - 機械学習データの探索と検証を行うライブラリです。
産業用途向けコンピュータービジョン
Section titled “産業用途向けコンピュータービジョン ”- CameraTraps
 - CameraTraps(PyTorch Wildlife)は、規模の大きなカメラトラップデータセットで学習した検出・分類モデルを提供する、野生生物画像解析向けの共同ディープラーニングフレームワークです。
- Deep Lake
 - コンピュータービジョンに最適化されたデータ基盤です。
- DeepForest
 - 航空機から撮影した RGB 画像を使い、深層学習で個々の樹冠や樹種を学習・予測する Python パッケージです。
- Detectron2
 - Facebook AI Research の次世代ライブラリで、最先端の検出・セグメンテーションアルゴリズムを提供します。
- Kornia
 - PyTorch 上に構築された微分可能なコンピュータービジョンライブラリで、微分可能な画像処理・幾何学的視覚アルゴリズムを豊富に提供します。
- libcom
 - 画像合成ツールボックスです。
- LightlyTrain
 - 産業用途向けに、ラベルなしデータを使ってコンピュータービジョンモデルを事前学習します。
- MMCV
 - OpenMMLab の基盤的なコンピュータービジョンライブラリです。画像・動画処理、データ変換と拡張、CNN アーキテクチャ、最適化済み CUDA 演算などの重要機能を提供します。
- SuperGradients
 - PyTorch ベースのコンピュータービジョンモデルを学習するためのオープンソースライブラリです。
- supervision
 - コンピュータービジョンのパイプラインを効率よく管理するための Python ライブラリです。アノテーション、可視化、モデルモニタリング用のツールを提供します。
- VideoSys
 - さまざまな高速化技術を用いて多くの拡散モデルに対応し、モデルの高速化とメモリ使用量削減を実現します。
産業用途向け情報検索
Section titled “産業用途向け情報検索 ”- AutoRAG
 - データに最適な RAG パイプラインを自動的に見つける RAG AutoML ツールです。
- BGE
 - 検索と RAG 向けのワンストップ検索ツールキットを構築します。
- EmbedAnything
 - テキスト、画像、音声、PDF などから埋め込みを生成するために Rust で構築された、最小構成で軽量かつ高性能な埋め込みパイプラインです。高密度、疎、ONNX、遅延相互作用型の埋め込みに対応します。
- Faiss
 - 高密度ベクトルの効率的な類似検索とクラスタリングを行うライブラリです。
- GraphRAG
 - LLM を活用して非構造化テキストから意味のある構造化データを抽出するための、データパイプライン兼変換ツール群です。
- HippoRAG
 - 人間の長期記憶の神経生物学に着想を得た新しい検索拡張生成(RAG)フレームワークです。LLM が外部文書をまたいで知識を継続的に統合できるようにします。
- JamAI Base
 - 組み込みデータベース(SQLite)と組み込みベクトルデータベース(LanceDB)を、管理されたメモリ機能や RAG 機能とともに統合した、オープンソースの RAG バックエンドプラットフォームです。LLM、ベクトル埋め込み、リランカーのオーケストレーションと管理を内蔵し、使いやすい表計算シート風 UI とシンプルな REST API から利用できます。
- LangExtract
 - ユーザー定義の指示に基づいて非構造化テキスト文書から構造化情報を抽出する Python ライブラリです。臨床記録やレポートなどを処理して重要な詳細を特定・整理し、抽出したデータが原文に対応することを保証します。
- LightRAG
 - シンプルで高速な検索拡張生成フレームワークです。
- llmware
 - 小型の特化モデルを使って LLM ベースのアプリケーション(RAG、エージェントなど)を構築する統合フレームワークです。モデルは非公開環境にデプロイでき、企業のナレッジソースと安全に連携し、あらゆる業務プロセス向けに費用対効果よく調整・適応できます。
- Mem0
 - インテリジェントなメモリレイヤーにより AI アシスタントやエージェントを強化し、パーソナライズされた AI との対話を可能にします。
- NGT
 - 高次元ベクトル空間の大量データを対象に、高速な近似最近傍検索を実行するコマンドとライブラリを提供します。
- NMSLIB
 - Non-Metric Space Library(NMSLIB)は、効率的な類似検索ライブラリであり、一般的な非計量空間向け k-NN 手法を評価するツールキットです。
- Qdrant
 - 高度なフィルタリングに対応したオープンソースのベクトル類似検索エンジンです。
- R2R
 - R2R(RAG to Riches)は、ハイブリッド検索、マルチモーダル対応、高度な可観測性を備えた RAG アプリケーションの構築、デプロイ、スケーリングを行う包括的なプラットフォームです。
- RAGFlow
 - 深い文書理解に基づく RAG エンジンです。
- RAGxplorer
 - RAG の可視化を構築するツールです。
- RAG-FiT
 - LLM が外部情報を利用する能力を高めるため、特別に作成した RAG 拡張データセットでモデルをファインチューニングするライブラリです。
- TextWorld
 - 強化学習(RL)エージェントの学習・テスト向けに、テキストベースのゲームを生成する拡張可能なサンドボックス環境です。
- Zvec
 - 低レイテンシの類似検索を行う、オープンソースのインプロセス型ベクトルデータベースです。
産業用途向け自然言語処理
Section titled “産業用途向け自然言語処理 ”- aisuite
 - 複数の生成 AI プロバイダーを利用するための、シンプルで統一されたインターフェースです。
- Align-Anything
 - LLM、VLM などを含む、あらゆるモダリティの大規模モデル(any-to-any モデル)を人間の意図や価値観に沿わせることを目指します。
- BERTopic
 - Transformer と c-TF-IDF を活用して高密度クラスタを作成するトピックモデリング手法です。重要語をトピックの説明に残しながら、解釈しやすいトピックを生成します。
- Burr
 - チャットボット、エージェント、シミュレーションなど、意思決定を行うアプリケーションの開発を支援します。テレメトリー、永続化、デプロイなどの本番向け機能と、オープンソースで無料のローカルファーストな Burr UI が付属します。
- Context7
 - プロンプトや AI コーディングエージェント向けに最新のコードドキュメントを提供します。
- Dify
 - 直感的なインターフェースにエージェント型 AI ワークフロー、RAG パイプライン、エージェント機能、モデル管理、可観測性などを統合したオープンソース LLM アプリ開発プラットフォームです。プロトタイプから本番環境へすばやく移行できます。
- dspy
 - 基盤モデルを使ってプログラミングするためのフレームワークです。
- Dust
 - 大規模言語モデルアプリの設計とデプロイを支援します。
- ESPnet
 - エンドツーエンドの音声処理ツールキットです。
- FastChat
 - 大規模言語モデルを用いたチャットボットの学習、サービング、評価を行うオープンプラットフォームです。
- Flair
 - Zalando が開発した最先端 NLP 向けのシンプルなフレームワークで、PyTorch を直接基盤としています。
- FunASR
 - 50 以上の言語に対応する本番品質の ASR ツールキットです。VAD、句読点付与、話者ダイアライゼーション、感情認識を内蔵し、Docker/WebSocket/REST によるデプロイや ONNX ランタイムにも対応します。
- Fun-ASR
 - 中国語の方言を含む 31 言語に対応した LLM ベースの ASR です。句読点、タイムスタンプ、話者ダイアライゼーションをネイティブにサポートします。
- Gensim
 - 大規模コーパスを使ったトピックモデリング、文書インデックス作成、類似検索を行う Python ライブラリです。
- gpt-fast
 - シンプルで効率的な PyTorch ネイティブの Transformer テキスト生成です。
- Haystack
 - Transformer モデルや GPT-3 などの LLM を使ってデータを活用するオープンソース NLP フレームワークです。ChatGPT のような質問応答、セマンティック検索、テキスト生成などをすばやく構築する、本番利用可能なツールを提供します。
- Interactive Composition Explorer
 - 言語モデルプログラム向けの Python ライブラリ兼トレース可視化ツールです。
- Jan
 - パソコン上で完全オフライン動作するオープンソースの ChatGPT 代替ツールです。LLM をダウンロードしてローカルで実行でき、完全な制御とプライバシーを確保できます。
- Lamini
 - モデルをすばやくカスタマイズするための LLM エンジンです。
- LangChain
 - 合成可能性を通じて LLM を使うアプリケーションの構築を支援します。
- LlamaIndex
 - LlamaIndex(GPT Index)は、LLM アプリケーション向けのデータフレームワークです。
- LLaMA
 - LLaMA(arXiv)モデルを読み込んで推論を実行するための、最小限で改変しやすく読みやすいサンプルを目指しています。
- LLaMA-Factory
 - コードを書かずに CLI と Web UI から 100 以上の大規模言語モデルを簡単にファインチューニングできます。
- LLMBox
 - 統合学習パイプラインと包括的なモデル評価機能を備えた、LLM 実装のための総合ライブラリです。
- LLaMA2-Accessory
 - 大規模言語モデル(LLM)やマルチモーダル LLM の事前学習、ファインチューニング、デプロイを行うオープンソースツールキットです。
- LMFlow
 - 大規模機械学習モデルのファインチューニング向けに、拡張可能で便利かつ効率的なツールボックスです。
- Megatron-LM
 - 大規模言語モデルを学習するための、高度に最適化された効率的なライブラリです。
- MindNLP
 - MindSpore を基盤とする、使いやすく高性能な NLP・LLM フレームワークです。Hugging Face のモデルとデータセットに対応します。
- MLC LLM
 - さまざまなハードウェアバックエンドやネイティブアプリで任意の言語モデルをネイティブにデプロイできる汎用ソリューションです。誰もが独自の用途に合わせてモデル性能をさらに最適化できる、生産性の高いフレームワークでもあります。
- mlx-lm
 - MLX を使って Apple silicon 上でテキストを生成し大規模言語モデルをファインチューニングする Python パッケージです。Hugging Face Hub と連携し、量子化と分散推論に対応します。
- Ollama
 - 大規模言語モデルをローカルで手軽に使い始められます。
- olmOCR
 - 実環境の PDF 文書を扱う言語モデルの学習用ツールキットです。
- PaddleNLP
 - PaddlePaddle ディープラーニングフレームワークを基盤とする大規模言語モデル(LLM)開発スイートです。さまざまなハードウェアデバイスで、効率的な大規模モデル学習、損失のない圧縮、高性能推論に対応します。
- Promptise Foundry
 - エージェント型 AI と MCP サーバー向けの本番用 Python フレームワークです。自律実行環境、メモリ、ツール統合、ガバナンス(予算、健全性、ミッション、シークレット)、ガードレール、セマンティックキャッシュ、可観測性を網羅します。
- Semantic Kernel
 - OpenAI、Azure OpenAI、Hugging Face などの大規模言語モデル(LLM)を C#、Python、Java などの従来型プログラミング言語に統合する SDK です。数行のコードで連鎖させられるプラグインを定義できます。
- Sentence Transformers
 - 文、段落、画像の高密度ベクトル表現を簡単に計算できます。
- SpaCy
 - Python と Cython で高度な自然言語処理を行うライブラリです。
- SWIFT
 - ディープラーニングモデルのファインチューニングを行う、スケーラブルで軽量な基盤です。
- Tensorflow Lingvo
 - 特に系列モデル向けの、TensorFlow でニューラルネットワークを構築するフレームワークです。
- Tensorflow Text
 - TensorFlow 2.0 ですぐに使える、テキスト関連クラスと演算のコレクションを提供します。
- ToolBench
 - ツール学習向け大規模言語モデルの学習、サービング、評価を行うオープンプラットフォームです。
- Transformers
 - 自然言語処理(NLP)向け最先端の事前学習済みモデルを提供する Hugging Face のライブラリです。
産業用途向けレコメンダーシステム
Section titled “産業用途向けレコメンダーシステム ”- EasyRec
 - 大規模レコメンデーションアルゴリズム向けのフレームワークです。
- Gorse
 - 幅広いオンラインサービスにすばやく導入できる、汎用のオープンソースレコメンダーシステムを目指しています。
- Merlin
 - 特徴量エンジニアリングと前処理から、深層学習モデルの学習、本番環境での推論まで、エンドツーエンドの GPU 高速化レコメンダーシステムを提供するオープンソースライブラリです。
- Recommenders
 - Jupyter ノートブックで提供される、レコメンデーションシステム構築のためのベンチマークとベストプラクティス集です。
- TorchRec
 - 大規模レコメンデーションシステム(RecSys)に必要な一般的なスパース性・並列化プリミティブを提供する、PyTorch ドメインライブラリです。
産業用途向け強化学習
Section titled “産業用途向け強化学習 ”- Acme
 - シンプルで効率的、かつ読みやすいエージェントを提供することを目指す、強化学習(RL)の構成要素ライブラリです。
- AReaL
 - 強化学習ライブラリです。
- ChatLearn
 - 大規模言語モデル向けの柔軟で効率的な強化学習学習フレームワークです。FSDP2 や Megatron などの分散学習エンジン、vLLM や SGLang などの推論エンジンに対応し、GRPO や GSPO などの最新 RL アルゴリズムをサポートします。
- CleanRL
 - 研究に適した高品質な単一ファイル実装を提供する深層強化学習ライブラリです。実装は簡潔でシンプルながら、AWS Batch を使って数千の実験を実行できる規模に拡張できます。
- d3rlpy
 - 実践者と研究者向けのオフライン深層強化学習ライブラリです。
- D4RL
 - オフライン強化学習向けのオープンソースベンチマークです。
- Dopamine
 - 強化学習アルゴリズムの高速な試作を行う研究フレームワークです。ユーザーが自由に大胆なアイデアを試せる、小さく理解しやすいコードベースを提供することを目指しています(探索的研究)。
- EvoTorch
 - NNAISENSE で開発された、PyTorch 上に構築されたオープンソース進化計算ライブラリです。
- FinRL
 - 金融分野における強化学習の大きな可能性を実証した、初のオープンソースフレームワークです。
- Gymnasium
 - 学習アルゴリズムと環境の間で通信する標準 API と、その API に準拠する標準環境群を提供することで、強化学習アルゴリズムの開発・比較を行うオープンソース Python ライブラリです。
- Gymnasium-Robotics
 - Gymnasium API を使う強化学習用ロボット環境のコレクションです。MuJoCo 物理エンジンと保守されている MuJoCo Python バインディングで動作します。
- Jumanji
 - JAX で記述された強化学習(RL)環境のスイートで、産業界主導の研究向けに、明快でハードウェア高速化に対応した環境を提供します。
- MARLlib
 - RLlib を基盤とする包括的なマルチエージェント強化学習アルゴリズムライブラリです。MARL 研究コミュニティに、アルゴリズムの構築、学習、評価を行う統合プラットフォームを提供します。
- Mava
 - JAX で分散マルチエージェント強化学習を行うフレームワークです。
- Melting Pot - マルチエージェント強化学習向けのテストシナリオ集です。
- MetaDrive
 - 汎用化可能な強化学習のため、多様な運転シナリオを組み合わせる運転シミュレーターです。
- Minigrid
 - 強化学習研究向けの離散グリッドワールド環境集です。Gymnasium 標準 API に準拠し、軽量、高速、容易にカスタマイズできるよう設計されています。
- MiniWorld
 - 強化学習とロボティクス研究向けの、最小構成の 3D 室内環境シミュレーターです。
- ML-Agents
 - ゲームやシミュレーションを、知的エージェントの強化学習環境として利用できるオープンソースプロジェクトです。
- MushroomRL
 - モジュール性を備えた Python 強化学習(RL)ライブラリです。テンソル計算(PyTorch、TensorFlow など)や RL ベンチマーク(OpenAI Gym、PyBullet、DeepMind Control Suite など)向けの既知の Python ライブラリを簡単に利用できます。
- OmniSafe
 - 安全な強化学習(RL)研究を加速するために設計された基盤フレームワークです。
- OpenRLHF
 - 人間のフィードバックによる強化学習(RLHF)向けのオープンソースフレームワークです。
- PARL
 - 柔軟で高効率な強化学習フレームワークです。
- PettingZoo
 - Gymnasium のマルチエージェント版に相当する、マルチエージェント強化学習研究用の Python ライブラリです。
- ranx
 - 高速なランキング評価指標を Python で実装したライブラリです。Numba による高速なベクトル演算と自動並列化を活用します。
- RL4CO
 - 組合せ最適化(CO)における強化学習のあらゆる用途向け PyTorch ライブラリです。
- RL2
 - 強化学習ライブラリです。
- RLinf
 - 強化学習ライブラリです。
- ROLL
 - 強化学習ライブラリです。
- skrl
 - 読みやすさ、シンプルさ、アルゴリズム実装の透明性を重視して設計された、Python(PyTorch 使用)製のオープンソースモジュール型強化学習ライブラリです。
- SkyRL
 - 長期にわたる現実世界の RL タスク向けに、モジュール型学習フレームワーク、クロスプラットフォーム推論バックエンド、エージェント型パイプライン、Gymnasium 環境を提供するフルスタック強化学習ライブラリです。
- slime
 - RL スケーリング向けの LLM 事後学習フレームワークです。
- Stable Baselines
 - OpenAI Baselines のフォークで、強化学習アルゴリズムを実装しています。
- TF-Agents
 - コンテキスト付きバンディットと強化学習向けの、信頼性、スケーラビリティ、使いやすさを備えた TensorFlow ライブラリです。
- TorchRL
 - PyTorch 用のオープンソース強化学習(RL)ライブラリです。
- TRL
 - 強化学習で Transformer 言語モデルを学習します。
- veRL
 - LLM 向けに設計された、柔軟で効率的かつ産業レベルの RLHF 学習フレームワークです。
産業用途向けロボティクス
Section titled “産業用途向けロボティクス ”- AI2-THOR
 - AI エージェント向けの、写真に近いリアルさで操作可能なフレームワークです。
- Genesis
 - Embodied AI とロボットシミュレーション向けの物理プラットフォームです。
- Habitat-Sim
 - Embodied AI 研究向けの柔軟で高性能な 3D シミュレーターです。
- IsaacLab
 - NVIDIA Isaac Sim を活用する、ロボット学習向けの統合型モジュラーフレームワークです。
- LeRobot
 - 実世界のロボティクスと模倣学習向けのモデル、データセット、ツールを提供します。
- robosuite
 - MuJoCo 物理エンジンを活用するロボット学習シミュレーションフレームワークです。
- RoboVerse
 - 多様な環境を備えた包括的なロボットシミュレーションプラットフォームです。
産業用途向け可視化
Section titled “産業用途向け可視化 ”- Apache ECharts
 - ブラウザー向けの強力なインタラクティブグラフ・データ可視化ライブラリです。
- Apache Superset
 - 最新のエンタープライズ対応ビジネスインテリジェンス Web アプリケーションです。
- Bokeh
 - 最新の Web ブラウザーで美しく意味のあるデータ表示を実現する、Python 用インタラクティブ可視化ライブラリです。
- Bread Dataset Viewer - IDE をクラッシュさせることなく、大規模な機械学習データセット(CSV、JSON、Parquet など)をエディター内で直接表示・探索する VS Code 拡張機能です。
- Bread WandB Viewer - Weights & Biases の実験、ログ、アーティファクトを IDE 内で表示する VS Code 拡張機能です。Web UI への切り替えが不要になり、完全オフライン動作によりデータのプライバシーを維持します。
- Data Formulator
 - AI を活用してデータを変換し、豊かな可視化を反復的に作成します。
- ggplot2
 - R 向けのグラフィック文法の実装です。
- gradio
 - Python を書くだけで、モデルのデモをすばやく作成して共有できます。ブラウザー上でモデルを対話的にデバッグし、共同作業者からフィードバックを受け取り、何もデプロイせずに公開リンクを生成できます。
- Kangas
 - 大規模マルチメディアデータの探索、分析、可視化を行うツールです。大量のデータ表を記録するシンプルな Python API と、データセットに対して複雑なクエリを実行できる直感的なビジュアルインターフェースを提供します。
- matplotlib
 - さまざまな印刷品質の形式とプラットフォーム横断型の対話環境で高品質な図を作成する Python 2D プロットライブラリです。
- Model Explorer
 - 機械学習モデルを視覚化・探索するツールです。モデル構造を理解し、レイヤーの詳細を調べ、大規模なニューラルネットワーク内を移動するための、直感的なグラフベースのビューを提供します。
- Netron
 - ニューラルネットワーク、ディープラーニング、機械学習モデルのビューアーです。
- Perspective
 WebAssembly を介したストリーミングピボット可視化です。
- Plotly
 - Python 向けのインタラクティブなオープンソースのブラウザーベースグラフ作成ライブラリです。
- Redash
 - 複数のバックエンドを活用して大規模データセットに簡単にアクセスできるよう設計された、オープンソースの可視化フレームワークです。
- Rerun
 - ロボティクス、コンピュータービジョン、空間 AI 向けに設計された、マルチモーダルデータの記録、保存、クエリ、可視化を行うオープンソース SDK です。
- seaborn
 - matplotlib を基盤とする Python 可視化ライブラリで、高水準のインターフェースを通じて魅力的な統計グラフを描画します。
- Spotlight
 - 重要なデータセグメントとモデルの失敗パターンの特定を支援します。高品質なデータセットをキュレーションすることで、信頼性の高い機械学習モデルの構築と保守を可能にします。
- Streamlit
 - 簡単な Python スクリプトで機械学習プロジェクトのアプリを作成できます。ホットリロードに対応し、ファイルを編集・保存するとアプリが即座に更新されます。
- tensorboardX
 - シンプルな関数呼び出しで TensorBoard イベントを記録します。
- TensorBoard
 - 機械学習実験をホスト、追跡、共有しやすくする可視化ツールキットです。
- Torchvista
 - ネストしたモジュールの折りたたみや、エラーがあっても部分的な可視化を続行する機能に対応し、ノートブック内で任意の PyTorch モデルの順伝播を計算グラフとして表示する、対話型ノートブックツールです。
- Transformer Explainer
 - GPT のような Transformer ベースモデルの仕組みを誰もが学べるよう設計された、インタラクティブな可視化ツールです。
- Vega-Altair
 - Python 用の宣言的な統計可視化ライブラリです。
- ydata-profiling
 - 一貫性があり高速なソリューションで、1 行のコードから探索的データ分析(EDA)を実行できます。
メタデータ管理
Section titled “メタデータ管理 ”- Apache Atlas
 - Apache Atlas フレームワークは、企業が Hadoop 内でコンプライアンス要件を効果的かつ効率的に満たし、企業全体のデータエコシステムと連携できるようにする、拡張可能な中核的ガバナンスサービス群です。
- DataHub
 - LinkedIn の汎用メタデータ検索・発見ツールです。
- Marquez
 - データエコシステムのメタデータを収集、集約、可視化するオープンソースのメタデータサービスです。
- Metacat
 - 統合メタデータ探索 API サービスです。メタデータシステムのフェデレーションビュー、データセットに関する任意のメタデータ保存、メタデータ探索という課題の解決に重点を置いています。
- ML Metadata
 - ML 開発者やデータサイエンティストのワークフローに関連するメタデータを記録・取得するライブラリです。
モデル、データ、実験の管理
Section titled “モデル、データ、実験の管理 ”- Aim
 - AI 実験の記録、検索、比較を非常に簡単に行えます。
- ClearML
 - AI 向けの自動実験管理とバージョン管理ツールです(旧称 Trains)。
- DataHub - 最新のデータスタック向けオープンソースデータカタログです。
- Dolt
 - Git リポジトリと同じようにフォーク、クローン、ブランチ、マージ、プッシュ、プルができる SQL データベースです。
- DVC
 - DVC(Data Version Control)は、モデルのバージョン管理を可能にする Git のフォークです。
- HuggingFace Model Downloader
 - Hugging Face の Web サイトからモデルやデータセットをダウンロードするユーティリティです。LFS ファイルのマルチスレッドダウンロードに対応し、SHA256 チェックサム検証でダウンロードしたモデルの整合性を保証します。
- Keepsake
 - 機械学習向けのバージョン管理です。
- KitOps
 - 既存の AI/ML、開発、DevOps ツールと連携する、AI/ML プロジェクト向けのオープンで標準準拠なパッケージング・バージョン管理システムです。
- lakeFS
 - オブジェクトストレージ上に構築された、再現可能でアトミックなバージョン管理対応データレイクです。
- MLflow
 - 実験、再現性、デプロイなどを含む ML ライフサイクルを管理するオープンソースプラットフォームです。
- Polyaxon
 - Kubernetes 上で再現性とスケーラビリティを備えた機械学習・ディープラーニングを行うプラットフォームです - (動画)。
- Quilt
 - データとモデルのバージョン管理、再現性、デプロイを実現します。
- Sacred
 - 機械学習実験の設定、整理、ログ記録、再現を支援するツールです。
- TerminusDB
 - Git のようにデータを保存するグラフデータベース管理システムです。
- Weights & Biases
 - 機械学習の実験追跡、データセットのバージョン管理、ハイパーパラメーター探索、可視化、共同作業を行います。
モデルの学習とオーケストレーション
Section titled “モデルの学習とオーケストレーション ”- AutoTrain Advanced
 - 数回クリックするだけで機械学習モデルを学習できる、コード不要のソリューションです。
- Avalanche
 - 継続学習アルゴリズムの高速な試作、学習、再現可能な評価のために、共有・共同作業が可能なオープンソース(MIT ライセンス)のコードベースを提供するエンドツーエンドの継続学習ライブラリです。
- Axolotl
 - 複数の設定やアーキテクチャに対応し、さまざまな AI モデルのファインチューニングを効率化するツールです。
- BindsNET
 - 機械学習向けの生物学的着想アルゴリズムの開発を目的としたスパイキングニューラルネットワークシミュレーションライブラリです。
- CML
 - 機械学習プロジェクトで継続的インテグレーション/デリバリー(CI/CD)を実装するためのオープンソースライブラリです。
- CoreNet
 - 研究者やエンジニアが、基盤モデル(CLIP、LLM など)、物体分類、物体検出、セマンティックセグメンテーションを含む幅広いタスク向けに、標準モデルや新しい小規模・大規模モデルを学習できるディープニューラルネットワークツールキットです。
- DataLinter
 - プラグインを通じてデータやコードに依存しないよう設計された、データとコード向けのオープンソースコンテキスト対応リンターです。
- Determined
 - 分散学習、ハイパーパラメーター調整、モデル管理を統合してサポートするディープラーニング学習プラットフォームです(TensorFlow と PyTorch に対応)。
- dstack
 - ML チームのワークロードオーケストレーションを簡素化し、GPU 利用率を高めるオープンソースのコンテナオーケストレーターです。
- envd
 - データサイエンスおよび AI/ML エンジニアリングチーム向けの機械学習開発環境です。
- Fire-Flyer File System
 - AI の学習・推論ワークロードが抱える課題に対応するために設計された、高性能な分散ファイルシステムです。最新の SSD と RDMA ネットワークを活用して共有ストレージレイヤーを提供し、分散アプリケーションの開発を簡素化します。
- H2O-3
 - よりスマートなアプリケーション向けの高速でスケーラブルな機械学習プラットフォームです。ディープラーニング、勾配ブースティングと XGBoost、Random Forest、一般化線形モデル(ロジスティック回帰、Elastic Net)、K-Means、PCA、Stacked Ensembles、自動機械学習(AutoML)などに対応します。
- Hopsworks
 - 機械学習パイプラインの設計と運用を行う、データ集約型プラットフォームです。
- Ignite
 - PyTorch でのニューラルネットワーク学習と評価を、柔軟かつ透明性の高い方法で支援する高水準ライブラリです。
- Kubeflow
 - Google 社内の機械学習パイプラインを基盤とする、クラウドネイティブな機械学習プラットフォームです。
- Ludwig
 - LLM やその他のディープニューラルネットワークなど、カスタム AI モデルを構築するためのローコードフレームワークです。
- MFTCoder
 - CodeFuse のオープンソースプロジェクトです。大規模言語モデル(LLM)、特にコードタスク向け大規模言語モデル(Code-LLM)を対象に、正確で効率的なマルチタスクファインチューニング(MFT)を行います。
- MLeap
 - Spark、TensorFlow、sklearn 向けのパイプラインとモデルのシリアライズを標準化します。
- Nanotron
 - 3D 並列化を使い、さまざまなモデルを効率よく学習するための分散プリミティブを提供します。
- NeMo
 - NVIDIA NeMo は、大規模言語モデル(LLM)、マルチモーダルモデル(MM)、自動音声認識(ASR)、音声合成(TTS)、コンピュータービジョン(CV)領域に取り組む研究者や PyTorch 開発者向けに構築された、スケーラブルでクラウドネイティブな生成 AI フレームワークです。既存コードや事前学習済みモデルのチェックポイントを活用し、新しい生成 AI モデルを効率よく作成、カスタマイズ、デプロイできるよう設計されています。
- Prime
 - インターネットを介した効率的なグローバル分散 AI モデル学習のフレームワークです。
- PyCaret
 ) - モデルの学習とデプロイを行うローコードライブラリです(scikit-learn、XGBoost、LightGBM、spaCy)。
- Sematic
 - リソース負荷の高いパイプラインをシンプルな Python で構築するプラットフォームです。
- Skaffold
 - Kubernetes アプリケーションの継続的開発を支援するコマンドラインツールです。アプリケーションのソースコードをローカルで反復開発し、ローカルまたはリモートの Kubernetes クラスターにデプロイできます。
- TFX
 - TensorFlow を基盤とし、モニタリングとモデルのバージョン管理を含む、本番環境を重視した ML 設定フレームワークです。
- unsloth
 - LLM 向けファインチューニングと強化学習です。OpenAI gpt-oss、DeepSeek-R1、Qwen3、Gemma 3、TTS を、VRAM を 70% 削減しながら 2 倍高速に学習できます。
モデルストレージの最適化
Section titled “モデルストレージの最適化 ”- AWQ
 - LLM の圧縮と高速化のためのアクティベーションを考慮した重み量子化です。
- GGML
 - CPU 上での効率的な推論を可能にし、特に大規模言語モデル向けに最適化された高性能テンソルライブラリです。
- neural-compressor
 - 主要なフレームワーク向けに、量子化、枝刈り(スパース化)、蒸留、ニューラルアーキテクチャ探索などの一般的なモデル圧縮技術を提供します。
- NNEF - Neural Network Exchange Format(NNEF)は、異なる機械学習フレームワークやプラットフォーム間の相互運用性と移植性を実現する、ニューラルネットワークモデル表現用のオープン標準です。
- ONNX
 - ONNX(Open Neural Network Exchange)は、異なるフレームワークやプラットフォーム間での機械学習モデルの相互運用性と移植性を促進するオープンソース形式です。
- PFA - PFA(Portable Format for Analytics)は、予測モデルと分析ワークフローを移植可能な JSON ベース形式で表現・交換するための標準形式です。
- PMML - PMML(Predictive Model Markup Language)は、異なるアプリケーション間で予測モデルを表現・共有するための XML ベース標準です。
- Quanto
 - ディープラーニングモデルの量子化を簡素化することを目指しています。
プライバシーと安全性
Section titled “プライバシーと安全性 ”- AI Gateway
 - ガードレールを統合した超高速 AI ゲートウェイです。
- ART
 - ART(Adversarial Robustness Toolbox)は、回避、ポイズニング、抽出、推論の敵対的脅威から機械学習モデルとアプリケーションを防御・評価するためのツールを開発者や研究者に提供します。
- CipherChat
 - LLM の安全性アラインメントに関する汎化能力を評価するフレームワークです。
- DeepTeam
 - 大規模言語モデルシステムの侵入テストと安全確保を行う、使いやすいオープンソース LLM レッドチーミングフレームワークです。
- FATE
 - FATE(Federated AI Technology Enabler)は、データの安全性とプライバシーを保護しながら企業や機関がデータを共同利用できるようにする、世界初の産業グレードの連合学習オープンソースフレームワークです。
- FedML
 - あらゆる場所・規模で連合/分散機械学習を実現する、研究と本番を統合したエッジ・クラウドプラットフォームです。
- Flower
 - 統一されたアプローチを持つ連合学習フレームワークです。あらゆる ML ワークロードを、任意の ML フレームワークとプログラミング言語で連合できます。
- Google’s Differential Privacy
 - プライベートまたは機密情報を含む数値データセットから集計統計を生成するために利用できる、ε 差分プライバシーアルゴリズムの C++ ライブラリです。
- Guardrails
 - 大規模言語モデルの出力に構造、型、品質の保証を追加するパッケージです。
- NeMo Guardrails
 - LLM ベースの対話システムにプログラム可能なガードレールを簡単に追加できるオープンソースツールキットです。
- Opacus
 - 差分プライバシーを適用して PyTorch モデルを学習できるライブラリです。クライアント側でのコード変更を最小限に抑え、学習性能への影響も小さく、使用したプライバシー予算を随時追跡できます。
- OpenFL
 - 連合学習のための Python フレームワークです。データサイエンティストが柔軟に拡張でき、簡単に習得できるツールとして設計されています。Intel Internet of Things Group(IOTG)と Intel Labs が開発しています。
- PySyft
 - 安全でプライベートなディープラーニングのための Python ライブラリです。PyTorch 内でマルチパーティ計算(MPC)を利用し、プライベートデータをモデル学習から切り離します。
- Tensorflow Privacy
 - 差分プライバシーを適用して機械学習モデルを学習する TensorFlow オプティマイザーの実装を含む Python ライブラリです。
- TF Encrypted
 - TensorFlow で暗号化データ上の機密機械学習を実現するフレームワークです。
その他の Awesome リスト
Section titled “その他の Awesome リスト”- Awesome Agentic Engineering Resources
 - エージェント型 AI システムを構築するためのリソース、ツール、参考資料を厳選したコレクションです。
- Awesome AI Gateway
 - AI ゲートウェイと LLM プロキシ(LiteLLM、OpenRouter、Portkey、Kong、Higress、new-api)を、コスト、コンプライアンス、セルフホスト、ルーティングの観点から比較する、厳選されたバイリンガル(EN/zh-CN)リストです。意思決定ツリー、再現可能なコストベンチマーク、選定スコアカードを備えています。
- Awesome AI Regulation
 - さまざまな法域で ML システムを責任を持ってデプロイするために不可欠なガバナンス、コンプライアンス、規制の枠組みを網羅します。
- Awesome AI Tokenomics
 - モニタリング、最適化、キャッシュ、モデル選択、コンテキスト管理など、AI システムにおけるトークンコストと効率を扱います。
- Awesome Production GenAI
 - LLM 運用、プロンプトエンジニアリング、生成 AI に特化したモニタリング・安全性ツールなど、生成 AI のデプロイに焦点を当てています。
- Awesome RAG Production
 - スケーラブルな RAG システムの構築に向けた、本番品質のツールとベストプラクティスを厳選したリストです。
コントリビューター
Section titled “コントリビューター”HagiCode
HagiCode はエージェント型コーディングワークスペースです。豊富で便利な UI インタラクションにより、計画・エージェント実行・プロジェクト作業を始めやすく、進めやすくし、開発をより魅力的な体験にします。
豊富で便利な UI インタラクションで、計画からプロジェクト作業までを分かりやすく進められます。

- スマートOpenSpec ワークフローが意図を、提案・設計・タスクから変更のリリースまで実行可能な道筋にします。
- 効率的マルチエージェント実行で調査・実装・レビューを並行して進め、複数リポジトリや使い慣れた Agent CLI にも対応します。
- 興味深い豊富で便利な UI インタラクションにより、計画・エージェント実行・プロジェクト作業を始めやすく、進めやすくします。
Windows 版をダウンロード
HagiCode を共有

アイデアを、出荷できるソフトウェアへ。
HagiCode はエージェント型コーディングワークスペースです。OpenSpec ワークフローで変更を計画し、マルチエージェント実行で進め、Hero Scenario で長い作業の進み具合を見える化して、アイデアを出荷できるソフトウェアにします。
- スマート
- OpenSpec ワークフローが、意図を提案からリリースまでの実行可能な道筋にします。
- 効率的
- マルチエージェント実行で、調査・実装・レビューを並行して進めます。
- 楽しい
- 使いやすい UI で、計画・Agent 実行・プロジェクト作業を進めやすくします。
© 2026 HagiCode | Powered By hagilight-starlight@0.21.0 | Branch: main | Commit: 745b50b | Built: