
Chinese NLP
Source: https://github.com/crownpku/Awesome-Chinese-NLP at
923e20ae6872
License: Apache-2.0
Read the English original
This edition is an AI-assisted translation.
Chinese NLP
Section titled “Chinese NLP”
中国語の自然言語処理(NLP)のための厳選されたリソース一覧。
中国語自然言語処理に関する資料
画像は復旦大学の邱錫鵬教授による
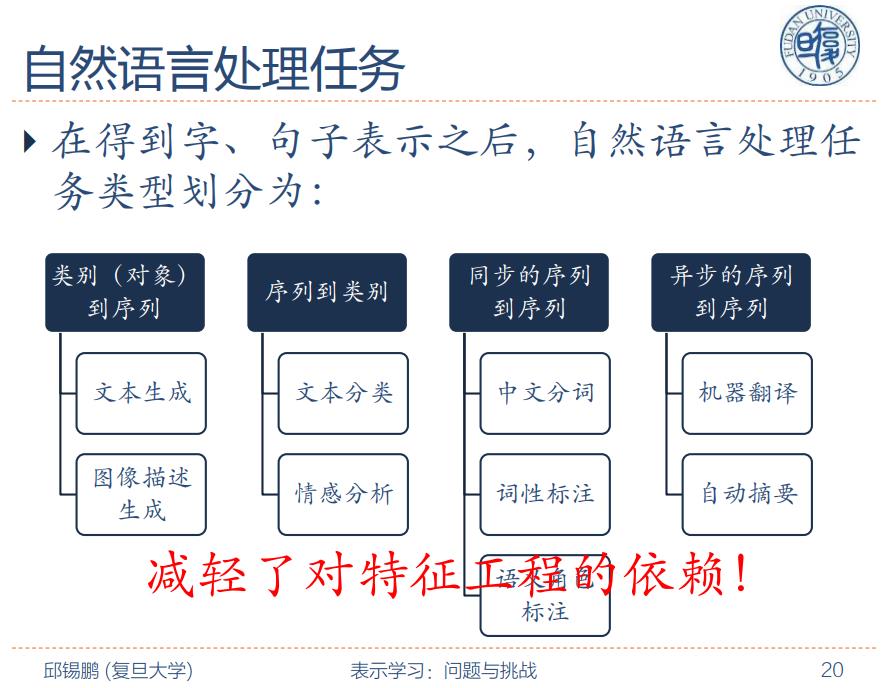
目次 Contents
Section titled “目次 Contents”中国語 NLP ツールキット Chinese NLP Toolkits
Section titled “中国語 NLP ツールキット Chinese NLP Toolkits”総合 NLP ツールキット Toolkits
Section titled “総合 NLP ツールキット Toolkits”-
THULAC 中文词法分析工具包 by 清华 (C++/Java/Python)
-
NLPIR by 中科院 (Java)
-
LTP 语言技术平台 by 哈工大 (C++) pylyp LTP の Python ラッパー
-
FudanNLP by 复旦 (Java)
-
BaiduLac by 百度 Baidu のオープンソース中国語語彙解析ツール。分詞、品詞タグ付け、固有表現認識を含む。
-
HanLP (Java)
-
FastNLP (Python) 軽量な NLP 処理スイート。
-
SnowNLP (Python) 中国語テキストを処理するための Python ライブラリ
-
YaYaNLP (Python) 純 Python で書かれた中国語自然言語処理パッケージ。「牙牙学语」にちなんで命名
-
小明NLP (Python) 軽量な中国語自然言語処理ツール
-
DeepNLP (Python) Tensorflow 上に実装された、中国語事前学習モデル付きの深層学習 NLP パイプライン。
-
chinese_nlp (C++ & Python) 中国語自然言語処理ツールと例
-
lightNLP (Python) Pytorch と torchtext に基づく自然言語処理深層学習フレームワーク
-
Chinese-Annotator (Python) 中国語テキスト注釈ツール Annotator for Chinese Text Corpus
-
Poplar (Typescript) 自然言語処理(NLP)のための Web ベースの注釈ツール
-
Jiagu (Python) Jiagu は BiLSTM などのモデルを基に大規模コーパスで学習している。中国語分詞、品詞タグ付け、固有表現認識、感情分析、知識グラフ関係抽出、キーワード抽出、テキスト要約、新語発見などの機能を提供。
-
SmoothNLP (Python & Java) 解釈可能な NLP 技術に注力
-
FoolNLTK (Python & Java) 中国語自然言語ツールキット A Chinese Nature Language Toolkit
一般的な英語または多言語対応 NLP ツールキット Popular NLP Toolkits for English/Multi-Language
Section titled “一般的な英語または多言語対応 NLP ツールキット Popular NLP Toolkits for English/Multi-Language”-
CoreNLP by Stanford (Java) コア NLP ツールの Java スイート。
-
Stanza by Stanford (Python) 多くの人間の言語向けの Python NLP ライブラリ
-
NLTK (Python) Natural Language Toolkit
-
textacy (Python) spaCy の前後で使える NLP
-
OpenNLP (Java) 機械学習ベースの自然言語テキスト処理ツールキット。
-
gensim (Python) Gensim はトピックモデリング、文書インデックス、類似性検索のための Python ライブラリ。
-
Kashgari - シンプルで強力な NLP フレームワーク。5 分で固有表現認識(NER)、品詞タグ付け(PoS)、テキスト分類の先進モデルを構築。BERT と word2vec を含む。
中国語単語分割 Chinese Word Segment
Section titled “中国語単語分割 Chinese Word Segment”-
Jieba 结巴中文分词 (Python および多数の他言語派生) 最高の Python 中国語分詞コンポーネント
-
北大中文分词工具 (Python) 高精度な中国語分詞ツール。使いやすく、既存のオープンソースツールと比べて分詞精度を大幅に向上。
-
kcws 深度学习中文分词 (Python) BiLSTM+CRF と IDCNN+CRF
-
ID-CNN-CWS (Python) 中国語単語分割のための反復膨張畳み込み Iterated Dilated Convolutions for Chinese Word Segmentation
-
Genius 中文分词 (Python) Genius は CRF(条件付き確率場)アルゴリズムを用いたオープンソースの Python 中国語分詞コンポーネント。
-
loso 中文分词 (Python)
-
yaha “哑哈”中文分词 (Python)
-
ChineseWordSegmentation (Python) コーパス不要の中国語分詞アルゴリズム Chinese word segmentation algorithm without corpus
-
Go 言語高性能分詞 (Go) 効率的な Go テキスト分割。英語、中国語、日本語などに対応。
-
Ansj中文分词 (java) n-Gram+CRF+HMM に基づく中国語分詞の Java 実装
情報抽出 Information Extraction
Section titled “情報抽出 Information Extraction”-
MITIE (C++) 情報抽出のためのライブラリとツール
-
Duckling (Haskell) 入力文字列に対して合成可能な言語ルールを表現・テスト・評価するための言語、エンジン、ツール群。
-
IEPY (Python) IEPY は関係抽出に焦点を当てたオープンソースの情報抽出ツール。
-
Snorkel 情報抽出に焦点を当てた学習データ作成・管理システム
-
bert-chinese-ner 事前学習言語モデル BERT で中国語 NER を行う
-
Information-Extraction-Chinese IDCNN/biLSTM+CRF による中国語固有表現認識、biGRU+2ATT による関係抽出 中文实体识别与关系提取
-
Familia Baidu 製の A Toolkit for Industrial Topic Modeling
-
Text Classification 深層学習による様々なテキスト分類モデル等。テストデータに Zhihu の Q&A コーパスを使用。
-
ComplexEventExtraction 中国語複合イベントの概念と顕在パターン。条件・因果・連鎖・反転などのイベント抽出を行い、事件・事象グラフを構築。
-
TextRank4ZH 中国語テキストからキーワードと要約を自動抽出
質問応答とチャットボット QA & Chatbot
Section titled “質問応答とチャットボット QA & Chatbot”-
Rasa NLU (Python) 自然言語を構造化データに変換。中国語フォークは Rasa NLU Chi
-
Rasa Core (Python) 対話ソフトウェアのための機械学習ベース対話エンジン
-
Chatstack 中国語 NLU システム構築のための全パイプライン UI
-
Snips NLU (Python) Snips NLU は自然言語の文を解析し構造化情報を抽出する Python ライブラリ。
-
DeepPavlov (Python) エンドツーエンド対話システム構築とチャットボット学習のためのオープンソースライブラリ。
-
ChatScript 自然言語ツール/対話マネージャ。ルールベースのチャットボットエンジン。
-
Chatterbot (Python) ChatterBot はチャットボット作成のための機械学習対話エンジン。
-
Chatbot (Python) ベクトルマッチングに基づく文脈型チャットボット
-
Tipask (PHP) Laravel ベースのオープンソース PHP 質問応答システム。拡張容易、高い負荷能力と安定性。
-
QuestionAnsweringSystem (Java) 質問を自動解析して候補回答を提示する Java 製の人間対機械質問応答システム。
-
QA-Snake (Python) 複数検索エンジンと深層学習技術に基づく自動質問応答
-
深層学習による中国語読解質問応答システム (Python)
-
AnyQ by Baidu FAQ 集合向け質問応答システムフレームワークとテキスト意味一致ツール SimNet を中心に含む。
-
DuReader 中国語読解 Baseline コード (Python)
-
SmartQQ ベースの自動ボットフレームワーク (Python)
-
QASystemOnMedicalKG (Python) 疾患を中心とした一定規模の医療知識グラフを用い、自動質問応答と分析を提供。
-
GPT2-chitchat (Python) 中国語雑談用の GPT2 モデル
-
CDial-GPT (Python) 大規模な中国語対話データセットと、それを用いた中国語対話事前学習モデル(中国語 GPT モデル)を提供
マルチモーダル表現と検索 Multi-Modal Representation & Retrieval
Section titled “マルチモーダル表現と検索 Multi-Modal Representation & Retrieval”- Chinese-CLIP (Python) Chinese-CLIP は中国語マルチモーダル画像・テキスト表現事前学習モデル。OpenAI の CLIP 構造に基づき、大規模な中国語ネイティブ画像・テキストコーパスで事前学習。複数のモデル規模をオープンソース化し、技術報告論文と検索デモを公開。
中国語コーパス Corpus
Section titled “中国語コーパス Corpus”-
農業知識グラフ 農業分野の情報検索、固有表現認識、関係抽出、分類木構築、データマイニング
-
異なるコーパス・モデル(BERT、GPT 等)に基づく中国語事前学習モデル 異なるコーパス・エンコーダ・タスクに対応する中国語事前学習モデルフレームワーク(from RUC and Tencent)
-
OpenCLaP マルチドメインのオープンソース中国語事前学習言語モデルリポジトリ(from Tsinghua)
-
UDChinese (spaCy の PoS 学習用)
-
Tencent AI Lab Embedding Corpus for Chinese Words and Phrases
-
中国語 GPT2 学習コード 詩、ニュース、小説の生成や汎用言語モデルの学習が可能。
-
中国語言語理解ベンチマーク ChineseGLUE 代表的なデータセット、ベース(事前学習)モデル、コーパス、リーダーボードを含む。
-
中華新華字典データベース 諺、成語、単語、漢字を含む。
-
Synonyms: 中国語類義語ツールキット 中国語 Wikipedia と word2vec で学習した類義語ライブラリを Python パッケージ化。
-
Chinese_conversation_sentiment 感情分析に有用な中国語感情データセット。
-
中国語緊急事態コーパス Chinese Emergency Corpus
-
dgk_lost_conv 中国語対話コーパス chinese conversation corpus
-
中英語対話システム学習用コーパス Datasets for Training Chatbot System
-
中国株公告情報クローラ Python スクリプトで巨潮ネットワークのサーバーから中国株(sz, sh)の公告(上場企業・監査機関)を取得
-
tushare 財務データインターフェース TuShare は無料のオープンソース Python 財務データインターフェースパッケージ。
-
金融テキストデータセット SmoothNLP 金融文本数据集(公开) Public Financial Datasets for NLP Researches
-
保険業界コーパス [52nlp 紹介 Blog] 機械学習タスク向け保険分野のオープンデータ OpenData in insurance area for Machine Learning Tasks
-
最も完全な中華古詩詞データベース 唐・宋両朝ほぼ 14000 人の詩人、約 5.5 万首の唐詩と 26 万首の宋詩。宋代 1564 人の詞人、21050 首の詞。
-
中国語小規模コーパス 中国語固有表現認識、関係認識、読解などの少量データを含む
-
Chinese-Literature-NER-RE-Dataset 中国語文学テキスト向け談話レベルの固有表現認識・関係抽出データセット A Discourse-Level Named Entity Recognition and Relation Extraction Dataset for Chinese Literature Text
-
ChineseTextualInference 中国語テキスト含意プロジェクト。88 万組のテキスト含意データセットの翻訳・構築と、深層学習ベースの含意判定モデル構築を含む。
-
大規模中国語自然言語処理コーパス Wikipedia (wiki2019zh)、ニュース (news2016zh)、百科 Q&A (baike2018qa)
-
中国語人名コーパス 中国語の姓名、姓、名、呼称、日本人名、翻訳人名、英語人名。
-
企業名・機関名コーパス 企業略称、省略形、ブランド語、企業名。
-
中国語センシティブワード辞書 センシティブワードフィルタの複数実装+約 1 万語のセンシティブワード辞書
-
中国語省略語データセット 否定完全形を含む中国語省略語のコーパス A corpus of Chinese abbreviation, including negative full forms.
-
中国語データ前処理素材 中国語分詞辞書と中国語ストップワード
-
SentiBridge: 中国語実体感情知識ベース 人々が実体をどう記述するかを描写。ニュース、旅行、飲食を含む計 30 万組。
-
OpenCorpus 自由利用可能な(中国語)コーパスの集積。
-
ChineseNlpCorpus 感情/意見/コメントの傾向分析、中国語固有表現認識、推薦システム
-
FinancialDatasets SmoothNLP 金融文本数据集(公开) Public Financial Datasets for NLP Researches Only
-
People’s Daily & Children’s Fairy Tale PD&CFT: 中国語読解データセット A Chinese Reading Comprehension Dataset
中国語 NLP の学術組織およびコンテスト Organizations
Section titled “中国語 NLP の学術組織およびコンテスト Organizations”-
NLP Conference Calender NLP コミュニティの主要な会議、ジャーナル、ワークショップ、共有タスク。
-
2017 AI-Challenger 画像中国語記述 与えられた画像の主要情報を一文で記述し、中国語文脈での画像理解課題に挑む。
-
2017 AI-Challenger 英中機械テキスト翻訳 大規模データで英中テキスト機械翻訳モデルの能力を向上。
-
2017 知乎看山杯機械学習チャレンジ 知乎の質問とトピックタグの紐付け訓練データから、未ラベルデータを自動タグ付けするモデルを学習。
-
2018 オープンドメイン中国語質問応答タスク 与えられた中国語の質問に対し、システムが知識ベースから実体や属性値を選んで回答とする。
-
2018 微衆銀行インテリジェント顧客問い合わせ文マッチング大会 中国語の実際の顧客コーパスに対し問い合わせ意図をマッチング。2 文が与えられたとき意図の近さを判定。
中国語 NLP 商用サービス Industry
Section titled “中国語 NLP 商用サービス Industry”-
華為雲 NLP 企業や開発者向けのテキスト分析・マイニングクラウドサービス。テキストを効率的に処理。
-
百度雲 NLP 業界最先端の自然言語処理技術、高品質なテキスト処理・理解技術を提供
-
阿里雲 NLP 企業や開発者向けのテキスト分析・マイニングの中核ツール
-
騰訊雲 NLP 並列計算と分散クローラに独特の意味解析技術を組み合わせ、NLP・トランスコード・抽出・データ取得を一括満たす
-
訊飛開放平台 音声対話を中核とする AI オープンプラットフォーム
-
搜狗実験室 分詞と品詞タグ付け
-
玻森データ 上海玻森データ科技。中国語意味解析技術に特化
-
雲孚科技 NLP ツールキット、知識グラフ、テキストマイニング、対話システム、世論分析など
-
智言科技 深層学習と知識グラフ技術に注力する AI 企業
-
追一科技 深層学習と自然言語処理を主力とする
学習資料 Learning Materials
Section titled “学習資料 Learning Materials”-
Stanford CS224n Natural Language Processing with Deep Learning 2017
-
[Georgia Tech CS 4650 および 7650「Natural Language」のコース資料] (https://github.com/jacobeisenstein/gt-nlp-class)
-
Speech and Language Processing by Dan Jurafsky and James H. Martin
-
テキスト処理実践講義資料 テキスト特徴抽出(TF-IDF)、テキスト分類、クラスタリング、word2vec 単語ベクトル学習、類義語詞林による中国語類似度計算、文書自動要約、情報抽出、感情分析と意見マイニング等の実験を含む。
-
nlp_tasks Natural Language Processing Tasks and Selected References
-
NLP 研究入門の道 清華大学の劉知遠先生による
-
Chinese NLP 中国語自然言語処理の共有タスク、データセット、最新の成果
HagiCode
HagiCode はエージェント型コーディングワークスペースです。豊富で便利な UI インタラクションにより、計画・エージェント実行・プロジェクト作業を始めやすく、進めやすくし、開発をより魅力的な体験にします。
豊富で便利な UI インタラクションで、計画からプロジェクト作業までを分かりやすく進められます。

- スマートOpenSpec ワークフローが意図を、提案・設計・タスクから変更のリリースまで実行可能な道筋にします。
- 効率的マルチエージェント実行で調査・実装・レビューを並行して進め、複数リポジトリや使い慣れた Agent CLI にも対応します。
- 興味深い豊富で便利な UI インタラクションにより、計画・エージェント実行・プロジェクト作業を始めやすく、進めやすくします。
Windows 版をダウンロード
HagiCode を共有

アイデアを、出荷できるソフトウェアへ。
HagiCode はエージェント型コーディングワークスペースです。OpenSpec ワークフローで変更を計画し、マルチエージェント実行で進め、Hero Scenario で長い作業の進み具合を見える化して、アイデアを出荷できるソフトウェアにします。
- スマート
- OpenSpec ワークフローが、意図を提案からリリースまでの実行可能な道筋にします。
- 効率的
- マルチエージェント実行で、調査・実装・レビューを並行して進めます。
- 楽しい
- 使いやすい UI で、計画・Agent 実行・プロジェクト作業を進めやすくします。
© 2026 HagiCode | Powered By hagilight-starlight@0.21.0 | Branch: main | Commit: 745b50b | Built: