
Chinese NLP
Source: https://github.com/crownpku/Awesome-Chinese-NLP at
923e20ae6872
License: Apache-2.0
Read the English original
This edition is an AI-assisted translation.
中文自然語言處理(Chinese NLP)
Section titled “中文自然語言處理(Chinese NLP)”
針對中文自然語言處理(NLP)的精選資源列表。
中文自然語言處理相關資料
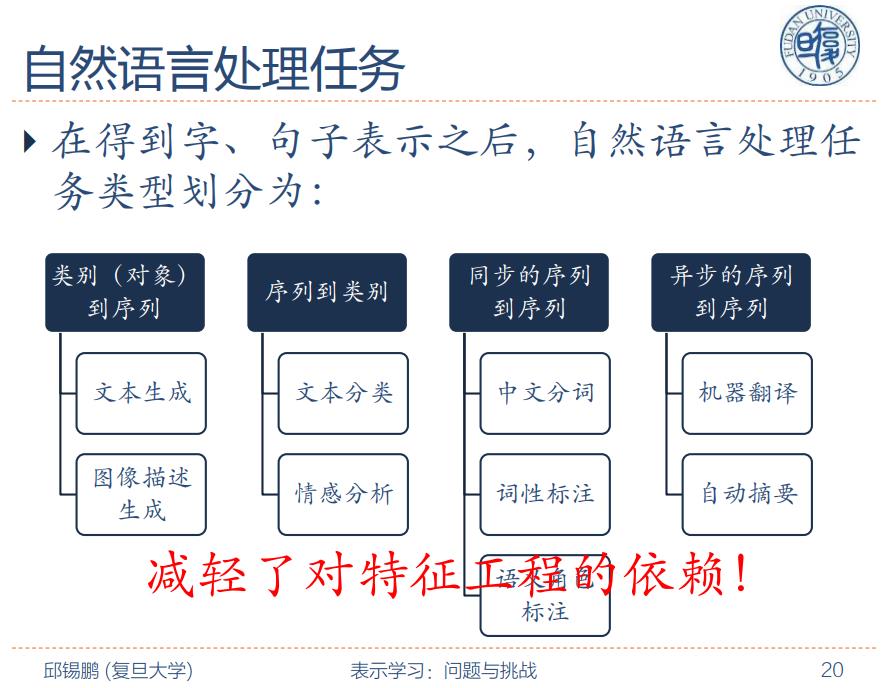
圖片來自復旦大學邱錫鵬教授
目錄 Contents
Section titled “目錄 Contents”中文 NLP 工具 Chinese NLP Toolkits
Section titled “中文 NLP 工具 Chinese NLP Toolkits”綜合 NLP 工具包 Toolkits
Section titled “綜合 NLP 工具包 Toolkits”-
THULAC 中文詞法分析工具包 by 清華 (C++/Java/Python)
-
NLPIR by 中科院 (Java)
-
LTP 語言技術平台 by 哈工大 (C++) pylyp LTP 的 python 封裝
-
FudanNLP by 復旦 (Java)
-
BaiduLac by 百度 Baidu 開源的中文詞法分析工具,包含分詞、詞性標註與命名實體識別。
-
HanLP (Java)
-
FastNLP (Python) 一款輕量級的 NLP 處理套件。
-
SnowNLP (Python) 用於處理中文文本的 Python 庫
-
YaYaNLP (Python) 純 python 編寫的中文自然語言處理包,取名於「牙牙學語」
-
小明NLP (Python) 輕量級中文自然語言處理工具
-
DeepNLP (Python) 基於 Tensorflow 實作、帶有中文預訓練模型的深度學習 NLP 流水線。
-
chinese_nlp (C++ & Python) 中文自然語言處理工具與範例
-
lightNLP (Python) 基於 Pytorch 和 torchtext 的自然語言處理深度學習框架
-
Chinese-Annotator (Python) 中文文本標註工具 Annotator for Chinese Text Corpus
-
Poplar (Typescript) 基於 Web 的自然語言處理(NLP)標註工具
-
Jiagu (Python) Jiagu 以 BiLSTM 等模型為基礎,使用大規模語料訓練而成。將提供中文分詞、詞性標註、命名實體識別、情感分析、知識圖譜關係抽取、關鍵詞抽取、文本摘要、新詞發現等常用自然語言處理功能。
-
SmoothNLP (Python & Java) 專注於可解釋的 NLP 技術
-
FoolNLTK (Python & Java) 一個中文自然語言處理工具包 A Chinese Nature Language Toolkit
常用的英文或支援多語言的 NLP 工具包 Popular NLP Toolkits for English/Multi-Language
Section titled “常用的英文或支援多語言的 NLP 工具包 Popular NLP Toolkits for English/Multi-Language”-
CoreNLP by Stanford (Java) 一套 Java 核心 NLP 工具。
-
Stanza by Stanford (Python) 支援多種人類語言的 Python NLP 庫
-
NLTK (Python) Natural Language Toolkit 自然語言工具包
-
textacy (Python) 在 spaCy 之前與之後都能用的 NLP
-
OpenNLP (Java) 基於機器學習的自然語言文本處理工具包。
-
gensim (Python) Gensim 是一個用於主題建模、文件索引與大規模語料相似度檢索的 Python 庫。
-
Kashgari - 簡單而強大的 NLP 框架,5 分鐘構建用於命名實體識別(NER)、詞性標註(PoS)與文本分類的先進模型。包含 BERT 與 word2vec。
中文分詞 Chinese Word Segment
Section titled “中文分詞 Chinese Word Segment”-
Jieba 結巴中文分詞 (Python 及大量其它程式語言衍生) 做最好的 Python 中文分詞組件
-
北大中文分詞工具 (Python) 高準確度中文分詞工具,簡單易用,跟現有開源工具相比大幅提高了分詞的準確率。
-
kcws 深度學習中文分詞 (Python) BiLSTM+CRF 與 IDCNN+CRF
-
ID-CNN-CWS (Python) 用於中文分詞的迭代膨脹卷積 Iterated Dilated Convolutions for Chinese Word Segmentation
-
Genius 中文分詞 (Python) Genius 是一個開源的 python 中文分詞組件,採用 CRF(條件隨機場)演算法。
-
loso 中文分詞 (Python)
-
yaha “啞哈”中文分詞 (Python)
-
ChineseWordSegmentation (Python) 無需語料庫的中文分詞演算法 Chinese word segmentation algorithm without corpus
-
Go 語言高效能分詞 (Go) Go 高效文本分詞;支援英文、中文、日文等。
-
Ansj中文分詞 (java) 基於 n-Gram+CRF+HMM 的中文分詞 java 實作
資訊擷取 Information Extraction
Section titled “資訊擷取 Information Extraction”-
MITIE (C++) 用於資訊擷取的庫與工具
-
Duckling (Haskell) 用於表達、測試與評估可組合語言規則的引擎與工具。
-
IEPY (Python) IEPY 是一個專注於關係抽取的開源資訊擷取工具。
-
Snorkel 專注於資訊擷取的訓練資料建立與管理系統
-
bert-chinese-ner 使用預訓練語言模型 BERT 做中文 NER
-
Information-Extraction-Chinese 使用 IDCNN/biLSTM+CRF 做中文命名實體識別、biGRU+2ATT 做關係抽取的中文實體識別與關係提取
-
Familia 百度出品的工業級主題建模工具包 A Toolkit for Industrial Topic Modeling
-
Text Classification 各類深度學習文本分類模型等。用知乎問答語料作為測試資料。
-
ComplexEventExtraction 中文複合事件的概念與顯式模式,包括條件事件、因果事件、順承事件、反轉事件等事件抽取,並形成事理圖譜。
-
TextRank4ZH 從中文文本中自動提取關鍵詞和摘要
問答和聊天機器人 QA & Chatbot
Section titled “問答和聊天機器人 QA & Chatbot”-
Rasa NLU (Python) 將自然語言轉為結構化資料,中文分支見 Rasa NLU Chi
-
Rasa Core (Python) 基於機器學習的對話引擎,用於會話軟體
-
Chatstack 用於構建中文 NLU 系統的完整流水線 UI
-
Snips NLU (Python) Snips NLU 是一個能夠解析自然語言句子並提取結構化資訊的 Python 庫。
-
DeepPavlov (Python) 用於構建端到端對話系統與訓練聊天機器人的開源庫。
-
ChatScript 自然語言工具/對話管理器,基於規則的聊天機器人引擎。
-
Chatterbot (Python) ChatterBot 是一個用於創建聊天機器人的機器學習對話引擎。
-
Chatbot (Python) 基於向量匹配的情境式聊天機器人
-
Tipask (PHP) 一款開放源碼的 PHP 問答系統,基於 Laravel 框架開發,容易擴展,具有強大的負載能力和穩定性。
-
QuestionAnsweringSystem (Java) 一個 Java 實現的人機問答系統,能夠自動分析問題並給出候選答案。
-
QA-Snake (Python) 基於多搜尋引擎和深度學習技術的自動問答
-
使用深度學習演算法實現的中文閱讀理解問答系統 (Python)
-
AnyQ by Baidu 主要包含面向 FAQ 集合的問答系統框架、文本語義匹配工具 SimNet。
-
DuReader 中文閱讀理解 Baseline 代碼 (Python)
-
基於 SmartQQ 的自動機器人框架 (Python)
-
QASystemOnMedicalKG (Python) 以疾病為中心的一定規模醫藥領域知識圖譜,並以該知識圖譜完成自動問答與分析服務。
-
GPT2-chitchat (Python) 用於中文閒聊的 GPT2 模型
-
CDial-GPT (Python) 提供了一個大規模中文對話資料集,並提供了在此資料集上的中文對話預訓練模型(中文 GPT 模型)
多模態表徵與檢索 Multi-Modal Representation & Retrieval
Section titled “多模態表徵與檢索 Multi-Modal Representation & Retrieval”- Chinese-CLIP (Python) Chinese-CLIP 是中文多模態圖文表徵預訓練模型。其基於 OpenAI 的 CLIP 模型結構,利用大規模中文原生圖文語料完成預訓練,目前開源了多個模型規模,同時公開了技術報告論文及檢索 demo
中文語料 Corpus
Section titled “中文語料 Corpus”-
農業知識圖譜 農業領域的資訊檢索,命名實體識別,關係抽取,分類樹構建,資料挖掘
-
基於不同語料、不同模型(比如 BERT、GPT)的中文預訓練模型 中文預訓練模型框架,支援不同語料、編碼器、目標任務的預訓練模型(from RUC and Tencent)
-
OpenCLaP 多領域開源中文預訓練語言模型倉庫 (from Tsinghua)
-
UDChinese (用於訓練 spaCy POS)
-
Tencent AI Lab Embedding Corpus for Chinese Words and Phrases
-
中文 GPT2 訓練代碼 可以寫詩,新聞,小說,或是訓練通用語言模型。
-
中文語言理解測評基準 ChineseGLUE 包括代表性的資料集、基準(預訓練)模型、語料庫、排行榜。
-
中華新華字典資料庫 包括歇後語,成語,詞語,漢字。
-
Synonyms: 中文近義詞工具包 基於維基百科中文和 word2vec 訓練的近義詞庫,封裝為 python 包文件。
-
Chinese_conversation_sentiment 一個可用於情感分析的中文情感資料集。
-
中文突發事件語料庫 Chinese Emergency Corpus
-
dgk_lost_conv 中文對白語料 chinese conversation corpus
-
用於訓練中英文對話系統的語料庫 Datasets for Training Chatbot System
-
中國股市公告資訊爬取 透過 python 腳本從巨潮網絡的伺服器獲取中國股市(sz, sh)的公告(上市公司和監管機構)
-
tushare 財經資料介面 TuShare 是一個免費、開源的 python 財經資料介面包。
-
金融文本資料集 SmoothNLP 金融文本資料集(公開) Public Financial Datasets for NLP Researches
-
保險行業語料庫 [52nlp 介紹 Blog] 面向機器學習的保險領域開放資料 OpenData in insurance area for Machine Learning Tasks
-
最全中華古詩詞資料庫 唐宋兩朝近一萬四千古詩人, 接近 5.5 萬首唐詩加 26 萬宋詩. 兩宋時期 1564 位詞人,21050 首詞。
-
中文語料小資料 包含了中文命名實體識別、中文關係識別、中文閱讀理解等一些小量資料
-
Chinese-Literature-NER-RE-Dataset 面向中文文學文本的語篇級命名實體識別與關係抽取資料集 A Discourse-Level Named Entity Recognition and Relation Extraction Dataset for Chinese Literature Text
-
ChineseTextualInference 中文文本推斷專案, 包括 88 萬文本蘊含中文文本蘊含資料集的翻譯與構建, 基於深度學習的文本蘊含判定模型構建.
-
大規模中文自然語言處理語料 維基百科(wiki2019zh), 新聞語料(news2016zh), 百科問答(baike2018qa)
-
中文人名語料庫 中文姓名, 姓氏, 名字, 稱呼, 日本人名, 翻譯人名, 英文人名。
-
公司名、機構名語料庫 公司簡稱, 縮寫, 品牌詞, 企業名。
-
中文敏感詞詞庫 敏感詞過濾的幾種實作+某 1w 詞敏感詞庫
-
中文簡稱詞庫 包含否定全稱的中文縮寫語料庫 A corpus of Chinese abbreviation, including negative full forms.
-
中文資料預處理材料 中文分詞詞典和中文停用詞
-
SentiBridge: 中文實體情感知識庫 刻畫人們如何描述某個實體,包含新聞、旅遊、餐飲,共計 30 萬對。
-
OpenCorpus 一系列可自由獲取(中文)語料的集合。
-
ChineseNlpCorpus 情感/觀點/評論 傾向性分析,中文命名實體識別,推薦系統
-
FinancialDatasets SmoothNLP 金融文本資料集(公開) Public Financial Datasets for NLP Researches Only
-
People’s Daily & Children’s Fairy Tale PD&CFT: 一個中文閱讀理解資料集 A Chinese Reading Comprehension Dataset
中文 NLP 學術組織及競賽 Organizations
Section titled “中文 NLP 學術組織及競賽 Organizations”-
NLP Conference Calender NLP 領域的主要會議、期刊、研討會與共享任務。
-
2017 AI-Challenger 圖像中文描述 用一句話描述給定圖像中的主要資訊,挑戰中文語境下的圖像理解問題。
-
2017 AI-Challenger 英中機器文本翻譯 用大規模的資料,提升英中文本機器翻譯模型的能力。
-
2017 知乎看山杯機器學習挑戰賽 根據知乎給出的問題及話題標籤的綁定關係的訓練資料,訓練出對未標註資料自動標註的模型。
-
2018 開放領域的中文問答任務 對於給定的一句中文問題,問答系統從給定知識庫中選擇若干實體或屬性值作為該問題的答案。
-
2018 微眾銀行智能客服問句匹配大賽 針對中文的真實客服語料,進行問句意圖匹配;給定兩個語句,判定兩者意圖是否相近。
中文 NLP 商業服務 Industry
Section titled “中文 NLP 商業服務 Industry”-
華為雲 NLP 針對各類企業及開發者提供的用於文本分析及挖掘的雲服務,旨在幫助用戶高效的處理文本
-
百度雲 NLP 提供業界領先的自然語言處理技術,提供優質文本處理及理解技術
-
阿里雲 NLP 為各類企業及開發者提供的用於文本分析及挖掘的核心工具
-
騰訊雲 NLP 基於平行計算、分散式爬蟲系統,結合獨特的語義分析技術,一站滿足 NLP、轉碼、抽取、資料抓取等需求
-
訊飛開放平台 以語音互動為核心的人工智慧開放平台
-
搜狗實驗室 分詞和詞性標註
-
玻森資料 上海玻森資料科技有限公司,專注中文語義分析技術
-
雲孚科技 NLP 工具包、知識圖譜、文本挖掘、對話系統、輿情分析等
-
智言科技 專注於深度學習和知識圖譜技術突破的人工智慧公司
-
追一科技 主攻深度學習和自然語言處理
學習資料 Learning Materials
Section titled “學習資料 Learning Materials”-
Stanford CS224n Natural Language Processing with Deep Learning 2017
-
[Course materials for Georgia Tech CS 4650 and 7650, “Natural Language”] (https://github.com/jacobeisenstein/gt-nlp-class)
-
Speech and Language Processing by Dan Jurafsky and James H. Martin
-
文本處理實踐課資料 文本處理實踐課資料,包含文本特徵提取(TF-IDF),文本分類,文本聚類,word2vec 訓練詞向量及同義詞詞林中文詞語相似度計算、文檔自動摘要,資訊抽取,情感分析與觀點挖掘等實驗。
-
nlp_tasks Natural Language Processing Tasks and Selected References
-
NLP 研究入門之道 from 清華劉知遠老師
-
Chinese NLP 中文自然語言處理的共享任務、資料集與最新成果
HagiCode
HagiCode 是面向專案開發的 AI 編碼工作台:豐富、便利的介面互動讓規劃、Agent 執行與專案工作更容易上手和跟進,帶來更投入的開發體驗。
透過豐富、便利的介面互動,讓規劃、Agent 執行與專案工作更容易上手和跟進。

- 智慧OpenSpec 工作流程將意圖轉化為從提案、設計、任務到交付的可執行路徑。
- 高效多 Agent 並行推進研究、實作與審查,並支援多儲存庫變更與你熟悉的 Agent CLI。
- 有趣豐富、便利的介面互動讓規劃、Agent 執行與專案工作更容易上手和跟進,帶來更投入的開發體驗。
下載 Windows 版
分享 HagiCode

讓想法化為交付成果。
HagiCode 是面向專案開發的 AI 編碼工作台:以 OpenSpec 工作流程規劃變更,多 Agent 並行執行,再由 Hero Scenario 讓進度一目了然,將想法化為交付成果。
- 智慧
- OpenSpec 工作流程將意圖轉化為從提案到交付的可執行路徑。
- 高效
- 多 Agent 並行推進研究、實作與審查。
- 有趣
- 豐富、便利的介面互動,讓規劃、Agent 執行與專案工作更容易跟進。
© 2026 HagiCode | Powered By hagilight-starlight@0.21.0 | Branch: main | Commit: 745b50b | Built: