
System Design
Source: https://github.com/madd86/awesome-system-design at
52834671253b
License: CC0-1.0
Read the English original
This edition is an AI-assisted translation.

Selección de artículos, libros, vídeos y herramientas sobre sistemas distribuidos y big data.
Tanto si preparas una entrevista como si quieres diseñar una aplicación distribuida o basada en microservicios, esta lista te ayudará.
Atención: las estrellas de GitHub no reflejan el uso ni la popularidad de todos los elementos enumerados.
Inspirado en Awesome-BigData
Creado por Gabriel Leon de Mattos
Contenido
Sección titulada «Contenido»- Relational Database
- NoSQL
- Sistemas de archivos distribuidos
- Gestión de recursos
- Procesamiento de flujos
- Agente de mensajes
- Balanceadores de carga
- Ecosistema Hadoop
- Framework REST
Artículos
Sección titulada «Artículos»Introducción / entrevistas
Sección titulada «Introducción / entrevistas»-
System Design Primer - [109k ⭐] - Impresionante recopilación de recursos, incluidos mazos de tarjetas didácticas de Anki.
-
System Design Interview Questions - Concepts you should know - Una lista seleccionada de temas para presentarle el diseño de sistemas.
-
Grokking the System Design Interview - [Paid 💵] - La preparación para el diseño de sistemas Grokking es uno de los cursos de los que más se habla. Lo mejor es el diseño de aplicaciones que sugiere en lugar de explicaciones de lo que se supone que debe hacer cada herramienta.
-
System Design in Software Development - Artículo básico sobre los temas de diseño y arquitectura de sistemas.
-
System Design - Recursos introductorios para la preparación de entrevistas.
-
Design Pattern for Distributed Systems - Artículo que habla sobre algunos patrones y algunas tecnologías a considerar.
-
Practice system design problems using AI on Codemia.io - Una herramienta que le permite practicar problemas de diseño de sistemas de forma interactiva como una entrevista con IA. Hay retroalimentación iterativa y evaluación final que califica su desempeño.
Avanzado
Sección titulada «Avanzado»-
Distributed Computing - Artículo de Wikipedia que amplía la visión del diseño de sistemas distribuidos.
-
Fallacies of Distributed Computing - Artículo de Wikipedia que presenta el tema de las falacias de la computación distribuida y sus efectos.
-
Fallacies of Distributed Computing Explained - Explicación en profundidad de las falacias mencionadas anteriormente.
-
CAP Theorem - Artículo de IBM sobre el teorema CAP, microservicios y bases de datos NoSQL.
-
Pattern: Microservice Architecture - Buen artículo que habla sobre la arquitectura de microservicios y sus inconvenientes.
-
Taxonomy of Distributed Systems - Conferencia de 11 páginas que clasifica los sistemas distribuidos y específicamente por qué los necesitamos.
-
Top 10 Secure Coding Practices - Breve artículo hablando de buenas prácticas para valores de código.
-
Scalable Web Architecture and Distributed Systems - Buen artículo sobre sistemas distribuidos, así como algunas de las herramientas potenciales.
-
Designing Distributed Systems: Patterns and Paradigms for Scalable, Reliable Services - [Paid 💵] - Libro que habla sobre sistemas distribuidos y también muestra ligeramente un código de su apariencia.
-
Designing Data Intensive Applications - [Paid 💵] - Profundiza para explicar varios recursos que utilizamos cuando trabajamos con sistemas distribuidos, así como cómo surgió y qué problemas pretende resolver.
-
The System Design Manual - [Paid 💵] - Cubre los aspectos centrales de los sistemas distribuidos, como: fundamentos de la red, la teoría que sustenta los sistemas distribuidos, patrones arquitectónicos de sistemas escalables, patrones de estabilidad que fortalecen los sistemas contra fallas y mejores prácticas operativas sobre cómo mantener sistemas a gran escala con un equipo pequeño.
-
Building Microservices - [Free 👍] - Impresionante libro que habla en profundidad sobre el diseño de arquitectura de sistemas con microservicios, incluye los temas más relevantes al respecto.
-
Monolith to Microservices - [Free 👍] - Escrito por el mismo autor que el anterior, este libro cubrirá la migración de Monolith a Microservicios; se recomienda comenzar con el libro anterior.
-
Distributed Systems (3rd Edition) - [Free 👍] - Excelente descripción general y una introducción en profundidad a los sistemas distribuidos. Recomendado para lectores de nivel intermedio.
-
Safe by Design - [Free 👍] - Gran libro sobre cómo hacer cumplir la corrección del código mediante el diseño.
Una colección de vídeos sobre sistemas distribuidos.
Introducción / entrevistas
Sección titulada «Introducción / entrevistas»-
Gaurav Sen - System Design Series - Buen recurso para las personas que desean aprender más sobre el diseño de sistemas, presenta el tema de una manera muy fácil de entender.
-
Tech Dummies - System Design Series - Otra introducción al diseño de sistemas.
-
Mock System Design Interview at Google - Descripción general de cómo sería una entrevista sobre el diseño de sistemas desde la perspectiva de un cumplimiento deficiente pero estricto de los requisitos. La clave aquí es cómo se desarrolla la interacción con el entrevistador.
-
Google Preparation Guide - Un vídeo rápido que explica cómo se entrevistan.
-
System Design Interview - El canal de YouTube se centró en contenido específico de entrevistas de diseño de sistemas, con explicaciones detalladas de una variedad de problemas.
-
Intro to Architecture and System Design Interviews - Un vídeo de YouTube con Jackson Gabbard con buena información sobre entrevistas de diseño de sistemas.
-
System Design Introduction for Interview - Introducción de Tushar al diseño de sistemas.
-
Distributed Systems - Este es un curso de introducción a Sistemas Distribuidos realizado por Chris Colohan. Obtuvo un doctorado en Carnegie Mellon y luego pasó 10 años trabajando en Google construyendo sistemas distribuidos.
-
The Easy Way - Canal emergente con videos fáciles de entender sobre sistemas distribuidos.
-
System Design by SDE Skills - Buen recurso para las personas que se están preparando para entrevistas de diseño de sistemas, hay múltiples entrevistas simuladas de diseño de sistemas y análisis profundos.
-
System Design by CodeKarle - Otro gran recurso gratuito, una lista de preguntas frecuentes en las entrevistas.
Avanzado
Sección titulada «Avanzado»- The evolution of Reddit Architecture - Descripción general de cómo se amplió el diseño del sistema Reddit.
- 6.824 Distributed Systems by MIT - Curso de nivel posgrado en sistemas distribuidos del MIT (2020).
- CSE138 Distributed Systems by UCSC - Curso de pregrado en sistemas distribuidos de la UCSC (2020).
Herramientas
Sección titulada «Herramientas»- Una colección de las herramientas más utilizadas para sistemas distribuidos
Sistema de gestión de bases de datos relacionales
Sección titulada «Sistema de gestión de bases de datos relacionales»-
MariaDB - MariaDB es una bifurcación del servidor MySQL.
-
MySQL - Base de datos relacional ampliamente utilizada.
-
PostgresSQL - Base de datos relacional que ha ido ganando popularidad.
-
SQLite - Otra base de datos ampliamente utilizada que está integrada en todos los teléfonos móviles y en la mayoría de las computadoras.
-
Sql Server - Base de datos relacional ampliamente utilizada.
Caché (clave-valor)
Sección titulada «Caché (clave-valor)»-
Apache Ignite - [3.3k ⭐] - Almacenamiento en memoria caché con propiedades ACID.
-
Couchbase - Inspirado en Memcached, agregando características como replicación y persistencia.
-
Oracle Coherence - [126 ⭐] - Almacenamiento en caché en memoria de alta escala y baja latencia.
-
Memcached - [10.2k ⭐] - Una de las primeras bases de datos de almacenamiento en caché en memoria, de alto rendimiento y multiproceso.
-
Redis - [44k ⭐] - Base de datos de almacenamiento en caché en memoria ampliamente utilizada con muchas características adicionales, como almacenamiento persistente y soporte para cadenas, listas, conjuntos, hashs, secuencias, mapas de bits, etc.
Almacenamiento (clave-valor)
Sección titulada «Almacenamiento (clave-valor)»-
Apple FoundationDB - [10k ⭐] - Multimodelo (muchos tipos de datos en una sola base de datos), almacén de valores clave ACID. Fácilmente escalable y tolerante a fallos.
-
Cosmos DB - El servicio de base de datos multimodelo distribuido globalmente de Microsoft. Escale el rendimiento y el almacenamiento de forma oriental e independiente. API SQL, MongoDB, Cassandra, Tables, Gremlin y Spark.
Almacenamiento de documentos
Sección titulada «Almacenamiento de documentos»-
CouchDB - [4.6k ⭐] - La base de datos de almacén de documentos NoSQL compatible con ACID proporciona una API HTTP RESTful para leer y actualizar documentos de bases de datos.
-
MongoDB - Una de las bases de datos ‘NoSQL’ más populares para uso general.
-
RethinkDB - [23.8k ⭐] - BD de almacén de documentos.
-
ElasticSearch - [49.9k ⭐] - Base de datos ‘NoSQL’ muy popular para motores de búsqueda rápidos y escalables.
-
Cosmos DB - El servicio de base de datos multimodelo distribuido globalmente de Microsoft. Escale el rendimiento y el almacenamiento de forma oriental e independiente. API SQL, MongoDB, Cassandra, Tables, Gremlin y Spark.
Almacenamiento de columnas anchas
Sección titulada «Almacenamiento de columnas anchas»-
Amazon DynamoDB - Base de datos de documentos y valores clave, de alto rendimiento, escalable y segura.
-
Google Bigtable - Base de datos ‘NoSQL’ escalable y de alto rendimiento para grandes cargas de trabajo analíticas y operativas.
-
Cassandra - Proyecto nacido en Facebook muy rápido, fácilmente escalable, con opción de incluir coherencia en cada operación.
-
Scylla - [4.9k ⭐] - Almacén de datos ‘NoSQL’ que utiliza el marco seastar, compatible con Cassandra.
-
HBase - [3.6k ⭐] - Modelado a partir de Bigtable de Google y escrito en Java. Desarrollado como parte del proyecto Apache Hadoop y se ejecuta sobre HDFS o Alluxio. (Ver Hadoop Related)
-
Cosmos DB - El servicio de base de datos multimodelo distribuido globalmente de Microsoft. Escale el rendimiento y el almacenamiento de forma oriental e independiente. API SQL, MongoDB, Cassandra, Tables, Gremlin y Spark.
-
Amazon Neptune - Servicio de base de datos de gráficos rápido, confiable y totalmente administrado.
-
ArangoDB - [10k ⭐] - Base de datos flexible para documentos, valores-clave, gráficos. Utiliza su propio lenguaje de consulta, AQL.
-
Neo4j - [7.9k ⭐] - Buen soporte para una base de datos gráfica, compatible con ACID y flexible.
-
Cosmos DB - El servicio de base de datos multimodelo distribuido globalmente de Microsoft. Escale el rendimiento y el almacenamiento de forma oriental e independiente. API SQL, MongoDB, Cassandra, Tables, Gremlin y Spark.
Sistemas de archivos distribuidos
Sección titulada «Sistemas de archivos distribuidos»-
HDFS - Hadoop File System es una opción muy popular entre sus competidores de big data, ya que proporciona acceso de alto rendimiento.
-
Lustre - Sistema de archivos para clusters de computadoras.
-
CephFS - Sistema de almacenamiento unificado y distribuido.
-
GlusterFS - Sistema de archivos NAS escalable.
-
MooseFS - Sistema de archivos distribuido compatible con POSIX.
-
XtreemFS - Sistema de archivos tolerante a fallos.
Gestión de recursos
Sección titulada «Gestión de recursos»- Kubernetes - Una forma muy popular de implementar, administrar y escalar automáticamente un grupo de contenedores en servidores virtuales o sin sistema operativo.
Procesamiento de flujos
Sección titulada «Procesamiento de flujos»-
Apache Samza - Cree aplicaciones con estado que procesen datos en tiempo real desde múltiples fuentes, incluido Kafka. Modelo de múltiples suscriptores sencillo y económico, que puede eliminar la contrapresión y tiene una persistencia confiable con baja latencia.
-
Apache Flink - Basado en el concepto de corrientes y transformaciones. Utiliza maven, maneja tareas por lotes como flujos de datos con límites finitos. Baja latencia, alto rendimiento.
-
Amazon Kinesis Streams - Servicio duradero, escalable y en tiempo real. Recopila gigabytes de datos por segundo de cientos de miles de fuentes, incluidos flujos de eventos de bases de datos, flujos de clics en sitios web, transacciones financieras, etc.
-
Azure Stream Analytics - Servicio de análisis en tiempo real diseñado para cargas de trabajo de misión crítica.
Agente de mensajes
Sección titulada «Agente de mensajes»-
Amazon MQ - Agente de mensajes de código abierto de Amazon.
-
Apache ActiveMQ - Es un servidor de mensajería multiprotocolo basado en Java.
-
Apache Kafka - Agente de mensajes muy popular con baja latencia para transmisión de datos.
-
RabbitMQ - Peso ligero muy popular corredor de mensajes escrito en erlang que también admite múltiples protocolos de mensajería.
-
IronMQ - Broker de mensajería muy rápido y altamente escalable. (no de código abierto)
-
Apache Pulsar - Creado por Google, también altamente escalable, de baja latencia, replicación geográfica y multitenencia.
-
Kestrel - Escrito en Scala y habla el protocolo memcached. Funciona de manera muy parecida a Kafka.
-
Azure Service Bus - Un intermediario de mensajes de integración empresarial totalmente gestionado.
Balanceadores de carga
Sección titulada «Balanceadores de carga»Software de código abierto
Sección titulada «Software de código abierto»-
SeeSaw - [5.1k ⭐] - Utilizado por Google, desarrollado en Go, servidor de equilibrio de carga virtual basado en Linux.
-
HAProxy - Opción muy popular que proporciona alta disponibilidad, proxy y equilibrio de carga TCP/HTTP. Utilizado por Reddit, Imgur, MaxCDN, GitHub, AirBNB.
-
Zevenet - Soporta L3, L4 y L7. Fácil instalación con un repositorio de Docker. Admite monitoreo avanzado de control de salud.
-
Neutrino - Utilizado por eBay, construido con Scala y Netty. Admite algoritmos de operación por turnos y de conexión mínima.
-
Nginx - Espera, ¿no es Nginx un servidor web? Sí, el código abierto admite un nivel básico de cambio de contenido y enrutamiento de solicitudes. La edición Plus admite equilibrio de carga, WAF, monitoreo, etc.
-
Openresty - Nginx + Lua, combinación perfecta.
Hardware
Sección titulada «Hardware»-
F5 - Opción robusta de equilibrador de carga de hardware que admite múltiples protocolos (IP, TCP, FTP, UDP, HTTP).
-
TP-Link - Alternativa más económica que funciona como equilibrador de carga.
-
Barracuda - Una de las mejores opciones para el equilibrio de carga cuando se trata de servidores internos. Máximas medidas de seguridad integradas, informes completos y monitoreo del tráfico saliente para prevenir la pérdida de datos.
-
Amazon Elastic Load Balancing - Opción popular para los clientes de Amazon, admite funciones lambda y es altamente escalable.
-
Google Load Balancing - Opción popular para los clientes de Google, viene con función de escalado automático, muy rápido y tiene CDN integrado.
-
Cloudflare Load Balancing - Equilibrio de carga escalable de Cloudflare, función de conmutación por error rápida y un panel de control.
-
DigitalOcean Load Balancing - Si es cliente de digitalocean, esta es una buena opción, muy económica, con disponibilidad regional, escalable y fácil de implementar entre sus otras gotas.
-
Azure Load Balancing - Opción popular para los clientes de Azure de Microsoft. Admite tráfico interno y externo, ipv6, monitoreo y el conjunto de funciones de equilibrio de carga estándar.
Ecosistema Hadoop
Sección titulada «Ecosistema Hadoop»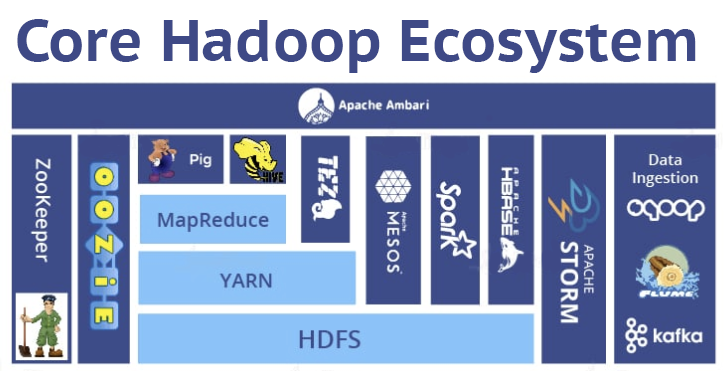
- Ambari - Panel de control que integra la mayoría de las tecnologías relacionadas con Hadoop para una fácil gestión y ejecución.
Ingesta de datos
Sección titulada «Ingesta de datos»-
Sqoop - Transfiera datos de manera eficiente entre Hadoop y almacenes de datos estructurados, como bases de datos relacionales.
-
Flume - Distribuido, altamente disponible y eficiente en la recopilación, agregación y movimiento de grandes cantidades de datos de registro.
-
Apache Kafka - Agente de mensajes muy popular con baja latencia para transmisión de datos.
Planificador de flujos de trabajo
Sección titulada «Planificador de flujos de trabajo»- Oozie - Cree flujos de trabajo en xml para ejecutar trabajos (de otras aplicaciones del ecosistema hadoop) en pasos, lo que también permite la ejecución paralela.
Consultas
Sección titulada «Consultas»- Hive - Consultar datos almacenados en hadoop en SQL.
- Pig - Lenguaje de scripting que se parece a SQL para consultar datos de hadoop.
Procesamiento
Sección titulada «Procesamiento»- Tez - Resuelve un problema similar a Spark y MapReduce, es más eficiente que MapReduce porque calcula la forma más eficiente de hacerlo.
- Map Reduce - MapReduce, como su nombre lo indica, mapea datos y reduce los resultados.
- Spark - Potente procesamiento de datos no solo para procesar datos como Tez (y MapReduce), sino que también puede procesar flujos de datos en tiempo real, aplicar algoritmos de análisis de regresión en ML y mucho más.
- Apex - *Proyecto retirado, es una plataforma nativa de YARN que unifica el procesamiento por secuencias y por lotes.
Base de datos
Sección titulada «Base de datos»- HBase - [3.6k ⭐] - Modelado a partir de Bigtable de Google y escrito en Java. Desarrollado como parte del proyecto Apache Hadoop.
Gestión de recursos
Sección titulada «Gestión de recursos»- YARN - ‘Yet Another Resource Negotiator’ funciona como un núcleo para administrar los recursos informáticos en todos los clústeres.
- MESOS - Funciona como un kernel de Linux al administrar la CPU, la memoria, el almacenamiento y otros recursos en todo el clúster.
Framework REST
Sección titulada «Framework REST»-
Gin - [40.6k ⭐] - Marco de microservicio increíblemente rápido que utiliza Golang y alta capacidad de rendimiento.
-
Phoenix - [15.5k ⭐] - Procesamiento distribuido, fácilmente escalable, soporte para canales y chat en vivo. Este marco, escrito en Elixir, utiliza BEAM y Erlang, muy eficiente para sistemas a gran escala y admite un alto rendimiento.
-
Express.js - [49.6k ⭐] - API de descanso rápida de node.js que puede funcionar bien en muchos escenarios.
-
Rails - [46.2k ⭐] - Escrito en Ruby, Rails ofrece API rápidas desde el prototipo hasta la producción de manera eficiente.
-
Play Framework - [11.6k ⭐] - Marco muy rápido y de alto rendimiento escrito en Scala/Java que es RESTful de forma predeterminada.
-
Flask - [51.6k ⭐] - Un microframework Python liviano para creación y producción rápidas de prototipos.
-
FastAPI - [22.7k ⭐] - Un microframework de Python liviano inspirado en Flask pero más moderno, que utiliza Python async.
-
Django REST - [18.4k ⭐] - Escrita en Python, Django Rest es una API REST potente y flexible. La eficiencia y el tiempo de comercialización se parecen a Rails.
-
ASP.NET Core MVC - Un marco completo para crear aplicaciones web y API utilizando el patrón de diseño Modelo-Vista-Controlador en C# o F#. Número 6 en TechEmpower Composite Benchmarks para frameworks web.
-
Fastify - [15.4k ⭐] - Un marco web Node.js altamente enfocado en brindar la mejor experiencia al desarrollador con la menor sobrecarga y una potente arquitectura de complementos.
HagiCode
HagiCode es un espacio de programación con agentes. Las interacciones de interfaz, ricas y cómodas, hacen que planificar, ejecutar agentes y trabajar en proyectos sea accesible y fácil de seguir, para una experiencia de desarrollo atractiva.
Una experiencia de desarrollo atractiva gracias a interacciones de interfaz ricas y cómodas.

- InteligenteLos flujos de trabajo de OpenSpec convierten la intención en un itinerario ejecutable, de la propuesta al diseño, las tareas y la entrega.
- EficienteLa ejecución multiagente avanza en paralelo con la investigación, la implementación y la revisión, en varios repositorios y con los Agent CLI que ya usas.
- InteresanteLas interacciones de interfaz, ricas y cómodas, hacen que planificar, ejecutar agentes y trabajar en proyectos sea accesible y fácil de seguir.
Descargar para Windows
Compartir HagiCode

Convierte ideas en software entregado.
HagiCode es un espacio de trabajo de programación con agentes: los flujos de trabajo de OpenSpec planifican el cambio, la ejecución multiagente lo lleva a cabo y Hero Scenario hace visible el largo recorrido, para convertir ideas en software entregado.
- Inteligente
- Los flujos de OpenSpec convierten la intención en un camino de la propuesta a la entrega.
- Eficiente
- La ejecución multiagente avanza en paralelo con investigación, implementación y revisión.
- Divertido
- Las interacciones de interfaz facilitan la planificación, los agentes y el trabajo en proyectos.
© 2026 HagiCode | Powered By hagilight-starlight@0.21.0 | Branch: main | Commit: 745b50b | Built: