
LLM
Source: https://github.com/Hannibal046/Awesome-LLM at
538eed00fcb0
License: CC0-1.0
Read the English original
This edition is an AI-assisted translation.
Awesome-LLM 
Sección titulada «Awesome-LLM »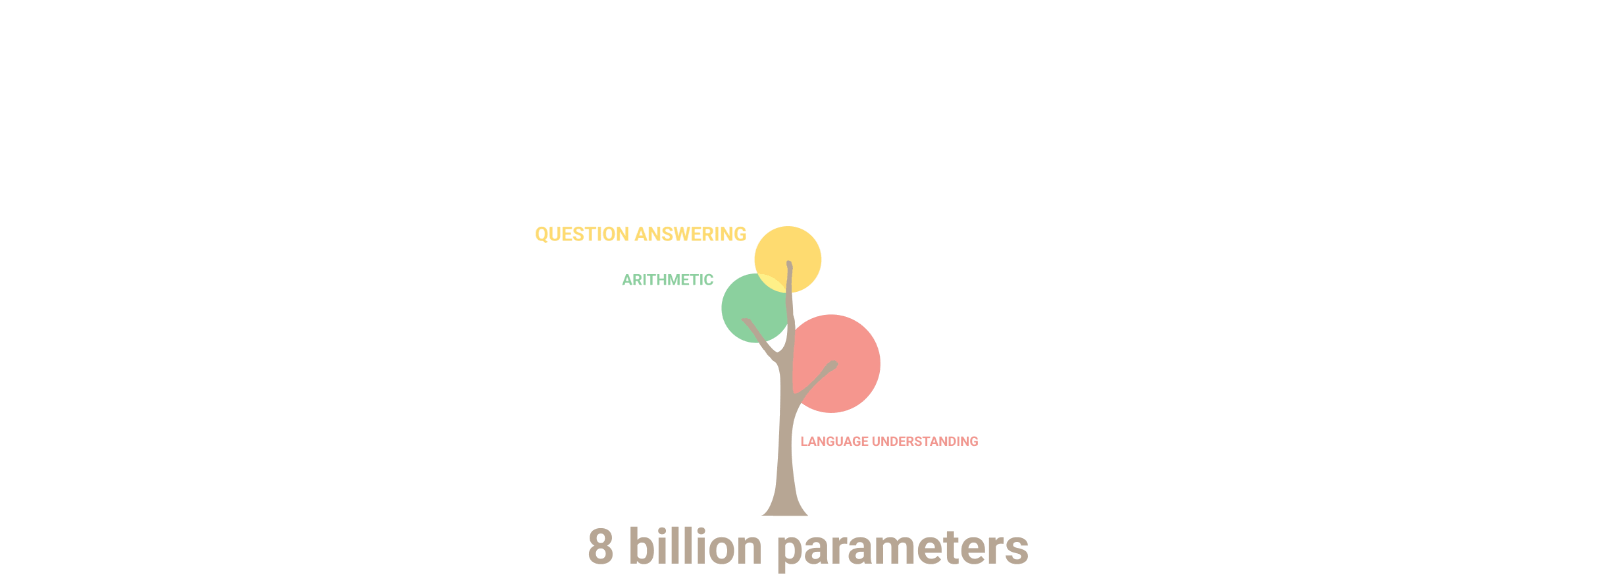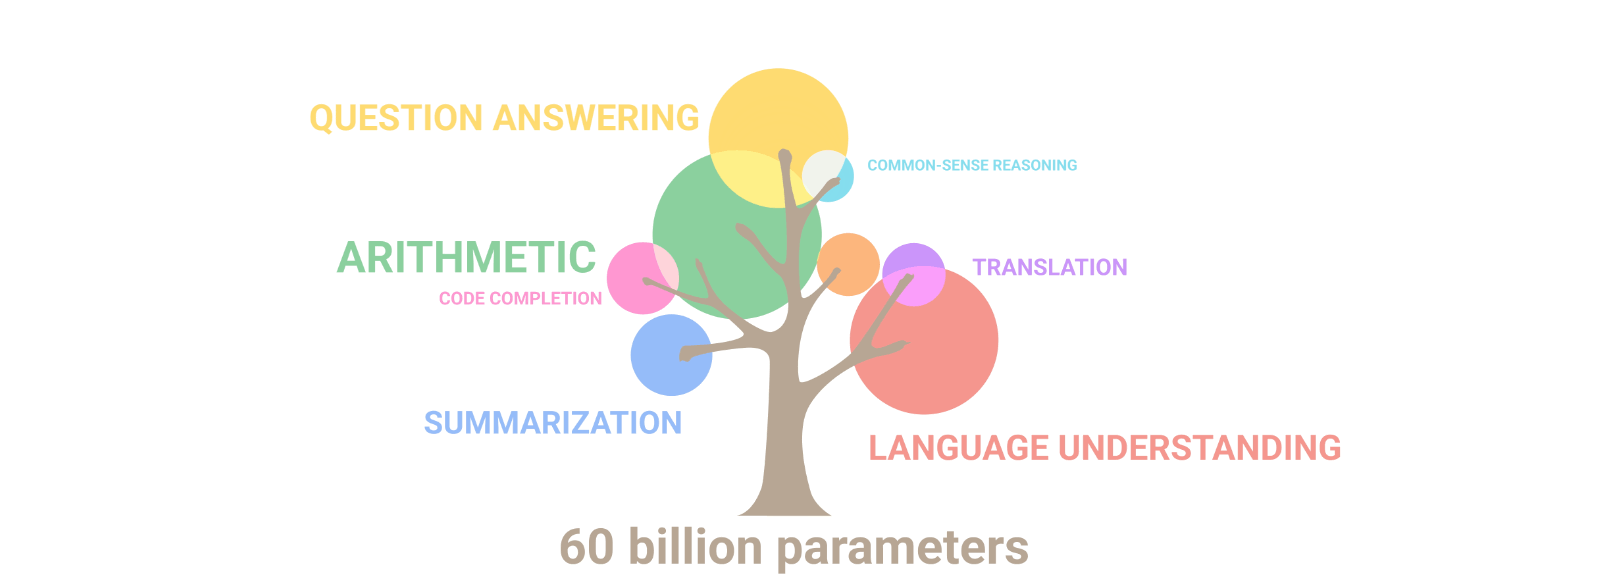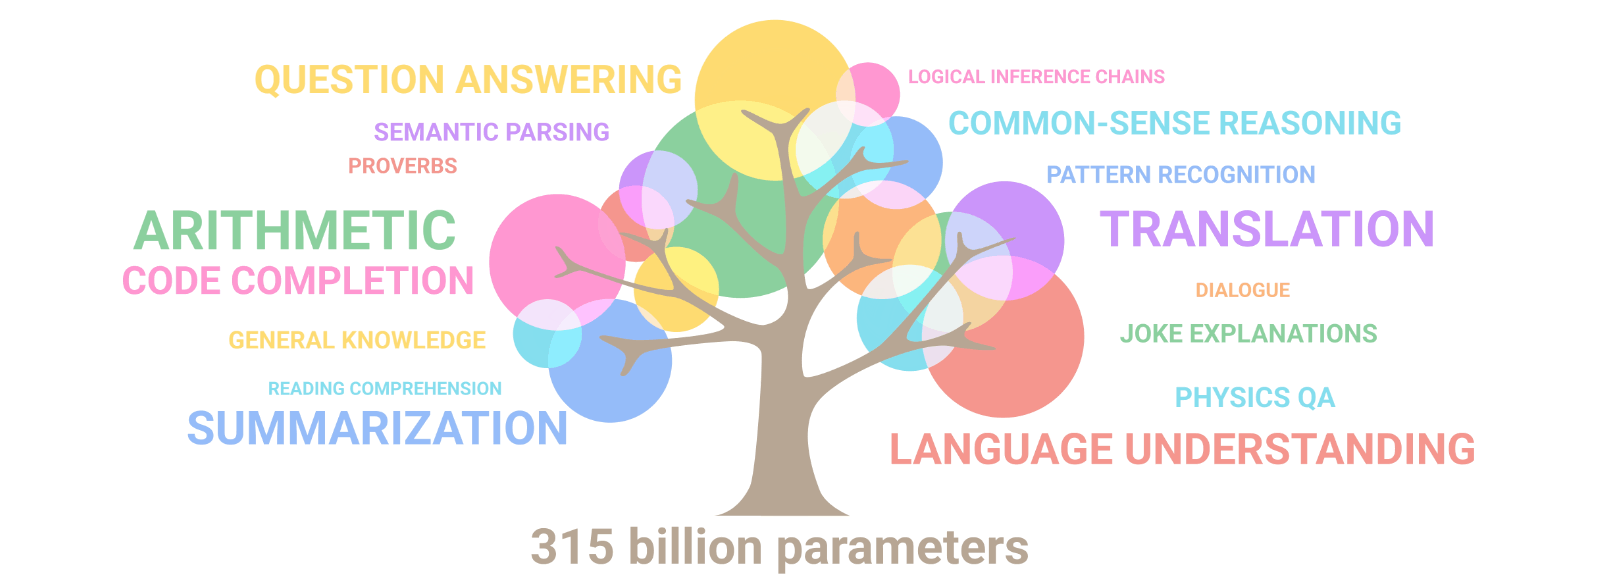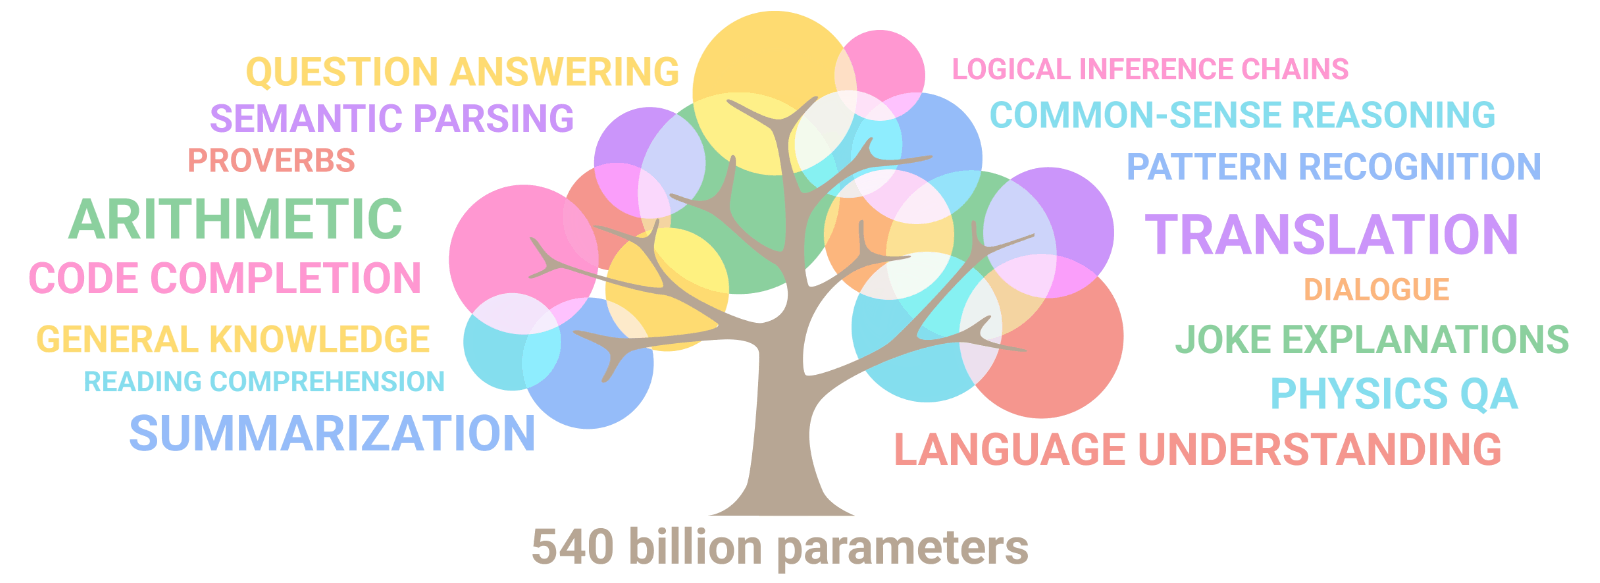
🔥 Los modelos de lenguaje grandes (LLM) han revolucionado primero a la comunidad de NLP, luego a la comunidad de IA y ahora a todo el mundo. Aquí encontrarás una selección de artículos sobre modelos de lenguaje grandes, especialmente los relacionados con ChatGPT. También incluye marcos de trabajo para entrenar LLM, herramientas para desplegarlos, cursos y tutoriales sobre LLM, así como todos los puntos de control y API de LLM disponibles públicamente.
Proyectos de LLM de tendencia
Sección titulada «Proyectos de LLM de tendencia»- TinyZero - Reproducción limpia, minimalista y accesible de DeepSeek R1-Zero
- open-r1 - Reproducción completamente abierta de DeepSeek-R1
- DeepSeek-R1 - Modelos de razonamiento de primera generación de DeepSeek.
- Qwen2.5-Max - Exploración de la inteligencia de los modelos MoE a gran escala.
- OpenAI o3-mini - Ampliando las posibilidades del razonamiento rentable.
- DeepSeek-V3 - El primer modelo de nivel GPT-4o con código fuente abierto.
- Kimi-K2 - Modelo de lenguaje MoE con 32B de parámetros activos y 1T de parámetros totales.
Artículos fundamentales
Sección titulada «Artículos fundamentales»artículos fundamentales
Otros artículos
Sección titulada «Otros artículos»[!NOTE] Si te interesa el campo de los LLM, la lista anterior de artículos fundamentales puede ayudarte a explorar su historia y el estado del arte. Sin embargo, cada área de los LLM ofrece perspectivas y aportaciones únicas, esenciales para comprender el campo en su conjunto. Para consultar una lista detallada de artículos sobre distintas subáreas, visita el siguiente enlace:
otros artículos
-
Awesome-LLM-hallucination - Lista de artículos sobre alucinaciones en LLM.
-
awesome-hallucination-detection - Lista de artículos sobre la detección de alucinaciones en LLM.
-
LLMsPracticalGuide - Selección de recursos de guías prácticas sobre LLM.
-
Awesome ChatGPT Prompts - Colección de ejemplos de prompts para usar con el modelo ChatGPT.
-
awesome-chatgpt-prompts-zh - Colección china de ejemplos de prompts para usar con el modelo ChatGPT.
-
Awesome ChatGPT - Selección de recursos para ChatGPT y GPT-3 de OpenAI.
-
Chain-of-Thoughts Papers - Una tendencia que comenzó con «Chain of Thought Prompting Elicits Reasoning in Large Language Models.
-
Awesome Deliberative Prompting - Cómo pedir a los LLM que produzcan razonamientos fiables y tomen decisiones sensibles a las razones.
-
Instruction-Tuning-Papers - Una tendencia que comenzó con
Natrural-Instruction(ACL 2022),FLAN(ICLR 2022) yT0(ICLR 2022). -
LLM Reading List - Lista de artículos y recursos sobre modelos de lenguaje grandes.
-
Reasoning using Language Models - Colección de artículos y recursos sobre el razonamiento mediante modelos de lenguaje.
-
Chain-of-Thought Hub - Medición del rendimiento de razonamiento de los LLM.
-
Awesome GPT - Selección de proyectos y recursos destacados relacionados con GPT, ChatGPT, OpenAI, LLM y más.
-
Awesome GPT-3 - Colección de demostraciones y artículos sobre la API GPT-3 de OpenAI.
-
Awesome LLM Human Preference Datasets - Colección de conjuntos de datos de preferencias humanas para el ajuste por instrucciones de LLM, RLHF y evaluación.
-
RWKV-howto - Materiales y tutoriales que pueden resultar útiles para aprender RWKV.
-
ModelEditingPapers - Lista de artículos y recursos sobre edición de modelos para modelos de lenguaje grandes.
-
Awesome LLM Security - Selección de herramientas, documentos y proyectos destacados sobre la seguridad de los LLM.
-
Awesome-Align-LLM-Human - Colección de artículos y recursos sobre la alineación de los modelos de lenguaje grandes (LLM) con las personas.
-
Awesome-Code-LLM - Selección de los mejores LLM de código para investigación.
-
Awesome-LLM-Compression - Artículos de investigación y herramientas sobre compresión de LLM.
-
Awesome-LLM-Systems - Artículos de investigación sobre sistemas de LLM.
-
awesome-llm-webapps - Colección de aplicaciones web de código abierto y mantenimiento activo para aplicaciones de LLM.
-
awesome-japanese-llm - Resumen de los LLM japoneses.
-
Awesome-LLM-Healthcare - Lista de artículos de la revisión sobre LLM en medicina.
-
Awesome-LLM-Inference - Selección de artículos destacados sobre inferencia de LLM, con código.
-
Awesome-LLM-3D - Selección de modelos de lenguaje grandes multimodales en entornos 3D, que incluye comprensión y razonamiento 3D, generación y agentes incorporados.
-
LLMDatahub - Colección seleccionada de conjuntos de datos diseñados específicamente para entrenar chatbots, con enlaces, tamaño, idioma, uso y una breve descripción de cada conjunto.
-
Awesome-Chinese-LLM - Recopilación de modelos de lenguaje grandes (LLM) de código abierto en chino, principalmente modelos más pequeños, desplegables de forma privada y con menores costes de entrenamiento; incluye modelos base, ajustes y aplicaciones de dominios verticales, conjuntos de datos y tutoriales, entre otros.
-
LLM4Opt - La aplicación de modelos de lenguaje grandes (LLM) a diversas tareas de optimización (Opt) es un área de investigación emergente. Esta colección reúne referencias y artículos sobre LLM4Opt.
-
awesome-language-model-analysis - Esta lista de artículos se centra en el análisis teórico o empírico de los modelos de lenguaje, por ejemplo, la dinámica del aprendizaje, la capacidad expresiva, la interpretabilidad, la generalización y otros temas de interés.
Clasificaciones de LLM
Sección titulada «Clasificaciones de LLM»- Chatbot Arena Leaderboard - plataforma de evaluación comparativa para modelos de lenguaje grandes (LLM) con enfrentamientos anónimos y aleatorizados mediante crowdsourcing.
- LiveBench - Una evaluación comparativa exigente y libre de contaminación.
- Open LLM Leaderboard - Tiene como objetivo seguir, clasificar y evaluar los LLM y los chatbots a medida que se publican.
- AlpacaEval - Evaluador automático de modelos de lenguaje que siguen instrucciones, basado en el conjunto de pruebas de Nous.
otras clasificaciones
- ACLUE - referencia de evaluación centrada en la comprensión del chino antiguo.
- BeHonest - Referencia pionera diseñada específicamente para evaluar exhaustivamente la honestidad de los LLM.
- Berkeley Function-Calling Leaderboard - evalúa la capacidad de los LLM para llamar a funciones y herramientas externas.
- Chinese Large Model Leaderboard - referencia de evaluación dirigida por expertos para LLM en chino.
- CompassRank - CompassRank se dedica a explorar los modelos de lenguaje y visuales más avanzados y ofrece una referencia de evaluación integral, objetiva y neutral para la industria y la investigación.
- CompMix - referencia que evalúa métodos de preguntas y respuestas que operan con una mezcla de fuentes de entrada heterogéneas (KB, texto, tablas e infoboxes).
- DreamBench++ - referencia para evaluar el rendimiento de los modelos de lenguaje grandes (LLM) en diversas tareas relacionadas con la imaginación textual y visual.
- FELM - metaevaluación que mide hasta qué punto los evaluadores de factualidad valoran las respuestas de los modelos de lenguaje grandes (LLM).
- InfiBench - referencia diseñada específicamente para evaluar la capacidad de los modelos de lenguaje grandes (LLM) de responder preguntas de programación del mundo real.
- LawBench - referencia diseñada para evaluar los modelos de lenguaje grandes en el ámbito jurídico.
- LLMEval - se centra en comprender el rendimiento de estos modelos en diversos escenarios y analizar los resultados desde una perspectiva de interpretabilidad.
- M3CoT - referencia que evalúa los modelos de lenguaje grandes en una variedad de tareas de razonamiento multimodal, como lenguaje, ciencias naturales y sociales, sentido común físico y social, razonamiento temporal, álgebra y geometría.
- MathEval - plataforma integral de evaluación comparativa diseñada para evaluar las capacidades matemáticas de modelos grandes en 20 áreas y casi 30 000 problemas matemáticos.
- MixEval - referencia dinámica basada en valores de referencia reales y derivada de mezclas de referencias disponibles; evalúa los LLM con una clasificación de modelos muy capaz (correlación de 0,96 con Chatbot Arena) y se ejecuta localmente con rapidez (en el 6 % del tiempo y coste de MMLU).
- MMedBench - referencia que evalúa la capacidad de los modelos de lenguaje grandes para responder preguntas médicas en varios idiomas.
- MMToM-QA - referencia multimodal de preguntas y respuestas diseñada para evaluar la capacidad cognitiva de los modelos de IA para comprender las creencias y los objetivos humanos.
- OlympicArena - referencia para evaluar modelos de IA en varias disciplinas académicas, como matemáticas, física, química, biología y otras.
- PubMedQA - referencia biomédica de preguntas y respuestas diseñada para responder preguntas de investigación mediante resúmenes de PubMed.
- SciBench - referencia diseñada para evaluar modelos de lenguaje grandes (LLM) resolviendo problemas científicos complejos, de nivel universitario, en áreas como química, física y matemáticas.
- SuperBench - plataforma de evaluación comparativa diseñada para evaluar modelos de lenguaje grandes (LLM) en diversas tareas, con especial atención a aspectos como la comprensión del lenguaje natural, el razonamiento y la generalización.
- SuperLim - referencia sueca de comprensión del lenguaje que evalúa modelos de procesamiento del lenguaje natural (NLP) en tareas como análisis argumentativo, similitud semántica e implicación textual.
- TAT-DQA - conjunto de datos de preguntas y respuestas visuales sobre documentos a gran escala, diseñado para comprender documentos complejos, en especial informes financieros.
- TAT-QA - referencia de preguntas y respuestas a gran escala centrada en datos financieros del mundo real, que integra información tabular y textual.
- VisualWebArena - referencia diseñada para evaluar el rendimiento de agentes web multimodales en tareas realistas fundamentadas visualmente.
- We-Math - referencia que evalúa la capacidad de los modelos multimodales grandes (LMM) para realizar razonamientos matemáticos similares a los humanos.
- WHOOPS! - conjunto de datos de evaluación comparativa que pone a prueba la capacidad de la IA para razonar sobre el sentido común visual mediante imágenes que desafían las expectativas habituales.
LLM de código abierto
Sección titulada «LLM de código abierto»DeepSeek
Alibaba
- Qwen-1.8B|7B|14B|72B
- Qwen1.5-0.5B|1.8B|4B|7B|14B|32B|72B|110B|MoE-A2.7B
- Qwen2-0.5B|1.5B|7B|57B-A14B-MoE|72B
- Qwen2.5-0.5B|1.5B|3B|7B|14B|32B|72B
- CodeQwen1.5-7B
- Qwen2.5-Coder-1.5B|7B|32B
- Qwen2-Math-1.5B|7B|72B
- Qwen2.5-Math-1.5B|7B|72B
- Qwen-VL-7B
- Qwen2-VL-2B|7B|72B
- Qwen2-Audio-7B
- Qwen2.5-VL-3|7|72B
- Qwen2.5-1M-7|14B
Meta
Mistral AI
Apple
Microsoft
AllenAI
xAI
Cohere
01-ai
Baichuan
Nvidia
BLOOM
Zhipu AI
RWKV Foundation
- RWKV-v4|5|6minicpm-2b-65d48bf958302b9fd25b698f)
ElutherAI
Stability AI
BigCode
DataBricks
Shanghai AI Laboratory
Moonshot AI
Datos de LLM
Sección titulada «Datos de LLM»Referencia: LLMDataHub
- IBM data-prep-kit - Kit de herramientas de código abierto para procesar datos no estructurados de forma eficiente, con módulos preconstruidos y escalabilidad desde el entorno local hasta clústeres.
- Datatrove - Libera el procesamiento de datos de la locura de los scripts mediante un conjunto de bloques de procesamiento personalizables e independientes de la plataforma.
- Dingo - Herramienta integral para evaluar la calidad de los datos.
- FastDatasets - Herramienta potente para crear conjuntos de datos de entrenamiento de alta calidad para modelos de lenguaje grandes.
Evaluación de LLM:
Sección titulada «Evaluación de LLM:»- lm-evaluation-harness - Marco para la evaluación con pocos ejemplos de modelos de lenguaje.
- lighteval - Conjunto ligero de herramientas de evaluación de LLM que Hugging Face utiliza internamente.
- simple-evals - Herramientas de evaluación de OpenAI.
otros marcos de evaluación
- OLMO-eval - repositorio para evaluar modelos de lenguaje abiertos.
- MixEval - Conjunto de evaluación fiable, listo para usar y compatible con modelos de código abierto y propietarios; admite MixEval y otras referencias.
- HELM - Holistic Evaluation of Language Models (HELM), un marco para aumentar la transparencia de los modelos de lenguaje.
- instruct-eval - Este repositorio contiene código para evaluar cuantitativamente modelos ajustados por instrucciones, como Alpaca y Flan-T5, en tareas reservadas para evaluación.
- Giskard - Biblioteca de pruebas y evaluación para aplicaciones de LLM, en particular RAG.
- LangSmith - plataforma unificada del marco LangChain para evaluación, colaboración HITL (Human In The Loop), registro y supervisión de aplicaciones de LLM.
- Ragas - marco que ayuda a evaluar las canalizaciones de generación aumentada por recuperación (RAG).
Marcos de entrenamiento de LLM
Sección titulada «Marcos de entrenamiento de LLM»- Meta Lingua - base de código ligera, eficiente y fácil de modificar para investigar los LLM.
- Litgpt - Más de 20 LLM de alto rendimiento con recetas para preentrenar, ajustar y desplegar a escala.
- nanotron - Entrenamiento minimalista de modelos de lenguaje grandes con paralelismo 3D.
- DeepSpeed - DeepSpeed es una biblioteca de optimización de aprendizaje profundo que facilita el entrenamiento y la inferencia distribuidos, de forma eficiente y eficaz.
- Megatron-LM - Investigación en curso sobre el entrenamiento de modelos Transformer a gran escala.
- torchtitan - Biblioteca nativa de PyTorch para entrenar modelos grandes.
otros marcos
- Megatron-DeepSpeed - Versión de NVIDIA Megatron-LM basada en DeepSpeed que añade compatibilidad con varias funciones, como el entrenamiento de modelos MoE, el aprendizaje curricular, el paralelismo 3D y otras.
- torchtune - Biblioteca nativa de PyTorch para ajustar LLM.
- ROLL - Biblioteca eficiente y fácil de usar para escalar el aprendizaje por refuerzo con modelos de lenguaje grandes.
- veRL - veRL es un marco de aprendizaje por refuerzo flexible y eficiente para LLM.
- NeMo Framework - Marco de IA generativa creado para investigadores y desarrolladores de PyTorch que trabajan con modelos de lenguaje grandes (LLM), modelos multimodales (MM), reconocimiento automático del habla (ASR), conversión de texto a voz (TTS) y visión artificial (CV).
- Colossal-AI - Hace que los grandes modelos de IA sean más baratos, rápidos y accesibles.
- BMTrain - Entrenamiento eficiente de modelos grandes.
- Mesh Tensorflow - Mesh TensorFlow: paralelismo de modelos más sencillo.
- maxtext - ¡Un LLM de JAX sencillo, de alto rendimiento y escalable!
- GPT-NeoX - Implementación de Transformers autorregresivos con paralelismo de modelos en GPU, basada en la biblioteca DeepSpeed.
- Transformer Engine - Biblioteca para acelerar el entrenamiento de modelos Transformer en GPU NVIDIA.
- OpenRLHF - Marco de RLHF fácil de usar, escalable y de alto rendimiento (ajuste PPO completo para más de 70B, DPO iterativo, LoRA, RingAttention y RFT).
- TRL - TRL es una biblioteca integral que proporciona un conjunto de herramientas para entrenar modelos de lenguaje Transformer mediante aprendizaje por refuerzo, desde el ajuste fino supervisado (SFT) y el modelado de recompensas (RM) hasta la optimización de políticas proximales (PPO).
- unslothai - Marco especializado en el ajuste fino eficiente. En su página de GitHub hay plantillas listas para usar para ajustar diversos LLM, con las que puedes entrenar fácilmente tus propios datos gratis en la nube de Google Colab.
- Axolotl - Marco de código abierto para ajustar y evaluar LLM. Simplifica la experimentación con distintas configuraciones de entrenamiento y facilita reproducir y compartir resultados; admite funciones como LoRA, QLoRA, DeepSpeed, PEFT y configuraciones con varias GPU.
Inferencia de LLM
Sección titulada «Inferencia de LLM»Referencia: llm-inference-solutions
- SGLang - Marco rápido de servicio para modelos de lenguaje grandes y modelos de lenguaje visual.
- vLLM - Motor de inferencia y servicio para LLM de alto rendimiento y uso eficiente de memoria.
- llama.cpp - Inferencia de LLM en C/C++.
- ollama - Empieza a usar Llama 3, Mistral, Gemma y otros modelos de lenguaje grandes.
- TGI - conjunto de herramientas para desplegar y ofrecer modelos de lenguaje grandes (LLM).
- TensorRT-LLM - Marco de Nvidia para la inferencia de LLM.
otras herramientas de despliegue
- FasterTransformer - Marco de NVIDIA para la inferencia de LLM (migrado a TensorRT-LLM).
- MInference - Para acelerar la inferencia de LLM con contextos largos, calcula la atención dispersa de forma aproximada y dinámica; reduce hasta 10 veces la latencia de inferencia del prellenado en una A100 sin perder precisión.
- exllama - Reescritura de la implementación de Llama de HF transformers con mayor eficiencia de memoria para usar pesos cuantizados.
- FastChat - Sistema distribuido de servicio de múltiples modelos LLM con interfaz web y API REST compatibles con OpenAI.
- mistral.rs - Inferencia de LLM extremadamente rápida.
- SkyPilot - Ejecuta LLM y trabajos por lotes en cualquier nube. Consigue el máximo ahorro de costes, la mayor disponibilidad de GPU y una ejecución gestionada, todo con una interfaz sencilla.
- Haystack - marco de NLP de código abierto que permite utilizar LLM y modelos basados en Transformer de Hugging Face, OpenAI y Cohere para interactuar con tus propios datos.
- OpenLLM - Ajusta, ofrece, despliega y supervisa cualquier LLM de código abierto en producción. BentoML lo utiliza en producción para aplicaciones basadas en LLM.
- DeepSpeed-Mii - MII ofrece inferencia de baja latencia y alto rendimiento, similar a vLLM y con la potencia de DeepSpeed.
- Text-Embeddings-Inference - Inferencia de embeddings de texto en Rust, licencia HFOIL.
- Infinity - Inferencia de embeddings de texto en Python.
- LMDeploy - Marco de inferencia y servicio para LLM y VL de alto rendimiento y baja latencia.
- Liger-Kernel - Kernels de Triton eficientes para el entrenamiento de LLM.
- prima.cpp - Implementación distribuida de llama.cpp que permite ejecutar LLM de nivel 70B en dispositivos de uso cotidiano.
- deploy-llms-with-ansible - Despliega fácilmente cualquier LLM en una máquina virtual con una configuración mínima mediante Ansible.
Aplicaciones de LLM
Sección titulada «Aplicaciones de LLM»Referencia: awesome-llm-apps
- dspy - DSPy: el marco para programar —no para crear prompts para— modelos fundacionales.
- LangChain — Biblioteca popular de Python/JavaScript para encadenar secuencias de prompts de modelos de lenguaje.
- LlamaIndex — Biblioteca de Python para ampliar aplicaciones de LLM con datos.
más aplicaciones
-
MLflow - MLflow: marco de código abierto para todo el ciclo de vida del aprendizaje automático; ayuda a los desarrolladores a hacer seguimiento de experimentos, evaluar modelos y prompts, desplegar modelos y añadir observabilidad mediante trazas.
-
Swiss Army Llama - Conjunto integral de herramientas para trabajar con LLM locales en diversas tareas.
-
LiteChain - Alternativa ligera a LangChain para componer LLM.
-
magentic - Integra sin problemas los LLM como funciones de Python.
-
wechat-chatgpt - Usa ChatGPT en WeChat mediante wechaty.
-
promptfoo - Prueba tus prompts. Evalúa y compara resultados de LLM, detecta regresiones y mejora la calidad de los prompts.
-
Agenta - Crea, versiona, evalúa y despliega fácilmente aplicaciones basadas en LLM.
-
Serge - Interfaz de chat creada con llama.cpp para ejecutar modelos Alpaca. ¡Sin claves de API y completamente autoalojada!
-
Langroid - Aprovecha los LLM mediante programación multiagente.
-
Embedchain - Marco para crear bots similares a ChatGPT sobre tus conjuntos de datos.
-
Opik - Evalúa, prueba y publica aplicaciones de LLM con confianza mediante un conjunto de herramientas de observabilidad para calibrar sus resultados durante todo el ciclo de desarrollo y producción.
-
IntelliServer - Simplifica la evaluación de LLM al proporcionar un microservicio unificado para acceder a varios modelos de IA y probarlos.
-
Langchain-Chatchat - Antes llamado langchain-ChatGLM; aplicación local de preguntas y respuestas basada en conocimientos con LLM (como ChatGLM) y LangChain.
-
Search with Lepton - Crea tu propio motor de búsqueda conversacional con menos de 500 líneas de código mediante LeptonAI.
-
Robocorp - Crea, despliega y opera Actions con Python desde cualquier lugar para mejorar tus agentes y asistentes de IA. Incluye un amplio conjunto de bibliotecas, utilidades y registros.
-
Tune Studio - Entorno de pruebas para que los desarrolladores ajusten y desplieguen LLM.
-
LLocalSearch - Búsqueda web local mediante cadenas de LLM.
-
AI Gateway — AI Gateway agiliza las solicitudes a más de 100 modelos de código abierto y cerrado mediante una API unificada. Está listo para producción y admite almacenamiento en caché, alternativas, reintentos, tiempos de espera y balanceo de carga; también puede desplegarse en el borde para minimizar la latencia.
-
talkd.ai dialog - API sencilla para desplegar cualquier RAG o LLM que quieras y añadir complementos.
-
Wllama - Vinculación de WebAssembly para llama.cpp que permite la inferencia de LLM en el navegador.
-
GPUStack - Administrador de clústeres de GPU de código abierto para ejecutar LLM.
-
MNN-LLM — Marco de inferencia en dispositivos que incluye inferencia de LLM en dispositivos (teléfonos móviles/PC/IoT).
-
CAMEL - Primer marco multiagente de LLM.
-
QA-Pilot - Proyecto de chat interactivo que aprovecha LLM de Ollama/OpenAI/MistralAI para comprender y explorar rápidamente repositorios de código de GitHub o recursos de archivos comprimidos.
-
Shell-Pilot - Interactúa con LLM mediante modelos de Ollama (o OpenAI, MistralAI) usando solo scripts de shell en Linux (o macOS), para mejorar la gestión inteligente del sistema sin dependencias.
-
MindSQL - Paquete de Python para convertir texto a SQL, con funciones de autoalojamiento y API REST compatibles con LLM propietarios y de código abierto.
-
Langfuse - Plataforma de ingeniería de LLM de código abierto 🪢: trazas, evaluaciones, gestión de prompts y entorno de pruebas.
-
AdalFlow - AdalFlow: biblioteca para crear y optimizar automáticamente aplicaciones de LLM.
-
Guidance — Práctica biblioteca de Python de Microsoft que usa plantillas Handlebars para intercalar generación, prompts y control lógico.
-
Evidently — Marco de código abierto para evaluar, probar y supervisar sistemas basados en ML y LLM.
-
Chainlit — Biblioteca de Python para crear interfaces de chatbot.
-
Guardrails.ai — Biblioteca de Python para validar resultados y reintentar operaciones fallidas. Sigue en fase alfa, así que pueden aparecer limitaciones y errores.
-
Semantic Kernel — Biblioteca de Python/C#/Java de Microsoft que admite plantillas de prompts, encadenamiento de funciones, memoria vectorizada y planificación inteligente.
-
Prompttools — Herramientas de Python de código abierto para probar y evaluar modelos, bases de datos vectoriales y prompts.
-
Outlines — Biblioteca de Python que ofrece un lenguaje específico de dominio para simplificar la creación de prompts y restringir la generación.
-
Promptify — Pequeña biblioteca de Python para usar modelos de lenguaje en tareas de NLP.
-
Scale Spellbook — Producto de pago para crear, comparar y publicar aplicaciones de modelos de lenguaje.
-
PromptPerfect — Producto de pago para probar y mejorar prompts.
-
Weights & Biases — Producto de pago para hacer seguimiento de experimentos de entrenamiento de modelos e ingeniería de prompts.
-
OpenAI Evals — Biblioteca de código abierto para evaluar el rendimiento de tareas con modelos de lenguaje y prompts.
-
Arthur Shield — Producto de pago para detectar toxicidad, alucinaciones, inyección de prompts, etc.
-
LMQL — Lenguaje de programación para interactuar con LLM, compatible con prompts tipados, flujo de control, restricciones y herramientas.
-
ModelFusion - Biblioteca de TypeScript para crear aplicaciones con LLM y otros modelos de ML (conversión de voz a texto, texto a voz y generación de imágenes).
-
OneKE — Modelo bilingüe chino-inglés de extracción de conocimiento que utiliza grafos de conocimiento y tecnologías de procesamiento del lenguaje natural.
-
llm-ui - Biblioteca de React para crear interfaces de usuario de LLM.
-
Wordware - IDE alojado en la web donde especialistas de dominio sin conocimientos técnicos colaboran con ingenieros de IA para crear agentes de IA específicos para tareas. Aborda los prompts como un nuevo lenguaje de programación, en lugar de bloques de poco o ningún código.
-
Wallaroo.AI - Despliega, gestiona y optimiza cualquier modelo a escala y en cualquier entorno, desde la nube hasta el borde. Permite pasar de un cuaderno de Python a la inferencia en minutos.
-
Dify - Plataforma de código abierto para desarrollar aplicaciones de LLM, con una interfaz intuitiva que agiliza los flujos de trabajo de IA, la gestión de modelos y el despliegue en producción.
-
LazyLLM - Aplicación de LLM de código abierto para crear fácilmente y sin complicaciones aplicaciones multiagente de LLM; admite el despliegue y el ajuste fino de modelos.
-
MemFree - Motor de búsqueda híbrida de IA de código abierto que obtiene al instante respuestas precisas de Internet, marcadores, notas y documentos. Admite el despliegue con un solo clic.
-
AutoRAG - Herramienta AutoML de código abierto para RAG. Optimiza automáticamente la calidad de las respuestas RAG, desde los conjuntos de datos de evaluación de generación hasta el despliegue de canalizaciones RAG optimizadas.
-
Epsilla - Plataforma integral de agentes de LLM con tus datos y conocimientos privados; ofrece agentes de IA listos para producción desde el primer día.
-
Arize-Phoenix - Herramienta de código abierto para la observabilidad de ML que se ejecuta en el entorno de tus cuadernos. Supervisa y ajusta modelos de LLM, CV y tabulares.
-
LLM - Utilidad de CLI y biblioteca de Python para interactuar con modelos de lenguaje grandes, tanto mediante API remotas como con modelos que pueden instalarse y ejecutarse en tu propio equipo.
-
Just-Chat - ¡Crea tu agente de LLM y conversa con él de forma sencilla y rápida!
-
Agentic Radar - Analizador de seguridad de CLI de código abierto para flujos de trabajo agénticos. Examina el código fuente, detecta vulnerabilidades y genera una visualización interactiva junto con un informe de seguridad detallado. Admite LangGraph, CrewAI, n8n, OpenAI Agents y más.
-
LangWatch - Plataforma de código abierto para la observabilidad de LLM, la evaluación de prompts y su optimización.
-
TensorZero - TensorZero es un marco de código abierto para crear aplicaciones de LLM listas para producción. Unifica una pasarela de LLM, observabilidad, optimización, evaluaciones y experimentación.
Tutoriales y cursos sobre LLM
Sección titulada «Tutoriales y cursos sobre LLM»- Andrej Karpathy Series - ¡Mi favorito!
- Umar Jamil Series - vídeos educativos y de gran calidad que no te puedes perder.
- Alexander Rush Series - materiales educativos y de gran calidad que no te puedes perder.
- llm-course - Curso para iniciarse en los modelos de lenguaje grandes (LLM), con itinerarios de aprendizaje y cuadernos de Colab.
- UWaterloo CS 886 - Avances recientes en modelos fundacionales.
- CS25-Transformers United
- ChatGPT Prompt Engineering
- Princeton: Understanding Large Language Models
- CS324 - Large Language Models
- State of GPT
- A Visual Guide to Mamba and State Space Models
- Let’s build GPT: from scratch, in code, spelled out.
- minbpe - Código minimalista y limpio para el algoritmo de codificación por pares de bytes (BPE), usado habitualmente en la tokenización de LLM.
- femtoGPT - Implementación pura en Rust de un Transformer generativo preentrenado minimalista.
- Neurips2022-Foundational Robustness of Foundation Models
- ICML2022-Welcome to the “Big Model” Era: Techniques and Systems to Train and Serve Bigger Models
- GPT in 60 Lines of NumPy
- LLM‑RL‑Visualized (EN) | LLM‑RL‑Visualized (中文) - Más de 100 mapas de algoritmos de LLM y RL 📚.
Libros sobre LLM
Sección titulada «Libros sobre LLM»- Generative AI with LangChain: Build large language model (LLM) apps with Python, ChatGPT, and other LLMs - incluye un repositorio de GitHub que muestra gran parte de su funcionalidad
- Build a Large Language Model (From Scratch) - Guía para crear tu propio LLM funcional.
- BUILD GPT: HOW AI WORKS - explica cómo programar desde cero un Transformer generativo preentrenado, o GPT.
- Hands-On Large Language Models: Language Understanding and Generation - Explora el mundo de los modelos de lenguaje grandes con más de 275 ilustraciones originales en esta guía ilustrada.
- The Chinese Book for Large Language Models - Libro introductorio sobre LLM basado en A Survey of Large Language Models.
Grandes ideas sobre los LLM
Sección titulada «Grandes ideas sobre los LLM»- Why did all of the public reproduction of GPT-3 fail?
- A Stage Review of Instruction Tuning
- LLM Powered Autonomous Agents
- Why you should work on AI AGENTS!
- Google “We Have No Moat, And Neither Does OpenAI”
- AI competition statement
- Prompt Engineering
- Noam Chomsky: The False Promise of ChatGPT
- Is ChatGPT 175 Billion Parameters? Technical Analysis
- The Next Generation Of Large Language Models
- Large Language Model Training in 2023
- How does GPT Obtain its Ability? Tracing Emergent Abilities of Language Models to their Sources
- Open Pretrained Transformers
- Scaling, emergence, and reasoning in large language models
Miscelánea
Sección titulada «Miscelánea»- Emergent Mind - Las últimas noticias sobre IA, seleccionadas y explicadas por GPT-4.
- ShareGPT - Comparte con un clic tus conversaciones más sorprendentes de ChatGPT.
- Major LLMs + Data Availability
- 500+ Best AI Tools
- Cohere Summarize Beta - Presentamos Cohere Summarize Beta: un nuevo endpoint para resumir textos.
- chatgpt-wrapper - ChatGPT Wrapper es una API y CLI de Python no oficial y de código abierto que permite interactuar con ChatGPT.
- Cursor - Escribe, edita y conversa sobre tu código con una potente IA.
- AutoGPT - aplicación experimental de código abierto que muestra las capacidades del modelo de lenguaje GPT-4.
- OpenAGI - Cuando los LLM se encuentran con expertos de dominio.
- EasyEdit - Marco fácil de usar para editar modelos de lenguaje grandes.
- chatgpt-shroud - Extensión de Chrome para ChatGPT de OpenAI que mejora la privacidad al facilitar ocultar y mostrar el historial de chat. Ideal para proteger la privacidad durante las presentaciones de pantalla.
- AI For Developers - Lista de herramientas y agentes de IA para desarrolladores.
Colaboraciones
Sección titulada «Colaboraciones»Este repositorio está activo y siempre agradecemos tus contribuciones.
Mantendré abiertas algunas solicitudes de incorporación de cambios si no estoy seguro de que sean adecuadas para los LLM; puedes votar por ellas añadiendo 👍.
Si tienes alguna pregunta sobre esta lista seleccionada, no dudes en contactarme en chengxin1998@stu.pku.edu.cn.
HagiCode
HagiCode es un espacio de programación con agentes. Las interacciones de interfaz, ricas y cómodas, hacen que planificar, ejecutar agentes y trabajar en proyectos sea accesible y fácil de seguir, para una experiencia de desarrollo atractiva.
Una experiencia de desarrollo atractiva gracias a interacciones de interfaz ricas y cómodas.

- InteligenteLos flujos de trabajo de OpenSpec convierten la intención en un itinerario ejecutable, de la propuesta al diseño, las tareas y la entrega.
- EficienteLa ejecución multiagente avanza en paralelo con la investigación, la implementación y la revisión, en varios repositorios y con los Agent CLI que ya usas.
- InteresanteLas interacciones de interfaz, ricas y cómodas, hacen que planificar, ejecutar agentes y trabajar en proyectos sea accesible y fácil de seguir.
Descargar para Windows
Compartir HagiCode

Convierte ideas en software entregado.
HagiCode es un espacio de trabajo de programación con agentes: los flujos de trabajo de OpenSpec planifican el cambio, la ejecución multiagente lo lleva a cabo y Hero Scenario hace visible el largo recorrido, para convertir ideas en software entregado.
- Inteligente
- Los flujos de OpenSpec convierten la intención en un camino de la propuesta a la entrega.
- Eficiente
- La ejecución multiagente avanza en paralelo con investigación, implementación y revisión.
- Divertido
- Las interacciones de interfaz facilitan la planificación, los agentes y el trabajo en proyectos.
© 2026 HagiCode | Powered By hagilight-starlight@0.21.0 | Branch: main | Commit: 745b50b | Built: