
Production Machine Learning
Source: https://github.com/EthicalML/awesome-production-machine-learning at
4efc0a16249c
License: MIT
Read the English original
This edition is an AI-assisted translation.


Awesome Production Machine Learning
Sección titulada «Awesome Production Machine Learning»Este repositorio reúne una lista seleccionada de excelentes bibliotecas de código abierto que te ayudarán a desplegar, supervisar, versionar, escalar y proteger el aprendizaje automático en producción 🚀
Puedes mantenerte al día siguiendo este repositorio de GitHub y recibir cada mes un resumen de las nuevas bibliotecas de ML para producción añadidas mediante las versiones 🤩
Además, ofrecemos un kit de búsqueda que te ayuda a recorrer rápidamente la cadena de herramientas.
Enlaces rápidos a las secciones de esta página
Sección titulada «Enlaces rápidos a las secciones de esta página»Cómo contribuir a la lista
Sección titulada «Cómo contribuir a la lista»Al enviar una solicitud de incorporación de cambios (PR), revisa los requisitos de CONTRIBUTING.md para ayudarnos a mantener la lista limpia y actualizada. Gracias a la comunidad por impulsar su crecimiento constante 🚀
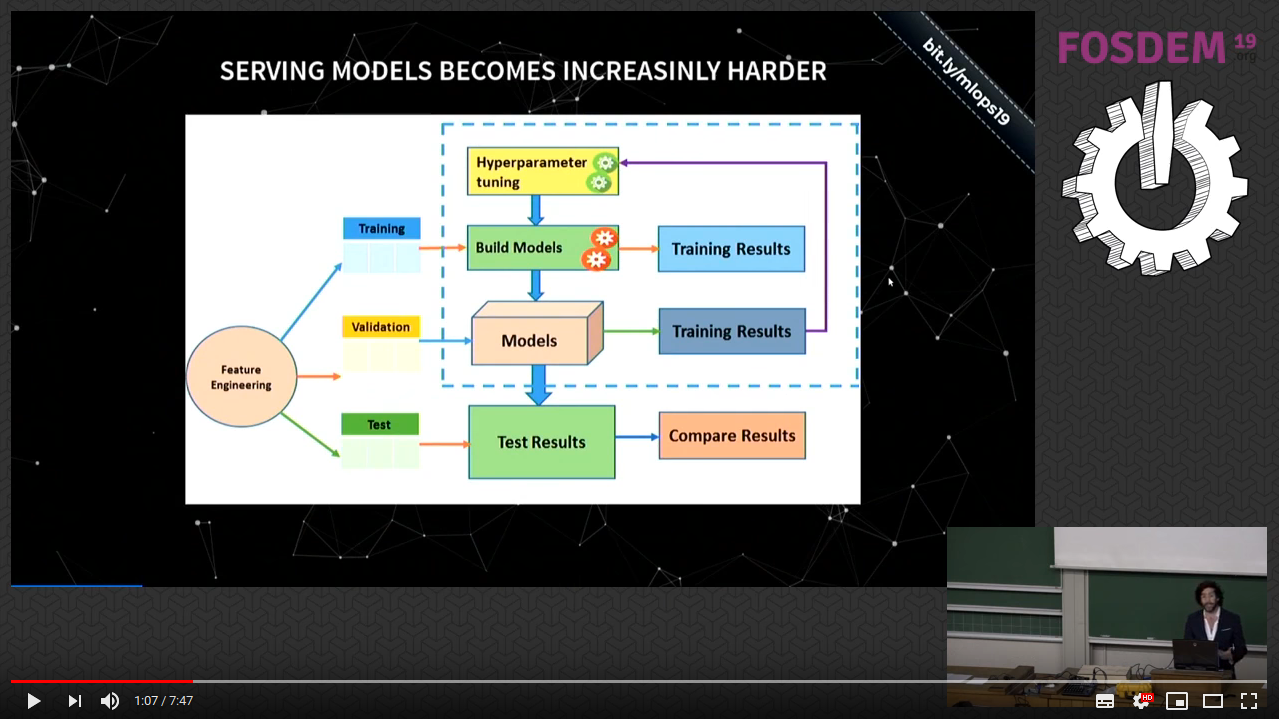
Vídeo de presentación de 10 minutos
Sección titulada «Vídeo de presentación de 10 minutos»| Este vídeo de 10 minutos ofrece una visión general de las motivaciones de las operaciones de aprendizaje automático y de algunas de las herramientas de este repositorio. Este vídeo más reciente presenta una versión actualizada del estado de MLOps en 2024. |
|
¿Quieres recibir actualizaciones periódicas sobre este repositorio y otros avances?
Sección titulada «¿Quieres recibir actualizaciones periódicas sobre este repositorio y otros avances?»| Puedes suscribirte al boletín Machine Learning Engineer. Únete a más de 70 000 profesionales y entusiastas del ML que reciben semanalmente artículos y tutoriales seleccionados sobre aprendizaje automático en producción. |
|
| Echa también un vistazo a la lista Awesome Production GenAI, en la que reunimos una selección de excelentes bibliotecas de código abierto para desplegar, supervisar, versionar y escalar aplicaciones y sistemas de inteligencia artificial generativa. |
|
Contenido principal
Sección titulada «Contenido principal»- AIDE
 - AIDE es un agente de ingeniería de ML de código abierto que utiliza un algoritmo de búsqueda en árbol para explorar, implementar y evaluar de forma autónoma estrategias de solución para tareas de aprendizaje automático.
- AutoGluon
 - Selección automatizada de características, modelos e hiperparámetros para datos tabulares, imágenes y texto, basada en bibliotecas populares de aprendizaje automático (Scikit-Learn, LightGBM, CatBoost, PyTorch, MXNet).
- Autokeras
 - Biblioteca AutoML para Keras basada en “Auto-Keras: Efficient Neural Architecture Search with Network Morphism”.
- auto-sklearn
 - Marco para automatizar el ajuste de algoritmos e hiperparámetros para sklearn.
- Ax
 - Ax es una plataforma accesible de propósito general para comprender, gestionar, desplegar y automatizar experimentos adaptativos.
- BoTorch
 - BoTorch es una biblioteca de optimización bayesiana basada en PyTorch.
- EvalML
 - EvalML es una biblioteca AutoML que crea, optimiza y evalúa canalizaciones de aprendizaje automático mediante funciones objetivo específicas del dominio.
- Feature Engine
 - Feature-engine es una biblioteca de Python que incluye varios transformadores para crear características destinadas a modelos de aprendizaje automático.
- Featuretools
 - Marco de código abierto para la ingeniería automatizada de características.
- FLAML
 - FLAML es una biblioteca rápida para el aprendizaje automático automatizado y el ajuste de modelos.
- HEBO
 - Conjunto de marcos de código abierto para la optimización de hiperparámetros, incluida la propuesta ganadora del NeurIPS 2020 Black-Box Optimisation Challenge, probados en tareas de ajuste de hiperparámetros.
- Katib
 - Sistema basado en Kubernetes para el ajuste de hiperparámetros y la búsqueda de arquitecturas neuronales.
- keras-tuner
 - Keras Tuner es un marco de optimización de hiperparámetros fácil de usar y distribuible que resuelve las dificultades de realizar búsquedas de hiperparámetros. Facilita la definición de un espacio de búsqueda y el uso de los algoritmos incluidos para encontrar los mejores valores de hiperparámetros.
- Optuna
 - Optuna es un marco de software para la optimización automática de hiperparámetros, diseñado especialmente para el aprendizaje automático.
- OSS Vizier
 - OSS Vizier es un servicio basado en Python para la optimización de caja negra y la investigación; fue uno de los primeros servicios de ajuste de hiperparámetros diseñados para funcionar a gran escala.
- Perpetual
 - Método de gradient boosting que no requiere optimizar hiperparámetros; un sencillo parámetro de presupuesto controla la complejidad del modelo.
- TPOT
 - Automatiza la creación de canalizaciones de sklearn (incluida la selección de características, el preprocesamiento, etc.).
- tsfresh
 - Extracción automática de características relevantes de series temporales.
Optimización del cálculo y la comunicación
Sección titulada «Optimización del cálculo y la comunicación»- Accelerate
 - Accelerate abstrae exactamente el código repetitivo relacionado con varias GPU/TPU y la precisión mixta, y deja intacto el resto del código.
- Adapters
 - Adapters es una biblioteca unificada para el aprendizaje por transferencia modular y eficiente en parámetros.
- Cache-DiT
 - Cache-DiT se basa en Diffusers y admite casi todos los DiT; ofrece aceleración híbrida mediante caché (DBCache, TaylorSeer, SCM, etc.) y optimizaciones integrales del paralelismo, incluido el paralelismo de contexto, de tensores y el paralelismo híbrido 2D/3D, además de ser compatible con compilación, descarga a CPU y cuantización.
- Colossal-AI
 - Sistema unificado de aprendizaje profundo para la era de los modelos grandes, que ayuda a desplegar de forma rápida y eficiente el entrenamiento y la inferencia de modelos de IA de gran tamaño.
- Composer
 - Composer es una biblioteca de PyTorch que permite entrenar redes neuronales más rápido, a menor coste y con mayor precisión.
- CuDF
 - Basada en el formato de memoria columnar Apache Arrow, cuDF es una biblioteca de GPU para cargar, combinar, agregar, filtrar y manipular datos de DataFrame.
- CuML
 - cuML es un conjunto de bibliotecas que implementan algoritmos de aprendizaje automático y funciones primitivas matemáticas con API compatibles con otros proyectos RAPIDS.
- CuPy
 - Implementación de matrices multidimensionales compatible con NumPy sobre CUDA. CuPy incluye la clase central de matrices multidimensionales cupy.ndarray y numerosas funciones para trabajar con ellas.
- DEAP
 - Innovador marco de computación evolutiva para crear prototipos y probar ideas rápidamente. Busca hacer explícitos los algoritmos y transparentes las estructuras de datos. Funciona a la perfección con mecanismos de paralelización como multiprocessing y SCOOP.
- DeepEP
 - DeepEP es una biblioteca de comunicación especializada en Mixture-of-Experts (MoE) y paralelismo de expertos (EP). Ofrece kernels GPU all-to-all de alto rendimiento y baja latencia, también conocidos como despacho y combinación MoE. La biblioteca también admite operaciones de baja precisión, incluido FP8.
- DGL
 - DGL es un paquete de Python fácil de usar, de alto rendimiento y escalable para el aprendizaje profundo sobre grafos.
- DLRover
 - DLRover facilita que el entrenamiento distribuido de grandes modelos de IA sea sencillo, estable, rápido y sostenible.
- Dask
 - Marco de procesamiento paralelo distribuido para cálculos de Pandas y NumPy.
- DeepSpeed
 - DeepSpeed es una biblioteca de optimización del aprendizaje profundo que facilita el entrenamiento y la inferencia distribuidos, y los hace eficientes y eficaces.
- FlagGems
 - FlagGems es una biblioteca de operadores de alto rendimiento implementada en OpenAI Triton. Se basa en una colección de kernels independientes del backend, concebidos para acelerar el entrenamiento y la inferencia de LLM en distintas plataformas de hardware.
- Flashlight
 - Biblioteca de aprendizaje automático rápida y flexible, escrita íntegramente en C++ por Facebook AI Research y los creadores de Torch, TensorFlow, Eigen y Deep Speech.
- Flax
 - Biblioteca y ecosistema de redes neuronales para JAX, diseñados para ofrecer flexibilidad.
- GPUStack
 - GPUStack es un gestor de clústeres GPU de código abierto para ejecutar modelos de IA.
- Hivemind
 - Aprendizaje profundo descentralizado en PyTorch.
- Jax
 - Transformaciones componibles de programas Python+NumPy: diferenciación, vectorización, compilación JIT para GPU/TPU y mucho más.
- Kompute
 - Marco de cálculo Vulkan ultrarrápido, ligero y compatible con teléfonos móviles, optimizado para casos de uso avanzados de procesamiento de datos en GPU.
- Liger Kernel
 - Liger Kernel es una colección de kernels Triton diseñados específicamente para entrenar LLM.
- LightGBM
 - LightGBM es un marco de gradient boosting que utiliza algoritmos de aprendizaje basados en árboles.
- MLX
 - MLX es un marco de matrices para el aprendizaje automático en Apple silicon.
- Modin
 - Acelera tus flujos de trabajo de Pandas cambiando una sola línea de código.
- NVIDIA TensorRT
 - TensorRT es una biblioteca C++ para inferencias de alto rendimiento en GPU NVIDIA y aceleradores de aprendizaje profundo.
- Nevergrad
 - Nevergrad es una plataforma de optimización sin gradientes.
- Norse
 - Norse busca aprovechar las ventajas de los componentes neuronales inspirados en la biología, que son dispersos y se activan por eventos: una diferencia fundamental frente a las redes neuronales artificiales.
- Numba
 - Compilador para funciones numéricas y de matrices de Python.
- Optimum
 - Optimum amplía Transformers y Diffusers con un conjunto de herramientas de optimización que permite entrenar y ejecutar modelos de forma muy eficiente en el hardware elegido, sin renunciar a la facilidad de uso.
- PEFT
 - Los métodos de ajuste fino eficiente en parámetros (PEFT) permiten adaptar eficazmente modelos de lenguaje preentrenados (PLM) a diversas aplicaciones posteriores sin ajustar todos los parámetros del modelo.
- PaddlePaddle
 - PaddlePaddle es un marco para entrenar redes profundas a gran escala con fuentes de datos distribuidas entre cientos de nodos.
- PyG
 - PyG (PyTorch Geometric) es una biblioteca basada en PyTorch que facilita la creación y el entrenamiento de redes neuronales de grafos (GNN) para una amplia variedad de aplicaciones con datos estructurados.
- PyTorch Lightning
 - PyTorch Lightning preentrena, ajusta y despliega modelos de IA en varias GPU y TPU sin cambiar el código.
- PyTorch
 - PyTorch es una biblioteca para desarrollar y entrenar modelos de aprendizaje profundo basados en redes neuronales.
- Ray
 - Ray es un marco flexible y de alto rendimiento para la ejecución distribuida de cargas de trabajo de aprendizaje automático.
- SetFit
 - SetFit es un marco eficiente, que no requiere prompts, para el ajuste fino de pocos ejemplos de Sentence Transformers.
- Sonnet
 - Sonnet es una biblioteca basada en TensorFlow 2 que ofrece abstracciones sencillas y componibles para la investigación en aprendizaje automático.
- Streaming
 - Biblioteca de flujos de datos para entrenar redes neuronales de forma eficiente.
- TensorFlow
 - TensorFlow es una biblioteca líder diseñada para desarrollar y desplegar aplicaciones de aprendizaje automático de última generación.
- ThunderKittens
 ThunderKittens es un marco que facilita la escritura de kernels rápidos de aprendizaje profundo en CUDA.
- TorchOpt
 - TorchOpt es una biblioteca eficiente para la optimización diferenciable basada en PyTorch.
- Triton
 - Triton es un lenguaje y compilador para escribir primitivas personalizadas de aprendizaje profundo muy eficientes. Su objetivo es ofrecer un entorno de código abierto para crear código rápido con mayor productividad que CUDA y más flexibilidad que otros DSL existentes.
- Vaex
 Vaex es una biblioteca Python de alto rendimiento para DataFrames diferidos y externos a memoria (similares a Pandas), destinada a visualizar y explorar grandes conjuntos de datos tabulares. Utiliza asignación de memoria, una política de copia cero y cálculos diferidos para ofrecer el máximo rendimiento sin desperdiciar memoria.
- Vowpal Wabbit
 Vowpal Wabbit es un sistema de aprendizaje automático que amplía las fronteras del campo mediante técnicas como aprendizaje en línea, hashing, allreduce, reducciones, learning2search y aprendizaje activo e interactivo.
- XGBoost
 - XGBoost es una biblioteca optimizada de gradient boosting distribuido, diseñada para ser muy eficiente, flexible y portable.
- YDF
 - YDF (Yggdrasil Decision Forests) es una biblioteca para entrenar, evaluar, interpretar y servir modelos de Random Forest, árboles de decisión con gradient boosting, CART y Isolation Forest.
- bitsandbytes
 - La biblioteca bitsandbytes es un envoltorio ligero de Python para funciones CUDA personalizadas, en particular optimizadores de 8 bits, multiplicación de matrices (LLM.int8()) y funciones de cuantización de 8 y 4 bits.
- einops
 - Operaciones con tensores flexibles y potentes para escribir código legible y fiable.
- scikit-learn
 - Scikit-learn es una potente biblioteca de aprendizaje automático que ofrece numerosos módulos para acceder a datos, prepararlos y crear modelos estadísticos.
- snnTorch
 - snnTorch es una biblioteca de aprendizaje profundo y en línea basada en redes neuronales de impulsos.
- torchdistill
 - torchdistill ofrece diversos métodos de destilación de conocimiento de última generación y permite diseñar experimentos nuevos con solo editar un archivo de configuración YAML declarativo, en lugar de código Python.
- torchkeras
 La biblioteca torchkeras es una herramienta sencilla para entrenar redes neuronales en PyTorch al estilo de Keras.
- veScale
 - veScale es un marco de entrenamiento de LLM nativo de PyTorch.
- yellowbrick
 - yellowbrick ofrece gráficos de evaluación de modelos basados en matplotlib para scikit-learn y otras bibliotecas de aprendizaje automático.
Anotación y síntesis de datos
Sección titulada «Anotación y síntesis de datos»- Argilla
 - Argilla ayuda a expertos del dominio y equipos de datos a crear mejores conjuntos de datos de PLN en menos tiempo.
- cleanlab
 - Biblioteca de IA centrada en los datos para Python. Puede encontrar automáticamente datos mal etiquetados, detectar valores atípicos, estimar el consenso y la calidad de los anotadores en conjuntos con varios anotadores, y sugerir qué datos conviene volver a etiquetar.
- COCO Annotator
 - Herramienta web de segmentación de imágenes para la detección de objetos, la localización y los puntos clave.
- CVAT
 - CVAT (Computer Vision Annotation Tool) es la herramienta web de anotación de OpenCV para vídeos e imágenes destinados a algoritmos informáticos.
- Doccano
 - Herramientas de código abierto para que las personas anoten texto, con funciones de análisis de sentimiento, reconocimiento de entidades con nombre y traducción automática.
- Label Studio
 - Herramienta de etiquetado y anotación de datos para múltiples dominios con un formato de salida estandarizado.
- LightlyStudio
 - Herramienta de código abierto para seleccionar, anotar y gestionar conjuntos de datos de visión (imágenes y vídeos). Admite selección automática basada en embeddings, anotación y etiquetado automático de cuadros delimitadores y segmentaciones.
- NeMo Curator
 - NeMo Curator es un marco acelerado por GPU para seleccionar eficazmente datos destinados a grandes modelos de lenguaje.
- refinery
 - La opción de código abierto para científicos de datos que necesitan escalar, evaluar y mantener datos de lenguaje natural.
- SDV
 - Synthetic Data Vault (SDV) es un ecosistema de bibliotecas para generar datos sintéticos. Permite aprender fácilmente conjuntos de datos de una o varias tablas y series temporales, y después generar nuevos datos sintéticos con el mismo formato y propiedades estadísticas que los originales.
- Semantic Segmentation Editor
 - Herramienta de código abierto de Hitachi para etiquetar datos de cámaras y LIDAR.
- synthcity
 - synthcity es una biblioteca para generar y evaluar datos tabulares sintéticos.
- TabGAN
 - Generación de datos tabulares sintéticos mediante GAN (CTGAN), modelos de difusión y LLM, con filtrado adversarial, métricas de privacidad e integración con sklearn.
- ViPE
 - ViPE es una herramienta de IA espacial para anotar poses de cámara y mapas de profundidad densos a partir de vídeos sin procesar.
- YData Synthetic
 - YData Synthetic es un paquete para generar datos sintéticos tabulares y de series temporales mediante modelos generativos de última generación.
Canalización de datos
Sección titulada «Canalización de datos»- Apache Airflow
 - Marco de canalización de datos creado en Python, con planificador, definición de DAG e interfaz de visualización.
- Apache Nifi
 - Apache NiFi está diseñado para el flujo de datos. Admite grafos dirigidos altamente configurables para el enrutamiento y la transformación de datos, así como la lógica de mediación entre sistemas.
- Argo Workflows
 - Argo Workflows es un motor de flujos de trabajo de código abierto y nativo de contenedores para orquestar trabajos paralelos en Kubernetes. Está implementado como un CRD (definición de recurso personalizado) de Kubernetes.
- Couler
 - Interfaz unificada para construir y gestionar flujos de trabajo de aprendizaje automático en distintos motores, como Argo Workflows, Tekton Pipelines y Apache Airflow.
- DataTrove
 - DataTrove es una biblioteca para procesar, filtrar y deduplicar datos de texto a gran escala.
- Dagster
 - Orquestador de datos para aprendizaje automático, análisis y ETL.
- DBT
 - Herramienta ETL para ejecutar transformaciones dentro de almacenes de datos.
- Flyte
 - Plataforma de Lyft, nativa de la nube, para el aprendizaje automático y el procesamiento de datos - (Demostración).
- Genie
 - Motor de orquestación de trabajos que permite conectar con sistemas basados en Hadoop y activar la ejecución de sus trabajos.
- Hamilton
 - Hamilton es un marco de microorquestación para definir flujos de datos. Se ejecuta donde se ejecute Python (por ejemplo, Jupyter, FastAPI, Spark, Ray o Dask). Incorpora buenas prácticas de ingeniería de software sin que tengas que preocuparte por ellas. Permite definir transformaciones de ingeniería de características, canalizaciones completas de modelos y flujos de trabajo de LLM. Complementa los sistemas de macroorquestación (como Kedro, Luigi, Airflow o dbt), sustituyendo el código de sus tareas. Incluye una interfaz autoalojable que registra el linaje y la procedencia, telemetría de ejecución y resúmenes de datos, y crea un catálogo que se rellena automáticamente, utilizable tanto en desarrollo como en producción.
- Instill VDP
 - Instill VDP (Versatile Data Pipeline) busca agilizar las canalizaciones de procesamiento de datos desde su inicio hasta su finalización.
- Instructor
 - Instructor facilita la obtención de datos estructurados, como JSON, a partir de LLM como GPT-3.5, GPT-4, GPT-4-Vision y modelos de código abierto.
- Kedro
 - Kedro es una herramienta de desarrollo de flujos de trabajo que ayuda a crear canalizaciones de datos robustas, escalables, desplegables, reproducibles y versionadas.
- Luigi
 - Luigi es un módulo de Python que ayuda a construir canalizaciones complejas de trabajos por lotes y gestiona la resolución de dependencias, los flujos de trabajo, la visualización, etc.
- Metaflow
 - Marco que permite a los científicos de datos crear y gestionar fácilmente proyectos de ciencia de datos del mundo real.
- Pachyderm
 - Marco distribuido de procesamiento de código abierto basado en Kubernetes, centrado principalmente en la creación dinámica de canalizaciones de aprendizaje automático para producción - (Vídeo).
- Pixeltable
 Biblioteca de Python de código abierto que ofrece infraestructura de datos declarativa e incremental para crear y gestionar cargas de trabajo de IA multimodal.
- Prefect Core
 - Sistema de gestión de flujos de trabajo que facilita añadir a las canalizaciones de datos semánticas como reintentos, registros, asignación dinámica, caché, notificaciones de fallos y mucho más.
- SeqIO
 - SeqIO es una biblioteca para procesar datos secuenciales que se utilizarán en modelos de secuencia posteriores.
- Snakemake
 - Sistema de gestión de flujos de trabajo para análisis de datos reproducibles y escalables.
- Towhee
 - Canalización de aprendizaje automático de propósito general para generar vectores de embedding mediante uno o varios modelos de ML.
- unstructured
 - unstructured agiliza y optimiza el procesamiento de datos para LLM: ingiere y preprocesa imágenes y documentos de texto, como PDF, HTML y Word, entre muchos otros.
- ZenML
 - ZenML es un marco MLOps extensible y de código abierto para crear canalizaciones de ML reproducibles, centrado en el seguimiento automatizado de metadatos, la caché y numerosas integraciones con otras herramientas.
Cuadernos de ciencia de datos
Sección titulada «Cuadernos de ciencia de datos»- Apache Zeppelin
 - Cuaderno web que permite realizar análisis de datos interactivos y basados en datos, así como crear documentos colaborativos con SQL, Scala y otros lenguajes.
- Deepnote
 - Deepnote sustituye directamente a Jupyter con un diseño centrado en la IA, una interfaz elegante, nuevos bloques e integraciones de datos nativas. Usa Python, R y SQL localmente en tu IDE favorito y luego escala a la nube de Deepnote para colaborar en tiempo real, utilizar el agente de Deepnote y desplegar aplicaciones de datos.
- Jupyter Notebooks
 - Entornos aislados de Python con interfaz web para un desarrollo reproducible.
- Marimo
 - Cuaderno reactivo de Python: ejecuta experimentos reproducibles, ejecútalo como script, despliega como aplicación y contrólalo con Git.
- Papermill
 - Papermill es una biblioteca para parametrizar cuadernos y ejecutarlos como scripts de Python.
- Polynote
 - Polynote es un entorno experimental de cuadernos políglotas. Actualmente admite Scala y Python (con o sin Spark), SQL y Vega.
- RMarkdown
 - El paquete rmarkdown es una implementación de nueva generación de R Markdown basada en Pandoc.
- Stencila
 - Stencila es una plataforma para crear, colaborar y compartir contenido basado en datos, transparente y reproducible.
- Voilà
 - Voilà convierte cuadernos de Jupyter en aplicaciones web independientes que, por ejemplo, pueden utilizarse como paneles de control.
Optimización del almacenamiento de datos
Sección titulada «Optimización del almacenamiento de datos»- AIStore
 - AIStore es un sistema ligero de almacenamiento de objetos que puede escalar linealmente al añadir nodos de almacenamiento y se centra especialmente en el aprendizaje profundo a escala de petabytes.
- Alluxio
 - Sistema virtual de almacenamiento distribuido que conecta los marcos de computación con los sistemas de almacenamiento.
- Apache Arrow
 - Representación columnar de datos en memoria compatible con Pandas, sistemas basados en Hadoop, etc.
- Apache Druid
 - Base de datos de análisis en tiempo real y de alto rendimiento. Consulta este artículo para obtener una introducción.
- Apache Hudi
 - Hudi es una plataforma transaccional de lago de datos que incorpora funciones esenciales de almacenes y bases de datos directamente en un lago de datos. Es ideal para cargas de trabajo de streaming y permite crear canalizaciones incrementales por lotes eficientes. Admite motores de consulta populares como Spark, Flink, Presto, Trino y Hive. Más información aquí.
- Apache Iceberg
 - Iceberg es un formato de alto rendimiento compatible con ACID, diseñado para tablas analíticas enormes (de decenas de petabytes). Aporta a los macrodatos la fiabilidad y sencillez de las tablas SQL y permite que motores como Spark, Trino, Flink, Presto, Hive e Impala trabajen de forma segura y simultánea con las mismas tablas. Más información aquí.
- Apache Ignite
 - Base de datos distribuida centrada en memoria, caché y plataforma de procesamiento para cargas transaccionales, analíticas y de streaming, con velocidades en memoria a escala de petabytes - Demostración.
- Apache Parquet
 - Representación columnar de datos en disco compatible con Pandas, sistemas basados en Hadoop, etc.
- Apache Pinot
 - Almacén OLAP distribuido en tiempo real. Aquí se encuentra una comparación de sistemas OLAP de código abierto para macrodatos: ClickHouse, Druid y Pinot.
- Casibase
 - Casibase es una base de conocimiento RAG (generación aumentada por recuperación) similar a LangChain, con interfaz web y SSO empresarial.
- Chroma
 - Chroma es una base de datos de embeddings de código abierto.
- ClickHouse
 - ClickHouse es un sistema de gestión de bases de datos columnar de código abierto.
- Delta Lake
 - Delta Lake es una capa de almacenamiento que aporta transacciones ACID escalables a Apache Spark y otros motores de macrodatos.
- EdgeDB
 - Gel potencia Postgres con un modelo de datos moderno, consultas de grafos, autenticación y soluciones de IA, entre muchas otras funciones.
- GPTCache
 - GPTCache es una biblioteca para crear una caché semántica para consultas a modelos de lenguaje grandes.
- InfluxDB
 Almacén escalable para métricas, eventos y análisis en tiempo real.
- Milvus
 Milvus es una base de datos vectorial de código abierto, nativa de la nube, diseñada para gestionar vectores de embeddings generados por modelos de aprendizaje automático y redes neuronales.
- Marqo
 Marqo es un motor integral de búsqueda vectorial.
- pgvector
 pgvector permite realizar búsquedas de similitud vectorial en Postgres.
- PostgresML
 PostgresML es una extensión de aprendizaje automático para PostgreSQL que permite entrenar y ejecutar inferencias sobre datos de texto y tabulares mediante consultas SQL.
- Redis
 Redis es un almacén de datos en memoria y de código abierto que admite búsquedas de similitud vectorial, por lo que resulta adecuado para aplicaciones de IA/ML como la búsqueda semántica y los sistemas de recomendación.
- Safetensors
 Forma sencilla y segura de almacenar y distribuir tensores.
- TimescaleDB
 Base de datos SQL de series temporales de código abierto, optimizada para la ingesta rápida y las consultas complejas, distribuida como extensión de PostgreSQL - (Vídeo).
- Weaviate
 - Motor de búsqueda vectorial de baja latencia (GraphQL, REST) con compatibilidad integrada para distintos tipos de medios. Sus módulos incluyen búsqueda semántica, preguntas y respuestas, clasificación, modelos personalizables (PyTorch/TensorFlow/Keras) y mucho más.
- Zarr
 - Implementación en Python de matrices N-dimensionales fragmentadas y comprimidas, diseñada para la computación paralela.
Procesamiento de flujos de datos
Sección titulada «Procesamiento de flujos de datos»- Apache Beam
 Apache Beam es un modelo de programación unificado para procesamiento por lotes y en streaming.
- Apache Flink
 - Marco de procesamiento de flujos de código abierto con potentes funciones para procesar flujos y lotes.
- Apache Kafka
 - Biblioteca cliente de Kafka para crear aplicaciones y microservicios cuyas entradas y salidas se almacenan en clústeres de Kafka.
- Apache Samza
 - Marco distribuido de procesamiento de flujos. Utiliza Apache Kafka para la mensajería y Apache Hadoop YARN para ofrecer tolerancia a fallos, aislamiento de procesadores, seguridad y gestión de recursos.
- Apache Spark
 - Procesamiento de flujos en micro lotes mediante Apache Spark, con semántica con estado de exactamente una vez.
- Bytewax
 - Marco flexible de procesamiento de flujos con estado, centrado en Python y basado en un motor Rust.
- FastStream
 - Marco moderno de streaming para Python, independiente del intermediario y compatible con los protocolos Apache Kafka, RabbitMQ y NATS. Inspirado en FastAPI y fácil de integrar con otros marcos web.
- MOA
 - MOA (Massive Online Analysis) es un marco de código abierto para la minería de flujos de macrodatos.
- MosaicML Streaming - Transmisión rápida y determinista de grandes conjuntos de datos desde almacenamiento en la nube para el entrenamiento distribuido de modelos.
- RisingWave
 - Base de datos SQL distribuida para streaming que unifica el procesamiento de flujos y el servicio de baja latencia, ideal para crear y servir características para el aprendizaje automático en línea.
- TensorStore
 - Biblioteca para leer y escribir grandes matrices multidimensionales.
Despliegue y servicio
Sección titulada «Despliegue y servicio»- Agenta
 - Agenta ofrece herramientas integrales para todo el flujo de trabajo de LLMOps: creación (entorno de pruebas de LLM, evaluación), despliegue (gestión de prompts y configuración) y observabilidad y trazabilidad de LLM.
- AirLLM
 - AirLLM optimiza el uso de memoria durante la inferencia, lo que permite ejecutar inferencias de modelos de lenguaje grandes de 70 000 millones de parámetros en una única GPU de 4 GB sin cuantización, destilación ni poda.
- AITemplate
 - AITemplate (AIT) es un marco de Python que transforma redes neuronales profundas en código C++ de CUDA (GPU NVIDIA) / HIP (GPU AMD) para ofrecer inferencias ultrarrápidas.
- BentoML
 - BentoML es un marco de código abierto para servir modelos de ML con alto rendimiento.
- Bifrost
 - Pasarela de IA que ofrece una API única compatible con OpenAI para más de 23 proveedores de LLM, con conmutación automática, balanceo de carga, caché semántica, control presupuestario y métricas de Prometheus.
- BISHENG
 - BISHENG es una plataforma abierta de DevOps para desarrollar aplicaciones de LLM, centrada en entornos empresariales.
- CosmoEdge
 - Motor de IA de vídeo en el borde escrito en C++ para despliegues de producción, que combina ingesta RTSP, inferencia de CV/VLM, orquestación visual, alertas y entrega de eventos en NPU Sophon y Rockchip.
- DeepDetect
 - Servidor de aprendizaje automático para producción, escrito en C++ y mantenido por Jolibrain, compatible con modelos de TensorFlow, XGBoost y Cafe.
- Dynamo
 - NVIDIA Dynamo es un marco de inferencia de alto rendimiento y baja latencia, diseñado para servir modelos de IA generativa y de razonamiento en entornos distribuidos con varios nodos.
- exo
 - exo te ayuda a ejecutar tu clúster de IA en casa con dispositivos de uso cotidiano.
- Genkit
 - Genkit es un marco de código abierto para crear aplicaciones basadas en IA con patrones familiares centrados en el código. Facilita el desarrollo, la integración y las pruebas de funciones de IA con observabilidad y evaluaciones.
- GoModel
 - GoModel es una pasarela de IA autoalojada, escrita en Go, que expone una API unificada compatible con OpenAI para OpenAI, Anthropic, Gemini, Groq, xAI, Ollama y otros proveedores; incluye enrutamiento, seguimiento de uso, límites de velocidad y protecciones.
- Inference
 - Servidor de inferencia rápido y listo para producción para visión artificial, compatible con el despliegue de numerosas arquitecturas populares y modelos ajustados. Con Inference puedes desplegar modelos como YOLOv5, YOLOv8, CLIP, SAM y CogVLM en tu propio hardware mediante Docker.
- Infinity
 - Infinity es una API REST de alto rendimiento y baja latencia para servir embeddings de texto, modelos de reordenamiento y CLIP.
- LiteLLM
 - LiteLLM es un SDK de Python y un servidor proxy (pasarela LLM) que permite llamar a más de 100 API de LLM en formato OpenAI: Bedrock, Azure, OpenAI, VertexAI, Cohere, Anthropic, Sagemaker, HuggingFace, Replicate y Groq.
- LiteRT
 - LiteRT (antes TensorFlow Lite) es el entorno de ejecución de alto rendimiento de Google para inferencias de IA en dispositivos, que permite desplegar modelos de aprendizaje automático en móviles, sistemas integrados y dispositivos de borde.
- LiteRT-LM
 - LiteRT-LM es el marco de inferencia de alto rendimiento y listo para producción de Google para desplegar grandes modelos de lenguaje en dispositivos de borde, con compatibilidad multiplataforma para Android, iOS, web, escritorio e IoT.
- LitServe
 - LitServe es un motor flexible para servir modelos de IA, basado en FastAPI. Admite motores de inferencia personalizados para modelos, agentes, sistemas multimodales, RAG y canalizaciones complejas de ML.
- jevos
 - jevOS es una alternativa de código abierto a Jev de TypeSafe para decisiones de sí o no: un clasificador binario de 1000 millones de parámetros (GGUF, llama.cpp) servido mediante una API HTTP FastAPI compatible con Jev, que funciona solo con CPU en un portátil.
- Jina-serve
 - Jina-serve es un marco para crear y desplegar servicios de IA que se comunican mediante gRPC, HTTP y WebSockets.
- Kiln
 - Kiln es una herramienta de código abierto para ajustar modelos LLM, generar datos sintéticos y colaborar en conjuntos de datos.
- KServe
 - KServe ofrece una definición de recurso personalizado de Kubernetes para servir modelos predictivos y generativos de aprendizaje automático.
- KTransformers
 - KTransformers es un marco flexible para probar optimizaciones de inferencia de LLM de vanguardia.
- Langtrace
 - Langtrace es una herramienta de observabilidad integral de código abierto, basada en OpenTelemetry, para aplicaciones LLM. Proporciona trazas, evaluaciones y métricas en tiempo real para los LLM, marcos de LLM, bases de datos vectoriales y más populares.
- Lepton AI
 - La biblioteca de Python de LeptonAI permite crear fácilmente un servicio de IA a partir de código Python.
- LightLLM
 - LightLLM es un marco de inferencia y servicio de LLM basado en Python, que destaca por su diseño ligero, facilidad de escalado y alto rendimiento.
- llama.cpp
 - llama.cpp es una biblioteca de software de código abierto que ejecuta inferencias en distintos modelos de lenguaje grandes, como Llama.
- llmfit
 - Herramienta de terminal que adapta los modelos LLM a la RAM, CPU y GPU de tu sistema. Detecta el hardware, puntúa cada modelo según calidad, velocidad, adecuación y contexto, y te indica cuáles funcionarán bien en tu equipo.
- LMCache
 - LMCache es una capa de caché KV de alto rendimiento que acelera la inferencia de LLM.
- LMDeploy
 - LMDeploy es un conjunto de herramientas para comprimir, desplegar y servir LLM.
- LM Studio
 - LM Studio es una herramienta para desplegar modelos LLM localmente en el ordenador, incluso en uno relativamente modesto, siempre que cumpla los requisitos mínimos.
- LocalAI
 - API REST de reemplazo directo compatible con las especificaciones de la API de OpenAI para inferencias locales.
- MindsDB
 - MindsDB es una plataforma para crear, servir y ajustar modelos en tiempo real a partir de bases de datos, almacenes vectoriales y datos de aplicaciones.
- mini-sglang
 - mini-sglang es un marco ligero y eficiente para servir grandes modelos de lenguaje.
- MLRun
 - MLRun es un marco MLOps abierto para crear y gestionar rápidamente aplicaciones continuas de ML e IA generativa a lo largo de todo su ciclo de vida.
- MLServer
 - Servidor de inferencia para modelos de aprendizaje automático, compatible con varios marcos, servicio multimodelo y mucho más.
- Model Runner
 - Docker Model Runner facilita la gestión, ejecución y prestación de modelos de IA mediante Docker. Admite LLM y otros modelos de IA obtenidos directamente de Docker Hub o de cualquier registro compatible con OCI.
- Mosec
 - Servidor de modelos basado en Rust y con canalización en varias etapas, que ofrece procesamiento dinámico por lotes y más. Es muy fácil de implementar y desplegar como microservicio.
- nano-vllm
 - nano-vllm es una implementación ligera de vLLM creada desde cero, que ofrece inferencia sin conexión rápida y optimizaciones como caché de prefijos, paralelismo de tensores y grafos CUDA.
- nndeploy
 - Marco de despliegue de IA fácil de usar y de alto rendimiento.
- Nuclio
 - Marco «serverless» de alto rendimiento para cargas de trabajo intensivas en datos, E/S y computación. Se integra bien con herramientas populares de ciencia de datos, como Jupyter y Kubeflow; admite diversas fuentes de datos y streaming, y permite ejecutar en CPU y GPU.
- OpenLLM
 - OpenLLM permite a los desarrolladores ejecutar cualquier LLM de código abierto (Llama 3.1, Qwen2, Phi3 y más) o modelo personalizado como API compatibles con OpenAI mediante un solo comando.
- OpenVINO
 - OpenVINO es un conjunto de herramientas de código abierto para optimizar y desplegar inferencias de IA.
- Open WebUI
 - Open WebUI es una plataforma de IA autoalojada, extensible, completa y fácil de usar, diseñada para funcionar totalmente sin conexión. Admite distintos ejecutores de LLM, como Ollama y API compatibles con OpenAI, e incorpora un motor de inferencia para RAG, lo que la convierte en una potente solución de despliegue de IA.
- OptiLLM
 - Proxy de inferencia optimizada compatible con la API de OpenAI que implementa más de 20 técnicas de vanguardia para mejorar notablemente la precisión y el rendimiento de los LLM en tareas de razonamiento, sin necesidad de entrenar ni ajustar modelos.
- PowerInfer
 - PowerInfer es un motor de inferencia de LLM para CPU/GPU que aprovecha la localidad de activación en tu dispositivo.
- Prompt2Model
 - Prompt2Model es un sistema que convierte una descripción de una tarea en lenguaje natural (como los prompts de ChatGPT) en el entrenamiento de un modelo pequeño y especializado, adecuado para su despliegue.
- RamaLama
 - RamaLama es una herramienta de código abierto que simplifica el uso local y el servicio de modelos de IA para inferencias mediante contenedores OCI, sin necesidad de configurar el sistema anfitrión.
- RunAnywhere
 - RunAnywhere es un SDK listo para producción que ejecuta modelos de IA (LLM, voz a texto y texto a voz) en dispositivos iOS, Android, React Native y Flutter, para crear aplicaciones móviles de IA privadas, sin conexión y rápidas.
- Seldon Core
 - Plataforma de código abierto para desplegar modelos de aprendizaje automático en Kubernetes - (Vídeo).
- SGLang
 - SGLang es un marco rápido para servir grandes modelos de lenguaje y modelos de visión y lenguaje.
- SIE
 - Servidor de inferencia de código abierto y clúster de producción para embeddings, reordenamiento y extracción. Incluye más de 85 modelos preconfigurados de vectores densos y dispersos, multivectoriales y de visión, además de modelos de reordenamiento y extracción. Incluye Helm, autoescalado con KEDA, paneles de Grafana y Terraform.
- SkyPilot
 - SkyPilot es un marco para ejecutar LLM, IA y trabajos por lotes en cualquier nube, que ofrece el máximo ahorro de costes, una alta disponibilidad de GPU y ejecución gestionada.
- Tensorflow Serving
 - Marco de alto rendimiento para servir modelos TensorFlow mediante el protocolo gRPC, capaz de gestionar 100 000 solicitudes por segundo y núcleo.
- torchtune
 - torchtune es una biblioteca de PyTorch para crear, realizar el posentrenamiento y experimentar fácilmente con LLM.
- Transformer Lab
 - Transformer Lab es un espacio de trabajo de código abierto para LLM que permite ajustar, evaluar, exportar y probar modelos localmente con distintos motores de inferencia y plataformas.
- Triton Inference Server
 - Triton es un software de servicio de alto rendimiento y código abierto para desplegar modelos de IA de cualquier marco en GPU y CPU, maximizando el uso de los recursos.
- Vercel AI
 - Vercel AI es un conjunto de herramientas TypeScript diseñado para crear aplicaciones basadas en IA con marcos populares como Next.js, React, Svelte y Vue, y entornos de ejecución como Node.js.
- Vespa
 - Busca, ejecuta inferencias y organiza vectores, tensores, texto y datos estructurados durante el servicio y a cualquier escala.
- vLLM
 - vLLM es un motor de inferencia y servicio para LLM de alto rendimiento y uso eficiente de memoria.
Evaluación y supervisión
Sección titulada «Evaluación y supervisión»- AlpacaEval
 - AlpacaEval es un evaluador automático para modelos de lenguaje que siguen instrucciones.
- ANN-Benchmarks
 - ANN-Benchmarks es un entorno de pruebas comparativas para algoritmos de búsqueda aproximada del vecino más cercano.
- ARES
 - ARES es un marco para evaluar automáticamente modelos de generación aumentada por recuperación (RAG).
- BEIR
 - BEIR es una prueba comparativa heterogénea que incluye diversas tareas de recuperación de información. También ofrece un marco común y sencillo para evaluar modelos de recuperación basados en PLN dentro de la prueba.
- Code Generation LM Evaluation Harness
 - Code Generation LM Evaluation Harness es un marco para evaluar modelos de generación de código.
- COMET
 - COMET es un marco de código abierto para la evaluación de aprendizaje automático.
- C-Eval
 - C-Eval es un conjunto integral de evaluaciones en chino para modelos fundacionales.
- Deepchecks
 - Deepchecks es una solución integral de código abierto para todas tus necesidades de validación de IA y ML, que permite probar exhaustivamente datos y modelos desde la investigación hasta la producción.
- DeepEval
 - DeepEval es un marco de evaluación de código abierto, sencillo de usar, para aplicaciones LLM.
- EvalAI
 - EvalAI es una plataforma de código abierto para evaluar y comparar algoritmos de IA a escala.
- Evalchemy
 - Evalchemy es un conjunto de herramientas unificado y fácil de usar para evaluar modelos de lenguaje con posentrenamiento.
- EvalPlus
 - EvalPlus es un marco sólido para evaluar LLM4Code, con pruebas ampliadas HumanEval+ y MBPP+, evaluación de eficiencia (EvalPerf) y un conjunto seguro y extensible de herramientas de evaluación.
- Evals
 - Evals es un marco para evaluar modelos de OpenAI y un registro de código abierto de pruebas comparativas.
- EvalScope
 - EvalScope es un marco optimizado y personalizable para evaluar eficazmente modelos grandes y comparar su rendimiento.
- Evaluate
 - Evaluate es una biblioteca que facilita la evaluación y comparación de modelos, así como la comunicación de sus resultados, de forma más estandarizada.
- Evidently
 - Evidently es un marco de código abierto para evaluar, probar y supervisar sistemas basados en ML y LLM.
- Future AGI
 - Plataforma de código abierto, autoalojable e integral para desarrollar y optimizar agentes, que unifica trazas, evaluaciones, simulaciones, conjuntos de datos, pasarelas y protecciones para aplicaciones de LLM y agentes de IA.
- GAOKAO-Bench
 - GAOKAO-Bench es un marco de evaluación que utiliza preguntas del examen nacional chino de acceso a la universidad (GAOKAO) para medir la comprensión lingüística y el razonamiento lógico de modelos grandes.
- Giskard
 - Giskard es una biblioteca de Python de código abierto que detecta automáticamente problemas de rendimiento, sesgo y seguridad en aplicaciones de IA.
- guidellm
 - guidellm es una herramienta para comparar y evaluar el rendimiento de sistemas de inferencia de grandes modelos de lenguaje.
- Harbor
 - Harbor es un marco para evaluar y optimizar agentes y modelos de lenguaje, compatible con experimentos paralelos en entornos de contenedores y con gestión integrada de pruebas comparativas y entornos.
- HumanEval
 - HumanEval es una prueba comparativa para evaluar la corrección funcional de modelos de generación de código mediante problemas de programación en Python con pruebas unitarias.
- Helicone
 - Helicone es una plataforma de desarrollo de LLM de código abierto, todo en uno.
- HELM
 - HELM (Holistic Evaluation of Language Models) ofrece herramientas para la evaluación integral de modelos de lenguaje, incluidos conjuntos de datos estandarizados, una API unificada para distintos modelos, métricas diversas, perturbaciones de equidad, un marco para crear prompts y un servidor proxy para acceder a los modelos de forma unificada.
- Inspect
 - Inspect es un marco para evaluar grandes modelos de lenguaje.
- IsaacLab-Arena
 - IsaacLab-Arena es una extensión de código abierto de NVIDIA Isaac Lab para crear entornos componibles y evaluar políticas robóticas a gran escala.
- JiWER
 - JiWER es un paquete de Python sencillo y rápido para evaluar sistemas de reconocimiento automático del habla.
- Laminar
 - Laminar es una plataforma de código abierto para rastrear, evaluar, etiquetar y analizar datos de LLM para productos de IA.
- Langfuse
 - Langfuse es una solución de observabilidad y analítica para aplicaciones basadas en LLM.
- LangTest
 - LangTest es un conjunto integral de herramientas de evaluación para modelos de PLN.
- Language Model Evaluation Harness
 - Language Model Evaluation Harness es un marco para probar modelos de lenguaje generativo en numerosas tareas de evaluación diferentes.
- LangWatch
 - LangWatch es una interfaz visual para DSPy y una plataforma completa de LLM Ops para supervisar, experimentar, medir y mejorar canalizaciones de LLM, con un modelo de distribución de código justo.
- Latitude
 - Latitude es una plataforma de código abierto para la observabilidad de agentes de IA, con búsqueda semántica de trazas y seguimiento de incidencias.
- LightEval
 - LightEval es un conjunto ligero de herramientas para evaluar LLM.
- lmms-eval
 - lmms-eval es un marco de evaluación diseñado meticulosamente para evaluar LMM de forma coherente y eficiente.
- Melting Pot
 - Melting Pot es un conjunto de escenarios de prueba para el aprendizaje por refuerzo multiagente.
- Meta-World
 - Meta-World es una prueba comparativa simulada de código abierto para el aprendizaje por meta-refuerzo y multitarea, compuesta por 50 tareas distintas de manipulación robótica.
- mir_eval
 - mir_eval es una biblioteca de Python que ofrece una forma transparente, estandarizada y sencilla de evaluar sistemas de recuperación de información musical.
- MLPerf Inference
 - MLPerf Inference es un conjunto de pruebas comparativas para medir la velocidad con la que los sistemas ejecutan modelos en diversos escenarios de despliegue.
- Massive Text Embedding Benchmark - Massive Text Embedding Benchmark (MTEB) es un marco de evaluación integral que mide el rendimiento de modelos de embeddings de texto en diversas tareas e idiomas: abarca 8 tareas de embeddings, 58 conjuntos de datos y 112 idiomas.
- NannyML
 - NannyML es una biblioteca que permite estimar el rendimiento de modelos tras su despliegue (sin acceder a los objetivos), detectar cambios en los datos y vincular de forma inteligente las alertas de deriva con cambios en el rendimiento del modelo.
- OGB
 - Open Graph Benchmark (OGB) es una colección de conjuntos de datos de referencia, cargadores de datos y evaluadores para el aprendizaje automático sobre grafos.
- Ollama Grid Search
 - Ollama Grid Search automatiza la selección de los mejores modelos, prompts o parámetros de inferencia para cada caso de uso; permite iterar sobre sus combinaciones e inspeccionar visualmente los resultados.
- onWatch
 - onWatch es una CLI ligera de Go que realiza un seguimiento en tiempo real del uso de cuotas de API de IA en varios proveedores (Anthropic Pro/Max Plans, Codex, Gemini CLI, Synthetic, Z.ai, GitHub Copilot, MiniMax Coding/Token Plan, Antigravity y OpenRouter), con proyecciones de consumo, gráficos históricos de uso y seguimiento por ciclo.
- OpenCompass
 - OpenCompass es una plataforma de evaluación de LLM compatible con una amplia variedad de modelos (LLaMA, LLaMa2, ChatGLM2, ChatGPT, Claude, etc.) y más de 50 conjuntos de datos.
- OpenLIT
 - OpenLIT es una plataforma de ingeniería de IA de código abierto que simplifica los flujos de trabajo de LLM con observabilidad, supervisión, protecciones, evaluaciones e integraciones fluidas.
- OpenLLMetry
 - OpenLLMetry ofrece a los desarrolladores una visión detallada de las aplicaciones de grandes modelos de lenguaje mediante supervisión del rendimiento, trazado de la ejecución y herramientas de depuración.
- Opik
 - Opik es una plataforma de código abierto para evaluar, probar y supervisar aplicaciones LLM.
- Overcooked-AI
 - Overcooked-AI es un entorno de pruebas comparativas para el rendimiento de tareas plenamente cooperativas entre personas e IA, basado en el popularísimo videojuego Overcooked.
- Phoenix
 - Phoenix es una plataforma de observabilidad de IA de código abierto, diseñada para experimentar, evaluar y solucionar problemas.
- Promptfoo
 - Marco de pruebas de seguridad ofensivas y evaluación de LLM para probar jailbreaks, inyección de prompts y otras vulnerabilidades, con integración de CI/CD.
- Prometheus-Eval
 - RagaAI Catalyst es una plataforma integral diseñada para mejorar la gestión y optimización de proyectos LLM.
- RagaAI Catalyst
 - Prometheus-Eval es una colección de herramientas para entrenar, evaluar y utilizar modelos de lenguaje especializados en la evaluación de otros modelos de lenguaje.
- Ragas
 - Ragas es un marco para evaluar canalizaciones RAG.
- RewardBench
 - RewardBench es una prueba comparativa diseñada para evaluar las capacidades y la seguridad de los modelos de recompensa.
- RLBench
 - RLBench es una ambiciosa prueba comparativa a gran escala y un entorno de aprendizaje, diseñado para facilitar la investigación en diversas áreas de manipulación guiada por visión, como el aprendizaje por refuerzo, por imitación y multitarea, la visión artificial geométrica y, en particular, el aprendizaje con pocos ejemplos.
- SimplerEnv
 - SimplerEnv es un entorno de manipulación simulado para evaluar políticas destinadas a configuraciones con robots reales.
- SwanLab
 - SwanLab es una herramienta para el seguimiento y la visualización del entrenamiento de IA.
- Speech-to-Text Benchmark
 - Speech-to-Text Benchmark es un marco minimalista y extensible para comparar distintos motores de conversión de voz a texto.
- TensorFlow Model Analysis
 - TensorFlow Model Analysis (TFMA) es una biblioteca para evaluar modelos de TensorFlow sobre grandes volúmenes de datos de forma distribuida, usando las mismas métricas definidas en su entrenador.
- TorchBench
 - TorchBench es una colección de pruebas comparativas de código abierto para evaluar el rendimiento de PyTorch.
- TruLens
 - TruLens ofrece un conjunto de herramientas para evaluar y realizar un seguimiento de experimentos con LLM.
- TrustLLM
 - TrustLLM es un marco integral para evaluar la fiabilidad de grandes modelos de lenguaje, que incluye principios, encuestas y pruebas comparativas.
- VBench
 - VBench es un conjunto integral de pruebas comparativas para modelos generativos de vídeo.
- VLMEvalKit
 - VLMEvalKit es un conjunto de herramientas de evaluación de código abierto para grandes modelos de visión y lenguaje (LVLM).
Explicabilidad y equidad
Sección titulada «Explicabilidad y equidad»- Aequitas
 - Conjunto de herramientas de código abierto para auditar sesgos, dirigido a científicos de datos, investigadores de aprendizaje automático y responsables de políticas. Permite auditar modelos de ML para detectar discriminación y sesgos, y tomar decisiones informadas y equitativas al desarrollar y desplegar herramientas predictivas de evaluación de riesgos.
- AI Explainability 360
 - Interpretabilidad y explicabilidad de datos y modelos de aprendizaje automático, con un conjunto integral de algoritmos que cubren distintas dimensiones de las explicaciones y métricas indirectas de explicabilidad.
- AI Fairness 360
 - Conjunto integral de métricas de equidad para conjuntos de datos y modelos de aprendizaje automático, explicaciones de esas métricas y algoritmos para mitigar sesgos en los datos y los modelos.
- Alibi
 - Alibi es una biblioteca de Python de código abierto para inspeccionar e interpretar modelos de aprendizaje automático. Inicialmente se centra en explicaciones de modelos de caja negra basadas en instancias.
- captum
 - Biblioteca para interpretar y comprender modelos de PyTorch, desarrollada por Facebook. Incluye implementaciones de propósito general de gradientes integrados, mapas de saliencia, SmoothGrad, VarGrad y otros métodos para modelos de PyTorch.
- Fairlearn
 - Fairlearn es un conjunto de herramientas de Python para evaluar y mitigar la falta de equidad en modelos de aprendizaje automático.
- InterpretML
 - InterpretML es un paquete de código abierto para entrenar modelos interpretables y explicar sistemas de caja negra.
- Lightly
 - Marco de Python para el aprendizaje autosupervisado con imágenes. Las representaciones aprendidas permiten analizar la distribución de datos sin etiquetar y reequilibrar conjuntos de datos.
- LOFO Importance
 - LOFO (Leave One Feature Out) Importance calcula la importancia de un conjunto de características según una métrica y un modelo elegidos: elimina cada característica por turnos, evalúa el rendimiento del modelo con un esquema de validación seleccionado y aplica la métrica elegida.
- mljar-supervised
 - Paquete de Python para AutoML con datos tabulares, ingeniería de características, ajuste de hiperparámetros, explicaciones y documentación automática.
- Quantus
 - Quantus es un conjunto de herramientas de IA explicable para evaluar de forma responsable las explicaciones de redes neuronales.
- SHAP
 - SHapley Additive exPlanations es un método unificado para explicar los resultados de cualquier modelo de aprendizaje automático.
- SHAPash
 - Shapash es una biblioteca de Python que ofrece distintos tipos de visualización con etiquetas explícitas que cualquiera puede entender.
- WhatIf
 - Interfaz fácil de usar para comprender mejor un modelo de ML de clasificación o regresión de caja negra.
Almacén de características
Sección titulada «Almacén de características»- FEAST
 - Feast (Feature Store) es un almacén de características de código abierto para el aprendizaje automático. Es la vía más rápida para aprovechar la infraestructura existente y llevar datos analíticos a producción para entrenar modelos y ejecutar inferencias en línea.
- Featureform
 - Almacén virtual de características, conectable a la infraestructura existente. Aprobado por científicos de datos. Descubrimiento, gobernanza, linaje y colaboración a solo una instalación de pip. Admite pandas, Python, Spark y SQL, además de integraciones con los principales proveedores de nube.
- Hopsworks Feature Store
 - Almacén de características fuera de línea/en línea para ML (Vídeo).
Detección de anomalías de nivel industrial
Sección titulada «Detección de anomalías de nivel industrial»- Alibi Detect
 - alibi-detect es un paquete de Python centrado en la detección de valores atípicos, ataques adversarios y deriva de conceptos.
- Darts
 - Darts es una biblioteca fácil de usar para pronosticar y detectar anomalías en series temporales.
- Deequ
 - Biblioteca basada en Apache Spark para definir «pruebas unitarias para datos» que miden la calidad de grandes conjuntos de datos.
- PyOD
 - Conjunto de herramientas de Python para la detección escalable de valores atípicos (detección de anomalías).
- TFDV
 - TFDV (TensorFlow Data Validation) es una biblioteca para explorar y validar datos de aprendizaje automático.
Visión artificial de nivel industrial
Sección titulada «Visión artificial de nivel industrial»- CameraTraps
 - CameraTraps (PyTorch Wildlife) es un marco colaborativo de aprendizaje profundo para analizar imágenes de fauna silvestre, con modelos de detección y clasificación entrenados con grandes conjuntos de datos de cámaras trampa.
- Deep Lake
 - Deep Lake es una infraestructura de datos optimizada para la visión artificial.
- DeepForest
 - DeepForest es un paquete de Python para entrenar y predecir copas de árboles individuales y especies a partir de imágenes RGB aéreas mediante aprendizaje profundo.
- Detectron2
 - Biblioteca de nueva generación de Facebook AI Research que ofrece algoritmos de detección y segmentación de última generación.
- Kornia
 - Kornia es una biblioteca diferenciable de visión artificial basada en PyTorch que ofrece un amplio conjunto de algoritmos diferenciables de procesamiento de imágenes y visión geométrica.
- libcom
 - libcom es un conjunto de herramientas para la composición de imágenes.
- LightlyTrain
 - Preentrena modelos de visión artificial con datos sin etiquetar para aplicaciones industriales.
- MMCV
 - MMCV es una biblioteca fundamental de visión artificial de OpenMMLab que ofrece funciones esenciales como procesamiento de imágenes y vídeo, transformación y aumento de datos, arquitecturas CNN y operaciones CUDA optimizadas.
- SuperGradients
 - SuperGradients es una biblioteca de código abierto para entrenar modelos de visión artificial basados en PyTorch.
- supervision
 - Supervision es una biblioteca de Python diseñada para gestionar eficazmente canalizaciones de visión artificial, con herramientas de anotación, visualización y supervisión de modelos.
- VideoSys
 - VideoSys admite numerosos modelos de difusión y varias técnicas de aceleración, lo que permite ejecutarlos más rápido y con menos memoria.
Recuperación de información de nivel industrial
Sección titulada «Recuperación de información de nivel industrial»- AutoRAG
 - AutoRAG es una herramienta AutoML para RAG que encuentra automáticamente una canalización RAG óptima para tus datos.
- BGE
 - BGE crea un conjunto integral de herramientas de recuperación para búsqueda y RAG.
- EmbedAnything
 - EmbedAnything es una canalización de embeddings minimalista, ligera y de alto rendimiento, creada en Rust para generar embeddings a partir de texto, imágenes, audio, PDF y otros medios, compatible con embeddings densos, dispersos, ONNX y de interacción tardía.
- Faiss
 - Faiss es una biblioteca para buscar similitudes y agrupar vectores densos de manera eficiente.
- GraphRAG
 - GraphRAG es un conjunto de canalizaciones de datos y transformaciones diseñado para extraer datos estructurados y significativos de texto no estructurado mediante LLM.
- HippoRAG
 - HippoRAG es un novedoso marco de generación aumentada por recuperación (RAG), inspirado en la neurobiología de la memoria humana a largo plazo, que permite a los LLM integrar continuamente conocimientos de documentos externos.
- JamAI Base
 - JamAI Base es una plataforma backend de código abierto para RAG (generación aumentada por recuperación) que integra una base de datos embebida (SQLite) y una base de datos vectorial embebida (LanceDB) con memoria gestionada y capacidades RAG. Incluye orquestación y gestión integradas de LLM, embeddings vectoriales y modelos de reordenamiento, accesibles desde una interfaz intuitiva tipo hoja de cálculo y una API REST sencilla.
- LangExtract
 - LangExtract es una biblioteca de Python que utiliza LLM para extraer información estructurada de documentos de texto no estructurados siguiendo instrucciones definidas por el usuario. Procesa materiales como notas clínicas e informes, identifica y organiza detalles clave y garantiza que los datos extraídos correspondan al texto fuente.
- LightRAG
 - Marco de generación aumentada por recuperación sencillo y rápido.
- llmware
 - llmware ofrece un marco unificado para crear aplicaciones basadas en LLM (por ejemplo, RAG y agentes) con modelos pequeños y especializados, que pueden desplegarse de forma privada, integrarse de manera segura con fuentes de conocimiento empresariales y adaptarse a cualquier proceso de negocio a bajo coste.
- Mem0
 - Mem0 potencia asistentes y agentes de IA con una capa de memoria inteligente que permite interacciones personalizadas con la IA.
- NGT
 - NGT ofrece comandos y una biblioteca para realizar búsquedas aproximadas del vecino más cercano a gran velocidad en grandes volúmenes de datos vectoriales de alta dimensión.
- NMSLIB
 - Non-Metric Space Library (NMSLIB): biblioteca eficiente de búsqueda por similitud y conjunto de herramientas para evaluar métodos k-NN en espacios genéricos no métricos.
- Qdrant
 - Motor de búsqueda de similitud vectorial de código abierto con compatibilidad ampliada para filtrado.
- R2R
 - R2R (RAG to Riches) es una plataforma integral para crear, desplegar y escalar aplicaciones RAG con búsqueda híbrida, compatibilidad multimodal y observabilidad avanzada.
- RAGFlow
 - RAGFlow es un motor RAG basado en la comprensión profunda de documentos.
- RAGxplorer
 - RAGxplorer es una herramienta para crear visualizaciones de RAG.
- RAG-FiT
 - Biblioteca diseñada para mejorar la capacidad de los LLM de utilizar información externa mediante el ajuste fino de modelos con conjuntos de datos RAG creados especialmente.
- TextWorld
 - TextWorld es un generador de juegos de texto y un entorno de aprendizaje extensible y aislado para entrenar y probar agentes de aprendizaje por refuerzo (RL).
- Zvec
 - Zvec es una base de datos vectorial de código abierto integrada en el proceso, para búsquedas de similitud con baja latencia.
Procesamiento del lenguaje natural de nivel industrial
Sección titulada «Procesamiento del lenguaje natural de nivel industrial»- aisuite
 - aisuite ofrece una interfaz sencilla y unificada para varios proveedores de IA generativa.
- Align-Anything
 - Align-Anything busca alinear con las intenciones y los valores humanos modelos grandes de cualquier modalidad (modelos de cualquier entrada a cualquier salida), incluidos LLM, VLM y otros.
- BERTopic
 - BERTopic es una técnica de modelado de temas que aprovecha transformers y c-TF-IDF para crear grupos densos y generar temas fáciles de interpretar, conservando las palabras importantes en sus descripciones.
- Burr
 - Burr ayuda a desarrollar aplicaciones que toman decisiones (chatbots, agentes y simulaciones). Incluye funciones listas para producción (telemetría, persistencia, despliegue, etc.) y una interfaz de código abierto, gratuita y local, Burr UI.
- Context7
 - Context7 proporciona documentación de código actualizada para prompts y agentes de programación con IA.
- Dify
 - Dify es una plataforma de código abierto para desarrollar aplicaciones LLM cuya interfaz intuitiva combina flujos de trabajo de IA con agentes, canalizaciones RAG, capacidades de agentes, gestión de modelos, funciones de observabilidad y más, para pasar rápidamente del prototipo a producción.
- dspy
 - Marco para programar con modelos fundacionales.
- Dust
 - Dust ayuda a diseñar y desplegar aplicaciones de grandes modelos de lenguaje.
- ESPnet
 - ESPnet es un conjunto integral de herramientas para el procesamiento del habla.
- FastChat
 - FastChat es una plataforma abierta para entrenar, servir y evaluar chatbots basados en grandes modelos de lenguaje.
- Flair
 - Marco sencillo de PLN de última generación desarrollado por Zalando y basado directamente en PyTorch.
- FunASR
 - FunASR es un conjunto de herramientas de reconocimiento automático del habla (ASR) listo para producción, compatible con más de 50 idiomas y con funciones integradas de VAD, puntuación, diarización de hablantes y reconocimiento de emociones, además de despliegue mediante Docker/WebSocket/REST y compatibilidad con el entorno de ejecución ONNX.
- Fun-ASR
 - ASR basada en LLM compatible con 31 idiomas, incluidos dialectos chinos, con puntuación, marcas de tiempo y diarización de hablantes nativas.
- Gensim
 - Gensim es una biblioteca de Python para modelar temas, indexar documentos y recuperar similitudes en corpus grandes.
- gpt-fast
 - Generación de texto con transformers nativa de PyTorch, sencilla y eficiente.
- Haystack
 - Haystack es un marco de PLN de código abierto que permite interactuar con tus datos mediante modelos Transformer y LLM (GPT-3 y similares). Ofrece herramientas listas para producción para crear rápidamente sistemas de preguntas y respuestas como ChatGPT, búsqueda semántica, generación de texto y más.
- Interactive Composition Explorer
 - ICE es una biblioteca de Python y un visualizador de trazas para programas basados en modelos de lenguaje.
- Jan
 - Jan es una alternativa de código abierto a ChatGPT que funciona completamente sin conexión en tu ordenador y te permite descargar y ejecutar LLM localmente con control y privacidad totales.
- Lamini
 - Lamini es un motor de LLM para personalizar modelos rápidamente.
- LangChain
 - LangChain ayuda a crear aplicaciones con LLM mediante la composición de componentes.
- LlamaIndex
 - LlamaIndex (GPT Index) es un marco de datos para aplicaciones basadas en LLM.
- LLaMA
 - LLaMA pretende ser un ejemplo mínimo, modificable y legible para cargar modelos LLaMA (arXiv) y ejecutar inferencias.
- LLaMA-Factory
 - LLaMA-Factory facilita el ajuste fino de más de 100 grandes modelos de lenguaje mediante una CLI y una interfaz web sin necesidad de programar.
- LLMBox
 - LLMBox es una biblioteca integral para implementar LLM, con una canalización de entrenamiento unificada y una evaluación completa de modelos.
- LLaMA2-Accessory
 - LLaMA2-Accessory es un conjunto de herramientas de código abierto para preentrenar, ajustar y desplegar grandes modelos de lenguaje (LLM) y LLM multimodales.
- LMFlow
 - LMFlow es un conjunto de herramientas extensible, práctico y eficiente para ajustar grandes modelos de aprendizaje automático.
- Megatron-LM
 - Megatron-LM es una biblioteca muy optimizada y eficiente para entrenar grandes modelos de lenguaje.
- MindNLP
 - MindNLP es un marco de PLN y LLM fácil de usar y de alto rendimiento, basado en MindSpore y compatible con los modelos y conjuntos de datos de Hugging Face.
- MLC LLM
 - MLC LLM es una solución universal que permite desplegar de forma nativa cualquier modelo de lenguaje en diversos backends de hardware y aplicaciones nativas; además, ofrece un marco productivo para que cualquiera optimice aún más el rendimiento de los modelos según sus propios casos de uso.
- mlx-lm
 - MLX LM es un paquete de Python para generar texto y ajustar grandes modelos de lenguaje en Apple silicon mediante MLX. Se integra con Hugging Face Hub y admite cuantización e inferencia distribuida.
- Ollama
 - Empieza a utilizar grandes modelos de lenguaje localmente.
- olmOCR
 - olmOCR es un conjunto de herramientas para entrenar modelos de lenguaje que trabajen con documentos PDF del mundo real.
- PaddleNLP
 - PaddleNLP es un conjunto de herramientas para desarrollar grandes modelos de lenguaje (LLM) basado en el marco de aprendizaje profundo PaddlePaddle. Admite el entrenamiento eficiente de modelos grandes, la compresión sin pérdida y la inferencia de alto rendimiento en distintos dispositivos de hardware.
- Promptise Foundry
 - Promptise Foundry es un marco de Python para producción de IA basada en agentes y servidores MCP. Abarca ejecución autónoma, memoria, integración de herramientas, gobernanza (presupuesto, estado, misión y secretos), protecciones, caché semántica y observabilidad.
- Semantic Kernel
 - Semantic Kernel es un SDK que integra grandes modelos de lenguaje (LLM), como OpenAI, Azure OpenAI y Hugging Face, con lenguajes de programación convencionales como C#, Python y Java. Permite definir complementos que pueden encadenarse con solo unas líneas de código.
- Sentence Transformers
 - Sentence Transformers facilita el cálculo de representaciones vectoriales densas para frases, párrafos e imágenes.
- SpaCy
 - spaCy es una biblioteca para el procesamiento avanzado del lenguaje natural en Python y Cython.
- SWIFT
 - SWIFT es una infraestructura ligera y escalable para ajustar modelos de aprendizaje profundo.
- Tensorflow Lingvo
 - Marco para crear redes neuronales en TensorFlow, especialmente modelos secuenciales.
- Tensorflow Text
 - TensorFlow Text ofrece una colección de clases y operaciones relacionadas con texto, listas para usar con TensorFlow 2.0.
- ToolBench
 - ToolBench es una plataforma abierta para entrenar, servir y evaluar grandes modelos de lenguaje en el aprendizaje de uso de herramientas.
- Transformers
 - Biblioteca de Hugging Face con modelos preentrenados de última generación para el procesamiento del lenguaje natural (PLN).
Sistemas de recomendación de nivel industrial
Sección titulada «Sistemas de recomendación de nivel industrial»- EasyRec
 - EasyRec es un marco para algoritmos de recomendación a gran escala.
- Gorse
 - Gorse aspira a ser un sistema de recomendación universal y de código abierto, que pueda incorporarse rápidamente a una amplia variedad de servicios en línea.
- Merlin
 - NVIDIA Merlin es una biblioteca de código abierto que ofrece sistemas de recomendación integrales acelerados por GPU, desde la ingeniería y el preprocesamiento de características hasta el entrenamiento de modelos de aprendizaje profundo y la ejecución de inferencias en producción.
- Recommenders
 - Recommenders incluye pruebas comparativas y buenas prácticas para crear sistemas de recomendación, presentadas en cuadernos de Jupyter.
- TorchRec
 - TorchRec es una biblioteca de dominio de PyTorch que ofrece primitivas comunes de dispersión y paralelismo necesarias para sistemas de recomendación (RecSys) a gran escala.
Aprendizaje por refuerzo de nivel industrial
Sección titulada «Aprendizaje por refuerzo de nivel industrial»- Acme
 - Acme es una biblioteca de componentes básicos de aprendizaje por refuerzo (RL) que busca ofrecer agentes sencillos, eficientes y legibles.
- AReaL
 - AReaL es una biblioteca de aprendizaje por refuerzo.
- ChatLearn
 - ChatLearn es un marco de entrenamiento por refuerzo flexible y eficiente para grandes modelos de lenguaje. Admite motores de entrenamiento distribuido (FSDP2, Megatron) y motores de inferencia (vLLM, SGLang), además de algoritmos modernos de RL como GRPO y GSPO.
- CleanRL
 - CleanRL es una biblioteca de aprendizaje profundo por refuerzo que ofrece implementaciones de alta calidad en un solo archivo, con funciones útiles para la investigación. La implementación es clara y sencilla, y puede escalarse para ejecutar miles de experimentos mediante AWS Batch.
- d3rlpy
 - d3rlpy es una biblioteca de aprendizaje profundo por refuerzo fuera de línea para profesionales e investigadores.
- D4RL
 - D4RL es una prueba comparativa de código abierto para el aprendizaje por refuerzo fuera de línea.
- Dopamine
 - Dopamine es un marco de investigación para crear prototipos de algoritmos de aprendizaje por refuerzo rápidamente. Responde a la necesidad de contar con una base de código pequeña y fácil de comprender, donde los usuarios puedan experimentar libremente con ideas audaces (investigación especulativa).
- EvoTorch
 - EvoTorch es una biblioteca de computación evolutiva de código abierto desarrollada en NNAISENSE y basada en PyTorch.
- FinRL
 - FinRL es el primer marco de código abierto que demuestra el enorme potencial del aprendizaje por refuerzo financiero.
- Gymnasium
 - Gymnasium es una biblioteca de Python de código abierto para desarrollar y comparar algoritmos de aprendizaje por refuerzo. Ofrece una API estándar para la comunicación entre algoritmos de aprendizaje y entornos, así como un conjunto estándar de entornos compatibles con dicha API.
- Gymnasium-Robotics
 - Gymnasium-Robotics contiene una colección de entornos robóticos de aprendizaje por refuerzo que utilizan la API de Gymnasium. Los entornos funcionan con el motor de física MuJoCo y sus bindings de Python mantenidos.
- Jumanji
 - Jumanji es un conjunto de entornos de aprendizaje por refuerzo (RL) escritos en JAX, con entornos limpios y acelerados por hardware para la investigación impulsada por la industria.
- MARLlib
 - MARLlib es una biblioteca integral de algoritmos de aprendizaje por refuerzo multiagente basada en RLlib. Ofrece a la comunidad de investigación MARL una plataforma unificada para crear, entrenar y evaluar algoritmos MARL.
- Mava
 - Mava es un marco para el aprendizaje por refuerzo multiagente distribuido en JAX.
- Melting Pot - Melting Pot es un conjunto de escenarios de prueba para el aprendizaje por refuerzo multiagente.
- MetaDrive
 - MetaDrive es un simulador de conducción que combina distintos escenarios para lograr un RL generalizable.
- Minigrid
 - La biblioteca Minigrid contiene una colección de entornos discretos de cuadrícula para investigar el aprendizaje por refuerzo. Los entornos siguen la API estándar de Gymnasium y están diseñados para ser ligeros, rápidos y fáciles de personalizar.
- MiniWorld
 - MiniWorld es un simulador minimalista de entornos interiores 3D para la investigación en aprendizaje por refuerzo y robótica.
- ML-Agents
 - ML-Agents es un proyecto de código abierto que permite utilizar juegos y simulaciones como entornos para entrenar agentes inteligentes mediante aprendizaje por refuerzo.
- MushroomRL
 - MushroomRL es una biblioteca de Python para el aprendizaje por refuerzo (RL) cuya modularidad permite utilizar fácilmente bibliotecas conocidas de cálculo tensorial (por ejemplo, PyTorch y TensorFlow) y pruebas comparativas de RL (por ejemplo, OpenAI Gym, PyBullet y DeepMind Control Suite).
- OmniSafe
 - OmniSafe es un marco de infraestructura diseñado para acelerar la investigación en aprendizaje por refuerzo seguro (RL).
- OpenRLHF
 - OpenRLHF es un marco de código abierto para el aprendizaje por refuerzo a partir de comentarios humanos (RLHF).
- PARL
 - PARL es un marco de aprendizaje por refuerzo flexible y de alto rendimiento.
- PettingZoo
 - PettingZoo es una biblioteca de Python para investigar el aprendizaje por refuerzo multiagente, similar a una versión multiagente de Gymnasium.
- ranx
 - ranx es una biblioteca de métricas rápidas de evaluación de clasificación implementadas en Python, que aprovecha Numba para acelerar las operaciones vectoriales y paralelizarlas automáticamente.
- RL4CO
 - RL4CO es una biblioteca de PyTorch para todo lo relacionado con el aprendizaje por refuerzo aplicado a la optimización combinatoria (CO).
- RL2
 - RL2 es una biblioteca de aprendizaje por refuerzo.
- RLinf
 - RLinf es una biblioteca de aprendizaje por refuerzo.
- ROLL
 - ROLL es una biblioteca de aprendizaje por refuerzo.
- skrl
 - skrl es una biblioteca modular de código abierto para el aprendizaje por refuerzo, escrita en Python (con PyTorch) y diseñada para priorizar la legibilidad, la sencillez y la transparencia en la implementación de algoritmos.
- SkyRL
 - SkyRL es una biblioteca integral de aprendizaje por refuerzo que ofrece marcos de entrenamiento modulares, backends de inferencia multiplataforma, canalizaciones con agentes y entornos Gymnasium para tareas RL de larga duración y del mundo real.
- slime
 - slime es un marco de posentrenamiento de LLM para escalar el aprendizaje por refuerzo.
- Stable Baselines
 - Fork de OpenAI Baselines con implementaciones de algoritmos de aprendizaje por refuerzo.
- TF-Agents
 - Biblioteca fiable, escalable y fácil de usar de TensorFlow para bandidos contextuales y aprendizaje por refuerzo.
- TorchRL
 - TorchRL es una biblioteca de código abierto para aprendizaje por refuerzo (RL) en PyTorch.
- TRL
 - Entrena modelos de lenguaje Transformer con aprendizaje por refuerzo.
- veRL
 - veRL (HybridFlow) es un marco de entrenamiento por RL flexible, eficiente y de nivel industrial, diseñado para LLM.
Robótica de nivel industrial
Sección titulada «Robótica de nivel industrial»- AI2-THOR
 - AI2-THOR es un marco interactivo de realismo casi fotográfico para agentes de IA.
- Genesis
 - Genesis es una plataforma física para IA corporizada y simulación robótica.
- Habitat-Sim
 - Habitat-Sim es un simulador 3D flexible y de alto rendimiento para la investigación en IA corporizada.
- IsaacLab
 - IsaacLab es un marco unificado y modular para el aprendizaje robótico que aprovecha NVIDIA Isaac Sim.
- LeRobot
 - LeRobot ofrece modelos, conjuntos de datos y herramientas para la robótica en el mundo real y el aprendizaje por imitación.
- robosuite
 - robosuite es un marco de simulación para el aprendizaje robótico, basado en el motor de física MuJoCo.
- RoboVerse
 - RoboVerse es una plataforma integral de simulación robótica con diversos entornos.
Visualización de nivel industrial
Sección titulada «Visualización de nivel industrial»- Apache ECharts
 - Apache ECharts es una potente biblioteca interactiva de gráficos y visualización de datos para navegadores.
- Apache Superset
 - Aplicación web moderna de inteligencia empresarial, lista para empresas.
- Bokeh
 - Bokeh es una biblioteca interactiva de visualización para Python que permite presentar datos de forma atractiva y significativa en navegadores web modernos.
- Bread Dataset Viewer - Extensión de VS Code para ver y explorar grandes conjuntos de datos de aprendizaje automático (CSV, JSON, Parquet, etc.) directamente en el editor, sin que el IDE se bloquee.
- Bread WandB Viewer - Extensión de VS Code para consultar experimentos, registros y artefactos de Weights & Biases en el IDE, sin tener que cambiar a la interfaz web y manteniendo la privacidad de los datos al funcionar completamente sin conexión.
- Data Formulator
 - Transforma datos y crea visualizaciones enriquecidas de forma iterativa con IA.
- ggplot2
 - Implementación de la gramática de los gráficos para R.
- gradio
 - Crea y comparte rápidamente demostraciones de modelos escribiendo solo Python. Depura modelos de forma interactiva en el navegador, recibe comentarios de colaboradores y genera enlaces públicos sin desplegar nada.
- Kangas
 - Kangas es una herramienta para explorar, analizar y visualizar datos multimedia a gran escala. Ofrece una API sencilla de Python para registrar grandes tablas de datos y una interfaz visual intuitiva para realizar consultas complejas sobre tus conjuntos de datos.
- matplotlib
 - Biblioteca de gráficos 2D para Python que produce figuras con calidad de publicación en diversos formatos impresos y entornos interactivos multiplataforma.
- Model Explorer
 - Model Explorer es una herramienta para visualizar y explorar modelos de aprendizaje automático. Ofrece una vista intuitiva basada en grafos para comprender la estructura del modelo, inspeccionar detalles de las capas y recorrer redes neuronales grandes.
- Netron
 - Netron es un visor de redes neuronales y modelos de aprendizaje profundo y automático.
- Perspective
 Visualización de tablas dinámicas en streaming mediante WebAssembly.
- Plotly
 - Biblioteca interactiva, de código abierto y basada en navegador para crear gráficos con Python.
- Redash
 - Redash es un marco de visualización de código abierto que facilita el acceso a grandes conjuntos de datos mediante distintos backends.
- Rerun
 - Rerun es un SDK de código abierto para registrar, almacenar, consultar y visualizar datos multimodales, diseñado para robótica, visión artificial e IA espacial.
- seaborn
 - Seaborn es una biblioteca de visualización para Python basada en matplotlib. Ofrece una interfaz de alto nivel para crear atractivos gráficos estadísticos.
- Spotlight
 - Spotlight ayuda a identificar segmentos de datos críticos y modos de fallo de modelos. Permite crear y mantener modelos de aprendizaje automático fiables seleccionando conjuntos de datos de alta calidad.
- Streamlit
 - Streamlit permite crear aplicaciones para proyectos de aprendizaje automático con scripts de Python sorprendentemente sencillos. Admite recarga en caliente, por lo que la aplicación se actualiza en directo cuando editas y guardas el archivo.
- tensorboardX
 - Escribe eventos de TensorBoard con una simple llamada a función.
- TensorBoard
 - TensorBoard es un conjunto de herramientas de visualización para experimentos de aprendizaje automático que facilita alojar, seguir y compartir experimentos de ML.
- Torchvista
 - Torchvista es una herramienta interactiva basada en cuadernos que visualiza el paso hacia delante de cualquier modelo de PyTorch como un grafo de cálculo. Admite módulos anidados plegables y visualizaciones parciales tolerantes a errores.
- Transformer Explainer
 - Transformer Explainer es una herramienta de visualización interactiva diseñada para ayudar a cualquiera a aprender cómo funcionan los modelos basados en Transformer, como GPT.
- Vega-Altair
 - Vega-Altair es una biblioteca declarativa de visualización estadística para Python.
- ydata-profiling
 - ydata-profiling ofrece una experiencia de análisis exploratorio de datos (EDA) en una sola línea, con una solución coherente y rápida.
Gestión de metadatos
Sección titulada «Gestión de metadatos»- Apache Atlas
 - El marco Apache Atlas es un conjunto extensible de servicios básicos de gobernanza que permite a las empresas cumplir sus requisitos normativos de forma eficaz y eficiente en Hadoop e integrarse con todo el ecosistema de datos empresarial.
- DataHub
 - DataHub es la herramienta generalizada de LinkedIn para buscar y descubrir metadatos.
- Marquez
 - Marquez es un servicio de metadatos de código abierto para recopilar, agregar y visualizar los metadatos de un ecosistema de datos.
- Metacat
 - Metacat es un servicio de API unificada para explorar metadatos. Se centra en resolver estos problemas: 1) vistas federadas de sistemas de metadatos; 2) almacenamiento arbitrario de metadatos sobre conjuntos de datos; 3) descubrimiento de metadatos.
- ML Metadata
 - Biblioteca para registrar y recuperar metadatos asociados a flujos de trabajo de desarrolladores de ML y científicos de datos.
Gestión de modelos, datos y experimentos
Sección titulada «Gestión de modelos, datos y experimentos»- Aim
 - Una forma muy sencilla de registrar, buscar y comparar experimentos de IA.
- ClearML
 - Gestor de experimentos y control de versiones de IA automágicos (antes llamado Trains).
- DataHub - DataHub es un catálogo de datos de código abierto para la pila de datos moderna.
- Dolt
 - Dolt es una base de datos SQL que puedes bifurcar, clonar, ramificar, fusionar, enviar y recibir, igual que un repositorio Git.
- DVC
 - DVC (Data Version Control) es un fork de Git que permite gestionar las versiones de modelos.
- HuggingFace Model Downloader
 - HuggingFace Model Downloader es una herramienta para descargar modelos y conjuntos de datos del sitio web de Hugging Face. Ofrece descargas multihilo para archivos LFS y verifica la integridad de los modelos descargados mediante sumas de comprobación SHA256.
- Keepsake
 - Control de versiones para aprendizaje automático.
- KitOps
 - KitOps es un sistema abierto y basado en estándares para empaquetar y versionar proyectos de IA/ML, compatible con todas las herramientas de IA/ML, desarrollo y DevOps que ya utilizas.
- lakeFS
 - Lago de datos repetible, atómico y versionado sobre almacenamiento de objetos.
- MLflow
 - Plataforma de código abierto para gestionar el ciclo de vida del ML, incluidos experimentación, reproducibilidad y despliegue.
- Polyaxon
 - Plataforma para el aprendizaje automático y profundo reproducible y escalable en Kubernetes - (Vídeo).
- Quilt
 - Versionado, reproducibilidad y despliegue de datos y modelos.
- Sacred
 - Herramienta para configurar, organizar, registrar y reproducir experimentos de aprendizaje automático.
- TerminusDB
 - Sistema de gestión de bases de datos de grafos que almacena datos como Git.
- Weights & Biases
 - Weights & Biases es una plataforma para realizar un seguimiento de experimentos de aprendizaje automático, versionar conjuntos de datos, buscar hiperparámetros, visualizar resultados y colaborar.
Entrenamiento y orquestación de modelos
Sección titulada «Entrenamiento y orquestación de modelos»- AutoTrain Advanced
 - AutoTrain Advanced es una solución sin código que permite entrenar modelos de aprendizaje automático con solo unos clics.
- Avalanche
 - Avalanche es una biblioteca integral para el aprendizaje continuo que ofrece una base de código abierta (con licencia MIT), compartida y colaborativa, para crear prototipos rápidamente, entrenar y evaluar algoritmos de aprendizaje continuo de forma reproducible.
- Axolotl
 - Axolotl es una herramienta diseñada para agilizar el ajuste fino de diversos modelos de IA, compatible con múltiples configuraciones y arquitecturas.
- BindsNET
 - BindsNET es una biblioteca de simulación de redes neuronales de impulsos orientada al desarrollo de algoritmos de aprendizaje automático inspirados en la biología.
- CML
 - Continuous Machine Learning (CML) es una biblioteca de código abierto para implementar integración y entrega continuas (CI/CD) en proyectos de aprendizaje automático.
- CoreNet
 - CoreNet es un conjunto de herramientas para redes neuronales profundas que permite a investigadores e ingenieros entrenar modelos estándar y novedosos, pequeños y a gran escala, para diversas tareas, incluidos modelos fundacionales (por ejemplo, CLIP y LLM), clasificación y detección de objetos y segmentación semántica.
- DataLinter
 - DataLinter es un analizador estático contextual de código abierto para datos y código, diseñado para ser independiente de ambos mediante complementos.
- Determined
 - Plataforma de entrenamiento de aprendizaje profundo con compatibilidad integrada para entrenamiento distribuido, ajuste de hiperparámetros y gestión de modelos (compatible con TensorFlow y PyTorch).
- dstack
 - dstack es un orquestador de contenedores de código abierto que simplifica la orquestación de cargas de trabajo y mejora el uso de GPU para equipos de ML.
- envd
 - Entorno de desarrollo de aprendizaje automático para equipos de ciencia de datos e ingeniería de IA/ML.
- Fire-Flyer File System
 - Fire-Flyer File System (3FS) es un sistema de archivos distribuido de alto rendimiento, diseñado para afrontar los retos de las cargas de trabajo de entrenamiento e inferencia de IA. Aprovecha SSD y redes RDMA modernas para ofrecer una capa de almacenamiento compartido que simplifica el desarrollo de aplicaciones distribuidas.
- H2O-3
 - Plataforma de aprendizaje automático rápida y escalable para aplicaciones más inteligentes: aprendizaje profundo, gradient boosting y XGBoost, Random Forest, modelos lineales generalizados (regresión logística, Elastic Net), K-Means, PCA, ensembles apilados, aprendizaje automático automatizado (AutoML), etc.
- Hopsworks
 - Hopsworks es una plataforma con uso intensivo de datos para diseñar y operar canalizaciones de aprendizaje automático.
- Ignite
 - Ignite es una biblioteca de alto nivel que facilita el entrenamiento y la evaluación flexible y transparente de redes neuronales en PyTorch.
- Kubeflow
 - Plataforma nativa de la nube para el aprendizaje automático, basada en las canalizaciones de ML internas de Google.
- Ludwig
 - Ludwig es un marco de bajo código para crear modelos de IA personalizados, como LLM y otras redes neuronales profundas.
- MFTCoder
 - MFTCoder es un proyecto de código abierto de CodeFuse para el ajuste fino multitarea (MFT) preciso y eficiente de grandes modelos de lenguaje (LLM), especialmente modelos de lenguaje para tareas de programación.
- MLeap
 - Estandarización de la serialización de canalizaciones y modelos para Spark, TensorFlow y sklearn.
- Nanotron
 - Nanotron ofrece primitivas distribuidas para entrenar eficazmente diversos modelos mediante paralelismo 3D.
- NeMo
 - NVIDIA NeMo es un marco de IA generativa escalable y nativo de la nube, creado para investigadores y desarrolladores de PyTorch que trabajan con grandes modelos de lenguaje (LLM), modelos multimodales (MM), reconocimiento automático del habla (ASR), conversión de texto a voz (TTS) y visión artificial (CV). Ayuda a crear, personalizar y desplegar eficazmente nuevos modelos de IA generativa aprovechando código existente y puntos de control de modelos preentrenados.
- Prime
 - Prime es un marco para el entrenamiento eficiente de modelos de IA distribuidos por todo el mundo a través de Internet.
- PyCaret
 Biblioteca de bajo código para entrenar y desplegar modelos (scikit-learn, XGBoost, LightGBM, spaCy).
- Sematic
 - Plataforma para crear canalizaciones con gran consumo de recursos usando Python sencillo.
- Skaffold
 - Skaffold es una herramienta de línea de comandos que facilita el desarrollo continuo de aplicaciones Kubernetes. Puedes iterar localmente sobre el código fuente de tu aplicación y luego desplegarla en clústeres Kubernetes locales o remotos.
- TFX
 - TensorFlow Extended (TFX) es un marco de configuración orientado a producción para ML basado en TensorFlow, que incluye supervisión y gestión de versiones de modelos.
- unsloth
 - Ajuste fino y aprendizaje por refuerzo para LLM. Entrena OpenAI gpt-oss, DeepSeek-R1, Qwen3, Gemma 3 y TTS dos veces más rápido con un 70 % menos de VRAM.
Optimización del almacenamiento de modelos
Sección titulada «Optimización del almacenamiento de modelos»- AWQ
 - Cuantización de pesos consciente de las activaciones para comprimir y acelerar LLM.
- GGML
 - GGML es una biblioteca de tensores de alto rendimiento para aprendizaje automático que permite realizar inferencias eficaces en CPU, especialmente optimizada para grandes modelos de lenguaje.
- neural-compressor
 - Intel® Neural Compressor ofrece técnicas populares de compresión de modelos, como cuantización, poda (dispersión), destilación y búsqueda de arquitecturas neuronales en los principales marcos.
- NNEF - Neural Network Exchange Format (NNEF) es un estándar abierto para representar modelos de redes neuronales y permitir la interoperabilidad y portabilidad entre distintos marcos y plataformas de aprendizaje automático.
- ONNX
 - ONNX (Open Neural Network Exchange) es un formato de código abierto diseñado para facilitar la interoperabilidad y portabilidad de modelos de aprendizaje automático entre distintos marcos y plataformas.
- PFA - PFA (Portable Format for Analytics) es un formato estándar para representar e intercambiar modelos predictivos y flujos de trabajo analíticos en un formato portátil basado en JSON.
- PMML - PMML (Predictive Model Markup Language) es un estándar basado en XML para representar y compartir modelos predictivos entre distintas aplicaciones.
- Quanto
 - Quanto busca simplificar la cuantización de modelos de aprendizaje profundo.
Privacidad y seguridad
Sección titulada «Privacidad y seguridad»- AI Gateway
 - AI Gateway es una pasarela de IA ultrarrápida con protecciones integradas.
- ART
 - ART (Adversarial Robustness Toolbox) ofrece herramientas para que desarrolladores e investigadores defiendan y evalúen modelos y aplicaciones de aprendizaje automático frente a amenazas adversarias de evasión, envenenamiento, extracción e inferencia.
- CipherChat
 - CipherChat es un marco para evaluar la capacidad de generalización de la alineación de seguridad de los LLM.
- DeepTeam
 - DeepTeam es un marco de código abierto, fácil de usar, para realizar pruebas de penetración y proteger sistemas basados en grandes modelos de lenguaje.
- FATE
 - FATE (Federated AI Technology Enabler) es el primer marco de aprendizaje federado de código abierto de nivel industrial del mundo, que permite a empresas e instituciones colaborar con datos protegiendo su seguridad y privacidad.
- FedML
 - FedML ofrece una plataforma integrada de investigación y producción en el borde y la nube para el aprendizaje automático federado y distribuido, en cualquier lugar y a cualquier escala.
- Flower
 - Flower es un marco de aprendizaje federado con un enfoque unificado. Permite federar cualquier carga de trabajo de ML, con cualquier marco de ML y lenguaje de programación.
- Google’s Differential Privacy
 - Biblioteca C++ de algoritmos con privacidad diferencial ε, que pueden generar estadísticas agregadas a partir de conjuntos de datos numéricos con información privada o sensible.
- Guardrails
 - Guardrails es un paquete que permite añadir garantías de estructura, tipo y calidad a las salidas de grandes modelos de lenguaje.
- NeMo Guardrails
 - NeMo Guardrails es un conjunto de herramientas de código abierto para añadir fácilmente protecciones programables a sistemas conversacionales basados en LLM.
- Opacus
 - Opacus es una biblioteca que permite entrenar modelos de PyTorch con privacidad diferencial. Admite el entrenamiento con cambios mínimos en el código del cliente, apenas afecta al rendimiento y permite realizar un seguimiento en línea del presupuesto de privacidad consumido en cada momento.
- OpenFL
 - OpenFL es un marco de Python para el aprendizaje federado. Está diseñado como una herramienta flexible, extensible y fácil de aprender para científicos de datos. Lo desarrollaron Intel Internet of Things Group (IOTG) e Intel Labs.
- PySyft
 - Biblioteca de Python para el aprendizaje profundo seguro y privado. PySyft separa los datos privados del entrenamiento de modelos mediante computación multipartita (MPC) en PyTorch.
- Tensorflow Privacy
 - Biblioteca de Python que incluye implementaciones de optimizadores de TensorFlow para entrenar modelos de aprendizaje automático con privacidad diferencial.
- TF Encrypted
 - Marco para el aprendizaje automático confidencial con datos cifrados en TensorFlow.
Otras listas increíbles
Sección titulada «Otras listas increíbles»- Awesome Agentic Engineering Resources
 - Colección seleccionada de recursos, herramientas y referencias para crear sistemas de IA con agentes.
- Awesome AI Gateway
 - Lista seleccionada y bilingüe (EN/zh-CN) de pasarelas de IA y proxies de LLM (LiteLLM, OpenRouter, Portkey, Kong, Higress, new-api), comparados por coste, cumplimiento, autoalojamiento y enrutamiento. Incluye un árbol de decisión, pruebas de costes reproducibles y una tabla comparativa para elegir.
- Awesome AI Regulation
 - Abarca gobernanza, cumplimiento y marcos regulatorios esenciales para desplegar sistemas de aprendizaje automático de forma responsable en distintas jurisdicciones.
- Awesome AI Tokenomics
 - Abarca el coste y la eficiencia de tokens en sistemas de IA, incluidos supervisión, optimización, caché, selección de modelos y gestión del contexto.
- Awesome Production GenAI
 - Se centra específicamente en el despliegue de IA generativa, incluidas las operaciones de LLM, la ingeniería de prompts y las herramientas de supervisión y seguridad específicas de GenAI.
- Awesome RAG Production
 - Lista seleccionada de herramientas listas para producción y buenas prácticas para crear sistemas RAG escalables.
Colaboradores
Sección titulada «Colaboradores»HagiCode
HagiCode es un espacio de programación con agentes. Las interacciones de interfaz, ricas y cómodas, hacen que planificar, ejecutar agentes y trabajar en proyectos sea accesible y fácil de seguir, para una experiencia de desarrollo atractiva.
Una experiencia de desarrollo atractiva gracias a interacciones de interfaz ricas y cómodas.

- InteligenteLos flujos de trabajo de OpenSpec convierten la intención en un itinerario ejecutable, de la propuesta al diseño, las tareas y la entrega.
- EficienteLa ejecución multiagente avanza en paralelo con la investigación, la implementación y la revisión, en varios repositorios y con los Agent CLI que ya usas.
- InteresanteLas interacciones de interfaz, ricas y cómodas, hacen que planificar, ejecutar agentes y trabajar en proyectos sea accesible y fácil de seguir.
Descargar para Windows
Compartir HagiCode

Convierte ideas en software entregado.
HagiCode es un espacio de trabajo de programación con agentes: los flujos de trabajo de OpenSpec planifican el cambio, la ejecución multiagente lo lleva a cabo y Hero Scenario hace visible el largo recorrido, para convertir ideas en software entregado.
- Inteligente
- Los flujos de OpenSpec convierten la intención en un camino de la propuesta a la entrega.
- Eficiente
- La ejecución multiagente avanza en paralelo con investigación, implementación y revisión.
- Divertido
- Las interacciones de interfaz facilitan la planificación, los agentes y el trabajo en proyectos.
© 2026 HagiCode | Powered By hagilight-starlight@0.21.0 | Branch: main | Commit: 745b50b | Built: