
Production Machine Learning
Source: https://github.com/EthicalML/awesome-production-machine-learning at
4efc0a16249c
License: MIT
Read the English original
This edition is an AI-assisted translation.


精选生产级机器学习资源
Section titled “精选生产级机器学习资源”本仓库精选了一系列优秀的开源库,助你将机器学习部署到生产环境,并进行监控、版本管理、扩展和安全防护 🚀
关注此 GitHub 仓库,即可通过版本发布及时了解每月新增的生产级机器学习库汇总 🤩
此外,我们还提供了一个搜索工具集,帮助你快速浏览整个工具链。
本页章节快速链接
Section titled “本页章节快速链接”如何为列表做贡献
Section titled “如何为列表做贡献”提交 PR 时,请先阅读我们的贡献指南,了解如何帮助我们保持列表整洁并及时更新——感谢社区一直以来对列表持续发展的支持 🚀
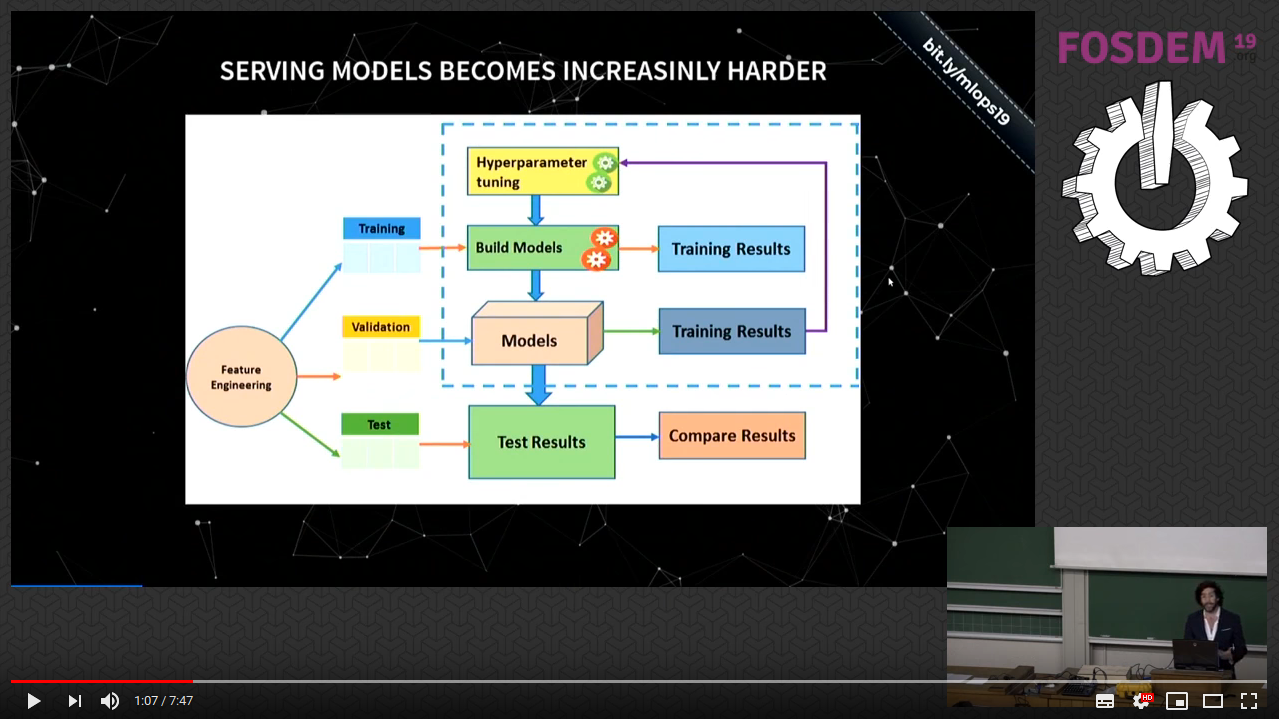
10 分钟视频概览
Section titled “10 分钟视频概览”| 本10 分钟视频介绍了机器学习运维(MLOps)的动机,并概述了本仓库中的部分工具。这个较新的视频介绍了 2024 年 MLOps 现状的更新版本。 |
|
想定期获取本仓库及其他进展的更新吗?
Section titled “想定期获取本仓库及其他进展的更新吗?”| 你可以订阅 Machine Learning Engineer 新闻通讯。加入超过 70,000 名机器学习专业人士和爱好者的行列,每周接收精选的生产级机器学习文章与教程。 |
|
| 也欢迎查看 Awesome Production GenAI 列表;我们致力于精选可用于部署、监控、版本管理和扩展生成式人工智能应用与系统的优秀开源库。 |
|
自动机器学习(AutoML)
Section titled “自动机器学习(AutoML)”- AIDE
 - AIDE 是一个开源机器学习工程代理,使用树搜索算法自主探索、实现并评估机器学习任务的解决策略。
- AutoGluon
 - 基于主流机器学习库(Scikit-Learn、LightGBM、CatBoost、PyTorch、MXNet),为表格、图像和文本数据自动选择特征、模型和超参数。
- Autokeras
 - 基于《Auto-Keras:通过网络形态变换实现高效神经架构搜索》的 Keras AutoML 库。
- auto-sklearn
 - 用于自动执行 sklearn 算法和超参数调优的框架。
- Ax
 - Ax 是一个易于使用的通用平台,用于理解、管理、部署和自动化自适应实验。
- BoTorch
 - 基于 PyTorch 构建的贝叶斯优化库。
- EvalML
 - EvalML 是一个 AutoML 库,使用领域专用目标函数构建、优化并评估机器学习流水线。
- Feature Engine
 - Feature-engine 是一个 Python 库,包含多个用于为机器学习模型构建特征的转换器。
- Featuretools
 - 一个用于自动化特征工程的开源框架。
- FLAML
 - FLAML 是一个快速的自动机器学习与调优库。
- HEBO
 - 一组开源超参数优化框架,其中包括 NeurIPS 2020 黑盒优化挑战赛的获胜方案,并在超参数调优任务上进行了测试。
- Katib
 - 一个基于 Kubernetes 的超参数调优与神经架构搜索系统。
- keras-tuner
 - Keras Tuner 是一个易于使用、可分布式运行的超参数优化框架,旨在解决超参数搜索中的痛点。它让你能够轻松定义搜索空间,并利用内置算法找到最佳超参数值。
- Optuna
 - Optuna 是一个自动化超参数优化软件框架,尤其适用于机器学习。
- OSS Vizier
 - OSS Vizier 是一个基于 Python 的黑盒优化与研究服务,也是最早设计为可大规模运行的超参数调优服务之一。
- Perpetual
 - 一种无需超参数优化的梯度提升机,可通过简单的预算参数控制模型复杂度。
- TPOT
 - 自动创建 sklearn 流水线(包括特征选择、预处理器等)。
- tsfresh
 - 自动从时间序列中提取相关特征。
计算与通信优化
Section titled “计算与通信优化”- Accelerate
 - Accelerate 仅对多 GPU/TPU 和混合精度相关的样板代码进行抽象,其余代码保持不变。
- Adapters
 - Adapters 是一个统一的库,用于参数高效、模块化的迁移学习。
- Cache-DiT
 - Cache-DiT 构建于 Diffusers 之上,支持几乎所有 DiT,提供混合缓存加速(DBCache、TaylorSeer、SCM 等)及全面的并行优化,包括上下文并行、张量并行和混合 2D/3D 并行,同时兼容编译、CPU 卸载和量化。
- Colossal-AI
 - 面向大模型时代的统一深度学习系统,帮助用户高效、快速地部署大型 AI 模型训练与推理。
- Composer
 - Composer 是一个 PyTorch 库,可帮助你以更快的速度、更低的成本和更高的精度训练神经网络。
- CuDF
 - cuDF 基于 Apache Arrow 列式内存格式构建,是一个 GPU DataFrame 库,可用于加载、连接、聚合、筛选及以其他方式处理数据。
- CuML
 - cuML 是一套实现机器学习算法和数学原语函数的库,其 API 与其他 RAPIDS 项目兼容。
- CuPy
 - 在 CUDA 上实现与 NumPy 兼容的多维数组。CuPy 包含核心多维数组类 cupy.ndarray 及其众多操作函数。
- DEAP
 - 一个新颖的进化计算框架,可用于快速原型设计和测试想法。它致力于使算法清晰明确、数据结构透明,并能与 multiprocessing、SCOOP 等并行化机制完美协作。
- DeepEP
 - DeepEP 是专为混合专家(MoE)和专家并行(EP)设计的通信库,提供高吞吐、低延迟的全对全 GPU 内核,也称为 MoE 分发与合并。该库还支持包括 FP8 在内的低精度运算。
- DGL
 - DGL 是一个易用、高性能且可扩展的 Python 包,用于图上的深度学习。
- DLRover
 - DLRover 让大型 AI 模型的分布式训练变得简单、稳定、快速且节能。
- Dask
 - 用于 Pandas 和 NumPy 计算的分布式并行处理框架。
- DeepSpeed
 - DeepSpeed 是一个深度学习优化库,让分布式训练与推理变得简单、高效且实用。
- FlagGems
 - FlagGems 是使用 OpenAI Triton 实现的高性能通用算子库。它基于一组与后端无关的内核,旨在加速多种硬件平台上的 LLM 训练与推理。
- Flashlight
 - 一个完全使用 C++ 编写的快速、灵活的机器学习库,来自 Facebook AI Research 以及 Torch、TensorFlow、Eigen 和 Deep Speech 的创作者。
- Flax
 - 为 JAX 设计的神经网络库及生态系统,注重灵活性。
- GPUStack
 - GPUStack 是一个用于运行 AI 模型的开源 GPU 集群管理器。
- Hivemind
 - 基于 PyTorch 的去中心化深度学习。
- Jax
 - 对 Python+NumPy 程序进行可组合变换:微分、向量化、JIT 编译至 GPU/TPU 等。
- Kompute
 - 快速、轻量且支持移动设备的 Vulkan 计算框架,针对高级 GPU 数据处理用例进行了优化。
- Liger Kernel
 - Liger Kernel 是一组专为 LLM 训练设计的 Triton 内核。
- LightGBM
 - LightGBM 是一种使用基于树的学习算法的梯度提升框架。
- MLX
 - MLX 是一个面向 Apple 芯片机器学习的数组框架。
- Modin
 - 只需更改一行代码,即可加速 Pandas 工作流。
- NVIDIA TensorRT
 - TensorRT 是一个 C++ 库,用于在 NVIDIA GPU 和深度学习加速器上实现高性能推理。
- Nevergrad
 - Nevergrad 是一个无梯度优化平台。
- Norse
 - Norse 致力于发挥仿生神经组件的优势;这类组件具有稀疏、事件驱动的特点,与人工神经网络有本质区别。
- Numba
 - 用于 Python 数组和数值函数的编译器。
- Optimum
 - Optimum 是 Transformers 和 Diffusers 的扩展,提供一系列优化工具,让模型能够在目标硬件上以最高效率进行训练和运行,同时保持易用性。
- PEFT
 - 参数高效微调(PEFT)方法能够高效地将预训练语言模型(PLM)适配到各种下游应用,而无需微调模型的全部参数。
- PaddlePaddle
 - PaddlePaddle 是一个用于大规模深度网络训练的框架,可使用分布在数百个节点上的数据源。
- PyG
 - PyG(PyTorch Geometric)是一个基于 PyTorch 构建的库,可轻松编写和训练图神经网络(GNN),适用于各种结构化数据相关应用。
- PyTorch Lightning
 - PyTorch Lightning 无需修改代码,即可在多块 GPU 和 TPU 上对 AI 模型进行预训练、微调和部署。
- PyTorch
 - PyTorch 是一个用于开发和训练基于神经网络的深度学习模型的库。
- Ray
 - Ray 是一个灵活、高性能的机器学习分布式执行框架。
- SetFit
 - SetFit 是一个高效、无需提示的 Sentence Transformers 小样本微调框架。
- Sonnet
 - Sonnet 是一个构建于 TensorFlow 2 之上的库,为机器学习研究提供简单、可组合的抽象。
- Streaming
 - 用于高效神经网络训练的数据流库。
- TensorFlow
 - TensorFlow 是一个领先的库,旨在开发和部署先进的机器学习应用。
- ThunderKittens
 ThunderKittens 是一个框架,旨在让开发者能够轻松使用 CUDA 编写快速的深度学习内核。
- TorchOpt
 - TorchOpt 是一个基于 PyTorch 构建的高效可微优化库。
- Triton
 - Triton 是一种语言和编译器,用于编写高效的自定义深度学习原语。它旨在提供一个开源环境,让开发者能够以高于 CUDA 的生产效率编写快速代码,同时比其他现有 DSL 更灵活。
- Vaex
 Vaex 是一个高性能 Python 库,用于惰性处理超出内存容量(Out-of-Core)的 DataFrame(类似 Pandas),以可视化和探索大型表格数据集。Vaex 通过内存映射、零内存复制策略和惰性计算实现最佳性能(不浪费内存)。
- Vowpal Wabbit
 Vowpal Wabbit 是一个机器学习系统,通过在线学习、哈希、allreduce、归约、learning2search、主动学习和交互式学习等技术推动机器学习的前沿。
- XGBoost
 - XGBoost 是一个经过优化的分布式梯度提升库,旨在实现高效率、灵活性和可移植性。
- YDF
 - YDF(Yggdrasil Decision Forests)是一个用于训练、评估、解释和服务随机森林、梯度提升决策树、CART 与 Isolation Forest 模型的库。
- bitsandbytes
 - Bitsandbytes 是一个轻量级 Python 封装库,封装了 CUDA 自定义函数,尤其包括 8 位优化器、矩阵乘法(LLM.int8())以及 8 位和 4 位量化函数。
- einops
 - 灵活而强大的张量操作,让代码更易读、更可靠。
- scikit-learn
 - Scikit-learn 是一个功能强大的机器学习库,提供丰富的模块,可用于数据访问、数据准备和统计模型构建。
- snnTorch
 - snnTorch 是一个使用脉冲神经网络进行深度学习和在线学习的库。
- torchdistill
 - torchdistill 提供多种先进的知识蒸馏方法;你只需编辑声明式 YAML 配置文件(而非 Python 代码),即可设计新实验。
- torchkeras
 torchkeras 是一个简单的工具,让你能够以 Keras 风格使用 PyTorch 训练神经网络。
- veScale
 - veScale 是一个原生基于 PyTorch 的 LLM 训练框架。
- yellowbrick
 - yellowbrick 是一个基于 matplotlib 的模型评估绘图库,适用于 scikit-learn 和其他机器学习库。
数据标注与合成
Section titled “数据标注与合成”- Argilla
 - Argilla 帮助领域专家和数据团队用更少时间构建更优质的 NLP 数据集。
- cleanlab
 - 面向数据中心 AI 的 Python 库。可自动发现错误标注的数据、检测离群值、估算多标注者数据集中的共识度和标注者质量,并建议下一步最适合重新标注的数据。
- COCO Annotator
 - 基于 Web 的图像分割工具,可用于目标检测、定位和关键点标注。
- CVAT
 - CVAT(计算机视觉标注工具)是 OpenCV 的 Web 标注工具,可为计算机视觉算法标注视频和图像。
- Doccano
 - 面向人工标注的开源文本标注工具,支持情感分析、命名实体识别和机器翻译。
- Label Studio
 - 支持多个领域、具有标准化输出格式的数据标注工具。
- LightlyStudio
 - 一个用于整理、标注和管理视觉数据集(图像和视频)的开源工具。支持基于嵌入的自动筛选、标注,以及边界框和分割任务的自动标签。
- NeMo Curator
 - NeMo Curator 是一个 GPU 加速框架,可高效整理大型语言模型数据。
- refinery
 - 数据科学家用于扩展、评估和维护自然语言数据的开源工具。
- SDV
 - Synthetic Data Vault(SDV)是一个合成数据生成库生态系统,用户可轻松学习单表、多表和时间序列数据集,随后生成格式和统计特性与原始数据集相同的新合成数据。
- Semantic Segmentation Editor
 - 日立的开源工具,用于标注相机和激光雷达数据。
- synthcity
 - synthcity 是一个用于生成和评估合成表格数据的库。
- TabGAN
 - 使用 GAN(CTGAN)、扩散模型和 LLM 生成合成表格数据,并支持对抗式筛选、隐私指标和 sklearn 集成。
- ViPE
 - ViPE 是一个空间 AI 工具,可从原始视频中标注相机姿态和稠密深度图。
- YData Synthetic
 - YData Synthetic 是一个利用先进生成模型生成合成表格和时间序列数据的包。
- Apache Airflow
 - 使用 Python 构建的数据流水线框架,包含调度器、DAG 定义和可视化界面。
- Apache Nifi
 - Apache NiFi 专为数据流设计,支持高度可配置的有向图,用于数据路由、转换和系统中介逻辑。
- Argo Workflows
 - Argo Workflows 是一个开源、容器原生的工作流引擎,用于编排 Kubernetes 上的并行作业。Argo Workflows 以 Kubernetes CRD(自定义资源定义)的形式实现。
- Couler
 - 用于在不同工作流引擎(如 Argo Workflows、Tekton Pipelines 和 Apache Airflow)上构建和管理机器学习工作流的统一接口。
- DataTrove
 - DataTrove 是一个用于超大规模文本数据处理、筛选和去重的库。
- Dagster
 - 面向机器学习、分析和 ETL 的数据编排器。
- DBT
 - 用于在数据仓库内运行转换的 ETL 工具。
- Flyte
 - Lyft 的云原生机器学习与数据处理平台 - (演示)。
- Genie
 - 用于对接 Hadoop 系统并触发作业执行的作业编排引擎。
- Hamilton
 - Hamilton 是一个用于定义数据流的微型编排框架。可在任何能运行 Python 的环境中运行(如 Jupyter、FastAPI、Spark、Ray、Dask)。无需额外学习即可遵循软件工程最佳实践。可用于定义特征工程转换、端到端模型流水线和 LLM 工作流。它与宏观编排系统(如 Kedro、Luigi、Airflow、dbt 等)互补,可替代这些系统宏任务内部的代码。它附带可自行托管的 UI,可捕获血缘与来源信息、执行遥测数据和数据摘要,并构建自动填充的目录;开发和生产环境均可使用。
- Instill VDP
 - Instill VDP(多功能数据流水线)旨在简化从启动到完成的数据处理流水线。
- Instructor
 - Instructor 让你能够轻松从 GPT-3.5、GPT-4、GPT-4-Vision 等 LLM 和开源模型获取 JSON 等结构化数据。
- Kedro
 - Kedro 是一个工作流开发工具,可帮助你构建稳健、可扩展、可部署、可复现且有版本管理的数据流水线。
- Luigi
 - Luigi 是一个 Python 模块,可帮助你构建复杂的批处理作业流水线,并处理依赖解析、工作流管理、可视化等。
- Metaflow
 - 一个帮助数据科学家轻松构建和管理真实数据科学项目的框架。
- Pachyderm
 - 一个基于 Kubernetes 构建的开源分布式处理框架,主要专注于动态构建生产级机器学习流水线 - (视频)。
- Pixeltable
 开源 Python 库,提供声明式、增量式数据基础设施,用于构建和管理多模态 AI 工作负载。
- Prefect Core
 - 工作流管理系统,让你能够轻松为数据流水线添加重试、日志记录、动态映射、缓存、故障通知等语义。
- SeqIO
 - SeqIO 是一个用于处理序列数据的库,这些数据将输入下游序列模型。
- Snakemake
 - 用于可复现、可扩展数据分析的工作流管理系统。
- Towhee
 - 通用机器学习流水线,可使用一个或多个机器学习模型生成嵌入向量。
- unstructured
 - unstructured 简化并优化 LLM 的数据处理工作流,可摄取和预处理图像及 PDF、HTML、Word 文档等文本文件。
- ZenML
 - ZenML 是一个可扩展的开源 MLOps 框架,用于创建可复现的 ML 流水线,重点支持自动化元数据跟踪、缓存以及与其他工具的丰富集成。
数据科学笔记本
Section titled “数据科学笔记本”- Apache Zeppelin
 - 基于 Web 的笔记本,提供数据驱动、交互式数据分析环境,以及支持 SQL、Scala 等语言的协作文档。
- Deepnote
 - Deepnote 是 Jupyter 的直接替代品,采用 AI 优先设计,提供简洁 UI、新型区块和原生数据集成。可在喜爱的 IDE 中本地使用 Python、R 和 SQL,然后扩展至 Deepnote 云,使用实时协作、Deepnote 代理和可部署的数据应用。
- Jupyter Notebooks
 - 基于 Web 的 Python 沙盒笔记本环境,适用于可复现开发。
- Marimo
 - 响应式 Python 笔记本——运行可复现实验、作为脚本执行、部署为应用,并通过 git 进行版本管理。
- Papermill
 - Papermill 是一个用于为笔记本添加参数并像 Python 脚本一样执行它们的库。
- Polynote
 - Polynote 是一个实验性的多语言笔记本环境。目前支持 Scala 和 Python(可搭配或不搭配 Spark)、SQL 和 Vega。
- RMarkdown
 - rmarkdown 包是基于 Pandoc 的新一代 R Markdown 实现。
- Stencila
 - Stencila 是一个用于创建、协作编辑和分享数据驱动内容的平台。这些内容透明且可复现。
- Voilà
 - Voilà 可将 Jupyter 笔记本转换为独立 Web 应用,例如可用作仪表板。
数据存储优化
Section titled “数据存储优化”- AIStore
 - AIStore 是一个轻量级对象存储系统,可随着每个新增存储节点线性扩展,并特别专注于拍字节级深度学习场景。
- Alluxio
 - 一种虚拟分布式存储系统,用于弥合计算框架与存储系统之间的鸿沟。
- Apache Arrow
 - 与 Pandas、基于 Hadoop 的系统等兼容的内存列式数据表示格式。
- Apache Druid
 - 一个高性能实时分析数据库。可阅读这篇文章了解入门信息。
- Apache Hudi
 - Hudi 是一个事务型数据湖平台,可将数据仓库和数据库的核心功能直接引入数据湖。Hudi 非常适合流式工作负载,也支持创建高效的增量批处理流水线。它支持 Spark、Flink、Presto、Trino、Hive 等主流查询引擎。更多信息见此处。
- Apache Iceberg
 - Iceberg 是一种符合 ACID、高性能的格式,专为超大型分析表(包含数十 PB 数据)设计。它将 SQL 表的可靠性和简洁性带入大数据领域,同时支持 Spark、Trino、Flink、Presto、Hive 和 Impala 等引擎安全地同时操作同一张表。更多信息见此处。
- Apache Ignite
 - 以内存为中心的分布式数据库、缓存和处理平台,可为事务型、分析型和流式工作负载提供 PB 级内存速度 - 演示。
- Apache Parquet
 - 与 Pandas、基于 Hadoop 的系统等兼容的磁盘列式数据表示格式。
- Apache Pinot
 - 一个实时分布式 OLAP 数据存储。关于 ClickHouse、Druid 和 Pinot 等开源大数据 OLAP 系统的比较见此处。
- Casibase
 - Casibase 是一个类似 LangChain 的 RAG(检索增强生成)知识库,提供 Web UI 和企业单点登录。
- Chroma
 - Chroma 是一个开源嵌入数据库。
- ClickHouse
 - ClickHouse 是一个开源列式数据库管理系统。
- Delta Lake
 - Delta Lake 是一个存储层,为 Apache Spark 和其他大数据引擎带来可扩展的 ACID 事务。
- EdgeDB
 - Gel 通过现代数据模型、图查询、身份验证与 AI 解决方案等功能增强 Postgres。
- GPTCache
 - GPTCache 是一个用于为大型语言模型查询创建语义缓存的库。
- InfluxDB
 可扩展的数据存储,用于存储指标、事件并进行实时分析。
- Milvus
 Milvus 是一个云原生开源向量数据库,用于管理机器学习模型和神经网络生成的嵌入向量。
- Marqo
 Marqo 是一个端到端向量搜索引擎。
- pgvector
 pgvector 为 Postgres 提供向量相似性搜索功能。
- PostgresML
 PostgresML 是 PostgreSQL 的机器学习扩展,可通过 SQL 查询对文本和表格数据进行训练和推理。
- Redis
 Redis 是一个开源内存数据存储,支持向量相似性搜索,适用于语义搜索和推荐系统等 AI/ML 应用。
- Safetensors
 一种简单、安全的张量存储与分发方式。
- TimescaleDB
 An open-source time-series SQL database optimized for fast ingest and complex queries packaged as a PostgreSQL extension - 开源时序 SQL 数据库,作为 PostgreSQL 扩展打包,针对快速写入和复杂查询进行了优化 - (视频)。
- Weaviate
 - 一个低延迟向量搜索引擎(GraphQL、RESTful),开箱即支持多种媒体类型。其模块包括语义搜索、问答、分类、可定制模型(PyTorch/TensorFlow/Keras)等。
- Zarr
 - 用于并行计算的分块压缩 N 维数组 Python 实现。
- Apache Beam
 Apache Beam 是一个统一的批处理和流处理编程模型。
- Apache Flink
 - 开源流处理框架,具备强大的流式和批处理能力。
- Apache Kafka
 - Kafka 客户端库,用于构建输入和输出存储在 Kafka 集群中的应用与微服务。
- Apache Samza
 - 分布式流处理框架。它使用 Apache Kafka 进行消息传递,并使用 Apache Hadoop YARN 提供容错、处理器隔离、安全和资源管理。
- Apache Spark
 - 使用 Apache Spark 框架作为后端的流微批处理,支持有状态的精确一次语义。
- Bytewax
 - 基于 Rust 引擎构建的灵活、以 Python 为中心的有状态流处理框架。
- FastStream
 - 一种现代化、与消息代理无关的流式 Python 框架,支持 Apache Kafka、RabbitMQ 和 NATS 协议,受 FastAPI 启发,且易于与其他 Web 框架集成。
- MOA
 - MOA(大规模在线分析)是一个用于大数据流挖掘的开源框架。
- MosaicML Streaming - 从云存储快速、确定性地流式读取大型数据集,以支持分布式模型训练。
- RisingWave
 - 一个分布式 SQL 流数据库,将流处理与低延迟服务相结合,非常适合构建和服务在线机器学习特征。
- TensorStore
 - 用于读写大型多维数组的库。
- Agenta
 - Agenta 为整个 LLMOps 工作流提供端到端工具:构建(LLM playground、评估)、部署(提示词和配置管理),以及观测与追踪。
- AirLLM
 - AirLLM 优化推理内存用量,使 700 亿参数大型语言模型无需量化、蒸馏和剪枝,即可在单张 4GB GPU 上运行推理。
- AITemplate
 - AITemplate(AIT)是一个 Python 框架,可将深度神经网络转换为 CUDA(NVIDIA GPU)/HIP(AMD GPU)C++ 代码,实现极速推理服务。
- BentoML
 - BentoML 是一个用于高性能 ML 模型服务的开源框架。
- Bifrost
 - AI 网关通过单一兼容 OpenAI 的 API 接入 23 多家 LLM 提供商,并提供自动故障切换、负载均衡、语义缓存、预算治理和 Prometheus 指标。
- BISHENG
 - BISHENG 是一个开放的 LLM 应用开发运维平台,专注于企业场景。
- CosmoEdge
 - 面向生产部署的 C++ 边缘视频 AI 引擎,结合 RTSP 接入、CV/VLM 推理、可视化编排、告警以及 Sophon 和 Rockchip NPU 上的事件分发。
- DeepDetect
 - 使用 C++ 编写并由 Jolibrain 维护的机器学习生产服务器,支持 TensorFlow、XGBoost 和 Caffe 模型。
- Dynamo
 - NVIDIA Dynamo 是一个高吞吐、低延迟的推理框架,专为多节点分布式环境中的生成式 AI 和推理模型服务而设计。
- exo
 - exo 可帮助你在家中利用日常设备组建并运行 AI 集群。
- Genkit
 - Genkit 是一个开源框架,使用熟悉的、以代码为中心的模式构建 AI 应用。它让 AI 功能的开发、集成和测试更加便捷,并支持可观测性和评估。
- GoModel
 - GoModel 是一个使用 Go 编写、可自行托管的 AI 网关,通过统一的兼容 OpenAI API 接入 OpenAI、Anthropic、Gemini、Groq、xAI、Ollama 等提供商,并支持路由、用量跟踪、速率限制和防护机制。
- Inference
 - 一个快速、可用于生产环境的计算机视觉推理服务器,支持部署多种热门模型架构和微调模型。借助 Inference,你可以通过 Docker 在自有硬件上部署 YOLOv5、YOLOv8、CLIP、SAM 和 CogVLM 等模型。
- Infinity
 - Infinity 是一个高吞吐、低延迟 REST API,用于提供文本嵌入、重排序模型和 CLIP 服务。
- LiteLLM
 - LiteLLM 是一个 Python SDK 和代理服务器(LLM 网关),可使用 OpenAI 格式调用 100 多种 LLM API,包括 Bedrock、Azure、OpenAI、VertexAI、Cohere、Anthropic、Sagemaker、HuggingFace、Replicate 和 Groq。
- LiteRT
 - LiteRT(原 TensorFlow Lite)是 Google 的高性能设备端 AI 推理运行时,可将机器学习模型部署到移动、嵌入式和边缘设备。
- LiteRT-LM
 - LiteRT-LM 是 Google 面向生产环境的高性能推理框架,可在边缘设备上部署大型语言模型,并支持 Android、iOS、Web、桌面和 IoT 等平台。
- LitServe
 - LitServe 是一个基于 FastAPI 构建的灵活 AI 模型服务引擎。它支持模型、代理、多模态系统、RAG 和复杂 ML 流水线的自定义推理引擎。
- jevos
 - jevOS 是 TypeSafe Jev 的开源替代方案,用于是/否决策:它是一个 10 亿参数二元分类器(GGUF、llama.cpp),通过兼容 Jev 的 FastAPI HTTP API 提供服务,可仅用 CPU 在笔记本电脑上运行。
- Jina-serve
 - Jina-serve 是一个用于构建和部署 AI 服务的框架,服务之间可通过 gRPC、HTTP 和 WebSocket 通信。
- Kiln
 - Kiln 是一个开源工具,用于微调 LLM 模型、生成合成数据并协作处理数据集。
- KServe
 - KServe 提供一个 Kubernetes 自定义资源定义,用于机器学习预测和生成式模型服务。
- KTransformers
 - KTransformers 是一个灵活的框架,可体验前沿 LLM 推理优化。
- Langtrace
 - Langtrace 是一个基于 OpenTelemetry 的开源端到端 LLM 应用可观测性工具,为主流 LLM、LLM 框架、向量数据库等提供实时追踪、评估和指标。
- Lepton AI
 - LeptonAI Python 库让你能够轻松使用 Python 代码构建 AI 服务。
- LightLLM
 - LightLLM 是一个基于 Python 的大型语言模型(LLM)推理和服务框架,以轻量设计、易于扩展和高速性能见长。
- llama.cpp
 - llama.cpp 是一个开源软件库,可对 Llama 等多种大型语言模型执行推理。
- llmfit
 - 一个终端工具,可根据系统的 RAM、CPU 和 GPU 为 LLM 模型选择合适配置。它能检测硬件,并从质量、速度、适配度和上下文等维度为各模型评分,告诉你哪些模型能在你的机器上流畅运行。
- LMCache
 - LMCache 是一个高性能 KV 缓存层,可加速 LLM 推理。
- LMDeploy
 - LMDeploy 是一个用于压缩、部署和提供 LLM 服务的工具包。
- LM Studio
 - LM Studio 是一个工具,可在本地计算机上部署 LLM 模型;只要满足最低要求,即使配置相对普通的设备也可以运行。
- LocalAI
 - LocalAI 是一个可直接替换的 REST API,兼容 OpenAI API 规范,可在本地执行推理。
- MindsDB
 - MindsDB 是一个平台,可直接基于数据库、向量存储和应用数据实时创建、提供和微调模型。
- mini-sglang
 - mini-sglang 是一个轻量、高效的大型语言模型服务框架。
- MLRun
 - MLRun 是一个开放的 MLOps 框架,可快速构建和管理贯穿整个生命周期的持续机器学习与生成式 AI 应用。
- MLServer
 - 一个机器学习模型推理服务器,支持多个框架、多模型服务等功能。
- Model Runner
 - Docker Model Runner 可轻松使用 Docker 管理、运行和提供 AI 模型服务,支持从 Docker Hub 或任何符合 OCI 标准的注册表拉取 LLM 和其他 AI 模型。
- Mosec
 - 一个由 Rust 驱动、支持多阶段流水线的模型服务器,提供动态批处理等功能。可轻松实现并部署为微服务。
- nano-vllm
 - nano-vllm 是一个从头构建的轻量级 vLLM 实现,提供快速离线推理,并采用前缀缓存、张量并行和 CUDA graph 等优化技术。
- nndeploy
 - 一个易用且高性能的 AI 部署框架。
- Nuclio
 - 一个专注于数据、I/O 和计算密集型工作负载的高性能“无服务器”框架。它与 Jupyter 和 Kubeflow 等主流数据科学工具紧密集成,支持多种数据和流式数据源,并支持在 CPU 和 GPU 上执行。
- OpenLLM
 - OpenLLM 让开发者只需一条命令,即可将任意开源 LLM(Llama 3.1、Qwen2、Phi3 等)或自定义模型作为兼容 OpenAI 的 API 运行。
- OpenVINO
 - OpenVINO 是一个用于优化和部署 AI 推理的开源工具包。
- Open WebUI
 - Open WebUI 是一个可扩展、功能丰富且易用的自托管 AI 平台,专为完全离线运行而设计。它支持 Ollama 等各种 LLM 运行器和兼容 OpenAI 的 API,并内置用于 RAG 的推理引擎,是强大的 AI 部署解决方案。
- OptiLLM
 - OptiLLM 是一个兼容 OpenAI API 的推理优化代理,实现了 20 多种先进技术,可显著提升 LLM 在推理任务上的准确性和性能,无需训练或微调任何模型。
- PowerInfer
 - PowerInfer 是一个利用激活局部性的 CPU/GPU LLM 推理引擎,面向你的设备进行优化。
- Prompt2Model
 - Prompt2Model 是一个系统,可根据自然语言任务描述(例如 ChatGPT 等 LLM 使用的提示词)训练适合部署的小型专用模型。
- RamaLama
 - RamaLama 是一个开源工具,通过 OCI 容器简化 AI 模型的本地推理与服务,无需配置主机系统。
- RunAnywhere
 - RunAnywhere 是一个面向生产环境的 SDK,可在 iOS、Android、React Native 和 Flutter 设备端运行 AI 模型(LLM、语音转文本、文本转语音),从而打造私密、离线且快速的移动 AI 应用。
- Seldon Core
 - 在 Kubernetes 上部署和运行机器学习模型的开源平台 - (视频)。
- SGLang
 - SGLang 是一个面向大型语言模型和视觉语言模型的快速服务框架。
- SIE
 - 开源推理服务器与生产集群,适用于嵌入、重排序和信息抽取。预配置 85 多个模型,涵盖稠密、稀疏、多向量、视觉、重排序和抽取模型。附带 Helm、KEDA 自动扩缩、Grafana 仪表板和 Terraform。
- SkyPilot
 - SkyPilot 是一个可在任意云上运行 LLM、AI 和批处理作业的框架,提供最大限度的成本节省、充足的 GPU 可用性和托管执行。
- Tensorflow Serving
 - 高性能框架,通过 gRPC 协议提供 TensorFlow 模型服务,每个核心每秒可处理 10 万个请求。
- torchtune
 - torchtune 是一个 PyTorch 库,可轻松编写、后训练和试验 LLM。
- Transformer Lab
 - Transformer Lab 是一个开源 LLM 工作空间,可在本地跨推理引擎和平台微调、评估、导出及测试模型。
- Triton Inference Server
 - Triton 是一个高性能开源服务软件,可部署来自任意框架的 AI 模型并运行于 GPU 和 CPU,同时最大限度地提高利用率。
- Vercel AI
 - Vercel AI 是一个 TypeScript 工具包,旨在帮助你使用 Next.js、React、Svelte、Vue 等主流框架以及 Node.js 等运行时构建 AI 应用。
- Vespa
 - 在服务期间以任意规模搜索、推理并组织向量、张量、文本和结构化数据。
- vLLM
 - vLLM 是一个高吞吐、内存高效的 LLM 推理与服务引擎。
- AlpacaEval
 - AlpacaEval 是一个用于评估遵循指令语言模型的自动评估器。
- ANN-Benchmarks
 - ANN-Benchmarks 是一个近似最近邻搜索算法的基准测试环境。
- ARES
 - ARES 是一个自动评估检索增强生成(RAG)模型的框架。
- BEIR
 - BEIR 是一个包含多种信息检索任务的异构基准。它还提供统一、易用的框架,可在该基准内评估基于 NLP 的检索模型。
- Code Generation LM Evaluation Harness
 - Code Generation LM Evaluation Harness 是一个用于评估代码生成模型的框架。
- COMET
 - COMET 是一个开源机器学习评估框架。
- C-Eval
 - C-Eval 是一个面向基础模型的综合中文评测套件。
- Deepchecks
 - Deepchecks 是一个满足各种 AI 与 ML 验证需求的全面开源解决方案,可全面测试从研究到生产阶段的数据和模型。
- DeepEval
 - DeepEval 是一个简单易用的 LLM 应用开源评估框架。
- EvalAI
 - EvalAI 是一个开源平台,可大规模评估和比较 AI 算法。
- Evalchemy
 - Evalchemy 是一个统一、易用的后训练语言模型评估工具包。
- EvalPlus
 - EvalPlus 是一个稳健的 LLM4Code 评估框架,包含扩展版 HumanEval+ 和 MBPP+ 基准、效率评估(EvalPerf)以及安全且可扩展的评估工具包。
- Evals
 - Evals 是一个用于评估 OpenAI 模型的框架,也是一个开源基准注册库。
- EvalScope
 - EvalScope 是一个精简且可定制的框架,用于高效的大模型评估和性能基准测试。
- Evaluate
 - Evaluate 是一个库,可让模型评估、比较和性能报告更加轻松、规范。
- Evidently
 - Evidently 是一个开源框架,用于评估、测试和监控 ML 与 LLM 驱动的系统。
- Future AGI
 - 开源、可自行托管的端到端智能体工程与优化平台,整合了追踪、评估、模拟、数据集、网关和防护机制,适用于 LLM 和 AI 智能体应用。
- GAOKAO-Bench
 - GAOKAO-Bench 是一个评估框架,使用中国普通高等学校招生全国统一考试(高考)题目作为数据集,评估大模型的语言理解与逻辑推理能力。
- Giskard
 - Giskard 是一个开源 Python 库,可自动检测 AI 应用中的性能、偏见和安全问题。
- guidellm
 - guidellm 是一个面向大型语言模型推理系统的基准测试与性能评估工具。
- Harbor
 - Harbor 是一个用于评估和优化智能体与语言模型的框架,支持在容器环境中并行开展实验,并内置基准与环境管理功能。
- HumanEval
 - HumanEval 是一个基准测试,使用带有单元测试的 Python 编程题评估代码生成模型的功能正确性。
- Helicone
 - Helicone 是一个一体化开源 LLM 开发者平台。
- HELM
 - HELM(语言模型整体评估)提供全面评估语言模型的工具,包括标准化数据集、面向多种模型的统一 API、多样化指标、r、公平性扰动、提示词构建框架,以及统一模型访问的代理服务器。
- Inspect
 - Inspect 是一个用于大型语言模型评估的框架。
- IsaacLab-Arena
 - IsaacLab-Arena 是 NVIDIA Isaac Lab 的开源扩展,用于可组合环境构建和大规模机器人策略评估。
- JiWER
 - JiWER 是一个简单快速的 Python 包,用于评估自动语音识别系统。
- Laminar
 - Laminar 是一个开源平台,用于追踪、评估、标注和分析 AI 产品的 LLM 数据。
- Langfuse
 - Langfuse 是一个面向基于 LLM 应用的可观测性与分析解决方案。
- LangTest
 - LangTest 是一个全面的 NLP 模型评估工具包。
- Language Model Evaluation Harness
 - Language Model Evaluation Harness 是一个框架,可在大量不同评估任务上测试生成式语言模型。
- LangWatch
 - LangWatch 是一个面向 DSPy 的可视化界面,也是一个完整的 LLM Ops 平台,用于监控、试验、衡量和改进 LLM 流水线,并采用公平代码分发模式。
- Latitude
 - Latitude 是一个开源 AI 智能体可观测性平台,提供语义追踪搜索和问题跟踪。
- LightEval
 - LightEval 是一个轻量级 LLM 评估套件。
- lmms-eval
 - lmms-eval 是一个精心打造的评估框架,用于一致、高效地评估大型多模态模型(LMM)。
- Melting Pot
 - Melting Pot 是一套用于多智能体强化学习的测试场景。
- Meta-World
 - Meta-World 是一个开源模拟基准,用于元强化学习和多任务学习,包含 50 种不同的机器人操作任务。
- mir_eval
 - mir_eval 是一个 Python 库,为评估音乐信息检索系统提供透明、标准化且简单直接的方法。
- MLPerf Inference
 - MLPerf Inference 是一个基准测试套件,用于衡量系统在多种部署场景下运行模型的速度。
- Massive Text Embedding Benchmark - Massive Text Embedding Benchmark(MTEB)是一个综合评估框架,可评估文本嵌入模型在多种任务和语言上的表现,涵盖 8 类嵌入任务、58 个数据集和 112 种语言。
- NannyML
 - NannyML 是一个库,可在无法访问目标值的情况下估算部署后模型性能、检测数据漂移,并将数据漂移告警与模型性能变化智能关联。
- OGB
 - Open Graph Benchmark(OGB)是一组图机器学习基准数据集、数据加载器和评估器。
- Ollama Grid Search
 - Ollama Grid Search 可自动为特定用例选择最佳模型、提示词或推理参数,让你能够遍历各种组合并直观检查结果。
- onWatch
 - onWatch 是一个轻量级 Go 命令行工具,可实时追踪多个提供商(Anthropic Pro/Max Plans、Codex、Gemini CLI、Synthetic、Z.ai、GitHub Copilot、MiniMax Coding/Token Plan、Antigravity、OpenRouter)的 AI API 配额用量,并提供消耗速率预测、历史用量图表和按周期跟踪。
- OpenCompass
 - OpenCompass 是一个 LLM 评估平台,支持在 50 多个数据集上评测广泛的模型(LLaMA、LLaMa2、ChatGLM2、ChatGPT、Claude 等)。
- OpenLIT
 - OpenLIT 是一个开源 AI 工程平台,通过可观测性、监控、防护机制、评估和无缝集成简化 LLM 工作流。
- OpenLLMetry
 - OpenLLMetry 通过性能监控、执行追踪和调试功能,为开发者深入洞察大型语言模型应用。
- Opik
 - Opik 是一个开源平台,用于评估、测试和监控 LLM 应用。
- Overcooked-AI
 - Overcooked-AI 是一个完全合作式人类与 AI 任务表现的基准环境,基于广受欢迎的电子游戏 Overcooked。
- Phoenix
 - Phoenix 是一个开源 AI 可观测性平台,专为实验、评估和故障排查而设计。
- Promptfoo
 - LLM 红队测试和评估框架,用于测试越狱、提示词注入及其他漏洞,并集成 CI/CD。
- Prometheus-Eval
 - RagaAI Catalyst 是一个综合平台,旨在增强 LLM 项目的管理与优化。
- RagaAI Catalyst
 - Prometheus-Eval 是一组工具,用于训练、评估和使用专门用于评估其他语言模型的语言模型。
- Ragas
 - Ragas 是一个用于评估 RAG 流水线的框架。
- RewardBench
 - RewardBench 是一个基准测试,旨在评估奖励模型的能力与安全性。
- RLBench
 - RLBench 是一个雄心勃勃的大规模基准和学习环境,旨在推动多个视觉引导操作研究领域的发展,包括强化学习、模仿学习、多任务学习、几何计算机视觉,尤其是小样本学习。
- SimplerEnv
 - SimplerEnv 是一个模拟操作策略评估环境,用于真实机器人设置。
- SwanLab
 - SwanLab 是一个 AI 训练跟踪与可视化工具。
- Speech-to-Text Benchmark
 - Speech-to-Text Benchmark 是一个简约且可扩展的框架,用于对不同语音转文本引擎进行基准测试。
- TensorFlow Model Analysis
 - TensorFlow Model Analysis(TFMA)是一个库,可使用训练器中定义的相同指标,以分布式方式在大量数据上评估 TensorFlow 模型。
- TorchBench
 - TorchBench 是一组用于评估 PyTorch 性能的开源基准测试。
- TruLens
 - TruLens 提供一组工具,用于评估和跟踪 LLM 实验。
- TrustLLM
 - TrustLLM 是一个全面的框架,用于评估大型语言模型的可信度,包含原则、调查和基准测试。
- VBench
 - VBench 是一套用于视频生成模型的综合基准测试。
- VLMEvalKit
 - VLMEvalKit 是一个开源工具包,用于评估大型视觉语言模型(LVLM)。
可解释性与公平性
Section titled “可解释性与公平性”- Aequitas
 - 一个开源偏见审计工具包,供数据科学家、机器学习研究人员和政策制定者审计机器学习模型中的歧视与偏见,并据此对预测风险评估工具的开发和部署做出知情且公平的决策。
- AI Explainability 360
 - 用于解释数据和机器学习模型的可解释性工具,包括一套全面的算法,覆盖多种解释维度及代理可解释性指标。
- AI Fairness 360
 - 为数据集和机器学习模型提供全面的公平性指标及指标说明,并提供减轻数据集和模型偏见的算法。
- Alibi
 - Alibi 是一个开源 Python 库,旨在检查和解释机器学习模型。该库最初专注于黑盒、基于实例的模型解释。
- captum
 - 由 Facebook 开发的 PyTorch 模型可解释性与理解库。它为 PyTorch 模型提供积分梯度、显著性图、SmoothGrad、VarGrad 等通用实现。
- Fairlearn
 - Fairlearn 是一个 Python 工具包,用于评估并缓解机器学习模型中的不公平现象。
- InterpretML
 - InterpretML 是一个开源包,用于训练可解释模型并解释黑盒系统。
- Lightly
 - 一个用于图像自监督学习的 Python 框架。学习到的表示可用于分析无标签数据的分布并重新平衡数据集。
- LOFO Importance
 - LOFO(逐个特征剔除)重要性根据选定指标,计算所选模型的一组特征的重要性:它会逐一移除特征,并根据所选指标和验证方案评估模型性能。
- mljar-supervised
 - 一个用于表格数据 AutoML 的 Python 包,支持特征工程、超参数调优、解释和自动文档生成。
- Quantus
 - Quantus 是一个用于负责任地评估神经网络解释的可解释 AI 工具包。
- SHAP
 - SHapley Additive exPlanations 是一种统一方法,用于解释任意机器学习模型的输出。
- SHAPash
 - Shapash 是一个 Python 库,提供多种可视化形式,并使用人人都能理解的明确标签。
- WhatIf
 - 一个易用界面,帮助用户加深对黑盒分类或回归机器学习模型的理解。
- FEAST
 - Feast(特征存储)是一个面向机器学习的开源特征存储。它能以最快捷的方式利用现有基础设施,将分析数据投入生产,用于模型训练和在线推理。
- Featureform
 - 一个虚拟特征存储,可即插即用地接入现有基础设施,深受数据科学家认可。只需 pip install,即可使用发现、治理、血缘跟踪和协作功能。支持 pandas、Python、Spark、SQL,并集成主流云服务商。
- Hopsworks Feature Store
 - 面向 ML 的离线/在线特征存储 (视频)。
工业级异常检测
Section titled “工业级异常检测”- Alibi Detect
 - alibi-detect 是一个 Python 包,专注于离群点、对抗样本和概念漂移检测。
- Darts
 - Darts 是一个易用的时间序列预测与异常检测库。
- Deequ
 - 一个构建于 Apache Spark 之上的库,用于定义“数据单元测试”,以衡量大型数据集的数据质量。
- PyOD
 - 一个用于可扩展离群点检测(异常检测)的 Python 工具箱。
- TFDV
 - TFDV(TensorFlow Data Validation)是一个用于探索和验证机器学习数据的库。
工业级计算机视觉
Section titled “工业级计算机视觉”- CameraTraps
 - CameraTraps(PyTorch Wildlife)是一个协作式深度学习框架,用于野生动物图像分析,提供基于大规模相机陷阱数据集训练的检测和分类模型。
- Deep Lake
 - Deep Lake 是一种针对计算机视觉优化的数据基础设施。
- DeepForest
 - DeepForest 是一个 Python 包,使用深度学习从航拍 RGB 图像中训练和预测单棵树的树冠及树种。
- Detectron2
 - Detectron2 是 Facebook AI Research 的新一代库,提供先进的检测和分割算法。
- Kornia
 - Kornia 是一个构建于 PyTorch 之上的可微计算机视觉库,提供丰富的可微图像处理和几何视觉算法。
- libcom
 - libcom 是一个图像合成工具箱。
- LightlyTrain
 - 使用无标签数据为工业应用预训练计算机视觉模型。
- MMCV
 - MMCV 是 OpenMMLab 的基础计算机视觉库,提供图像和视频处理、数据转换与增强、CNN 架构以及优化 CUDA 操作等核心功能。
- SuperGradients
 - SuperGradients 是一个开源库,用于训练基于 PyTorch 的计算机视觉模型。
- supervision
 - Supervision 是一个 Python 库,旨在高效管理计算机视觉流水线,提供模型标注、可视化和监控工具。
- VideoSys
 - VideoSys 通过多种加速技术支持许多扩散模型,使其运行更快且内存占用更低。
工业级信息检索
Section titled “工业级信息检索”- AutoRAG
 - AutoRAG 是一个 RAG AutoML 工具,可自动为你的数据寻找最优 RAG 流水线。
- BGE
 - BGE 构建了一个用于搜索和 RAG 的一站式检索工具包。
- EmbedAnything
 - EmbedAnything 是一个使用 Rust 构建的极简、轻量、高性能嵌入流水线,可为文本、图像、音频、PDF 和其他媒体生成嵌入,并支持稠密、稀疏、ONNX 和后期交互嵌入。
- Faiss
 - Faiss 是一个用于稠密向量高效相似性搜索和聚类的库。
- GraphRAG
 - GraphRAG 是一套数据流水线与转换工具,旨在借助 LLM 从非结构化文本中提取有意义的结构化数据。
- HippoRAG
 - HippoRAG 是一个新颖的检索增强生成(RAG)框架,灵感来自人类长期记忆的神经生物学原理,可让 LLM 持续整合外部文档中的知识。
- JamAI Base
 - JamAI Base 是一个开源 RAG(检索增强生成)后端平台,集成嵌入式数据库(SQLite)和嵌入式向量数据库(LanceDB),并提供托管记忆与 RAG 能力。它内置 LLM、向量嵌入和重排序编排与管理功能,均可通过便捷直观的类电子表格 UI 和简单 REST API 使用。
- LangExtract
 - LangExtract 是一个 Python 库,根据用户定义的指令使用 LLM 从非结构化文本文件中提取结构化信息。它可处理临床记录或报告等材料,识别并整理关键细节,同时确保提取数据与源文本相对应。
- LightRAG
 - 一个简单快速的检索增强生成框架。
- llmware
 - llmware 提供统一框架,用于构建基于 LLM 的应用(如 RAG、智能体),采用小型专用模型,可安全、私密地部署并集成企业知识源,还能以经济高效的方式针对任意业务流程进行调优和适配。
- Mem0
 - Mem0 通过智能记忆层增强 AI 助手和智能体,实现个性化 AI 交互。
- NGT
 - NGT 提供命令和库,可在高维向量数据空间的大量数据中执行高速近似最近邻搜索。
- NMSLIB
 - 非度量空间库(NMSLIB):一个高效的相似性搜索库,也是用于评估通用非度量空间中 k-NN 方法的工具包。
- Qdrant
 - 一个开源向量相似性搜索引擎,支持扩展过滤功能。
- R2R
 - R2R(RAG to Riches)是一个综合平台,用于构建、部署和扩展 RAG 应用,支持混合搜索、多模态和高级可观测性。
- RAGFlow
 - RAGFlow 是一个基于深度文档理解的 RAG 引擎。
- RAGxplorer
 - RAGxplorer 是一个用于构建 RAG 可视化的工具。
- RAG-FiT
 - RAG-FiT 是一个库,旨在通过使用专门创建的 RAG 增强数据集微调模型,提升 LLM 使用外部信息的能力。
- TextWorld
 - TextWorld 是一个基于文本的游戏生成器,也是一个可扩展的沙盒学习环境,用于训练和测试强化学习(RL)智能体。
- Zvec
 - Zvec 是一个开源进程内向量数据库,用于低延迟相似性搜索。
工业级自然语言处理
Section titled “工业级自然语言处理”- aisuite
 - aisuite 是一个简单、统一的接口,可对接多个生成式 AI 提供商。
- Align-Anything
 - Align-Anything 致力于使任意模态的大模型(任意到任意模型),包括 LLM、VLM 等,与人类意图和价值观保持一致。
- BERTopic
 - BERTopic 是一种主题建模技术,利用 Transformer 和 c-TF-IDF 创建稠密簇,从而生成易于解释的主题,同时保留主题描述中的重要词语。
- Burr
 - Burr 帮助你开发能够做出决策的应用(聊天机器人、智能体、模拟)。它具备生产就绪功能(遥测、持久化、部署等),还提供开源、免费且本地优先的 Burr UI。
- Context7
 - Context7 为提示词和 AI 编程智能体提供最新代码文档。
- Dify
 - Dify 是一个开源 LLM 应用开发平台,其直观界面整合了智能体 AI 工作流、RAG 流水线、智能体能力、模型管理、可观测性等功能,让你能够快速从原型迈向生产。
- dspy
 - 一个使用基础模型进行编程的框架。
- Dust
 - Dust 协助设计和部署大型语言模型应用。
- ESPnet
 - ESPnet 是一个端到端语音处理工具包。
- FastChat
 - FastChat 是一个开放平台,用于训练、服务和评估基于大型语言模型的聊天机器人。
- Flair
 - 由 Zalando 开发的简洁先进 NLP 框架,直接构建于 PyTorch 之上。
- FunASR
 - FunASR 是一个生产级 ASR 工具包,支持 50 多种语言,内置 VAD、标点恢复、说话人分离和情感识别,并支持通过 Docker/WebSocket/REST 部署及 ONNX 运行时。
- Fun-ASR
 - 基于 LLM 的 ASR,支持包括中文方言在内的 31 种语言,并原生支持标点、时间戳和说话人分离。
- Gensim
 - Gensim 是一个 Python 库,用于大型语料的主题建模、文档索引和相似性检索。
- gpt-fast
 - 简单高效、原生基于 PyTorch 的 Transformer 文本生成。
- Haystack
 - Haystack 是一个开源 NLP 框架,可使用 Transformer 模型和 LLM(GPT-3 等)与你的数据交互。Haystack 提供生产就绪工具,可快速构建类似 ChatGPT 的问答、语义搜索、文本生成等应用。
- Interactive Composition Explorer
 - ICE 是一个 Python 库和追踪可视化工具,面向语言模型程序。
- Jan
 - Jan 是一个开源 ChatGPT 替代品,可在计算机上 100% 离线运行,让你能够在本地下载和运行 LLM,并完全掌控数据与隐私。
- Lamini
 - Lamini 是一个可快速定制模型的 LLM 引擎。
- LangChain
 - LangChain 通过可组合性帮助你构建 LLM 应用。
- LlamaIndex
 - LlamaIndex(GPT Index)是一个面向 LLM 应用的数据框架。
- LLaMA
 - LLaMA 旨在提供一个精简、易于修改和阅读的示例,用于加载 LLaMA(arXiv)模型并执行推理。
- LLaMA-Factory
 - LLaMA-Factory 让你能够通过零代码 CLI 和 Web UI 轻松微调 100 多种大型语言模型。
- LLMBox
 - LLMBox 是一个全面的 LLM 实现库,包含统一的训练流水线和完善的模型评估功能。
- LLaMA2-Accessory
 - LLaMA2-Accessory 是一个开源工具包,用于预训练、微调和部署大型语言模型(LLM)及多模态 LLM。
- LMFlow
 - LMFlow 是一个可扩展、便捷且高效的工具箱,用于微调大型机器学习模型。
- Megatron-LM
 - Megatron-LM 是一个高度优化、高效的大型语言模型训练库。
- MindNLP
 - MindNLP 是一个易用、高性能的 NLP 和 LLM 框架,基于 MindSpore 构建,并兼容 Hugging Face 模型与数据集。
- MLC LLM
 - MLC LLM 是一个通用解决方案,可将任意语言模型原生部署到多种硬件后端和原生应用中,同时也为所有人提供高效框架,进一步针对自身用例优化模型性能。
- mlx-lm
 - MLX LM 是一个 Python 包,可在 Apple 芯片上使用 MLX 生成文本并微调大型语言模型,支持与 Hugging Face Hub 集成、量化和分布式推理。
- Ollama
 - 轻松开始在本地运行大型语言模型。
- olmOCR
 - olmOCR 是一个工具包,用于训练语言模型处理现实世界中的 PDF 文档。
- PaddleNLP
 - PaddleNLP 是一个基于 PaddlePaddle 深度学习框架的大型语言模型(LLM)开发套件,支持在各种硬件设备上进行高效大模型训练、无损压缩和高性能推理。
- Promptise Foundry
 - Promptise Foundry 是一个面向智能体 AI 和 MCP 服务器的生产级 Python 框架,涵盖自主运行时、记忆、工具集成、治理(预算、健康状态、任务、密钥)、防护机制、语义缓存和可观测性。
- Semantic Kernel
 - Semantic Kernel 是一个 SDK,可将 OpenAI、Azure OpenAI 和 Hugging Face 等大型语言模型(LLM)与 C#、Python 和 Java 等传统编程语言集成。借助插件定义,只需几行代码即可串联这些能力。
- Sentence Transformers
 - Sentence Transformers 提供了一种简单的方法,可计算句子、段落和图像的稠密向量表示。
- SpaCy
 - spaCy 是一个使用 Python 和 Cython 实现的高级自然语言处理库。
- SWIFT
 - SWIFT 是一个可扩展、轻量级的基础设施,用于深度学习模型微调。
- Tensorflow Lingvo
 - 一个用于使用 TensorFlow 构建神经网络的框架,尤其适用于序列模型。
- Tensorflow Text
 - TensorFlow Text 提供一组可与 TensorFlow 2.0 配合使用的文本相关类和操作。
- ToolBench
 - ToolBench 是一个开放平台,用于训练、服务和评估面向工具学习的大型语言模型。
- Transformers
 - Hugging Face 提供的先进自然语言处理(NLP)预训练模型库。
工业级推荐系统
Section titled “工业级推荐系统”- EasyRec
 - EasyRec 是一个用于大规模推荐算法的框架。
- Gorse
 - Gorse 致力于成为一个通用开源推荐系统,可快速应用于各种在线服务。
- Merlin
 - NVIDIA Merlin 是一个开源库,提供端到端 GPU 加速推荐系统,涵盖从特征工程和预处理、训练深度学习模型到生产推理的全过程。
- Recommenders
 - Recommenders 提供推荐系统构建基准测试和最佳实践,并以 Jupyter 笔记本形式呈现。
- TorchRec
 - TorchRec 是一个 PyTorch 领域库,提供大规模推荐系统(RecSys)所需的通用稀疏性和并行性原语。
工业级强化学习
Section titled “工业级强化学习”- Acme
 - Acme 是一个强化学习(RL)构建模块库,致力于提供简单、高效且易读的智能体。
- AReaL
 - AReaL 是一个强化学习库。
- ChatLearn
 - ChatLearn 是一个灵活高效的大型语言模型强化学习训练框架,支持分布式训练引擎(FSDP2、Megatron)和推理引擎(vLLM、SGLang),并支持 GRPO、GSPO 等现代 RL 算法。
- CleanRL
 - CleanRL 是一个深度强化学习库,提供高质量的单文件实现,并具备利于研究的功能。实现简洁清晰,同时可扩展至使用 AWS Batch 运行数千项实验。
- d3rlpy
 - d3rlpy 是一个面向实践者和研究人员的离线深度强化学习库。
- D4RL
 - D4RL 是一个离线强化学习开源基准。
- Dopamine
 - Dopamine 是一个研究框架,可快速原型化强化学习算法。它致力于提供一个精简、易于理解的代码库,让用户自由尝试大胆的新想法(探索性研究)。
- EvoTorch
 - EvoTorch 是由 NNAISENSE 开发、构建于 PyTorch 之上的开源进化计算库。
- FinRL
 - FinRL 是首个展示金融强化学习巨大潜力的开源框架。
- Gymnasium
 - Gymnasium 是一个开源 Python 库,用于开发和比较强化学习算法。它提供学习算法与环境之间通信的标准 API,以及一组符合该 API 的标准环境。
- Gymnasium-Robotics
 - Gymnasium-Robotics 收录了一系列使用 Gymnasium API 的强化学习机器人环境。环境运行于 MuJoCo 物理引擎及其维护的 mujoco Python 绑定之上。
- Jumanji
 - Jumanji 是一套使用 JAX 编写的强化学习(RL)环境,为产业驱动的研究提供简洁、硬件加速的环境。
- MARLlib
 - MARLlib 是一个基于 RLlib 的全面多智能体强化学习算法库,为 MARL 研究社区提供统一平台,用于构建、训练和评估 MARL 算法。
- Mava
 - Mava 是一个使用 JAX 实现的分布式多智能体强化学习框架。
- Melting Pot - Melting Pot 是一套用于多智能体强化学习的测试场景。
- MetaDrive
 - MetaDrive 是一个驾驶模拟器,可组合多样化驾驶场景以实现泛化 RL。
- Minigrid
 - Minigrid 库收录了一系列离散网格世界环境,用于开展强化学习研究。环境遵循 Gymnasium 标准 API,并且轻量、快速且易于定制。
- MiniWorld
 - MiniWorld 是一个极简的 3D 室内环境模拟器,适用于强化学习与机器人研究。
- ML-Agents
 - ML-Agents 是一个开源项目,可将游戏和模拟环境用作训练强化学习智能体的环境。
- MushroomRL
 - MushroomRL 是一个 Python 强化学习(RL)库,其模块化设计让用户能够轻松使用知名张量计算库(如 PyTorch、TensorFlow)和 RL 基准(如 OpenAI Gym、PyBullet、DeepMind Control Suite)。
- OmniSafe
 - OmniSafe 是一个基础设施框架,旨在加速安全强化学习(RL)研究。
- OpenRLHF
 - OpenRLHF 是一个用于人类反馈强化学习(RLHF)的开源框架。
- PARL
 - PARL 是一个灵活且高效的强化学习框架。
- PettingZoo
 - PettingZoo 是一个 Python 库,用于开展多智能体强化学习研究,类似于多智能体版的 Gymnasium。
- ranx
 - ranx 是一个快速排序评估指标库,以 Python 实现,利用 Numba 实现高速向量运算和自动并行化。
- RL4CO
 - RL4CO 是一个 PyTorch 库,涵盖组合优化(CO)强化学习的各类功能。
- RL2
 - RL2 是一个强化学习库。
- RLinf
 - RLinf 是一个强化学习库。
- ROLL
 - ROLL 是一个强化学习库。
- skrl
 - skrl 是一个使用 Python(基于 PyTorch)编写的开源模块化库,用于强化学习,重点关注算法实现的可读性、简洁性和透明度。
- SkyRL
 - SkyRL 是一个全栈强化学习库,提供模块化训练框架、跨平台推理后端、智能体流水线和 Gymnasium 环境,适用于长期运行的现实世界 RL 任务。
- slime
 - slime 是一个用于 RL 扩展的 LLM 后训练框架。
- Stable Baselines
 - OpenAI Baselines 的一个分支,包含强化学习算法实现。
- TF-Agents
 - 一个可靠、可扩展且易用的 TensorFlow 库,用于上下文赌博机和强化学习。
- TorchRL
 - TorchRL 是一个适用于 PyTorch 的开源强化学习(RL)库。
- TRL
 - 使用强化学习训练 Transformer 语言模型。
- veRL
 - veRL(HybridFlow)是一个灵活、高效、工业级的 RLHF 训练框架,专为 LLM 设计。
工业级机器人
Section titled “工业级机器人”- AI2-THOR
 - AI2-THOR 是一个近乎照片级真实、可交互的 AI 智能体框架。
- Genesis
 - Genesis 是一个面向具身 AI 和机器人模拟的物理平台。
- Habitat-Sim
 - Habitat-Sim 是一个灵活、高性能的 3D 模拟器,用于具身 AI 研究。
- IsaacLab
 - IsaacLab 是一个统一、模块化的机器人学习框架,利用 NVIDIA Isaac Sim。
- LeRobot
 - LeRobot 为现实世界机器人和模仿学习提供模型、数据集和工具。
- robosuite
 - robosuite 是一个使用 MuJoCo 物理引擎的机器人学习模拟框架。
- RoboVerse
 - RoboVerse 是一个综合机器人模拟平台,提供多种环境。
工业级可视化
Section titled “工业级可视化”- Apache ECharts
 - Apache ECharts 是一个功能强大的交互式图表和数据可视化库,适用于浏览器。
- Apache Superset
 - 一个现代化、面向企业的商业智能 Web 应用。
- Bokeh
 - Bokeh 是一个面向 Python 的交互式可视化库,可在现代 Web 浏览器中实现美观且富有意义的数据展示。
- Bread Dataset Viewer - 一个 VS Code 扩展,可直接在编辑器中查看和探索大型机器学习数据集(CSV、JSON、Parquet 等),无需担心 IDE 崩溃。
- Bread WandB Viewer - 一个 VS Code 扩展,可在 IDE 中查看 Weights & Biases 实验、日志和产物,无需切换到 Web UI;所有操作完全离线,保护数据隐私。
- Data Formulator
 - 借助 AI 迭代转换数据并创建丰富的可视化。
- ggplot2
 - 面向 R 语言的图形语法实现。
- gradio
 - 只需编写 Python,即可快速创建和分享模型演示。在浏览器中交互式调试模型、收集协作者反馈,并生成公共链接,无需部署任何内容。
- Kangas
 - Kangas 是一个用于探索、分析和可视化大规模多媒体数据的工具。它提供简单易用的 Python API,可记录大型数据表,并配有直观的可视化界面,用于对数据集执行复杂查询。
- matplotlib
 - 一个 Python 二维绘图库,可在多种印刷格式和跨平台交互环境中生成出版级图表。
- Model Explorer
 - Model Explorer 是一个机器学习模型可视化与探索工具,提供直观的图结构视图,帮助理解模型结构、检查层详情并浏览大型神经网络。
- Netron
 - Netron 是一个神经网络、深度学习和机器学习模型查看器。
- Perspective
 通过 WebAssembly 实现流式数据透视可视化。
- Plotly
 - 一个交互式、开源、基于浏览器的 Python 绘图库。
- Redash
 - Redash 是一个开源可视化框架,旨在通过多种后端轻松访问大型数据集。
- Rerun
 - Rerun 是一个开源 SDK,用于记录、存储、查询和可视化多模态数据,专为机器人、计算机视觉和空间 AI 设计。
- seaborn
 - Seaborn 是一个基于 matplotlib 的 Python 可视化库,提供高级接口以绘制美观的统计图表。
- Spotlight
 - Spotlight 可帮助你识别关键数据片段和模型失效模式。它支持整理高质量数据集,从而构建并维护可靠的机器学习模型。
- Streamlit
 - Streamlit 让你通过看似简单的 Python 脚本为机器学习项目创建应用。它支持热重载,因此编辑并保存文件后,应用会实时更新。
- tensorboardX
 - 通过简单的函数调用写入 TensorBoard 事件。
- TensorBoard
 - TensorBoard 是一个机器学习实验可视化工具包,可轻松托管、跟踪和分享 ML 实验。
- Torchvista
 - Torchvista 是一个基于交互式笔记本的工具,可将任意 PyTorch 模型的前向传播可视化为笔记本中的计算图,支持折叠嵌套模块,并可容忍错误、显示部分可视化结果。
- Transformer Explainer
 - Transformer Explainer 是一个交互式可视化工具,旨在帮助任何人了解 GPT 等基于 Transformer 的模型如何工作。
- Vega-Altair
 - Vega-Altair 是一个用于 Python 的声明式统计可视化库。
- ydata-profiling
 - ydata-profiling 以一致且快速的方式,通过一行代码提供探索性数据分析(EDA)体验。
- Apache Atlas
 - Apache Atlas 框架是一套可扩展的核心基础治理服务,可帮助企业有效满足 Hadoop 环境中的合规要求,并支持与整个企业数据生态系统集成。
- DataHub
 - DataHub 是 LinkedIn 的通用元数据搜索与发现工具。
- Marquez
 - Marquez 是一个开源元数据服务,用于收集、汇总和可视化数据生态系统的元数据。
- Metacat
 - Metacat 是一个统一的元数据探索 API 服务,重点解决以下问题:1)元数据系统的联邦视图;2)任意数据集元数据的存储;3)元数据发现。
- ML Metadata
 - 一个用于记录和检索与机器学习开发者及数据科学家工作流相关元数据的库。
模型、数据与实验管理
Section titled “模型、数据与实验管理”- Aim
 - 一种极其简单的方式,用于记录、搜索和比较 AI 实验。
- ClearML
 - 为 AI 提供自动化实验管理器和版本控制(前身为 Trains)。
- DataHub - DataHub 是一个面向现代数据技术栈的开源数据目录。
- Dolt
 - Dolt 是一个 SQL 数据库,可以像 Git 仓库一样进行 fork、clone、branch、merge、push 和 pull。
- DVC
 - DVC(数据版本控制)是一个 Git 分支,可用于模型版本管理。
- HuggingFace Model Downloader
 - HuggingFace Model Downloader 是一个工具,可从 HuggingFace 网站下载模型和数据集。它支持多线程下载 LFS 文件,并通过 SHA256 校验和验证下载模型的完整性。
- Keepsake
 - 机器学习版本控制。
- KitOps
 - KitOps 是一个开放、基于标准的 AI/ML 项目打包与版本管理系统,可与现有 AI/ML、开发和 DevOps 工具协同工作。
- lakeFS
 - 构建于对象存储之上的可重复、原子化且有版本管理的数据湖。
- MLflow
 - 用于管理 ML 生命周期的开源平台,涵盖实验、可复现性和部署。
- Polyaxon
 - 一个在 Kubernetes 上实现可复现、可扩展机器学习与深度学习的平台 - (视频)。
- Quilt
 - 对数据和模型进行版本管理、确保可复现并支持部署。
- Sacred
 - 一个帮助你配置、组织、记录和复现机器学习实验的工具。
- TerminusDB
 - 一种以类似 Git 的方式存储数据的图数据库管理系统。
- Weights & Biases
 - Weights & Biase 是一个机器学习实验跟踪、数据集版本管理、超参数搜索、可视化与协作工具。
模型训练与编排
Section titled “模型训练与编排”- AutoTrain Advanced
 - AutoTrain Advanced 是一种无需编写代码的解决方案,只需点击几下即可训练机器学习模型。
- Avalanche
 - Avalanche 是一个端到端持续学习库,提供共享协作的 MIT 开源代码库,用于快速原型开发、训练和可复现地评估持续学习算法。
- Axolotl
 - Axolotl 是一个工具,旨在简化多种 AI 模型的微调,并支持多种配置和架构。
- BindsNET
 - BindsNET 是一个脉冲神经网络模拟库,面向仿生机器学习算法的开发。
- CML
 - 持续机器学习(CML)是一个开源库,用于在机器学习项目中实现持续集成与交付(CI/CD)。
- CoreNet
 - CoreNet 是一个深度神经网络工具包,研究人员和工程师可用它训练各类标准及新型的小型和大型模型,以完成多种任务,包括基础模型(如 CLIP 和 LLM)、目标分类、目标检测和语义分割。
- DataLinter
 - DataLinter 是一个开源数据与代码上下文检查工具,通过插件设计实现对数据和代码的技术栈无关性。
- Determined
 - 深度学习训练平台,内置分布式训练、超参数调优和模型管理支持(支持 TensorFlow 和 PyTorch)。
- dstack
 - dstack 是一个开源容器编排器,可简化工作负载编排并提高 ML 团队的 GPU 利用率。
- envd
 - 面向数据科学及 AI/ML 工程团队的机器学习开发环境。
- Fire-Flyer File System
 - Fire-Flyer File System(3FS)是一个高性能分布式文件系统,旨在应对 AI 训练和推理工作负载的挑战。它利用现代 SSD 和 RDMA 网络提供共享存储层,简化分布式应用开发。
- H2O-3
 - 快速、可扩展的机器学习平台,助力打造更智能的应用:深度学习、梯度提升与 XGBoost、随机森林、广义线性模型(逻辑回归、弹性网络)、K 均值、PCA、堆叠集成、自动机器学习(AutoML)等。
- Hopsworks
 - Hopsworks 是一个数据密集型平台,用于设计和运行机器学习流水线。
- Ignite
 - Ignite 是一个高级库,可帮助你灵活、透明地使用 PyTorch 训练和评估神经网络。
- Kubeflow
 - 一个基于 Google 内部机器学习流水线构建的云原生机器学习平台。
- Ludwig
 - Ludwig 是一个低代码框架,用于构建 LLM 和其他深度神经网络等自定义 AI 模型。
- MFTCoder
 - MFTCoder 是 CodeFuse 的开源项目,旨在对大型语言模型(LLM)进行准确、高效的多任务微调(MFT),尤其是代码大模型(面向代码任务的语言模型)。
- MLeap
 - 为 Spark、TensorFlow 和 sklearn 实现流水线与模型序列化的标准化。
- Nanotron
 - Nanotron 提供分布式原语,可通过 3D 并行高效训练各种模型。
- NeMo
 - NVIDIA NeMo 是一个可扩展、云原生的生成式 AI 框架,面向使用 PyTorch 的研究人员和开发者,覆盖大型语言模型(LLM)、多模态模型(MM)、自动语音识别(ASR)、文本转语音(TTS)和计算机视觉(CV)等领域。它通过复用现有代码和预训练模型检查点,帮助你高效创建、定制和部署新的生成式 AI 模型。
- Prime
 - Prime 是一个框架,可通过互联网高效地在全球范围内分布式训练 AI 模型。
- PyCaret
 ) - 用于训练和部署模型(scikit-learn、XGBoost、LightGBM、spaCy)的低代码库。
- Sematic
 - 使用简单 Python 构建资源密集型流水线的平台。
- Skaffold
 - Skaffold 是一个命令行工具,可促进 Kubernetes 应用的持续开发。你可以在本地迭代应用源代码,然后部署到本地或远程 Kubernetes 集群。
- TFX
 - TensorFlow Extended(TFX)是一个面向生产的配置框架,基于 TensorFlow 构建 ML,并包含监控和模型版本管理。
- unsloth
 - 面向 LLM 的微调与强化学习。训练 OpenAI gpt-oss、DeepSeek-R1、Qwen3、Gemma 3 和 TTS 的速度快 2 倍,同时减少 70% 的 VRAM 用量。
模型存储优化
Section titled “模型存储优化”- AWQ
 - 面向 LLM 压缩与加速的激活感知权重量化。
- GGML
 - GGML 是一个高性能机器学习张量库,可在 CPU 上实现高效推理,尤其针对大型语言模型进行了优化。
- neural-compressor
 - Intel® Neural Compressor 致力于为主流框架提供常用模型压缩技术,如量化、剪枝(稀疏化)、蒸馏和神经架构搜索。
- NNEF - 神经网络交换格式(NNEF)是一种开放标准,用于表示神经网络模型,以实现不同机器学习框架和平台之间的互操作性和可移植性。
- ONNX
 - ONNX(开放神经网络交换格式)是一种开源格式,旨在促进不同框架和平台之间机器学习模型的互操作性与可移植性。
- PFA - PFA(可移植分析格式)是一种基于 JSON 的标准格式,用于以可移植方式表示和交换预测模型及分析工作流。
- PMML - PMML(预测模型标记语言)是一种基于 XML 的标准,用于在不同应用之间表示和共享预测模型。
- Quanto
 - Quanto 致力于简化深度学习模型量化。
- AI Gateway
 - AI Gateway 是一个极速 AI 网关,集成了防护机制。
- ART
 - ART(对抗鲁棒性工具箱)提供工具,帮助开发者和研究人员防御并评估机器学习模型与应用遭受的对抗威胁,包括规避、投毒、模型提取和推理攻击。
- CipherChat
 - CipherChat 是一个用于评估 LLM 安全对齐泛化能力的框架。
- DeepTeam
 - DeepTeam 是一个简单易用的开源 LLM 红队测试框架,用于渗透测试并保障大型语言模型系统的安全。
- FATE
 - FATE(联邦 AI 技术赋能器)是世界上首个工业级联邦学习开源框架,使企业和机构能够在保护数据安全与隐私的同时开展数据协作。
- FedML
 - FedML 为任意地点、任意规模的联邦/分布式机器学习提供集成研究与生产的边缘云平台。
- Flower
 - Flower 是一个统一方法的联邦学习框架,可联合运行任意机器学习工作负载、使用任意 ML 框架和任意编程语言。
- Google’s Differential Privacy
 - 这是一个 C++ 库,包含 ε-差分隐私算法,可用于对包含私人或敏感信息的数值数据集生成汇总统计信息。
- Guardrails
 - Guardrails 是一个包,可让用户为大型语言模型的输出添加结构、类型和质量保证。
- NeMo Guardrails
 - NeMo Guardrails 是一个开源工具包,可轻松为基于 LLM 的对话系统添加可编程防护机制。
- Opacus
 - Opacus 是一个库,可使用差分隐私训练 PyTorch 模型。它只需在客户端进行极少代码改动,对训练性能影响很小,并允许客户端实时跟踪当前已消耗的隐私预算。
- OpenFL
 - OpenFL 是一个联邦学习 Python 框架,设计灵活、可扩展且易于数据科学家学习。OpenFL 由 Intel 物联网事业部(IOTG)和 Intel Labs 开发。
- PySyft
 - 一个用于安全、私密深度学习的 Python 库。PySyft 将私有数据与模型训练解耦,并在 PyTorch 中使用多方计算(MPC)。
- Tensorflow Privacy
 - 一个 Python 库,包含使用差分隐私训练机器学习模型的 TensorFlow 优化器实现。
- TF Encrypted
 - 一个用于基于 TensorFlow 对加密数据进行机密机器学习的框架。
其他精选列表
Section titled “其他精选列表”- Awesome Agentic Engineering Resources
 - 精选资源、工具和参考资料合集,助你构建智能体 AI 系统。
- Awesome AI Gateway
 - 精选的双语(英文/简体中文)AI 网关和 LLM 代理列表(LiteLLM、OpenRouter、Portkey、Kong、Higress、new-api),按成本、合规性、自托管和路由进行比较,并提供决策树、可复现成本基准测试和选择评分卡。
- Awesome AI Regulation
 - 涵盖负责任部署机器学习系统所需的治理、合规和监管框架,并覆盖不同司法辖区。
- Awesome AI Tokenomics
 - 涵盖 AI 系统中的 Token 成本与效率,包括监控、优化、缓存、模型选择和上下文管理。
- Awesome Production GenAI
 - 专注于生成式 AI 部署,包括 LLM 运维、提示词工程以及生成式 AI 专属的监控和安全工具。
- Awesome RAG Production
 - 精选生产级工具和最佳实践,助你构建可扩展的 RAG 系统。
HagiCode
HagiCode 是面向项目开发的 AI 编码工作台:丰富、便捷的界面交互让规划、Agent 执行与项目工作更容易上手和跟进,带来更投入的开发体验。
丰富、便捷的界面交互,让规划、Agent 执行与项目工作更容易上手和跟进。

- 智能OpenSpec 工作流把意图转化为从提案、设计、任务到交付的可执行路径。
- 高效多 Agent 并行推进调研、实现与审阅,并支持多仓库变更和你熟悉的 Agent CLI。
- 有趣丰富、便捷的界面交互让规划、Agent 执行与项目工作更容易上手和跟进,带来更投入的开发体验。
下载 Windows 版
分享 HagiCode

让想法变成真正交付的软件。
HagiCode 是面向项目开发的 AI 编码工作台:用 OpenSpec 工作流规划变更,多 Agent 并行执行,再由 Hero Scenario 让进度一目了然,把想法变成真正交付的软件。
- 智能
- OpenSpec 工作流把意图变成从提案到交付的可执行路径。
- 高效
- 多 Agent 并行推进调研、实现与审阅。
- 有趣
- 丰富、便捷的界面交互,让规划、Agent 执行和项目工作更容易跟进。
© 2026 HagiCode | Powered By hagilight-starlight@0.21.0 | Branch: main | Commit: 745b50b | Built: