
Chinese NLP
Source: https://github.com/crownpku/Awesome-Chinese-NLP at
923e20ae6872
License: Apache-2.0
Read the English original
This edition is an AI-assisted translation.
中文自然语言处理(Chinese NLP)
Section titled “中文自然语言处理(Chinese NLP)”
面向中文自然语言处理(NLP)的精选资源列表。
中文自然语言处理相关资料
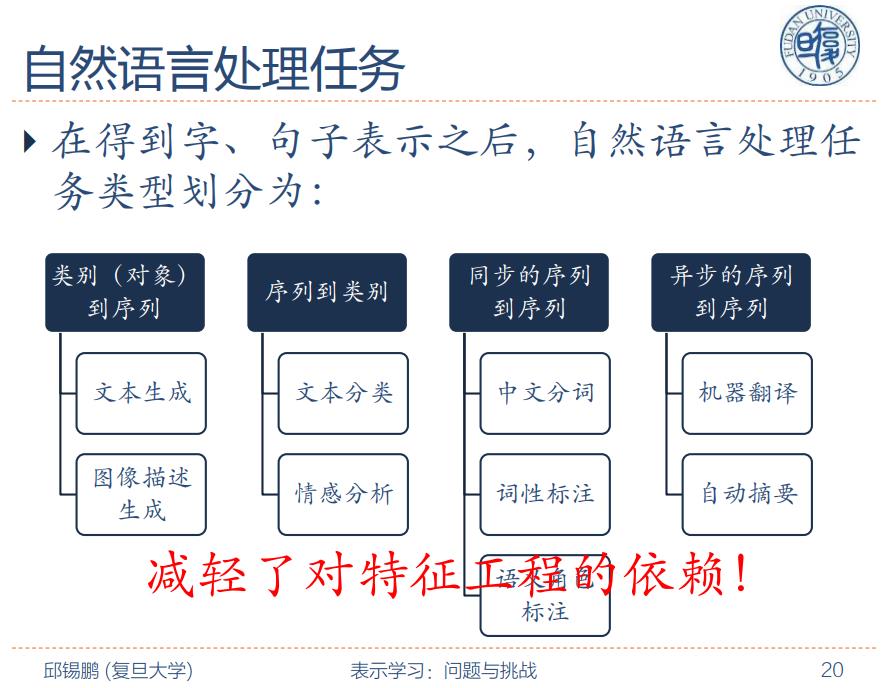
图片来自复旦大学邱锡鹏教授
目录 Contents
Section titled “目录 Contents”中文 NLP 工具 Chinese NLP Toolkits
Section titled “中文 NLP 工具 Chinese NLP Toolkits”综合 NLP 工具包 Toolkits
Section titled “综合 NLP 工具包 Toolkits”-
THULAC 中文词法分析工具包 by 清华 (C++/Java/Python)
-
NLPIR by 中科院 (Java)
-
LTP 语言技术平台 by 哈工大 (C++) pylyp LTP 的 python 封装
-
FudanNLP by 复旦 (Java)
-
BaiduLac by 百度 Baidu 开源的中文词法分析工具,包含分词、词性标注与命名实体识别。
-
HanLP (Java)
-
FastNLP (Python) 一款轻量级的 NLP 处理套件。
-
SnowNLP (Python) 用于处理中文文本的 Python 库
-
YaYaNLP (Python) 纯 python 编写的中文自然语言处理包,取名于“牙牙学语”
-
小明NLP (Python) 轻量级中文自然语言处理工具
-
DeepNLP (Python) 基于 Tensorflow 实现、带有中文预训练模型的深度学习 NLP 流水线。
-
chinese_nlp (C++ & Python) 中文自然语言处理工具与示例
-
lightNLP (Python) 基于 Pytorch 和 torchtext 的自然语言处理深度学习框架
-
Chinese-Annotator (Python) 中文文本标注工具 Annotator for Chinese Text Corpus
-
Poplar (Typescript) 基于 Web 的自然语言处理(NLP)标注工具
-
Jiagu (Python) Jiagu 以 BiLSTM 等模型为基础,使用大规模语料训练而成。将提供中文分词、词性标注、命名实体识别、情感分析、知识图谱关系抽取、关键词抽取、文本摘要、新词发现等常用自然语言处理功能。
-
SmoothNLP (Python & Java) 专注于可解释的 NLP 技术
-
FoolNLTK (Python & Java) 一个中文自然语言处理工具包 A Chinese Nature Language Toolkit
常用的英文或支持多语言的 NLP 工具包 Popular NLP Toolkits for English/Multi-Language
Section titled “常用的英文或支持多语言的 NLP 工具包 Popular NLP Toolkits for English/Multi-Language”-
CoreNLP by Stanford (Java) 一套 Java 核心 NLP 工具。
-
Stanza by Stanford (Python) 支持多种人类语言的 Python NLP 库
-
NLTK (Python) Natural Language Toolkit 自然语言工具包
-
textacy (Python) 在 spaCy 之前与之后都能用的 NLP
-
OpenNLP (Java) 基于机器学习的自然语言文本处理工具包。
-
gensim (Python) Gensim 是一个用于主题建模、文档索引与大规模语料相似度检索的 Python 库。
-
Kashgari - 简单而强大的 NLP 框架,5 分钟构建用于命名实体识别(NER)、词性标注(PoS)与文本分类的先进模型。包含 BERT 与 word2vec 词向量。
中文分词 Chinese Word Segment
Section titled “中文分词 Chinese Word Segment”-
Jieba 结巴中文分词 (Python 及大量其它编程语言衍生) 做最好的 Python 中文分词组件
-
北大中文分词工具 (Python) 高准确度中文分词工具,简单易用,跟现有开源工具相比大幅提高了分词的准确率。
-
kcws 深度学习中文分词 (Python) BiLSTM+CRF 与 IDCNN+CRF
-
ID-CNN-CWS (Python) 用于中文分词的迭代膨胀卷积 Iterated Dilated Convolutions for Chinese Word Segmentation
-
Genius 中文分词 (Python) Genius 是一个开源的 python 中文分词组件,采用 CRF(条件随机场)算法。
-
loso 中文分词 (Python)
-
yaha “哑哈”中文分词 (Python)
-
ChineseWordSegmentation (Python) 无需语料库的中文分词算法 Chinese word segmentation algorithm without corpus
-
Go 语言高性能分词 (Go) Go 高效文本分词;支持英文、中文、日文等。
-
Ansj中文分词 (java) 基于 n-Gram+CRF+HMM 的中文分词 java 实现
信息提取 Information Extraction
Section titled “信息提取 Information Extraction”-
MITIE (C++) 用于信息提取的库与工具
-
Duckling (Haskell) 用于表达、测试与评估可组合语言规则的引擎与工具。
-
IEPY (Python) IEPY 是一个专注于关系抽取的开源信息提取工具。
-
Snorkel 专注于信息提取的训练数据创建与管理系统
-
bert-chinese-ner 使用预训练语言模型 BERT 做中文 NER
-
Information-Extraction-Chinese 使用 IDCNN/biLSTM+CRF 做中文命名实体识别、biGRU+2ATT 做关系抽取的中文实体识别与关系提取
-
Familia 百度出品的工业级主题建模工具包 A Toolkit for Industrial Topic Modeling
-
Text Classification 各类深度学习文本分类模型等。用知乎问答语料作为测试数据。
-
ComplexEventExtraction 中文复合事件的概念与显式模式,包括条件事件、因果事件、顺承事件、反转事件等事件抽取,并形成事理图谱。
-
TextRank4ZH 从中文文本中自动提取关键词和摘要
问答和聊天机器人 QA & Chatbot
Section titled “问答和聊天机器人 QA & Chatbot”-
Rasa NLU (Python) 将自然语言转为结构化数据,中文分支见 Rasa NLU Chi
-
Rasa Core (Python) 基于机器学习的对话引擎,用于会话软件
-
Chatstack 用于构建中文 NLU 系统的完整流水线 UI
-
Snips NLU (Python) Snips NLU 是一个能够解析自然语言句子并提取结构化信息的 Python 库。
-
DeepPavlov (Python) 用于构建端到端对话系统与训练聊天机器人的开源库。
-
ChatScript 自然语言工具/对话管理器,基于规则的聊天机器人引擎。
-
Chatterbot (Python) ChatterBot 是一个用于创建聊天机器人的机器学习对话引擎。
-
Chatbot (Python) 基于向量匹配的情境式聊天机器人
-
Tipask (PHP) 一款开放源码的 PHP 问答系统,基于 Laravel 框架开发,容易扩展,具有强大的负载能力和稳定性。
-
QuestionAnsweringSystem (Java) 一个 Java 实现的人机问答系统,能够自动分析问题并给出候选答案。
-
QA-Snake (Python) 基于多搜索引擎和深度学习技术的自动问答
-
使用深度学习算法实现的中文阅读理解问答系统 (Python)
-
AnyQ by Baidu 主要包含面向 FAQ 集合的问答系统框架、文本语义匹配工具 SimNet。
-
DuReader 中文阅读理解 Baseline 代码 (Python)
-
基于 SmartQQ 的自动机器人框架 (Python)
-
QASystemOnMedicalKG (Python) 以疾病为中心的一定规模医药领域知识图谱,并以该知识图谱完成自动问答与分析服务。
-
GPT2-chitchat (Python) 用于中文闲聊的 GPT2 模型
-
CDial-GPT (Python) 提供了一个大规模中文对话数据集,并提供了在此数据集上的中文对话预训练模型(中文 GPT 模型)
多模态表征与检索 Multi-Modal Representation & Retrieval
Section titled “多模态表征与检索 Multi-Modal Representation & Retrieval”- Chinese-CLIP (Python) Chinese-CLIP 是中文多模态图文表征预训练模型。其基于 OpenAI 的 CLIP 模型结构,利用大规模中文原生图文语料完成预训练,目前开源了多个模型规模,同时公开了技术报告论文及检索 demo
中文语料 Corpus
Section titled “中文语料 Corpus”-
农业知识图谱 农业领域的信息检索,命名实体识别,关系抽取,分类树构建,数据挖掘
-
基于不同语料、不同模型(比如 BERT、GPT)的中文预训练模型 中文预训练模型框架,支持不同语料、编码器、目标任务的预训练模型(from RUC and Tencent)
-
OpenCLaP 多领域开源中文预训练语言模型仓库 (from Tsinghua)
-
UDChinese (用于训练 spaCy 词性标注)
-
Tencent AI Lab Embedding Corpus for Chinese Words and Phrases
-
中文 GPT2 训练代码 可以写诗,新闻,小说,或是训练通用语言模型。
-
中文语言理解测评基准 ChineseGLUE 包括代表性的数据集、基准(预训练)模型、语料库、排行榜。
-
中华新华字典数据库 包括歇后语,成语,词语,汉字。
-
Synonyms: 中文近义词工具包 基于维基百科中文和 word2vec 训练的近义词库,封装为 python 包文件。
-
Chinese_conversation_sentiment 一个可用于情感分析的中文情感数据集。
-
中文突发事件语料库 Chinese Emergency Corpus
-
dgk_lost_conv 中文对白语料 chinese conversation corpus
-
用于训练中英文对话系统的语料库 Datasets for Training Chatbot System
-
中国股市公告信息爬取 通过 python 脚本从巨潮网络的服务器获取中国股市(sz, sh)的公告(上市公司和监管机构)
-
tushare 财经数据接口 TuShare 是一个免费、开源的 python 财经数据接口包。
-
金融文本数据集 SmoothNLP 金融文本数据集(公开) Public Financial Datasets for NLP Researches
-
保险行业语料库 [52nlp 介绍 Blog] 面向机器学习的保险领域开放数据 OpenData in insurance area for Machine Learning Tasks
-
最全中华古诗词数据库 唐宋两朝近一万四千古诗人, 接近 5.5 万首唐诗加 26 万宋诗. 两宋时期 1564 位词人,21050 首词。
-
中文语料小数据 包含了中文命名实体识别、中文关系识别、中文阅读理解等一些小量数据
-
Chinese-Literature-NER-RE-Dataset 面向中文文学文本的语篇级命名实体识别与关系抽取数据集 A Discourse-Level Named Entity Recognition and Relation Extraction Dataset for Chinese Literature Text
-
ChineseTextualInference 中文文本推断项目, 包括 88 万文本蕴含中文文本蕴含数据集的翻译与构建, 基于深度学习的文本蕴含判定模型构建.
-
大规模中文自然语言处理语料 维基百科(wiki2019zh), 新闻语料(news2016zh), 百科问答(baike2018qa)
-
中文人名语料库 中文姓名, 姓氏, 名字, 称呼, 日本人名, 翻译人名, 英文人名。
-
公司名、机构名语料库 公司简称, 缩写, 品牌词, 企业名。
-
中文敏感词词库 敏感词过滤的几种实现+某 1w 词敏感词库
-
中文简称词库 包含否定全称的中文缩写语料库 A corpus of Chinese abbreviation, including negative full forms.
-
中文数据预处理材料 中文分词词典和中文停用词
-
SentiBridge: 中文实体情感知识库 刻画人们如何描述某个实体,包含新闻、旅游、餐饮,共计 30 万对。
-
OpenCorpus 一系列可自由获取(中文)语料的集合。
-
ChineseNlpCorpus 情感/观点/评论 倾向性分析,中文命名实体识别,推荐系统
-
FinancialDatasets SmoothNLP 金融文本数据集(公开) Public Financial Datasets for NLP Researches Only
-
People’s Daily & Children’s Fairy Tale PD&CFT: 一个中文阅读理解数据集 A Chinese Reading Comprehension Dataset
中文 NLP 学术组织及竞赛 Organizations
Section titled “中文 NLP 学术组织及竞赛 Organizations”-
NLP Conference Calender NLP 领域的主要会议、期刊、研讨会与共享任务。
-
2017 AI-Challenger 图像中文描述 用一句话描述给定图像中的主要信息,挑战中文语境下的图像理解问题。
-
2017 AI-Challenger 英中机器文本翻译 用大规模的数据,提升英中文本机器翻译模型的能力。
-
2017 知乎看山杯机器学习挑战赛 根据知乎给出的问题及话题标签的绑定关系的训练数据,训练出对未标注数据自动标注的模型。
-
2018 开放领域的中文问答任务 对于给定的一句中文问题,问答系统从给定知识库中选择若干实体或属性值作为该问题的答案。
-
2018 微众银行智能客服问句匹配大赛 针对中文的真实客服语料,进行问句意图匹配;给定两个语句,判定两者意图是否相近。
中文 NLP 商业服务 Industry
Section titled “中文 NLP 商业服务 Industry”-
华为云 NLP 针对各类企业及开发者提供的用于文本分析及挖掘的云服务,旨在帮助用户高效的处理文本
-
百度云 NLP 提供业界领先的自然语言处理技术,提供优质文本处理及理解技术
-
阿里云 NLP 为各类企业及开发者提供的用于文本分析及挖掘的核心工具
-
腾讯云 NLP 基于并行计算、分布式爬虫系统,结合独特的语义分析技术,一站满足 NLP、转码、抽取、数据抓取等需求
-
讯飞开放平台 以语音交互为核心的人工智能开放平台
-
搜狗实验室 分词和词性标注
-
玻森数据 上海玻森数据科技有限公司,专注中文语义分析技术
-
云孚科技 NLP 工具包、知识图谱、文本挖掘、对话系统、舆情分析等
-
智言科技 专注于深度学习和知识图谱技术突破的人工智能公司
-
追一科技 主攻深度学习和自然语言处理
学习资料 Learning Materials
Section titled “学习资料 Learning Materials”-
Stanford CS224n Natural Language Processing with Deep Learning 2017
-
[Course materials for Georgia Tech CS 4650 and 7650, “Natural Language”] (https://github.com/jacobeisenstein/gt-nlp-class)
-
Speech and Language Processing by Dan Jurafsky and James H. Martin
-
文本处理实践课资料 文本处理实践课资料,包含文本特征提取(TF-IDF),文本分类,文本聚类,word2vec 训练词向量及同义词词林中文词语相似度计算、文档自动摘要,信息抽取,情感分析与观点挖掘等实验。
-
nlp_tasks Natural Language Processing Tasks and Selected References
-
NLP 研究入门之道 from 清华刘知远老师
-
Chinese NLP 中文自然语言处理的共享任务、数据集与最新成果
HagiCode
HagiCode 是面向项目开发的 AI 编码工作台:丰富、便捷的界面交互让规划、Agent 执行与项目工作更容易上手和跟进,带来更投入的开发体验。
丰富、便捷的界面交互,让规划、Agent 执行与项目工作更容易上手和跟进。

- 智能OpenSpec 工作流把意图转化为从提案、设计、任务到交付的可执行路径。
- 高效多 Agent 并行推进调研、实现与审阅,并支持多仓库变更和你熟悉的 Agent CLI。
- 有趣丰富、便捷的界面交互让规划、Agent 执行与项目工作更容易上手和跟进,带来更投入的开发体验。
下载 Windows 版
分享 HagiCode

让想法变成真正交付的软件。
HagiCode 是面向项目开发的 AI 编码工作台:用 OpenSpec 工作流规划变更,多 Agent 并行执行,再由 Hero Scenario 让进度一目了然,把想法变成真正交付的软件。
- 智能
- OpenSpec 工作流把意图变成从提案到交付的可执行路径。
- 高效
- 多 Agent 并行推进调研、实现与审阅。
- 有趣
- 丰富、便捷的界面交互,让规划、Agent 执行和项目工作更容易跟进。
© 2026 HagiCode | Powered By hagilight-starlight@0.21.0 | Branch: main | Commit: 745b50b | Built: