
Chinese NLP
Source: https://github.com/crownpku/Awesome-Chinese-NLP at
923e20ae6872
License: Apache-2.0
Read the English original
This edition is an AI-assisted translation.
Chinese NLP
Заголовок раздела «Chinese NLP»
Подборка ресурсов по NLP (обработке естественного языка) для китайского языка.
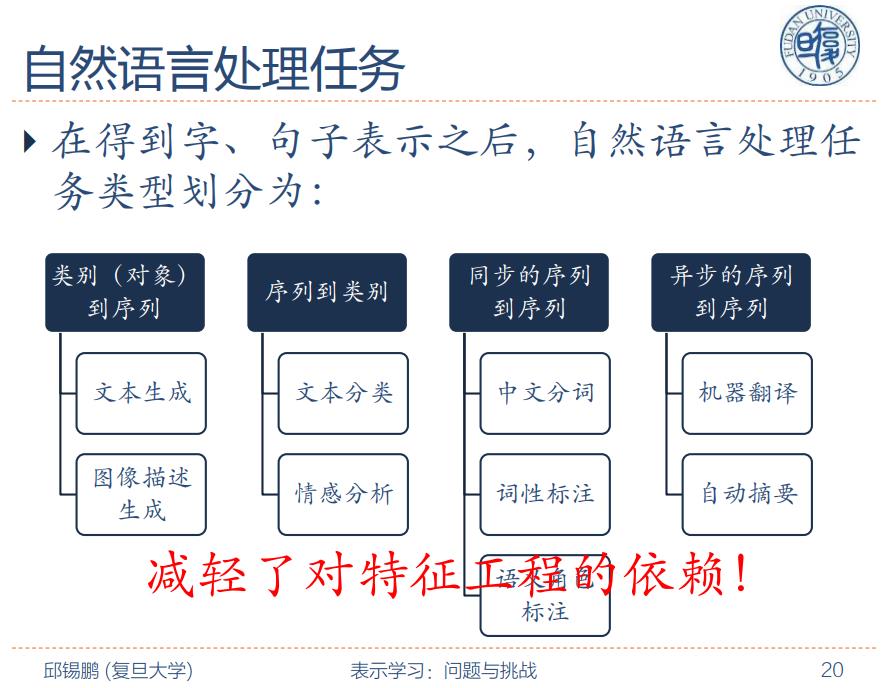
Материалы, связанные с обработкой естественного языка китайского
Изображение предоставлено профессором Цю Сипэном из Фуданьского университета
Содержание Contents
Заголовок раздела «Содержание Contents»1. Китайские NLP-инструменты Chinese NLP Toolkits
Заголовок раздела «1. Китайские NLP-инструменты Chinese NLP Toolkits»3. Академические организации и соревнования по китайскому NLP Organizations
Заголовок раздела «3. Академические организации и соревнования по китайскому NLP Organizations»4. Коммерческие сервисы китайского NLP Industry
Заголовок раздела «4. Коммерческие сервисы китайского NLP Industry»Китайские NLP-инструменты Chinese NLP Toolkits
Заголовок раздела «Китайские NLP-инструменты Chinese NLP Toolkits»Комплексные NLP-наборы Toolkits
Заголовок раздела «Комплексные NLP-наборы Toolkits»-
THULAC 中文词法分析工具包 от 清华 (C++/Java/Python)
-
NLPIR от 中科院 (Java)
-
LTP 语言技术平台 от 哈工大 (C++) pylyp Python-обёртка для LTP
-
FudanNLP от 复旦 (Java)
-
BaiduLac от 百度 открытый инструмент лексического анализа Baidu для китайского: сегментация, частеречная разметка и распознавание именованных сущностей.
-
HanLP (Java)
-
FastNLP (Python) лёгкий NLP-пакет.
-
SnowNLP (Python) библиотека Python для обработки китайского текста
-
YaYaNLP (Python) китайский NLP-пакет, написанный на чистом Python, назван в честь «牙牙学语» (лепет ребёнка)
-
小明NLP (Python) лёгкий инструмент китайского NLP
-
DeepNLP (Python) конвейер глубокого обучения NLP на Tensorflow с предобученными китайскими моделями.
-
chinese_nlp (C++ & Python) китайские NLP-инструменты и примеры
-
lightNLP (Python) фреймворк глубокого обучения NLP на базе Pytorch и torchtext
-
Chinese-Annotator (Python) инструмент разметки китайского текста Annotator for Chinese Text Corpus
-
Poplar (Typescript) веб-инструмент аннотирования для NLP
-
Jiagu (Python) Jiagu основан на моделях вроде BiLSTM и обучен на крупных корпусах. Предоставляет сегментацию, частеречную разметку, NER, анализ тональности, извлечение отношений из графа знаний, извлечение ключевых слов, суммаризацию, обнаружение новых слов и др.
-
SmoothNLP (Python & Java) ориентирован на объяснимые NLP-технологии
-
FoolNLTK (Python & Java) набор инструментов китайского естественного языка A Chinese Nature Language Toolkit
Популярные английские или многоязычные NLP-наборы Popular NLP Toolkits for English/Multi-Language
Заголовок раздела «Популярные английские или многоязычные NLP-наборы Popular NLP Toolkits for English/Multi-Language»-
CoreNLP от Stanford (Java) набор основных NLP-инструментов на Java.
-
Stanza от Stanford (Python) Python-библиотека NLP для многих человеческих языков
-
NLTK (Python) Natural Language Toolkit
-
spaCy (Python) NLP промышленного уровня с онлайн-курсом
-
textacy (Python) NLP до и после spaCy
-
OpenNLP (Java) набор на основе машинного обучения для обработки текста естественного языка.
-
gensim (Python) Gensim — библиотека Python для тематического моделирования, индексирования документов и поиска сходства в больших корпусах.
-
Kashgari - простой и мощный NLP-фреймворк, соберите передовую модель за 5 минут для NER, PoS и классификации текста. Включает BERT и word2vec.
Сегментация китайских слов Chinese Word Segment
Заголовок раздела «Сегментация китайских слов Chinese Word Segment»-
Jieba 结巴中文分词 (Python и множество других языковых вариантов) лучший компонент сегментации китайского для Python
-
北大中文分词工具 (Python) высокоточный инструмент сегментации, простой в использовании, заметно точнее существующих открытых инструментов.
-
kcws 深度学习中文分词 (Python) BiLSTM+CRF и IDCNN+CRF
-
ID-CNN-CWS (Python) итеративные дилатированные свёртки для сегментации китайских слов Iterated Dilated Convolutions for Chinese Word Segmentation
-
Genius 中文分词 (Python) Genius — открытый компонент сегментации китайского на python, использует алгоритм CRF (условное случайное поле).
-
loso 中文分词 (Python)
-
yaha “哑哈”中文分词 (Python)
-
ChineseWordSegmentation (Python) алгоритм сегментации китайского без корпуса Chinese word segmentation algorithm without corpus
-
Высокопроизводительная сегментация на Go (Go) эффективная сегментация текста на Go; поддерживает английский, китайский, японский и др.
-
Ansj中文分词 (java) реализация сегментации китайского на Java на базе n-Gram+CRF+HMM
Извлечение информации Information Extraction
Заголовок раздела «Извлечение информации Information Extraction»-
MITIE (C++) библиотека и инструменты для извлечения информации
-
Duckling (Haskell) язык, движок и инструменты для выражения, тестирования и оценки компонуемых языковых правил на входных строках.
-
IEPY (Python) IEPY — открытый инструмент извлечения информации с упором на извлечение отношений.
-
Snorkel система создания и управления обучающими данными с упором на извлечение информации
-
Нейросетевая модель для распознавания именованных сущностей китайского языка
-
bert-chinese-ner использует предобученную языковую модель BERT для китайского NER
-
Information-Extraction-Chinese NER китайского с IDCNN/biLSTM+CRF и извлечение отношений с biGRU+2ATT 中文实体识别与关系提取
-
Familia от Baidu, A Toolkit for Industrial Topic Modeling
-
Text Classification всевозможные модели классификации текста и др. на глубоком обучении. В качестве тестовых данных — корпус вопросов и ответов Zhihu.
-
ComplexEventExtraction понятия и явные шаблоны составных китайских событий: условные, причинно-следственные, последовательные, инверсные события и построение графа событий.
-
TextRank4ZH автоматически извлекает ключевые слова и резюме из китайского текста
Вопросы и ответы и чат-боты QA & Chatbot
Заголовок раздела «Вопросы и ответы и чат-боты QA & Chatbot»-
Rasa NLU (Python) преобразует естественный язык в структурированные данные, китайская ветка — Rasa NLU Chi
-
Rasa Core (Python) движок диалога на основе машинного обучения для разговорного ПО
-
Chatstack полноценный UI-конвейер для построения китайской NLU-системы
-
Snips NLU (Python) Snips NLU — библиотека Python, разбирающая предложения естественного языка и извлекающая структурированную информацию.
-
DeepPavlov (Python) открытая библиотека для создания сквозных диалоговых систем и обучения чат-ботов.
-
ChatScript инструмент/менеджер диалога естественного языка, движок чат-ботов на правилах.
-
Chatterbot (Python) ChatterBot — движок разговорного диалога на машинном обучении для создания чат-ботов.
-
Chatbot (Python) контекстный чат-бот на основе сопоставления векторов
-
Tipask (PHP) открытая PHP-система вопросов и ответов на Laravel, легко расширяется, с высокой нагрузочной способностью и стабильностью.
-
QuestionAnsweringSystem (Java) человеко-машинная система вопросов и ответов на Java, автоматически анализирует вопросы и даёт кандидатов в ответы.
-
QA-Snake (Python) автоматические вопросы и ответы на базе нескольких поисковых систем и глубокого обучения
-
Система вопросов и ответов для чтения китайского на глубоком обучении (Python)
-
AnyQ by Baidu включает в основном фреймворк вопросов и ответов для коллекций FAQ и инструмент семантического сопоставления текста SimNet.
-
Фреймворк авто-бота на базе SmartQQ (Python)
-
QASystemOnMedicalKG (Python) граф знаний медицинской предметной области определённого масштаба, центрированный на болезнях, с автоматическими вопросами, ответами и аналитикой.
-
GPT2-chitchat (Python) модель GPT2 для китайской болтовни
-
CDial-GPT (Python) предоставляет большой китайский диалоговый датасет и предобученную китайскую диалоговую модель (китайскую GPT-модель) на нём
Мультимодальное представление и поиск Multi-Modal Representation & Retrieval
Заголовок раздела «Мультимодальное представление и поиск Multi-Modal Representation & Retrieval»- Chinese-CLIP (Python) Chinese-CLIP — предобученная модель китайского мультимодального представления текст-изображение. На базе структуры CLIP от OpenAI, предобучена на большом нативном китайском корпусе текст-изображение; открыто несколько размеров моделей, технический отчёт и демо поиска.
Китайский корпус Corpus
Заголовок раздела «Китайский корпус Corpus»-
CN-Probase, крупный граф китайских концептов описание в официальном аккаунте
-
Открытая загрузка крупного графа знаний китайского языка на 140 млн
-
Сельскохозяйственный граф знаний поиск информации, распознавание сущностей, извлечение отношений, построение дерева классификации, интеллектуальный анализ данных в сельской области
-
Китайские предобученные модели по разным корпусам и моделям (BERT, GPT и т.д.) фреймворк китайских предобученных моделей, поддерживающий разные корпуса, кодировщики и задачи (from RUC and Tencent)
-
OpenCLaP мультидоменный открытый репозиторий предобученных языковых моделей китайского (from Tsinghua)
-
Корпус с частеречной разметкой «Жэньминь Жибао» 1998 г.@Baidu Disk
-
Корпус новостей Sogou 20061127 (с классификацией)@Baidu Disk
-
UDChinese (для обучения spaCy POS)
-
Tencent AI Lab Embedding Corpus for Chinese Words and Phrases
-
Код обучения китайского GPT2 может писать стихи, новости, романы или обучать универсальную языковую модель.
-
ChineseGLUE, бенчмарк понимания китайского языка включает репрезентативные датасеты, эталонные (предобученные) модели, корпуса, таблицу лидеров.
-
База данных китайского словаря Синьхуа включает пословицы, идиомы, слова, иероглифы.
-
Synonyms: набор синонимов китайского библиотека синонимов, обученная на китайской Wikipedia и word2vec, упакованная как python-пакет.
-
Chinese_conversation_sentiment китайский датасет тональности, полезный для анализа настроений.
-
Корпус китайских чрезвычайных ситуаций Chinese Emergency Corpus
-
dgk_lost_conv, корпус китайских диалогов chinese conversation corpus
-
Корпус для обучения китайско-английских диалоговых систем Datasets for Training Chatbot System
-
Сбор объявлений китайской биржи python-скрипты для получения объявлений (публичных компаний и регуляторов) рынков sz, sh с серверов Juchao
-
Интерфейс финансовых данных tushare TuShare — бесплатный открытый python-пакет финансовых данных.
-
Датасет финансового текста SmoothNLP 金融文本数据集(公开) Public Financial Datasets for NLP Researches
-
Корпус страховой отрасли [Блог 52nlp] открытые данные в страховой сфере для задач ML OpenData in insurance area for Machine Learning Tasks
-
Самая полная база древней китайской поэзии почти 14000 поэтов эпох Тан и Сун, ~55000 танских стихов и 260000 сунских стихов. 1564 автораci эпохи Сун, 21050 ci.
-
Небольшие китайские корпуса включает немного китайского NER, распознавания отношений, чтения
-
Chinese-Literature-NER-RE-Dataset датасет NER и извлечения отношений на уровне дискурса для китайского литературного текста A Discourse-Level Named Entity Recognition and Relation Extraction Dataset for Chinese Literature Text
-
ChineseTextualInference проект текстового вывода китайского языка, включая перевод и построение датасета из 880k пар текстовой импликации и модель на глубоком обучении.
-
Крупный корпус китайского NLP Wikipedia (wiki2019zh), новости (news2016zh), энциклопедические Q&A (baike2018qa)
-
Корпус китайских имён людей китайские имена, фамилии, личные имена, обращения, японские имена, переведённые имена, английские имена.
-
Корпус названий компаний и организаций сокращения компаний, аббревиатуры, бренды, названия предприятий.
-
Словарь чувствительных китайских слов несколько реализаций фильтрации чувствительных слов + словарь ~10k слов
-
Корпус китайских аббревиатур корпус китайских аббревиатур, включая отрицательные полные формы A corpus of Chinese abbreviation, including negative full forms.
-
Материалы предобработки китайских данных словарь сегментации и стоп-слова китайского
-
SentiBridge: база знаний тональности китайских сущностей описывает, как люди описывают сущность; 300000 пар из новостей, путешествий, общепита.
-
OpenCorpus собрание свободно доступных (китайских) корпусов.
-
ChineseNlpCorpus анализ тональности/мнения/комментариев, китайский NER, рекомендательная система
-
FinancialDatasets SmoothNLP 金融文本数据集(公开) Public Financial Datasets for NLP Researches Only
-
People’s Daily & Children’s Fairy Tale PD&CFT: китайский датасет чтения A Chinese Reading Comprehension Dataset
Академические организации и соревнования по китайскому NLP Organizations
Заголовок раздела «Академические организации и соревнования по китайскому NLP Organizations»-
Лаборатория NLP и гуманитарных вычислений Университета Цинхуа
-
Ключевая лаборатория вычислительной лингвистики Пекинского университета
-
Группа исследований NLP Института вычислительной техники Академии
-
NLP Conference Calender основные конференции, журналы, воркшопы и общие задачи сообщества NLP.
-
2017 AI-Challenger описание изображения на китайском описать одним предложением главную информацию заданного изображения, задача понимания изображения в китайском контексте.
-
2017 AI-Challenger машинный перевод текста английский-китайский на больших данных повысить способность моделей машинного перевода англо-китайского текста.
-
2017 конкурс машинного обучения Zhihu Kanshan Cup по обучающим данным привязки вопросов и тегов тем Zhihu обучить модель автоматической разметки неразмеченных данных.
-
2018 задача китайских вопросов и ответов в открытой области для заданного китайского вопроса система выбирает из базы знаний сущности или значения атрибутов в качестве ответа.
-
2018 конкурс сопоставления вопросов службы поддержки WeBank на реальном китайском корпусе поддержки, сопоставление намерений; даны две фразы — определить близость намерений.
Коммерческие сервисы китайского NLP Industry
Заголовок раздела «Коммерческие сервисы китайского NLP Industry»-
Huawei Cloud NLP облачный сервис анализа и извлечения текста для предприятий и разработчиков, помогает эффективно обрабатывать текст
-
Baidu Cloud NLP предоставляет передовую технологию NLP, качественную обработку и понимание текста
-
Alibaba Cloud NLP ключевой инструмент анализа и извлечения текста для предприятий и разработчиков
-
Tencent Cloud NLP на базе параллельных вычислений и распределённого краулера в сочетании с уникальным семантическим анализом закрывает NLP, транскодирование, извлечение, сбор данных
-
Открытая платформа iFlytek открытая ИИ-платформа с упором на голосовое взаимодействие
-
Лаборатория Sogou сегментация и частеречная разметка
-
BosonNLP 玻森数据 Shanghai Boson, специализируется на семантическом анализе китайского
-
Yunfu Tech 云孚科技 NLP-инструменты, графы знаний, извлечение текста, диалоговые системы, анализ мнений и т.д.
-
Zhiyan Tech 智言科技 ИИ-компания, ориентированная на глубокое обучение и графы знаний
-
Zhuiyi Tech 追一科技 ориентирована на глубокое обучение и NLP
Учебные материалы Learning Materials
Заголовок раздела «Учебные материалы Learning Materials»-
Stanford CS224n Natural Language Processing with Deep Learning 2017
-
[Учебные материалы для Georgia Tech CS 4650 и 7650, «Natural Language»] (https://github.com/jacobeisenstein/gt-nlp-class)
-
Speech and Language Processing от Dan Jurafsky и James H. Martin
-
Материалы практического курса обработки текста включают извлечение признаков (TF-IDF), классификацию, кластеризацию текста, обучение word2vec, расчёт сходства китайских слов, автоматическое резюме, извлечение информации, анализ тональности и майнинг мнений.
-
nlp_tasks Natural Language Processing Tasks and Selected References
-
Путь в исследования NLP от профессора Лю Чжиюаня 清华
-
Chinese NLP Общие задачи, наборы данных и передовые результаты по китайскому NLP
HagiCode
HagiCode — агентная среда разработки. Насыщенные и удобные взаимодействия с интерфейсом делают планирование, работу агентов и проектные задачи понятными и доступными, превращая разработку в увлекательный процесс.
Насыщенные и удобные взаимодействия с интерфейсом помогают легче планировать, запускать агентов и вести проектную работу.

- УмныйРабочие процессы OpenSpec превращают намерение в исполнимый путь от предложения через дизайн и задачи до готового изменения.
- ЭффективныйМультиагентное выполнение параллельно продвигает исследование, реализацию и проверку в нескольких репозиториях и с привычными Agent CLI.
- ИнтересныйНасыщенные и удобные взаимодействия с интерфейсом делают планирование, работу агентов и проектные задачи понятными и доступными.
Скачать для Windows
Поделиться HagiCode

Превращайте идеи в готовое ПО.
HagiCode — агентная среда разработки: рабочие процессы OpenSpec планируют изменение, мультиагентное выполнение его реализует, а Hero Scenario делает долгий путь наглядным, так что идеи становятся готовым ПО.
- Умный
- Рабочие процессы OpenSpec превращают намерение в путь от предложения до готового изменения.
- Эффективный
- Мультиагентное выполнение ведёт исследование, реализацию и проверку параллельно.
- Увлекательный
- Удобный интерфейс упрощает планирование, работу агентов и проектные задачи.
© 2026 HagiCode | Powered By hagilight-starlight@0.21.0 | Branch: main | Commit: 745b50b | Built: