
Production Machine Learning
Source: https://github.com/EthicalML/awesome-production-machine-learning at
4efc0a16249c
License: MIT
Read the English original
This edition is an AI-assisted translation.


Awesome Production Machine Learning
Seção intitulada “Awesome Production Machine Learning”Este repositório reúne uma lista selecionada de bibliotecas incríveis de código aberto que ajudam a implantar, monitorar, versionar, escalar e proteger o aprendizado de máquina em produção 🚀
Você pode acompanhar as novidades seguindo este repositório no GitHub para receber, todos os meses, um resumo das novas bibliotecas de ML para produção adicionadas nas versões 🤩
Além disso, oferecemos um kit de busca que ajuda a navegar rapidamente pela cadeia de ferramentas.
Links rápidos para as seções desta página
Seção intitulada “Links rápidos para as seções desta página”Como contribuir para a lista
Seção intitulada “Como contribuir para a lista”Leia os requisitos de CONTRIBUTING.md ao enviar uma PR para nos ajudar a manter a lista organizada e atualizada — agradecemos à comunidade por apoiar seu crescimento contínuo 🚀
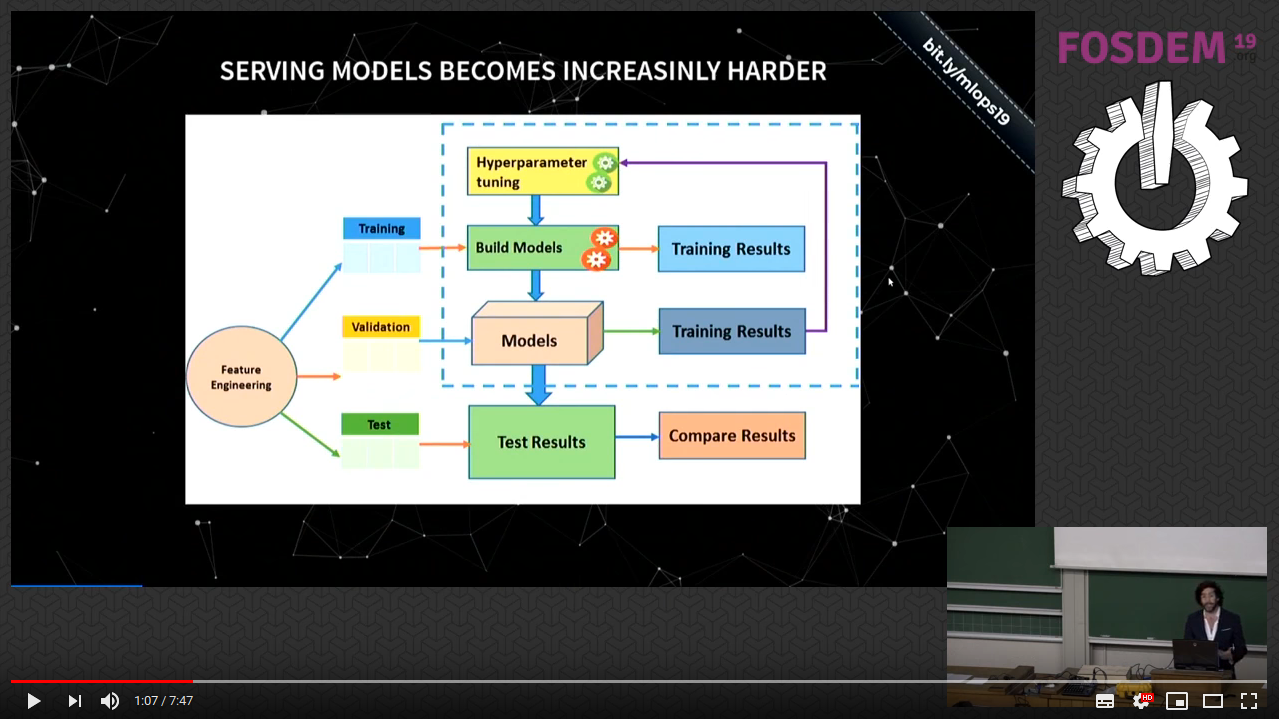
Visão geral em vídeo de 10 minutos
Seção intitulada “Visão geral em vídeo de 10 minutos”| Este vídeo de 10 minutos apresenta as motivações para as operações de aprendizado de máquina e uma visão geral de algumas ferramentas deste repositório. Este vídeo mais recente aborda uma versão atualizada, de 2024, do estado de MLOps. |
|
Quer receber atualizações recorrentes sobre este repositório e outros avanços?
Seção intitulada “Quer receber atualizações recorrentes sobre este repositório e outros avanços?”| Você pode assinar o boletim informativo Machine Learning Engineer. Junte-se a mais de 70.000 profissionais e entusiastas de ML que recebem semanalmente artigos e tutoriais selecionados sobre aprendizado de máquina em produção. |
|
| Confira também a lista Awesome Production GenAI, que reúne bibliotecas incríveis de código aberto para implantar, monitorar, versionar e escalar aplicações e sistemas de inteligência artificial generativa. |
|
Conteúdo principal
Seção intitulada “Conteúdo principal”- AIDE
 - O AIDE é um agente de engenharia de ML de código aberto que usa um algoritmo de busca em árvore para explorar, implementar e avaliar estratégias de solução para tarefas de aprendizado de máquina de forma autônoma.
- AutoGluon
 - Seleção automatizada de recursos, modelos e hiperparâmetros para dados tabulares, de imagem e texto, baseada em bibliotecas populares de aprendizado de máquina (Scikit-Learn, LightGBM, CatBoost, PyTorch, MXNet).
- Autokeras
 - Biblioteca AutoML para Keras baseada em “Auto-Keras: Efficient Neural Architecture Search with Network Morphism”.
- auto-sklearn
 - Framework para automatizar o ajuste de algoritmos e hiperparâmetros para sklearn.
- Ax
 - Ax é uma plataforma acessível e de uso geral para compreender, gerenciar, implantar e automatizar experimentos adaptativos.
- BoTorch
 - BoTorch é uma biblioteca de otimização Bayesiana criada sobre o PyTorch.
- EvalML
 - EvalML é uma biblioteca AutoML que cria, otimiza e avalia pipelines de aprendizado de máquina usando funções objetivo específicas do domínio.
- Feature Engine
 - Feature-engine é uma biblioteca Python que contém vários transformadores para criar recursos usados em modelos de aprendizado de máquina.
- Featuretools
 - Framework de código aberto para engenharia automatizada de recursos.
- FLAML
 - FLAML é uma biblioteca rápida para aprendizado de máquina automatizado e ajuste.
- HEBO
 - Conjunto de frameworks de otimização de hiperparâmetros de código aberto, incluindo a solução vencedora do NeurIPS 2020 Black-Box Optimisation Challenge, testada em tarefas de ajuste de hiperparâmetros.
- Katib
 - Sistema baseado em Kubernetes para ajuste de hiperparâmetros e busca de arquiteturas neurais.
- keras-tuner
 - Keras Tuner é um framework de otimização de hiperparâmetros distribuível e fácil de usar, que resolve os desafios da busca de hiperparâmetros. Ele facilita a definição de um espaço de busca e o uso dos algoritmos incluídos para encontrar os melhores valores.
- Optuna
 - Optuna é um framework de software para otimização automática de hiperparâmetros, projetado especialmente para aprendizado de máquina.
- OSS Vizier
 - OSS Vizier é um serviço baseado em Python para otimização de caixa-preta e pesquisa, um dos primeiros serviços de ajuste de hiperparâmetros projetados para operar em grande escala.
- Perpetual
 - Uma máquina de gradient boosting que dispensa otimização de hiperparâmetros, com um parâmetro de orçamento simples para controlar a complexidade do modelo.
- TPOT
 - Automatiza a criação de pipelines do sklearn (incluindo seleção de recursos, pré-processador etc.).
- tsfresh
 - Extração automática de recursos relevantes de séries temporais.
Otimização da computação e da comunicação
Seção intitulada “Otimização da computação e da comunicação”- Accelerate
 - Accelerate abstrai exatamente — e somente — o código boilerplate relacionado a várias GPUs/TPUs e precisão mista, mantendo inalterado o restante do código.
- Adapters
 - Adapters é uma biblioteca unificada para aprendizado por transferência modular e eficiente em parâmetros.
- Cache-DiT
 - Cache-DiT é baseado no Diffusers e oferece suporte a quase todos os DiTs, com aceleração híbrida por cache (DBCache, TaylorSeer, SCM etc.) e otimizações abrangentes de paralelismo, incluindo paralelismo de contexto, de tensores e paralelismo híbrido 2D/3D, além de compatibilidade com compilação, descarregamento para CPU e quantização.
- Colossal-AI
 - Sistema unificado de aprendizado profundo para a era dos grandes modelos, que ajuda a implantar com eficiência e rapidez o treinamento e a inferência de grandes modelos de IA.
- Composer
 - Composer é uma biblioteca PyTorch que permite treinar redes neurais com mais rapidez, menor custo e maior precisão.
- CuDF
 - Baseada no formato de memória colunar Apache Arrow, cuDF é uma biblioteca GPU de DataFrames para carregar, unir, agregar, filtrar e manipular dados de outras formas.
- CuML
 - cuML é um conjunto de bibliotecas que implementam algoritmos de aprendizado de máquina e funções primitivas matemáticas com APIs compatíveis com as de outros projetos RAPIDS.
- CuPy
 - Implementação de arrays multidimensionais compatível com NumPy para CUDA. CuPy inclui a classe central de arrays multidimensionais cupy.ndarray e muitas funções para trabalhar com ela.
- DEAP
 - Framework inovador de computação evolutiva para prototipagem rápida e teste de ideias. Busca tornar explícitos os algoritmos e transparentes as estruturas de dados. Funciona em perfeita harmonia com mecanismos de paralelização como multiprocessing e SCOOP.
- DeepEP
 - DeepEP é uma biblioteca de comunicação desenvolvida para Mixture-of-Experts (MoE) e paralelismo de especialistas (EP). Oferece kernels GPU all-to-all de alta vazão e baixa latência, também conhecidos como dispatch e combine de MoE. A biblioteca também oferece suporte a operações de baixa precisão, incluindo FP8.
- DGL
 - DGL é um pacote Python escalável, de alto desempenho e fácil de usar para aprendizado profundo em grafos.
- DLRover
 - DLRover torna o treinamento distribuído de grandes modelos de IA fácil, estável, rápido e sustentável.
- Dask
 - Framework de processamento paralelo distribuído para computações com Pandas e NumPy.
- DeepSpeed
 - DeepSpeed é uma biblioteca de otimização de aprendizado profundo que torna o treinamento e a inferência distribuídos fáceis, eficientes e eficazes.
- FlagGems
 - FlagGems é uma biblioteca de operadores genéricos de alto desempenho implementada em OpenAI Triton. Ela reúne kernels independentes de backend para acelerar o treinamento e a inferência de LLMs em diversas plataformas de hardware.
- Flashlight
 - Biblioteca de aprendizado de máquina rápida e flexível, escrita inteiramente em C++, criada pelo Facebook AI Research e pelos criadores do Torch, TensorFlow, Eigen e Deep Speech.
- Flax
 - Biblioteca e ecossistema de redes neurais para JAX, projetados para oferecer flexibilidade.
- GPUStack
 - GPUStack é um gerenciador de clusters GPU de código aberto para executar modelos de IA.
- Hivemind
 - Aprendizado profundo descentralizado em PyTorch.
- Jax
 - Transformações combináveis de programas Python+NumPy: diferenciação automática, vetorização, compilação JIT para GPU/TPU e muito mais.
- Kompute
 - Framework de computação Vulkan extremamente rápido, leve e compatível com celulares, otimizado para casos de uso avançados de processamento de dados em GPU.
- Liger Kernel
 - Liger Kernel é uma coleção de kernels Triton projetados especificamente para treinamento de LLMs.
- LightGBM
 - LightGBM é um framework de gradient boosting que usa algoritmos de aprendizado baseados em árvores.
- MLX
 - MLX é um framework de arrays para aprendizado de máquina em chips Apple silicon.
- Modin
 - Acelere seus fluxos de trabalho Pandas alterando uma única linha de código.
- NVIDIA TensorRT
 - TensorRT é uma biblioteca C++ para inferência de alto desempenho em GPUs NVIDIA e aceleradores de aprendizado profundo.
- Nevergrad
 - Nevergrad é uma plataforma de otimização sem gradientes.
- Norse
 - Norse busca aproveitar as vantagens de componentes neurais bioinspirados, que são esparsos e orientados a eventos — uma diferença fundamental em relação às redes neurais artificiais.
- Numba
 Compilador para funções numéricas e de arrays em Python.
- Optimum
 - Optimum é uma extensão do Transformers e do Diffusers que oferece ferramentas de otimização para treinar e executar modelos com máxima eficiência no hardware desejado, sem deixar de ser fácil de usar.
- PEFT
 - Os métodos de ajuste fino eficiente em parâmetros (PEFT) permitem adaptar com eficiência modelos de linguagem pré-treinados (PLMs) a diversas aplicações posteriores sem ajustar todos os parâmetros do modelo.
- PaddlePaddle
 - PaddlePaddle é um framework para treinamento de redes profundas em grande escala, usando fontes de dados distribuídas por centenas de nós.
- PyG
 - PyG (PyTorch Geometric) é uma biblioteca baseada em PyTorch que facilita a criação e o treinamento de redes neurais em grafos (GNNs) para diversas aplicações com dados estruturados.
- PyTorch Lightning
 - PyTorch Lightning pré-treina, ajusta e implanta modelos de IA em várias GPUs e TPUs sem alterar o código.
- PyTorch
 - PyTorch é uma biblioteca para desenvolver e treinar modelos de aprendizado profundo baseados em redes neurais.
- Ray
 - Ray é um framework flexível e de alto desempenho para execução distribuída de tarefas de aprendizado de máquina.
- SetFit
 - SetFit é um framework eficiente, sem prompts, para ajuste fino few-shot de Sentence Transformers.
- Sonnet
 - Sonnet é uma biblioteca baseada no TensorFlow 2 que oferece abstrações simples e combináveis para pesquisa em aprendizado de máquina.
- Streaming
 - Biblioteca de streaming de dados para treinamento eficiente de redes neurais.
- TensorFlow
 - TensorFlow é uma biblioteca líder para desenvolver e implantar aplicações de aprendizado de máquina de última geração.
- ThunderKittens
 ThunderKittens é um framework que facilita a criação de kernels rápidos de aprendizado profundo em CUDA.
- TorchOpt
 - TorchOpt é uma biblioteca eficiente para otimização diferenciável baseada em PyTorch.
- Triton
 - Triton é uma linguagem e um compilador para escrever primitivas personalizadas de aprendizado profundo altamente eficientes. Seu objetivo é oferecer um ambiente de código aberto para escrever código rápido com produtividade superior à do CUDA e mais flexibilidade que outras DSLs existentes.
- Vaex
 Vaex é uma biblioteca Python de alto desempenho para DataFrames lazy e out-of-core (semelhantes aos do Pandas), usada para visualizar e explorar grandes conjuntos de dados tabulares. Vaex usa mapeamento de memória, política de cópia zero de memória e computações lazy para obter o melhor desempenho (sem desperdício de memória).
- Vowpal Wabbit
 Vowpal Wabbit é um sistema de aprendizado de máquina que amplia as fronteiras da área com técnicas como aprendizado online, hashing, allreduce, reduções, learning2search, aprendizado ativo e interativo.
- XGBoost
 - XGBoost é uma biblioteca otimizada de gradient boosting distribuído, projetada para ser altamente eficiente, flexível e portátil.
- YDF
 - YDF (Yggdrasil Decision Forests) é uma biblioteca para treinar, avaliar, interpretar e servir modelos Random Forest, Gradient Boosted Decision Trees, CART e Isolation Forest.
- bitsandbytes
 - A biblioteca bitsandbytes é um wrapper Python leve em torno de funções CUDA personalizadas, em especial otimizadores de 8 bits, multiplicação de matrizes (LLM.int8()) e funções de quantização de 8 e 4 bits.
- einops
 - Operações de tensores flexíveis e poderosas para código legível e confiável.
- scikit-learn
 - Scikit-learn é uma poderosa biblioteca de aprendizado de máquina que oferece uma grande variedade de módulos para acesso e preparação de dados e criação de modelos estatísticos.
- snnTorch
 - snnTorch é uma biblioteca de aprendizado profundo e online com redes neurais pulsadas.
- torchdistill
 - torchdistill oferece vários métodos de destilação de conhecimento de última geração e permite criar novos experimentos simplesmente editando um arquivo de configuração YAML declarativo em vez de código Python.
- torchkeras
 A biblioteca torchkeras é uma ferramenta simples para treinar redes neurais em PyTorch no estilo do Keras.
- veScale
 - veScale é um framework nativo do PyTorch para treinamento de LLMs.
- yellowbrick
 - yellowbrick oferece gráficos de avaliação de modelos baseados em matplotlib para scikit-learn e outras bibliotecas de aprendizado de máquina.
Anotação e síntese de dados
Seção intitulada “Anotação e síntese de dados”- Argilla
 - Argilla ajuda especialistas de domínio e equipes de dados a criar conjuntos de dados de PLN melhores em menos tempo.
- cleanlab
 - Biblioteca Python para IA centrada em dados. Detecta automaticamente dados com rótulos incorretos e valores atípicos, estima o consenso e a qualidade dos anotadores em conjuntos com vários anotadores e sugere quais dados rotular novamente em seguida.
- COCO Annotator
 - Ferramenta web de segmentação de imagens para detecção de objetos, localização e pontos-chave.
- CVAT
 - CVAT (Computer Vision Annotation Tool) é a ferramenta de anotação web do OpenCV para vídeos e imagens usados por algoritmos computacionais.
- Doccano
 - Ferramenta de código aberto para anotação de textos por pessoas, com recursos para análise de sentimentos, reconhecimento de entidades nomeadas e tradução automática.
- Label Studio
 - Ferramenta multidomínio de rotulagem e anotação de dados com formato de saída padronizado.
- LightlyStudio
 - Ferramenta de código aberto para selecionar, anotar e gerenciar conjuntos de dados de visão (imagens e vídeos). Oferece seleção automática baseada em embeddings, anotação e rotulagem automática de caixas delimitadoras e segmentações.
- NeMo Curator
 - NeMo Curator é um framework acelerado por GPU para curadoria eficiente de dados para grandes modelos de linguagem.
- refinery
 - A escolha de código aberto de cientistas de dados para dimensionar, avaliar e manter dados de linguagem natural.
- SDV
 - Synthetic Data Vault (SDV) é um ecossistema de bibliotecas para geração de dados sintéticos. Permite aprender facilmente conjuntos de dados de tabela única ou múltiplas tabelas e séries temporais e, depois, gerar novos dados sintéticos com o mesmo formato e propriedades estatísticas do original.
- Semantic Segmentation Editor
 - Ferramenta de código aberto da Hitachi para rotular dados de câmeras e LIDAR.
- synthcity
 - synthcity é uma biblioteca para gerar e avaliar dados tabulares sintéticos.
- TabGAN
 - Geração de dados tabulares sintéticos usando GANs (CTGAN), modelos de difusão e LLMs, com filtragem adversarial, métricas de privacidade e integração com sklearn.
- ViPE
 - ViPE é uma ferramenta de IA espacial para anotar poses de câmera e mapas de profundidade densos a partir de vídeos brutos.
- YData Synthetic
 - YData Synthetic é um pacote para gerar dados sintéticos tabulares e de séries temporais usando modelos generativos de última geração.
Pipeline de dados
Seção intitulada “Pipeline de dados”- Apache Airflow
 - Framework de pipeline de dados em Python, com agendador, definição de DAGs e interface para visualização.
- Apache Nifi
 - Apache NiFi foi criado para fluxo de dados. Oferece suporte a grafos direcionados altamente configuráveis para roteamento e transformação de dados e lógica de mediação de sistemas.
- Argo Workflows
 - Argo Workflows é um mecanismo de workflow de código aberto e nativo de contêineres para orquestrar tarefas paralelas no Kubernetes. É implementado como uma CRD (Custom Resource Definition) do Kubernetes.
- Couler
 - Interface unificada para criar e gerenciar workflows de aprendizado de máquina em diferentes mecanismos, como Argo Workflows, Tekton Pipelines e Apache Airflow.
- DataTrove
 - DataTrove é uma biblioteca para processar, filtrar e deduplicar dados de texto em escala muito grande.
- Dagster
 - Orquestrador de dados para aprendizado de máquina, análise e ETL.
- DBT
 - Ferramenta ETL para executar transformações em data warehouses.
- Flyte
 - Plataforma de Lyft nativa da nuvem para aprendizado de máquina e processamento de dados - (Demonstração).
- Genie
 - Mecanismo de orquestração de tarefas que conecta e aciona a execução de tarefas em sistemas baseados em Hadoop.
- Hamilton
 - Hamilton é um framework de micro-orquestração para definir fluxos de dados. Executa onde quer que o Python seja executado (por exemplo, Jupyter, FastAPI, Spark, Ray e Dask). Incorpora boas práticas de engenharia de software sem exigir que você as conheça. Use-o para definir transformações de engenharia de recursos, pipelines completos de modelos e workflows de LLM. Complementa sistemas de macro-orquestração (como Kedro, Luigi, Airflow e dbt), substituindo o código dentro dessas tarefas. Inclui uma interface auto-hospedável que registra linhagem, proveniência, telemetria de execução e resumos de dados, além de criar um catálogo preenchido automaticamente, útil tanto no desenvolvimento quanto em produção.
- Instill VDP
 - Instill VDP (Versatile Data Pipeline) busca simplificar pipelines de processamento de dados do início ao fim.
- Instructor
 - Instructor facilita a obtenção de dados estruturados, como JSON, de LLMs como GPT-3.5, GPT-4, GPT-4-Vision e modelos de código aberto.
- Kedro
 - Kedro é uma ferramenta de desenvolvimento de workflows que ajuda a criar pipelines de dados robustos, escaláveis, implantáveis, reproduzíveis e versionados.
- Luigi
 - Luigi é um módulo Python para criar pipelines complexos de tarefas em lote, cuidando da resolução de dependências, gerenciamento de workflows, visualização etc.
- Metaflow
 - Framework que ajuda cientistas de dados a criar e gerenciar facilmente projetos reais de ciência de dados.
- Pachyderm
 - Framework de processamento distribuído de código aberto, baseado em Kubernetes e voltado principalmente à criação dinâmica de pipelines de aprendizado de máquina para produção - (Vídeo).
- Pixeltable
 Biblioteca Python de código aberto que oferece infraestrutura de dados declarativa e incremental para criar e gerenciar cargas de trabalho de IA multimodal.
- Prefect Core
 - Sistema de gerenciamento de workflows que facilita a inclusão de recursos semânticos nos pipelines de dados, como novas tentativas, registro em log, mapeamento dinâmico, cache e notificações de falhas.
- SeqIO
 - SeqIO é uma biblioteca para processar dados sequenciais destinados a modelos de sequência posteriores.
- Snakemake
 - Sistema de gerenciamento de workflows para análises de dados reproduzíveis e escaláveis.
- Towhee
 - Pipeline de aprendizado de máquina de uso geral para gerar vetores de embeddings usando um ou vários modelos de ML.
- unstructured
 - unstructured simplifica e otimiza o processamento de dados para LLMs, recebendo e pré-processando imagens e documentos de texto como PDFs, HTML, arquivos Word e muitos outros.
- ZenML
 - ZenML é um framework MLOps extensível e de código aberto para criar pipelines de ML reproduzíveis, com foco em rastreamento automatizado de metadados, cache e integração com muitas outras ferramentas.
Notebooks de ciência de dados
Seção intitulada “Notebooks de ciência de dados”- Apache Zeppelin
 - Notebook baseado na web que permite análises de dados interativas e orientadas por dados e documentos colaborativos com SQL, Scala e outras linguagens.
- Deepnote
 - Deepnote é uma alternativa direta ao Jupyter, com design centrado em IA, interface elegante, novos blocos e integrações de dados nativas. Use Python, R e SQL localmente em seu IDE favorito e depois amplie para a nuvem Deepnote, com colaboração em tempo real, agente Deepnote e aplicações de dados implantáveis.
- Jupyter Notebooks
 - Ambientes sandbox Python com interface web para desenvolvimento reproduzível.
- Marimo
 - Notebook Python reativo — execute experimentos reproduzíveis, rode como script, implante como aplicação e versione com git.
- Papermill
 - Papermill é uma biblioteca para parametrizar notebooks e executá-los como scripts Python.
- Polynote
 - Polynote é um ambiente experimental de notebooks poliglotas. Atualmente, oferece suporte a Scala e Python (com ou sem Spark), SQL e Vega.
- RMarkdown
 - O pacote rmarkdown é uma implementação de próxima geração do R Markdown baseada no Pandoc.
- Stencila
 - Stencila é uma plataforma para criar, colaborar e compartilhar conteúdo orientado por dados — conteúdo transparente e reproduzível.
- Voilà
 - Voilà transforma notebooks Jupyter em aplicações web independentes, que podem, por exemplo, ser usadas como painéis.
Otimização do armazenamento de dados
Seção intitulada “Otimização do armazenamento de dados”- AIStore
 - AIStore é um sistema leve de armazenamento de objetos que pode escalar linearmente a cada nó de armazenamento adicionado e tem foco especial em aprendizado profundo em escala de petabytes.
- Alluxio
 - Sistema virtual de armazenamento distribuído que preenche a lacuna entre frameworks de computação e sistemas de armazenamento.
- Apache Arrow
 - Representação colunar de dados em memória, compatível com Pandas, sistemas baseados em Hadoop etc.
- Apache Druid
 - Banco de dados de análise em tempo real de alto desempenho. Consulte este artigo para uma introdução.
- Apache Hudi
 - Hudi é uma plataforma transacional de data lake que leva ao data lake as principais funcionalidades de data warehouses e bancos de dados. É ideal para cargas de trabalho de streaming e também permite criar pipelines em lote incrementais eficientes. Oferece suporte a mecanismos de consulta populares como Spark, Flink, Presto, Trino e Hive. Saiba mais aqui.
- Apache Iceberg
 - Iceberg é um formato de alto desempenho compatível com ACID, criado para enormes tabelas analíticas (com dezenas de petabytes de dados). Traz a confiabilidade e a simplicidade de tabelas SQL para big data e permite que mecanismos como Spark, Trino, Flink, Presto, Hive e Impala trabalhem com segurança nas mesmas tabelas ao mesmo tempo. Saiba mais aqui.
- Apache Ignite
 - Banco de dados distribuído centrado em memória, plataforma de cache e processamento para cargas transacionais, analíticas e de streaming, com velocidade em memória na escala de petabytes - Demonstração.
- Apache Parquet
 - Representação colunar de dados em disco, compatível com Pandas, sistemas baseados em Hadoop etc.
- Apache Pinot
 - Armazenamento OLAP distribuído em tempo real. Aqui há uma comparação dos sistemas OLAP de código aberto para big data: ClickHouse, Druid e Pinot.
- Casibase
 - Casibase é um banco de conhecimento RAG (Retrieval-Augmented Generation) semelhante ao LangChain, com interface web e SSO empresarial.
- Chroma
 - Chroma é um banco de dados de embeddings de código aberto.
- ClickHouse
 - ClickHouse é um sistema de gerenciamento de banco de dados colunar de código aberto.
- Delta Lake
 - Delta Lake é uma camada de armazenamento que oferece transações ACID escaláveis ao Apache Spark e a outros mecanismos de big data.
- EdgeDB
 - Gel potencializa o Postgres com um modelo de dados moderno, consultas de grafos, autenticação, soluções de IA e muito mais.
- GPTCache
 - GPTCache é uma biblioteca para criar cache semântico para consultas a grandes modelos de linguagem.
- InfluxDB
 Armazenamento de dados escalável para métricas, eventos e análises em tempo real.
- Milvus
 Milvus é um banco de dados vetorial de código aberto e nativo da nuvem, criado para gerenciar vetores de embeddings gerados por modelos de aprendizado de máquina e redes neurais.
- Marqo
 Marqo é um mecanismo de busca vetorial de ponta a ponta.
- pgvector
 pgvector oferece busca por similaridade vetorial no Postgres.
- PostgresML
 PostgresML é uma extensão de aprendizado de máquina para PostgreSQL que permite treinar e executar inferências em dados de texto e tabulares usando consultas SQL.
- Redis
 Redis é um armazenamento de dados em memória e de código aberto que oferece busca por similaridade vetorial, tornando-o adequado a aplicações de IA/ML como busca semântica e sistemas de recomendação.
- Safetensors
 Forma simples e segura de armazenar e distribuir tensores.
- TimescaleDB
 Banco de dados SQL de séries temporais de código aberto, otimizado para ingestão rápida e consultas complexas, distribuído como extensão do PostgreSQL - (Vídeo).
- Weaviate
 - Mecanismo de busca vetorial de baixa latência (GraphQL, RESTful), com suporte pronto para uso a diferentes tipos de mídia. Os módulos incluem busca semântica, perguntas e respostas, classificação, modelos personalizáveis (PyTorch/TensorFlow/Keras) e muito mais.
- Zarr
 - Implementação Python de arrays N-dimensionais fragmentados e compactados, projetados para computação paralela.
Processamento de fluxos de dados
Seção intitulada “Processamento de fluxos de dados”- Apache Beam
 Apache Beam é um modelo unificado de programação para processamento em lote e streaming.
- Apache Flink
 - Framework de processamento de streaming de código aberto com recursos avançados para processamento de streams e lotes.
- Apache Kafka
 - Biblioteca cliente Kafka para criar aplicações e microsserviços cuja entrada e saída são armazenadas em clusters Kafka.
- Apache Samza
 - Framework distribuído de processamento de streams. Usa Apache Kafka para mensagens e Apache Hadoop YARN para oferecer tolerância a falhas, isolamento de processadores, segurança e gerenciamento de recursos.
- Apache Spark
 - Processamento de streams em microlotes usando o framework Apache Spark como backend, com semântica stateful de exatamente uma vez.
- Bytewax
 - Framework flexível de processamento stateful de streams, centrado em Python e baseado em um mecanismo Rust.
- FastStream
 - Framework moderno de streaming em Python, independente de broker, com suporte aos protocolos Apache Kafka, RabbitMQ e NATS. Inspirado no FastAPI e facilmente integrável a outros frameworks web.
- MOA
 - MOA (Massive Online Analysis) é um framework de código aberto para mineração de streams de big data.
- MosaicML Streaming - Streaming rápido e determinístico de grandes conjuntos de dados em armazenamento na nuvem para treinamento distribuído de modelos.
- RisingWave
 - Banco de dados SQL distribuído para streaming que unifica processamento de streams e serviço de baixa latência, ideal para criar e disponibilizar recursos de aprendizado de máquina online.
- TensorStore
 - Biblioteca para leitura e gravação de grandes arrays multidimensionais.
Implantação e serviço
Seção intitulada “Implantação e serviço”- Agenta
 - Agenta oferece ferramentas de ponta a ponta para todo o workflow LLMOps: criação (playground de LLM e avaliação), implantação (gerenciamento de prompts e configurações) e observabilidade e rastreamento de LLMs.
- AirLLM
 - AirLLM otimiza o uso de memória na inferência e permite executá-la em grandes modelos de linguagem de 70 bilhões de parâmetros em uma única placa GPU de 4 GB, sem quantização, destilação ou poda.
- AITemplate
 - AITemplate (AIT) é um framework Python que converte redes neurais profundas em código C++ CUDA (GPU NVIDIA) / HIP (GPU AMD) para serviço de inferência extremamente rápido.
- BentoML
 - BentoML é um framework de código aberto para servir modelos de ML com alto desempenho.
- Bifrost
 - Gateway de IA que oferece uma única API compatível com OpenAI para mais de 23 provedores de LLM, com alternativas automáticas, balanceamento de carga, cache semântico, controle de orçamento e métricas Prometheus.
- BISHENG
 - BISHENG é uma plataforma aberta de DevOps para aplicações com LLM, voltada a cenários empresariais.
- CosmoEdge
 - Mecanismo C++ de IA de vídeo de borda para implantações em produção, que combina ingestão RTSP, inferência de CV/VLM, orquestração visual, alarmes e entrega de eventos em NPUs Sophon e Rockchip.
- DeepDetect
 - Servidor de aprendizado de máquina para produção para modelos TensorFlow, XGBoost e Cafe, escrito em C++ e mantido pela Jolibrain.
- Dynamo
 - NVIDIA Dynamo é um framework de inferência de alta vazão e baixa latência para servir modelos de IA generativa e de raciocínio em ambientes distribuídos com vários nós.
- exo
 - exo ajuda a executar seu cluster de IA em casa com dispositivos do dia a dia.
- Genkit
 - Genkit é um framework de código aberto para criar aplicações com IA usando padrões familiares e centrados em código. Facilita o desenvolvimento, a integração e o teste de recursos de IA com observabilidade e avaliações.
- GoModel
 - GoModel é um gateway de IA auto-hospedado, escrito em Go, que oferece uma API unificada compatível com OpenAI para OpenAI, Anthropic, Gemini, Groq, xAI, Ollama e outros provedores, com roteamento, acompanhamento de uso, limites de taxa e proteções.
- Inference
 - Servidor de inferência rápido e pronto para produção para visão computacional, com implantação de muitas arquiteturas de modelos populares e modelos ajustados. Com Inference, é possível implantar modelos como YOLOv5, YOLOv8, CLIP, SAM e CogVLM em seu próprio hardware usando Docker.
- Infinity
 - Infinity é uma API REST de alta vazão e baixa latência para servir embeddings de texto, modelos de reranking e CLIP.
- LiteLLM
 - LiteLLM é um SDK Python e servidor proxy (gateway LLM) para chamar mais de 100 APIs de LLM no formato OpenAI: Bedrock, Azure, OpenAI, VertexAI, Cohere, Anthropic, Sagemaker, HuggingFace, Replicate e Groq.
- LiteRT
 - LiteRT (anteriormente TensorFlow Lite) é o runtime de alto desempenho do Google para inferência de IA no dispositivo, permitindo implantar modelos de aprendizado de máquina em dispositivos móveis, embarcados e de borda.
- LiteRT-LM
 - LiteRT-LM é o framework de inferência de alto desempenho e pronto para produção do Google para implantar grandes modelos de linguagem em dispositivos de borda, com suporte multiplataforma para Android, iOS, Web, Desktop e IoT.
- LitServe
 - LitServe é um mecanismo flexível para servir modelos de IA, baseado no FastAPI. Oferece suporte a mecanismos personalizados de inferência para modelos, agentes, sistemas multimodais, RAG e pipelines complexos de ML.
- jevos
 - jevOS é uma alternativa de código aberto ao Jev da TypeSafe para decisões sim/não: um classificador binário de 1 bilhão de parâmetros (GGUF, llama.cpp), servido por uma API HTTP FastAPI compatível com Jev e executado somente em CPU em um laptop.
- Jina-serve
 - Jina-serve é um framework para criar e implantar serviços de IA que se comunicam por gRPC, HTTP e WebSockets.
- Kiln
 - Kiln é uma ferramenta de código aberto para ajuste fino de modelos LLM, geração de dados sintéticos e colaboração em conjuntos de dados.
- KServe
 - KServe oferece uma definição de recurso personalizado do Kubernetes para servir modelos preditivos e generativos de ML.
- KTransformers
 - KTransformers é um framework flexível para experimentar otimizações de inferência de LLM de última geração.
- Langtrace
 - Langtrace é uma ferramenta de observabilidade de ponta a ponta, de código aberto e baseada em OpenTelemetry, para aplicações com LLM. Oferece rastreamento em tempo real, avaliações e métricas para LLMs populares, frameworks de LLM, bancos de dados vetoriais e muito mais.
- Lepton AI
 - A biblioteca Python LeptonAI facilita a criação de um serviço de IA a partir de código Python.
- LightLLM
 - LightLLM é um framework Python para inferência e serviço de LLMs, conhecido por seu design leve, fácil escalabilidade e alto desempenho.
- llama.cpp
 - llama.cpp é uma biblioteca de software de código aberto que executa inferência em diversos grandes modelos de linguagem, como o Llama.
- llmfit
 - Ferramenta de terminal que ajusta os modelos LLM ao tamanho da RAM, CPU e GPU do sistema. Detecta o hardware, pontua cada modelo em qualidade, velocidade, adequação e contexto e indica quais funcionarão bem na máquina.
- LMCache
 - LMCache é uma camada de cache KV de alto desempenho que acelera a inferência de LLMs.
- LMDeploy
 - LMDeploy é um conjunto de ferramentas para comprimir, implantar e servir LLMs.
- LM Studio
 - LM Studio é uma ferramenta para implantar modelos LLM localmente, mesmo em um computador relativamente modesto, desde que atenda aos requisitos mínimos.
- LocalAI
 - LocalAI é uma API REST substituta compatível com as especificações da API OpenAI para inferência local.
- MindsDB
 - MindsDB é a plataforma para criar, servir e ajustar modelos em tempo real a partir de bancos de dados, armazenamentos vetoriais e dados de aplicações.
- mini-sglang
 - mini-sglang é um framework leve e eficiente para servir grandes modelos de linguagem.
- MLRun
 - MLRun é um framework MLOps aberto para criar e gerenciar rapidamente aplicações contínuas de ML e IA generativa ao longo de todo o ciclo de vida.
- MLServer
 - Servidor de inferência para modelos de aprendizado de máquina, com suporte a vários frameworks, serviço de múltiplos modelos e muito mais.
- Model Runner
 - Docker Model Runner facilita o gerenciamento, a execução e o serviço de modelos de IA usando Docker, com suporte a LLMs e outros modelos de IA obtidos diretamente do Docker Hub ou de qualquer registro compatível com OCI.
- Mosec
 - Servidor de modelos com várias etapas de pipeline e acelerado por Rust, com batching dinâmico e outros recursos. Fácil de implementar e implantar como microsserviços.
- nano-vllm
 - nano-vllm é uma implementação leve do vLLM, criada do zero, que oferece inferência offline rápida com otimizações como cache de prefixo, paralelismo de tensores e CUDA Graph.
- nndeploy
 - Framework de implantação de IA fácil de usar e de alto desempenho.
- Nuclio
 - Framework “serverless” de alto desempenho, voltado a cargas de trabalho intensivas em dados, E/S e computação. Integra-se bem com ferramentas populares de ciência de dados, como Jupyter e Kubeflow; oferece suporte a várias fontes de dados e streaming e à execução em CPUs e GPUs.
- OpenLLM
 - OpenLLM permite executar qualquer LLM de código aberto (Llama 3.1, Qwen2, Phi3 e outros) ou modelos personalizados como APIs compatíveis com OpenAI com um único comando.
- OpenVINO
 - OpenVINO é um conjunto de ferramentas de código aberto para otimizar e implantar inferência de IA.
- Open WebUI
 - Open WebUI é uma plataforma de IA auto-hospedada extensível, repleta de recursos e fácil de usar, projetada para funcionar totalmente offline. Compatível com vários executores de LLM, como Ollama, e APIs compatíveis com OpenAI; tem mecanismo de inferência integrado para RAG e é uma poderosa solução de implantação de IA.
- OptiLLM
 - OptiLLM é um proxy de inferência otimizador compatível com a API OpenAI que implementa mais de 20 técnicas de última geração para melhorar muito a precisão e o desempenho de LLMs em tarefas de raciocínio, sem exigir treinamento ou ajuste fino dos modelos.
- PowerInfer
 - PowerInfer é um mecanismo de inferência de LLM para CPU/GPU que aproveita a localidade de ativações no dispositivo.
- Prompt2Model
 - Prompt2Model recebe a descrição de uma tarefa em linguagem natural (como os prompts do ChatGPT) e treina um modelo pequeno e especializado, adequado à implantação.
- RamaLama
 - RamaLama é uma ferramenta de código aberto que simplifica o uso local e o serviço de modelos de IA para inferência por meio de contêineres OCI, eliminando a necessidade de configurar o sistema host.
- RunAnywhere
 - RunAnywhere é um SDK pronto para produção para executar modelos de IA (LLMs, conversão de fala em texto e texto em fala) no dispositivo em iOS, Android, React Native e Flutter, permitindo aplicações móveis de IA privadas, offline e rápidas.
- Seldon Core
 - Plataforma de código aberto para implantação de modelos de aprendizado de máquina no Kubernetes - (Vídeo).
- SGLang
 - SGLang é um framework rápido para servir grandes modelos de linguagem e modelos de linguagem visual.
- SIE
 - Servidor de inferência de código aberto e cluster de produção para embeddings, reranking e extração. Inclui mais de 85 modelos pré-configurados para modalidades densas, esparsas e multivetoriais, visão, rerankers e extratores. Vem com Helm, escalonamento automático KEDA, painéis Grafana e Terraform.
- SkyPilot
 - SkyPilot é um framework para executar LLMs, IA e tarefas em lote em qualquer nuvem, oferecendo máxima economia de custos, maior disponibilidade de GPUs e execução gerenciada.
- Tensorflow Serving
 - Framework de alto desempenho para servir modelos TensorFlow via protocolo gRPC, capaz de processar 100 mil solicitações por segundo por núcleo.
- torchtune
 - torchtune é uma biblioteca PyTorch para criar, pós-treinar e experimentar facilmente com LLMs.
- Transformer Lab
 - Transformer Lab é um espaço de trabalho de código aberto para LLMs, usado para ajustar, avaliar, exportar e testar modelos localmente em diferentes mecanismos e plataformas de inferência.
- Triton Inference Server
 - Triton é um software de serviço de código aberto e alto desempenho para implantar modelos de IA de qualquer framework em GPU e CPU, maximizando a utilização.
- Vercel AI
 - Vercel AI é um kit de ferramentas TypeScript para criar aplicações com IA usando frameworks populares como Next.js, React, Svelte e Vue, e runtimes como Node.js.
- Vespa
 - Pesquise, execute inferências e organize vetores, tensores, texto e dados estruturados no momento do serviço e em qualquer escala.
- vLLM
 - vLLM é um mecanismo de inferência e serviço para LLMs com alta vazão e uso eficiente de memória.
Avaliação e monitoramento
Seção intitulada “Avaliação e monitoramento”- AlpacaEval
 - AlpacaEval é um avaliador automático de modelos de linguagem que seguem instruções.
- ANN-Benchmarks
 - ANN-Benchmarks é um ambiente de benchmark para algoritmos de busca aproximada de vizinhos mais próximos.
- ARES
 - ARES é um framework para avaliar automaticamente modelos de Retrieval-Augmented Generation (RAG).
- BEIR
 - BEIR é um benchmark heterogêneo com diversas tarefas de recuperação de informação. Também oferece um framework comum e simples para avaliar modelos de recuperação baseados em PLN no benchmark.
- Code Generation LM Evaluation Harness
 - Code Generation LM Evaluation Harness é um framework para avaliar modelos de geração de código.
- COMET
 - COMET é um framework de código aberto para avaliação de aprendizado de máquina.
- C-Eval
 - C-Eval é um conjunto abrangente de avaliação em chinês para modelos de base.
- Deepchecks
 - Deepchecks é uma solução holística de código aberto para todas as necessidades de validação de IA e ML, que permite testar minuciosamente dados e modelos desde a pesquisa até a produção.
- DeepEval
 - DeepEval é um framework de avaliação de código aberto e fácil de usar para aplicações com LLM.
- EvalAI
 - EvalAI é uma plataforma de código aberto para avaliar e comparar algoritmos de IA em grande escala.
- Evalchemy
 - Evalchemy é um kit de ferramentas unificado e fácil de usar para avaliar modelos de linguagem pós-treinados.
- EvalPlus
 - EvalPlus é um framework robusto de avaliação de LLMs para código, com benchmarks HumanEval+ e MBPP+ ampliados, avaliação de eficiência (EvalPerf) e um kit de ferramentas seguro e extensível.
- Evals
 - Evals é um framework para avaliar modelos da OpenAI e um registro de código aberto de benchmarks.
- EvalScope
 - EvalScope é um framework simplificado e personalizável para avaliação eficiente de grandes modelos e benchmarking de desempenho.
- Evaluate
 - Evaluate é uma biblioteca que facilita e padroniza a avaliação, a comparação de modelos e a comunicação do desempenho.
- Evidently
 - Evidently é um framework de código aberto para avaliar, testar e monitorar sistemas de ML e com tecnologia LLM.
- Future AGI
 - Plataforma completa, auto-hospedável e de código aberto para engenharia e otimização de agentes, que unifica rastreamentos, avaliações, simulações, conjuntos de dados, gateway e proteções para aplicações com LLMs e agentes de IA.
- GAOKAO-Bench
 - GAOKAO-Bench é um framework de avaliação que usa questões do Exame Nacional de Admissão à Universidade da China (GAOKAO) como conjunto de dados para avaliar compreensão de linguagem e raciocínio lógico de grandes modelos.
- Giskard
 - Giskard é uma biblioteca Python de código aberto que detecta automaticamente problemas de desempenho, viés e segurança em aplicações de IA.
- guidellm
 - guidellm é uma ferramenta de benchmarking e avaliação de desempenho para sistemas de inferência de grandes modelos de linguagem.
- Harbor
 - Harbor é um framework para avaliar e otimizar agentes e modelos de linguagem, com suporte a experimentos paralelos em ambientes de contêiner e gerenciamento integrado de benchmarks e ambientes.
- HumanEval
 - HumanEval é um benchmark que avalia a correção funcional de modelos de geração de código usando problemas de programação em Python com testes unitários.
- Helicone
 - Helicone é uma plataforma completa e de código aberto para desenvolvedores de LLMs.
- HELM
 - HELM (Holistic Evaluation of Language Models) oferece ferramentas para avaliação holística de modelos de linguagem, incluindo conjuntos de dados padronizados, API unificada para vários modelos, métricas diversas, perturbações de viés, framework para construção de prompts e servidor proxy para acesso unificado aos modelos.
- Inspect
 - Inspect é um framework para avaliação de grandes modelos de linguagem.
- IsaacLab-Arena
 - IsaacLab-Arena é uma extensão de código aberto do NVIDIA Isaac Lab para criar ambientes combináveis e avaliar políticas robóticas em grande escala.
- JiWER
 - JiWER é um pacote Python simples e rápido para avaliar um sistema de reconhecimento automático de fala.
- Laminar
 - Laminar é uma plataforma de código aberto para rastrear, avaliar, rotular e analisar dados de LLMs em produtos de IA.
- Langfuse
 - Langfuse é uma solução de observabilidade e análise para aplicações baseadas em LLMs.
- LangTest
 - LangTest é um kit de ferramentas abrangente para avaliação de modelos de PLN.
- Language Model Evaluation Harness
 - Language Model Evaluation Harness é um framework para testar modelos de linguagem generativa em grande número de tarefas de avaliação diferentes.
- LangWatch
 - LangWatch é uma interface visual para DSPy e uma plataforma completa de LLM Ops para monitorar, experimentar, medir e aprimorar pipelines de LLM, com um modelo de distribuição fair-code.
- Latitude
 - Latitude é uma plataforma de código aberto para observabilidade de agentes de IA, com busca semântica de rastreamentos e acompanhamento de problemas.
- LightEval
 - LightEval é um conjunto leve de ferramentas para avaliação de LLMs.
- lmms-eval
 - lmms-eval é um framework de avaliação cuidadosamente desenvolvido para avaliar LMMs de forma consistente e eficiente.
- Melting Pot
 - Melting Pot é um conjunto de cenários de teste para aprendizado por reforço multiagente.
- Meta-World
 - Meta-World é um benchmark simulado de código aberto para meta-aprendizado por reforço e aprendizado multitarefa, composto por 50 tarefas distintas de manipulação robótica.
- mir_eval
 - mir_eval é uma biblioteca Python que oferece uma maneira transparente, padronizada e simples de avaliar tarefas de recuperação de informações musicais.
- MLPerf Inference
 - MLPerf Inference é um conjunto de benchmarks para medir a velocidade com que sistemas executam modelos em vários cenários de implantação.
- Massive Text Embedding Benchmark - Massive Text Embedding Benchmark (MTEB) é um framework abrangente de avaliação que mede o desempenho de modelos de embeddings de texto em diversas tarefas e idiomas: 8 tarefas de embedding, 58 conjuntos de dados e 112 idiomas.
- NannyML
 - NannyML é uma biblioteca que estima o desempenho de modelos após a implantação (sem acesso aos alvos), detecta desvios de dados e relaciona de forma inteligente alertas de desvio a mudanças no desempenho dos modelos.
- OGB
 - Open Graph Benchmark (OGB) é uma coleção de conjuntos de dados de benchmark, carregadores de dados e avaliadores para aprendizado de máquina em grafos.
- Ollama Grid Search
 - Ollama Grid Search automatiza a seleção dos melhores modelos, prompts ou parâmetros de inferência para um caso de uso, permitindo testar combinações e inspecionar visualmente os resultados.
- onWatch
 - onWatch é uma CLI Go leve que acompanha em tempo real o uso de cotas de APIs de IA em vários provedores (Anthropic Pro/Max Plans, Codex, Gemini CLI, Synthetic, Z.ai, GitHub Copilot, MiniMax Coding/Token Plan, Antigravity e OpenRouter), com projeções de consumo, gráficos históricos e acompanhamento por ciclo.
- OpenCompass
 - OpenCompass é uma plataforma de avaliação de LLMs compatível com ampla variedade de modelos (LLaMA, LLaMa2, ChatGLM2, ChatGPT, Claude etc.) e mais de 50 conjuntos de dados.
- OpenLIT
 - OpenLIT é uma plataforma de engenharia de IA de código aberto que simplifica workflows de LLM com observabilidade, monitoramento, proteções, avaliações e integrações perfeitas.
- OpenLLMetry
 - OpenLLMetry oferece aos desenvolvedores visibilidade detalhada de aplicações com grandes modelos de linguagem, por meio de monitoramento de desempenho, rastreamento de execução e recursos de depuração.
- Opik
 - Opik é uma plataforma de código aberto para avaliar, testar e monitorar aplicações com LLM.
- Overcooked-AI
 - Overcooked-AI é um ambiente de benchmark para desempenho de tarefas totalmente cooperativas entre pessoas e IA, baseado no popular videogame Overcooked.
- Phoenix
 - Phoenix é uma plataforma de observabilidade de IA de código aberto voltada a experimentação, avaliação e solução de problemas.
- Promptfoo
 - Framework de red teaming e avaliação de LLMs para testar jailbreaks, injeção de prompts e outras vulnerabilidades, com integração a CI/CD.
- Prometheus-Eval
 - RagaAI Catalyst é uma plataforma abrangente para aprimorar o gerenciamento e a otimização de projetos com LLM.
- RagaAI Catalyst
 - Prometheus-Eval é uma coleção de ferramentas para treinar, avaliar e usar modelos de linguagem especializados em avaliar outros modelos de linguagem.
- Ragas
 - Ragas é um framework para avaliar pipelines RAG.
- RewardBench
 - RewardBench é um benchmark para avaliar os recursos e a segurança de modelos de recompensa.
- RLBench
 - RLBench é um ambicioso ambiente de aprendizado e benchmark em grande escala para facilitar pesquisas em áreas de manipulação guiada por visão, incluindo aprendizado por reforço, por imitação, multitarefa, visão computacional geométrica e, em especial, aprendizado few-shot.
- SimplerEnv
 - SimplerEnv é um ambiente de avaliação simulado para políticas de manipulação em configurações de robôs reais.
- SwanLab
 - SwanLab é uma ferramenta para acompanhar e visualizar o treinamento de IA.
- Speech-to-Text Benchmark
 - Speech-to-Text Benchmark é um framework minimalista e extensível para comparar diferentes mecanismos de conversão de fala em texto.
- TensorFlow Model Analysis
 - TensorFlow Model Analysis (TFMA) é uma biblioteca para avaliar modelos TensorFlow em grandes volumes de dados de forma distribuída, usando as mesmas métricas definidas no treinamento.
- TorchBench
 - TorchBench é uma coleção de benchmarks de código aberto usados para avaliar o desempenho do PyTorch.
- TruLens
 - TruLens oferece um conjunto de ferramentas para avaliar e acompanhar experimentos com LLMs.
- TrustLLM
 - TrustLLM é um framework abrangente para avaliar a confiabilidade de grandes modelos de linguagem, com princípios, pesquisas e benchmarks.
- VBench
 - VBench é um conjunto abrangente de benchmarks para modelos generativos de vídeo.
- VLMEvalKit
 - VLMEvalKit é um kit de ferramentas de código aberto para avaliar grandes modelos de linguagem visual (LVLMs).
Explicabilidade e equidade
Seção intitulada “Explicabilidade e equidade”- Aequitas
 - Kit de ferramentas de auditoria de viés de código aberto para cientistas de dados, pesquisadores de aprendizado de máquina e formuladores de políticas, que audita modelos de ML em busca de discriminação e viés e ajuda a tomar decisões informadas e equitativas sobre o desenvolvimento e a implantação de ferramentas preditivas de avaliação de risco.
- AI Explainability 360
 - Interpretabilidade e explicabilidade de dados e modelos de aprendizado de máquina, com um conjunto abrangente de algoritmos que cobre diferentes dimensões das explicações e métricas de explicabilidade substitutas.
- AI Fairness 360
 - Conjunto abrangente de métricas de equidade para conjuntos de dados e modelos de aprendizado de máquina, explicações dessas métricas e algoritmos para reduzir vieses nos dados e modelos.
- Alibi
 - Alibi é uma biblioteca Python de código aberto para inspeção e interpretação de modelos de aprendizado de máquina. Seu foco inicial são explicações de modelos caixa-preta baseadas em instâncias.
- captum
 - Biblioteca de interpretabilidade e compreensão de modelos para PyTorch, desenvolvida pelo Facebook. Inclui implementações de uso geral de gradientes integrados, mapas de saliência, SmoothGrad, VarGrad e outros recursos para modelos PyTorch.
- Fairlearn
 - Fairlearn é um kit de ferramentas Python para avaliar e reduzir a injustiça em modelos de aprendizado de máquina.
- InterpretML
 - InterpretML é um pacote de código aberto para treinar modelos interpretáveis e explicar sistemas caixa-preta.
- Lightly
 - Framework Python para aprendizado autossupervisionado em imagens. As representações aprendidas podem ser usadas para analisar a distribuição de dados sem rótulos e reequilibrar conjuntos de dados.
- LOFO Importance
 - LOFO (Leave One Feature Out) Importance calcula a importância de um conjunto de recursos com base em uma métrica e modelo escolhidos, removendo cada recurso individualmente e avaliando o desempenho do modelo com um esquema de validação e a métrica selecionados.
- mljar-supervised
 - Pacote Python para AutoML em dados tabulares, com engenharia de recursos, ajuste de hiperparâmetros, explicações e documentação automática.
- Quantus
 - Quantus é um kit de ferramentas de IA explicável para avaliação responsável de explicações de redes neurais.
- SHAP
 - SHapley Additive exPlanations oferece uma abordagem unificada para explicar a saída de qualquer modelo de aprendizado de máquina.
- SHAPash
 - Shapash é uma biblioteca Python que oferece vários tipos de visualização com rótulos explícitos que todos podem entender.
- WhatIf
 - Interface fácil de usar para aprofundar a compreensão de um modelo de ML caixa-preta de classificação ou regressão.
Repositório de recursos
Seção intitulada “Repositório de recursos”- FEAST
 - Feast (Feature Store) é um repositório de recursos de código aberto para aprendizado de máquina. É o caminho mais rápido para gerenciar a infraestrutura existente e colocar dados analíticos em produção para treinamento de modelos e inferência online.
- Featureform
 - Repositório virtual de recursos. Integra-se à infraestrutura existente. Aprovado por cientistas de dados. Descoberta, governança, linhagem e colaboração a uma instalação de pip de distância. Compatível com pandas, Python, Spark e SQL, além de integrações com os principais provedores de nuvem.
- Hopsworks Feature Store
 - Feature Store offline/online para ML (Vídeo).
Detecção de anomalias de nível industrial
Seção intitulada “Detecção de anomalias de nível industrial”- Alibi Detect
 - alibi-detect é um pacote Python voltado à detecção de valores atípicos, ataques adversariais e desvios de conceito.
- Darts
 - Darts é uma biblioteca fácil de usar para previsão e detecção de anomalias em séries temporais.
- Deequ
 - Biblioteca baseada no Apache Spark para definir “testes unitários para dados”, que medem a qualidade de grandes conjuntos de dados.
- PyOD
 - Kit de ferramentas Python para detecção escalável de valores atípicos (detecção de anomalias).
- TFDV
 - TFDV (TensorFlow Data Validation) é uma biblioteca para explorar e validar dados de aprendizado de máquina.
Visão computacional de nível industrial
Seção intitulada “Visão computacional de nível industrial”- CameraTraps
 - CameraTraps (PyTorch Wildlife) é um framework colaborativo de aprendizado profundo para análise de imagens da vida selvagem, com modelos de detecção e classificação treinados em grandes conjuntos de dados de câmeras-armadilha.
- Deep Lake
 - Deep Lake é uma infraestrutura de dados otimizada para visão computacional.
- DeepForest
 - DeepForest é um pacote Python para treinar modelos e prever copas individuais e espécies de árvores em imagens aéreas RGB usando aprendizado profundo.
- Detectron2
 - Detectron2 é a biblioteca de próxima geração do Facebook AI Research, com algoritmos de detecção e segmentação de última geração.
- Kornia
 - Kornia é uma biblioteca diferenciável de visão computacional baseada em PyTorch, com um rico conjunto de algoritmos diferenciáveis de processamento de imagens e visão geométrica.
- libcom
 - libcom é um kit de ferramentas para composição de imagens.
- LightlyTrain
 - Pré-treine modelos de visão computacional em dados sem rótulos para aplicações industriais.
- MMCV
 - MMCV é uma biblioteca fundamental de visão computacional do OpenMMLab, com funcionalidades essenciais como processamento de imagens e vídeos, transformação e aumento de dados, arquiteturas CNN e operações CUDA otimizadas.
- SuperGradients
 - SuperGradients é uma biblioteca de código aberto para treinar modelos de visão computacional baseados em PyTorch.
- supervision
 - Supervision é uma biblioteca Python para gerenciar pipelines de visão computacional com eficiência, oferecendo ferramentas de anotação, visualização e monitoramento de modelos.
- VideoSys
 - VideoSys oferece suporte a diversos modelos de difusão e técnicas de aceleração, permitindo executá-los mais rapidamente e com menor consumo de memória.
Recuperação de informação de nível industrial
Seção intitulada “Recuperação de informação de nível industrial”- AutoRAG
 - AutoRAG é uma ferramenta AutoML para RAG que encontra automaticamente o pipeline RAG ideal para seus dados.
- BGE
 - BGE cria um kit de ferramentas completo para recuperação em busca e RAG.
- EmbedAnything
 - EmbedAnything é um pipeline de embeddings minimalista, leve e de alto desempenho, desenvolvido em Rust para gerar embeddings de texto, imagens, áudio, PDFs e outras mídias, com suporte a embeddings densos, esparsos, ONNX e de interação tardia.
- Faiss
 - Faiss é uma biblioteca para busca eficiente por similaridade e agrupamento de vetores densos.
- GraphRAG
 - GraphRAG é um conjunto de pipelines e transformações de dados projetado para extrair dados estruturados e significativos de texto não estruturado usando LLMs.
- HippoRAG
 - HippoRAG é um novo framework de geração aumentada por recuperação (RAG), inspirado na neurobiologia da memória humana de longo prazo, que permite aos LLMs integrar continuamente conhecimento de documentos externos.
- JamAI Base
 - JamAI Base é uma plataforma backend de RAG de código aberto que integra um banco de dados incorporado (SQLite) e um banco vetorial incorporado (LanceDB), com recursos gerenciados de memória e RAG. Oferece orquestração e gerenciamento integrados de LLMs, embeddings vetoriais e rerankers, acessíveis por uma interface intuitiva semelhante a uma planilha e uma API REST simples.
- LangExtract
 - LangExtract é uma biblioteca Python que usa LLMs para extrair informações estruturadas de documentos de texto não estruturados com base em instruções definidas pelo usuário. Processa materiais como anotações clínicas e relatórios, identificando e organizando detalhes importantes e garantindo que os dados extraídos correspondam ao texto-fonte.
- LightRAG
 - Framework simples e rápido de geração aumentada por recuperação.
- llmware
 - llmware oferece um framework unificado para criar aplicações baseadas em LLM (como RAG e agentes), usando modelos pequenos e especializados que podem ser implantados com privacidade, integrados com segurança a fontes de conhecimento empresariais e ajustados de forma econômica a qualquer processo de negócios.
- Mem0
 - Mem0 aprimora assistentes e agentes de IA com uma camada de memória inteligente, permitindo interações personalizadas.
- NGT
 - NGT oferece comandos e uma biblioteca para buscas rápidas aproximadas de vizinhos mais próximos em grandes volumes de dados vetoriais de alta dimensão.
- NMSLIB
 - Non-Metric Space Library (NMSLIB): biblioteca eficiente de busca por similaridade e kit de ferramentas para avaliar métodos k-NN em espaços não métricos genéricos.
- Qdrant
 - Mecanismo de busca por similaridade vetorial de código aberto com suporte avançado à filtragem.
- R2R
 - R2R (RAG to Riches) é uma plataforma abrangente para criar, implantar e escalar aplicações RAG com busca híbrida, suporte multimodal e observabilidade avançada.
- RAGFlow
 - RAGFlow é um mecanismo RAG baseado na compreensão profunda de documentos.
- RAGxplorer
 - RAGxplorer é uma ferramenta para criar visualizações de RAG.
- RAG-FiT
 - RAG-FiT é uma biblioteca para melhorar a capacidade dos LLMs de usar informações externas, ajustando modelos em conjuntos de dados criados especialmente com RAG.
- TextWorld
 - TextWorld é um gerador de jogos baseados em texto e um ambiente sandbox de aprendizado extensível para treinar e testar agentes de aprendizado por reforço (RL).
- Zvec
 - Zvec é um banco de dados vetorial de código aberto, em processo, para busca por similaridade de baixa latência.
Processamento de linguagem natural de nível industrial
Seção intitulada “Processamento de linguagem natural de nível industrial”- aisuite
 - aisuite é uma interface simples e unificada para vários provedores de IA generativa.
- Align-Anything
 - Align-Anything busca alinhar grandes modelos de qualquer modalidade (modelos de qualquer modalidade para qualquer modalidade), incluindo LLMs e VLMs, às intenções e aos valores humanos.
- BERTopic
 - BERTopic é uma técnica de modelagem de tópicos que usa transformers e c-TF-IDF para criar agrupamentos densos e facilmente interpretáveis, preservando palavras importantes nas descrições dos tópicos.
- Burr
 - Burr ajuda a desenvolver aplicações que tomam decisões (chatbots, agentes e simulações). Inclui recursos prontos para produção (telemetria, persistência, implantação etc.) e a interface Burr, de código aberto, gratuita e local-first.
- Context7
 - Context7 fornece documentação de código atualizada para prompts e agentes de programação com IA.
- Dify
 - Dify é uma plataforma de código aberto para desenvolver aplicações com LLM. Sua interface intuitiva combina workflows de IA agêntica, pipelines RAG, recursos de agentes, gerenciamento de modelos, observabilidade e muito mais, acelerando a passagem do protótipo à produção.
- dspy
 - Framework para programar com modelos de base.
- Dust
 - Dust ajuda a projetar e implantar aplicações com grandes modelos de linguagem.
- ESPnet
 - ESPnet é um kit de ferramentas completo para processamento de fala.
- FastChat
 - FastChat é uma plataforma aberta para treinar, servir e avaliar chatbots baseados em grandes modelos de linguagem.
- Flair
 - Framework simples de PLN de última geração, desenvolvido pela Zalando e baseado diretamente no PyTorch.
- FunASR
 - FunASR é um kit de ferramentas ASR pronto para produção, compatível com mais de 50 idiomas, com VAD, pontuação, diarização de locutores e reconhecimento de emoções integrados, além de implantação via Docker/WebSocket/REST e suporte ao runtime ONNX.
- Fun-ASR
 - ASR baseado em LLM, compatível com 31 idiomas, incluindo dialetos chineses, com pontuação, marcações de tempo e diarização de locutores nativas.
- Gensim
 - Gensim é uma biblioteca Python para modelagem de tópicos, indexação de documentos e recuperação por similaridade em grandes corpora.
- gpt-fast
 - Geração de texto simples e eficiente com transformers nativos do PyTorch.
- Haystack
 - Haystack é um framework de PLN de código aberto para interagir com seus dados usando modelos Transformer e LLMs (GPT-3 e similares). Oferece ferramentas prontas para produção para criar rapidamente sistemas de perguntas e respostas como o ChatGPT, busca semântica, geração de texto e muito mais.
- Interactive Composition Explorer
 - ICE é uma biblioteca Python e visualizador de rastreamentos para programas de modelos de linguagem.
- Jan
 - Jan é uma alternativa de código aberto ao ChatGPT que funciona 100% offline no computador, permitindo baixar e executar LLMs localmente com controle total e privacidade.
- Lamini
 - Lamini é um mecanismo LLM para personalizar modelos rapidamente.
- LangChain
 - LangChain ajuda a criar aplicações com LLMs por meio da composição de componentes.
- LlamaIndex
 - LlamaIndex (GPT Index) é um framework de dados para sua aplicação com LLM.
- LLaMA
 - LLaMA é um exemplo mínimo, modificável e legível para carregar modelos LLaMA (arXiv) e executar inferência.
- LLaMA-Factory
 - LLaMA-Factory facilita o ajuste fino de mais de 100 grandes modelos de linguagem com CLI e interface web sem código.
- LLMBox
 - LLMBox é uma biblioteca abrangente para implementar LLMs, incluindo um pipeline unificado de treinamento e avaliação completa de modelos.
- LLaMA2-Accessory
 - LLaMA2-Accessory é um kit de ferramentas de código aberto para pré-treinamento, ajuste fino e implantação de grandes modelos de linguagem (LLMs) e LLMs multimodais.
- LMFlow
 - LMFlow é uma caixa de ferramentas extensível, prática e eficiente para ajustar grandes modelos de aprendizado de máquina.
- Megatron-LM
 - Megatron-LM é uma biblioteca altamente otimizada e eficiente para treinar grandes modelos de linguagem.
- MindNLP
 - MindNLP é um framework de PLN e LLM fácil de usar e de alto desempenho baseado no MindSpore, compatível com modelos e conjuntos de dados do Hugging Face.
- MLC LLM
 - MLC LLM é uma solução universal que permite implantar nativamente qualquer modelo de linguagem em diversos backends de hardware e aplicações nativas, além de fornecer um framework produtivo para otimizar ainda mais o desempenho dos modelos para cada caso de uso.
- mlx-lm
 - MLX LM é um pacote Python para gerar texto e ajustar grandes modelos de linguagem em Apple silicon com MLX, com integração ao Hugging Face Hub e suporte a quantização e inferência distribuída.
- Ollama
 - Comece a usar grandes modelos de linguagem localmente.
- olmOCR
 - olmOCR é um kit de ferramentas para treinar modelos de linguagem que trabalham com documentos PDF do mundo real.
- PaddleNLP
 - PaddleNLP é um conjunto de ferramentas de desenvolvimento de grandes modelos de linguagem (LLM) baseado no framework de aprendizado profundo PaddlePaddle, com suporte a treinamento eficiente de grandes modelos, compressão sem perdas e inferência de alto desempenho em vários dispositivos de hardware.
- Promptise Foundry
 - Promptise Foundry é um framework Python para produção de IA agêntica e servidores MCP, que abrange runtime autônomo, memória, integração de ferramentas, governança (orçamento, integridade, missão e segredos), proteções, cache semântico e observabilidade.
- Semantic Kernel
 - Semantic Kernel é um SDK que integra grandes modelos de linguagem (LLMs), como OpenAI, Azure OpenAI e Hugging Face, a linguagens de programação convencionais, como C#, Python e Java. Isso é feito por meio de plugins que podem ser encadeados com poucas linhas de código.
- Sentence Transformers
 - Sentence Transformers oferece um método simples para calcular representações vetoriais densas de frases, parágrafos e imagens.
- SpaCy
 - spaCy é uma biblioteca para processamento avançado de linguagem natural em Python e Cython.
- SWIFT
 - SWIFT é uma infraestrutura escalável e leve para ajuste fino de modelos de aprendizado profundo.
- Tensorflow Lingvo
 - Framework para criar redes neurais em TensorFlow, especialmente modelos sequenciais.
- Tensorflow Text
 - TensorFlow Text oferece um conjunto de classes e operações de texto prontas para uso com TensorFlow 2.0.
- ToolBench
 - ToolBench é uma plataforma aberta para treinar, servir e avaliar grandes modelos de linguagem voltados ao uso de ferramentas.
- Transformers
 - Biblioteca do Hugging Face com modelos pré-treinados de última geração para processamento de linguagem natural (PLN).
Sistemas de recomendação de nível industrial
Seção intitulada “Sistemas de recomendação de nível industrial”- EasyRec
 - EasyRec é um framework para algoritmos de recomendação em grande escala.
- Gorse
 - Gorse busca ser um sistema de recomendação universal e de código aberto, que pode ser rapidamente incorporado a vários serviços online.
- Merlin
 - NVIDIA Merlin é uma biblioteca de código aberto que oferece sistemas de recomendação acelerados por GPU de ponta a ponta, da engenharia e pré-processamento de recursos ao treinamento de modelos de aprendizado profundo e inferência em produção.
- Recommenders
 - Recommenders reúne benchmarks e boas práticas para criar sistemas de recomendação, apresentados em notebooks Jupyter.
- TorchRec
 - TorchRec é uma biblioteca de domínio do PyTorch com primitivas comuns de esparsidade e paralelismo necessárias a sistemas de recomendação (RecSys) em grande escala.
Aprendizado por reforço de nível industrial
Seção intitulada “Aprendizado por reforço de nível industrial”- Acme
 - Acme é uma biblioteca de componentes de aprendizado por reforço (RL) que busca oferecer agentes simples, eficientes e legíveis.
- AReaL
 - AReaL é uma biblioteca de aprendizado por reforço.
- ChatLearn
 - ChatLearn é um framework flexível e eficiente para treinamento de LLMs com aprendizado por reforço, compatível com mecanismos de treinamento distribuído (FSDP2, Megatron) e de inferência (vLLM, SGLang), além de algoritmos modernos de RL, como GRPO e GSPO.
- CleanRL
 - CleanRL é uma biblioteca de aprendizado profundo por reforço que oferece implementações de alta qualidade em arquivo único, com recursos favoráveis à pesquisa. A implementação é simples e organizada, mas pode ser escalada para executar milhares de experimentos usando AWS Batch.
- d3rlpy
 - d3rlpy é uma biblioteca de aprendizado profundo por reforço offline para profissionais e pesquisadores.
- D4RL
 - D4RL é um benchmark de código aberto para aprendizado por reforço offline.
- Dopamine
 - Dopamine é um framework de pesquisa para prototipar rapidamente algoritmos de aprendizado por reforço. Busca oferecer uma base de código pequena e fácil de entender, na qual os usuários possam experimentar livremente ideias ousadas de pesquisa especulativa.
- EvoTorch
 - EvoTorch é uma biblioteca de computação evolutiva de código aberto desenvolvida na NNAISENSE e baseada no PyTorch.
- FinRL
 - FinRL é o primeiro framework de código aberto a demonstrar o grande potencial do aprendizado por reforço financeiro.
- Gymnasium
 - Gymnasium é uma biblioteca Python de código aberto para desenvolver e comparar algoritmos de aprendizado por reforço. Oferece uma API padrão para comunicação entre algoritmos de aprendizado e ambientes, além de um conjunto padrão de ambientes compatíveis com essa API.
- Gymnasium-Robotics
 - Gymnasium-Robotics reúne ambientes robóticos de aprendizado por reforço compatíveis com a API Gymnasium. Os ambientes usam o mecanismo de física MuJoCo e as bindings Python mantidas do mujoco.
- Jumanji
 - Jumanji é um conjunto de ambientes de aprendizado por reforço (RL) escritos em JAX, com aceleração de hardware e voltados à pesquisa orientada pela indústria.
- MARLlib
 - MARLlib é uma biblioteca abrangente de algoritmos de aprendizado por reforço multiagente baseada no RLlib. Oferece à comunidade de pesquisa em MARL uma plataforma unificada para criar, treinar e avaliar algoritmos MARL.
- Mava
 - Mava é um framework para aprendizado por reforço multiagente distribuído em JAX.
- Melting Pot - Melting Pot é um conjunto de cenários de teste para aprendizado por reforço multiagente.
- MetaDrive
 - MetaDrive é um simulador de direção que combina diversos cenários para aprendizado por reforço generalizável.
- Minigrid
 - A biblioteca Minigrid reúne ambientes discretos de grade para pesquisa em aprendizado por reforço. Segue a API padrão do Gymnasium e foi projetada para ser leve, rápida e facilmente personalizável.
- MiniWorld
 - MiniWorld é um simulador minimalista de ambientes internos 3D para pesquisa em aprendizado por reforço e robótica.
- ML-Agents
 - ML-Agents é um projeto de código aberto que permite usar jogos e simulações como ambientes para treinar agentes inteligentes com aprendizado por reforço.
- MushroomRL
 - MushroomRL é uma biblioteca Python de aprendizado por reforço (RL) modular, que facilita o uso de bibliotecas conhecidas de computação de tensores (como PyTorch e TensorFlow) e benchmarks de RL (como OpenAI Gym, PyBullet e Deepmind Control Suite).
- OmniSafe
 - OmniSafe é um framework de infraestrutura criado para acelerar pesquisas em aprendizado por reforço seguro (RL).
- OpenRLHF
 - OpenRLHF é um framework de código aberto para aprendizado por reforço a partir de feedback humano (RLHF).
- PARL
 - PARL é um framework de aprendizado por reforço flexível e altamente eficiente.
- PettingZoo
 - PettingZoo é uma biblioteca Python para pesquisa em aprendizado por reforço multiagente, semelhante a uma versão multiagente do Gymnasium.
- ranx
 - ranx é uma biblioteca Python de métricas rápidas de avaliação de ranqueamento, que usa Numba para operações vetoriais velozes e paralelização automática.
- RL4CO
 - RL4CO é uma biblioteca PyTorch para aprendizado por reforço voltado à otimização combinatória (CO).
- RL2
 - RL2 é uma biblioteca de aprendizado por reforço.
- RLinf
 - RLinf é uma biblioteca de aprendizado por reforço.
- ROLL
 - ROLL é uma biblioteca de aprendizado por reforço.
- skrl
 - skrl é uma biblioteca modular de código aberto para aprendizado por reforço, escrita em Python com PyTorch e voltada à legibilidade, simplicidade e transparência das implementações de algoritmos.
- SkyRL
 - SkyRL é uma biblioteca completa de aprendizado por reforço, com frameworks modulares de treinamento, backends de inferência multiplataforma, pipelines agênticos e ambientes Gymnasium para tarefas de RL de longo horizonte no mundo real.
- slime
 - slime é um framework de pós-treinamento de LLMs para escalar o aprendizado por reforço.
- Stable Baselines
 - Fork do OpenAI Baselines com implementações de algoritmos de aprendizado por reforço.
- TF-Agents
 - Biblioteca TensorFlow confiável, escalável e fácil de usar para bandits contextuais e aprendizado por reforço.
- TorchRL
 - TorchRL é uma biblioteca de código aberto para aprendizado por reforço (RL) em PyTorch.
- TRL
 - Treine modelos de linguagem Transformer com aprendizado por reforço.
- veRL
 - veRL (HybridFlow) é um framework flexível, eficiente e de nível industrial para treinamento de RLHF voltado a LLMs.
Robótica de nível industrial
Seção intitulada “Robótica de nível industrial”- AI2-THOR
 - AI2-THOR é um framework interativo quase fotorrealista para agentes de IA.
- Genesis
 - Genesis é uma plataforma de física para IA incorporada e simulação robótica.
- Habitat-Sim
 - Habitat-Sim é um simulador 3D flexível e de alto desempenho para pesquisa em IA incorporada.
- IsaacLab
 - IsaacLab é um framework unificado e modular para aprendizado robótico, que usa NVIDIA Isaac Sim.
- LeRobot
 - LeRobot oferece modelos, conjuntos de dados e ferramentas para robótica no mundo real e aprendizado por imitação.
- robosuite
 - robosuite é um framework de simulação baseado no mecanismo de física MuJoCo para aprendizado robótico.
- RoboVerse
 - RoboVerse é uma plataforma abrangente de simulação robótica com ambientes diversos.
Visualização de nível industrial
Seção intitulada “Visualização de nível industrial”- Apache ECharts
 - Apache ECharts é uma biblioteca poderosa e interativa de gráficos e visualização de dados para navegadores.
- Apache Superset
 - Aplicação web moderna de inteligência empresarial, pronta para uso corporativo.
- Bokeh
 - Bokeh é uma biblioteca interativa de visualização para Python que permite apresentações visuais de dados belas e significativas em navegadores modernos.
- Bread Dataset Viewer - Extensão do VS Code para visualizar e explorar grandes conjuntos de dados de aprendizado de máquina (CSV, JSON, Parquet etc.) diretamente no editor sem travar a IDE.
- Bread WandB Viewer - Extensão do VS Code para visualizar experimentos, registros e artefatos do Weights & Biases na IDE, sem precisar alternar para a interface web e preservando a privacidade dos dados por funcionar totalmente offline.
- Data Formulator
 - Transforme dados e crie visualizações ricas de forma iterativa com IA.
- ggplot2
 - Implementação da gramática dos gráficos para R.
- gradio
 - Crie e compartilhe rapidamente demonstrações de modelos escrevendo apenas Python. Depure modelos interativamente no navegador, receba comentários de colaboradores e gere links públicos sem implantar nada.
- Kangas
 - Kangas é uma ferramenta para explorar, analisar e visualizar dados multimídia em grande escala. Oferece uma API Python simples para registrar tabelas de dados grandes e uma interface visual intuitiva para executar consultas complexas no conjunto de dados.
- matplotlib
 - Biblioteca Python para gráficos 2D, que produz figuras com qualidade de publicação em diversos formatos para impressão e ambientes interativos em várias plataformas.
- Model Explorer
 - Model Explorer é uma ferramenta para visualizar e explorar modelos de aprendizado de máquina, oferecendo uma visão intuitiva baseada em grafos para entender a estrutura dos modelos, inspecionar camadas e navegar por grandes redes neurais.
- Netron
 - Netron é um visualizador de redes neurais e modelos de aprendizado profundo e de máquina.
- Perspective
 Visualização de tabelas dinâmicas em streaming via WebAssembly.
- Plotly
 - Biblioteca interativa, de código aberto e baseada em navegador para gráficos em Python.
- Redash
 - Redash é um framework de visualização de código aberto criado para facilitar o acesso a grandes conjuntos de dados usando vários backends.
- Rerun
 - Rerun é um SDK de código aberto para registrar, armazenar, consultar e visualizar dados multimodais, voltado a robótica, visão computacional e IA espacial.
- seaborn
 - Seaborn é uma biblioteca Python de visualização baseada em matplotlib. Oferece uma interface de alto nível para criar gráficos estatísticos atraentes.
- Spotlight
 - Spotlight ajuda a identificar segmentos críticos de dados e modos de falha de modelos. Permite criar e manter modelos de aprendizado de máquina confiáveis por meio da curadoria de conjuntos de dados de alta qualidade.
- Streamlit
 - Streamlit permite criar aplicações para projetos de aprendizado de máquina com scripts Python surpreendentemente simples. Tem recarregamento automático, então a aplicação é atualizada ao vivo enquanto você edita e salva o arquivo.
- tensorboardX
 - Grave eventos do TensorBoard com uma simples chamada de função.
- TensorBoard
 - TensorBoard é um kit de ferramentas de visualização para experimentos de aprendizado de máquina que facilita hospedar, acompanhar e compartilhar experimentos de ML.
- Torchvista
 - Torchvista é uma ferramenta interativa baseada em notebooks para visualizar o passe direto de qualquer modelo PyTorch como um grafo computacional dentro de notebooks, com módulos aninhados recolhíveis e visualizações parciais tolerantes a erros.
- Transformer Explainer
 - Transformer Explainer é uma ferramenta interativa de visualização criada para ajudar qualquer pessoa a entender como funcionam modelos baseados em Transformer, como o GPT.
- Vega-Altair
 - Vega-Altair é uma biblioteca declarativa de visualização estatística para Python.
- ydata-profiling
 - ydata-profiling oferece uma experiência de análise exploratória de dados (EDA) em uma linha, com uma solução consistente e rápida.
Gerenciamento de metadados
Seção intitulada “Gerenciamento de metadados”- Apache Atlas
 - O framework Apache Atlas é um conjunto extensível de serviços fundamentais de governança que permite às empresas atender com eficiência aos requisitos de conformidade no Hadoop e integrar-se a todo o ecossistema de dados empresarial.
- DataHub
 - DataHub é a ferramenta generalizada do LinkedIn para busca e descoberta de metadados.
- Marquez
 - Marquez é um serviço de metadados de código aberto para coletar, agregar e visualizar metadados de um ecossistema de dados.
- Metacat
 - Metacat é um serviço de API unificada para exploração de metadados. Resolve problemas como: 1) visões federadas de sistemas de metadados; 2) armazenamento arbitrário de metadados sobre conjuntos de dados; 3) descoberta de metadados.
- ML Metadata
 - Biblioteca para registrar e recuperar metadados associados aos fluxos de trabalho de desenvolvedores de ML e cientistas de dados.
Gerenciamento de modelos, dados e experimentos
Seção intitulada “Gerenciamento de modelos, dados e experimentos”- Aim
 - Uma maneira muito simples de registrar, pesquisar e comparar experimentos de IA.
- ClearML
 - Gerenciador de experimentos e controle de versões quase mágicos para IA (anteriormente Trains).
- DataHub - DataHub é um catálogo de dados de código aberto para a pilha de dados moderna.
- Dolt
 - Dolt é um banco de dados SQL que você pode bifurcar, clonar, ramificar, mesclar, enviar e obter, como em um repositório git.
- DVC
 - DVC (Data Version Control) é um fork do git que permite controlar versões de modelos.
- HuggingFace Model Downloader
 - HuggingFace Model Downloader é uma ferramenta para baixar modelos e conjuntos de dados do site Hugging Face. Oferece downloads multithread de arquivos LFS e verifica a integridade dos modelos baixados por checksum SHA256.
- Keepsake
 - Controle de versões para aprendizado de máquina.
- KitOps
 - KitOps é um sistema aberto e baseado em padrões para empacotar e versionar projetos de IA/ML, compatível com as ferramentas de IA/ML, desenvolvimento e DevOps que você já usa.
- lakeFS
 - Data lake reproduzível, atômico e versionado sobre armazenamento de objetos.
- MLflow
 - Plataforma de código aberto para gerenciar o ciclo de vida de ML, incluindo experimentação, reprodutibilidade e implantação.
- Polyaxon
 - Plataforma para aprendizado de máquina e profundo reproduzível e escalável no Kubernetes - (Vídeo).
- Quilt
 - Versionamento, reprodutibilidade e implantação de dados e modelos.
- Sacred
 - Ferramenta para configurar, organizar, registrar e reproduzir experimentos de aprendizado de máquina.
- TerminusDB
 - Sistema de gerenciamento de banco de dados em grafo que armazena dados como o git.
- Weights & Biases
 - Weights & Biases é uma ferramenta para acompanhar experimentos de aprendizado de máquina, versionar conjuntos de dados, pesquisar hiperparâmetros, visualizar e colaborar.
Treinamento e orquestração de modelos
Seção intitulada “Treinamento e orquestração de modelos”- AutoTrain Advanced
 - AutoTrain Advanced é uma solução sem código que permite treinar modelos de aprendizado de máquina com apenas alguns cliques.
- Avalanche
 - Avalanche é uma biblioteca completa de aprendizado contínuo, com base de código colaborativa e de código aberto (licença MIT) para prototipagem rápida, treinamento e avaliação reproduzível de algoritmos de aprendizado contínuo.
- Axolotl
 - Axolotl é uma ferramenta para simplificar o ajuste fino de diversos modelos de IA, com suporte a várias configurações e arquiteturas.
- BindsNET
 - BindsNET é uma biblioteca de simulação de redes neurais pulsadas, voltada ao desenvolvimento de algoritmos de aprendizado de máquina bioinspirados.
- CML
 - Continuous Machine Learning (CML) é uma biblioteca de código aberto para implementar integração e entrega contínuas (CI/CD) em projetos de aprendizado de máquina.
- CoreNet
 - CoreNet é um kit de ferramentas de redes neurais profundas que permite a pesquisadores e engenheiros treinar modelos padrão e inovadores de diferentes escalas para várias tarefas, incluindo modelos de base (como CLIP e LLMs), classificação e detecção de objetos e segmentação semântica.
- DataLinter
 - DataLinter é um linter contextual de código aberto para dados e código, projetado para ser agnóstico em relação aos dados e ao código por meio de plugins.
- Determined
 - Plataforma de treinamento de aprendizado profundo com suporte integrado a treinamento distribuído, ajuste de hiperparâmetros e gerenciamento de modelos (compatível com TensorFlow e PyTorch).
- dstack
 - dstack é um orquestrador de contêineres de código aberto que simplifica a orquestração de cargas de trabalho e aumenta a utilização de GPUs pelas equipes de ML.
- envd
 - Ambiente de desenvolvimento de aprendizado de máquina para equipes de ciência de dados e engenharia de IA/ML.
- Fire-Flyer File System
 - O Fire-Flyer File System (3FS) é um sistema de arquivos distribuído de alto desempenho, projetado para atender às demandas de cargas de trabalho de treinamento e inferência de IA. Usa SSDs modernos e redes RDMA para oferecer uma camada de armazenamento compartilhada que simplifica o desenvolvimento de aplicações distribuídas.
- H2O-3
 - Plataforma de aprendizado de máquina rápida e escalável para aplicações mais inteligentes: aprendizado profundo, gradient boosting e XGBoost, Random Forest, modelos lineares generalizados (regressão logística, Elastic Net), K-Means, PCA, ensembles empilhados, aprendizado de máquina automatizado (AutoML) etc.
- Hopsworks
 - Hopsworks é uma plataforma com uso intensivo de dados para projetar e operar pipelines de aprendizado de máquina.
- Ignite
 - Ignite é uma biblioteca de alto nível que ajuda a treinar e avaliar redes neurais no PyTorch com flexibilidade e transparência.
- Kubeflow
 - Plataforma nativa da nuvem para aprendizado de máquina baseada nos pipelines internos de ML do Google.
- Ludwig
 - Ludwig é um framework low-code para criar modelos de IA personalizados, como LLMs e outras redes neurais profundas.
- MFTCoder
 - MFTCoder é um projeto de código aberto da CodeFuse para ajuste fino multitarefa (MFT) preciso e eficiente de grandes modelos de linguagem (LLMs), especialmente modelos de linguagem para tarefas de programação.
- MLeap
 - Padronização de pipelines e serialização de modelos para Spark, TensorFlow e sklearn.
- Nanotron
 - Nanotron oferece primitivas distribuídas para treinar eficientemente vários tipos de modelos usando paralelismo 3D.
- NeMo
 - NVIDIA NeMo é um framework de IA generativa escalável e nativo da nuvem, criado para pesquisadores e desenvolvedores PyTorch que trabalham com grandes modelos de linguagem (LLMs), modelos multimodais (MMs), reconhecimento automático de fala (ASR), conversão de texto em fala (TTS) e visão computacional (CV). Ajuda a criar, personalizar e implantar modelos de IA generativa com eficiência, aproveitando código existente e checkpoints de modelos pré-treinados.
- Prime
 - Prime é um framework para treinamento eficiente e globalmente distribuído de modelos de IA pela internet.
- PyCaret
 ) - Biblioteca low-code para treinar e implantar modelos (scikit-learn, XGBoost, LightGBM, spaCy)
- Sematic
 - Plataforma para criar pipelines que consomem muitos recursos usando Python simples.
- Skaffold
 - Skaffold é uma ferramenta de linha de comando que facilita o desenvolvimento contínuo de aplicações Kubernetes. Permite iterar localmente no código-fonte da aplicação e implantá-la em clusters Kubernetes locais ou remotos.
- TFX
 - TensorFlow Extended (TFX) é um framework de configuração voltado à produção para ML baseado em TensorFlow, incluindo monitoramento e gerenciamento de versões de modelos.
- unsloth
 - Ajuste fino e aprendizado por reforço para LLMs. Treine OpenAI gpt-oss, DeepSeek-R1, Qwen3, Gemma 3 e TTS duas vezes mais rápido, usando 70% menos VRAM.
Otimização do armazenamento de modelos
Seção intitulada “Otimização do armazenamento de modelos”- AWQ
 - Quantização de pesos sensível às ativações para compressão e aceleração de LLMs.
- GGML
 - GGML é uma biblioteca de tensores de alto desempenho para aprendizado de máquina, que permite inferência eficiente em CPUs e é especialmente otimizada para grandes modelos de linguagem.
- neural-compressor
 - Intel® Neural Compressor busca oferecer técnicas populares de compressão de modelos, como quantização, poda (esparsidade), destilação e busca por arquiteturas neurais, em frameworks comuns.
- NNEF - Neural Network Exchange Format (NNEF) é um padrão aberto para representar modelos de redes neurais e permitir interoperabilidade e portabilidade entre diferentes frameworks e plataformas de aprendizado de máquina.
- ONNX
 - ONNX (Open Neural Network Exchange) é um formato de código aberto criado para facilitar a interoperabilidade e a portabilidade de modelos de aprendizado de máquina entre diferentes frameworks e plataformas.
- PFA - PFA (Portable Format for Analytics) é um formato padrão para representar e trocar modelos preditivos e workflows analíticos em um formato portátil baseado em JSON.
- PMML - PMML (Predictive Model Markup Language) é um padrão baseado em XML para representar e compartilhar modelos preditivos entre diferentes aplicações.
- Quanto
 - Quanto busca simplificar a quantização de modelos de aprendizado profundo.
Privacidade e segurança
Seção intitulada “Privacidade e segurança”- AI Gateway
 - AI Gateway é um gateway de IA extremamente rápido, com proteções integradas.
- ART
 - ART (Adversarial Robustness Toolbox) oferece ferramentas para desenvolvedores e pesquisadores defenderem e avaliarem modelos e aplicações de aprendizado de máquina contra ameaças adversariais de evasão, envenenamento, extração e inferência.
- CipherChat
 - CipherChat é um framework para avaliar a capacidade de generalização do alinhamento de segurança de LLMs.
- DeepTeam
 - DeepTeam é um framework de red teaming de LLMs de código aberto e fácil de usar para testes de penetração e proteção de sistemas de grandes modelos de linguagem.
- FATE
 - FATE (Federated AI Technology Enabler) é o primeiro framework de aprendizado federado de código aberto de nível industrial do mundo, permitindo que empresas e instituições colaborem com dados protegendo sua segurança e privacidade.
- FedML
 - FedML oferece uma plataforma integrada de pesquisa e produção, de borda à nuvem, para aprendizado de máquina federado e distribuído em qualquer lugar e escala.
- Flower
 - Flower é um framework de aprendizado federado com uma abordagem unificada. Permite federar qualquer carga de trabalho de ML, com qualquer framework de ML e linguagem de programação.
- Google’s Differential Privacy
 - Biblioteca C++ de algoritmos com privacidade diferencial ε, que podem gerar estatísticas agregadas sobre conjuntos de dados numéricos com informações privadas ou sensíveis.
- Guardrails
 - Guardrails é um pacote que permite adicionar garantias de estrutura, tipo e qualidade às saídas de grandes modelos de linguagem.
- NeMo Guardrails
 - NeMo Guardrails é um kit de ferramentas de código aberto para adicionar facilmente proteções programáveis a sistemas conversacionais baseados em LLMs.
- Opacus
 - Opacus é uma biblioteca que permite treinar modelos PyTorch com privacidade diferencial. Oferece treinamento com alterações mínimas no código do cliente, pouco impacto no desempenho e acompanhamento online do orçamento de privacidade consumido a qualquer momento.
- OpenFL
 - OpenFL é um framework Python para aprendizado federado. Foi projetado para ser flexível, extensível e fácil de aprender para cientistas de dados. Desenvolvido pelo Intel Internet of Things Group (IOTG) e pelo Intel Labs.
- PySyft
 - Biblioteca Python para aprendizado profundo seguro e privado. PySyft separa os dados privados do treinamento de modelos, usando computação multipartidária (MPC) no PyTorch.
- Tensorflow Privacy
 - Biblioteca Python com implementações de otimizadores TensorFlow para treinar modelos de aprendizado de máquina com privacidade diferencial.
- TF Encrypted
 - Framework para aprendizado de máquina confidencial em dados criptografados no TensorFlow.
Outras listas incríveis
Seção intitulada “Outras listas incríveis”- Awesome Agentic Engineering Resources
 - Coleção selecionada de recursos, ferramentas e referências para criar sistemas de IA agêntica.
- Awesome AI Gateway
 - Lista selecionada e bilíngue (EN/zh-CN) de gateways de IA e proxies LLM (LiteLLM, OpenRouter, Portkey, Kong, Higress, new-api), comparados por custo, conformidade, auto-hospedagem e roteamento, com árvore de decisão, benchmarks de custo reproduzíveis e tabela de pontuação.
- Awesome AI Regulation
 - Abrange governança, conformidade e frameworks regulatórios essenciais para implantar sistemas de ML com responsabilidade em diferentes jurisdições.
- Awesome AI Tokenomics
 - Abrange custos e eficiência de tokens em sistemas de IA, incluindo monitoramento, otimização, cache, seleção de modelos e gerenciamento de contexto.
- Awesome Production GenAI
 - Foco específico na implantação de IA generativa, incluindo operações de LLM, engenharia de prompts e ferramentas de monitoramento e segurança próprias de GenAI.
- Awesome RAG Production
 - Lista selecionada de ferramentas prontas para produção e boas práticas para criar sistemas RAG escaláveis.
Contribuidores
Seção intitulada “Contribuidores”HagiCode
O HagiCode é um ambiente de programação com agentes. Interações de interface ricas e práticas tornam o planejamento, a execução de agentes e o trabalho em projetos mais acessíveis e fáceis de acompanhar, criando uma experiência de desenvolvimento envolvente.
Uma experiência de desenvolvimento envolvente, com interações de interface ricas e práticas.

- InteligenteOs fluxos de trabalho do OpenSpec transformam a intenção em um caminho executável, da proposta ao design, às tarefas e à entrega.
- EficienteA execução multiagente mantém pesquisa, implementação e revisão em andamento em paralelo, em vários repositórios e com os Agent CLI que você já usa.
- InteressanteInterações de interface ricas e práticas tornam o planejamento, a execução de agentes e o trabalho em projetos mais acessíveis e fáceis de acompanhar.
Baixar para Windows
Compartilhar o HagiCode

Transforme ideias em software entregue.
O HagiCode é um ambiente de programação com agentes: os fluxos de trabalho do OpenSpec planejam a mudança, a execução multiagente a realiza e o Hero Scenario torna o longo percurso visível, para transformar ideias em software entregue.
- Inteligente
- Os fluxos do OpenSpec transformam a intenção em um caminho da proposta à entrega.
- Eficiente
- A execução multiagente conduz pesquisa, implementação e revisão em paralelo.
- Divertido
- As interações de interface facilitam o planejamento, a execução de agentes e os projetos.
© 2026 HagiCode | Powered By hagilight-starlight@0.21.0 | Branch: main | Commit: 745b50b | Built: