
Chinese NLP
Source: https://github.com/crownpku/Awesome-Chinese-NLP at
923e20ae6872
License: Apache-2.0
Read the English original
This edition is an AI-assisted translation.
Chinese NLP
Seção intitulada “Chinese NLP”
Uma lista selecionada de recursos para PLN (processamento de linguagem natural) para o chinês.
Materiais relacionados ao processamento de linguagem natural em chinês
Imagem do professor Qiu Xipeng da Universidade Fudan
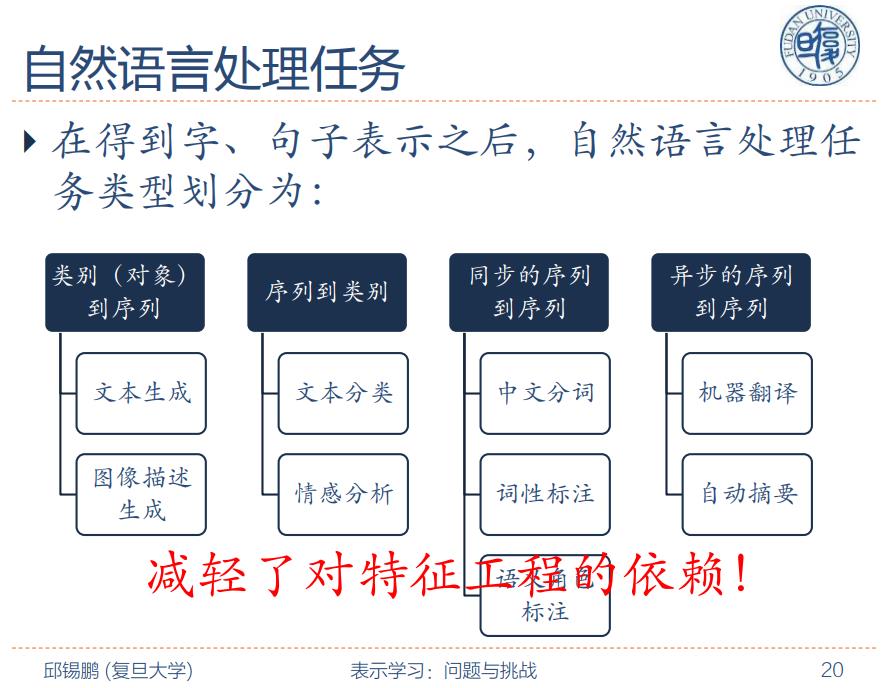
Conteúdo Contents
Seção intitulada “Conteúdo Contents”1. Ferramentas NLP chinesas Chinese NLP Toolkits
Seção intitulada “1. Ferramentas NLP chinesas Chinese NLP Toolkits”3. Organizações acadêmicas e competições NLP chinesas Organizations
Seção intitulada “3. Organizações acadêmicas e competições NLP chinesas Organizations”4. Serviços comerciais NLP chineses Industry
Seção intitulada “4. Serviços comerciais NLP chineses Industry”5. Material de aprendizagem Learning Materials
Seção intitulada “5. Material de aprendizagem Learning Materials”Ferramentas NLP chinesas Chinese NLP Toolkits
Seção intitulada “Ferramentas NLP chinesas Chinese NLP Toolkits”Conjuntos de ferramentas NLP integradas Toolkits
Seção intitulada “Conjuntos de ferramentas NLP integradas Toolkits”-
THULAC 中文词法分析工具包 por 清华 (C++/Java/Python)
-
NLPIR por 中科院 (Java)
-
LTP 语言技术平台 por 哈工大 (C++) pylyp wrapper Python para LTP
-
FudanNLP por 复旦 (Java)
-
BaiduLac por 百度 ferramenta aberta de análise lexical do Baidu para chinês, incluindo segmentação, etiquetagem gramatical e reconhecimento de entidades nomeadas.
-
HanLP (Java)
-
FastNLP (Python) um conjunto NLP leve.
-
SnowNLP (Python) biblioteca Python para processar texto chinês
-
YaYaNLP (Python) pacote NLP chinês escrito em Python puro, batizado de «牙牙学语» (aprender a falar)
-
小明NLP (Python) ferramenta NLP chinesa leve
-
DeepNLP (Python) pipeline NLP de deep learning implementado no Tensorflow com modelos chineses pré-treinados.
-
chinese_nlp (C++ & Python) ferramentas e exemplos de processamento de linguagem natural chinês
-
lightNLP (Python) framework de deep learning NLP baseado em Pytorch e torchtext
-
Chinese-Annotator (Python) anotador para corpus de texto chinês Annotator for Chinese Text Corpus
-
Poplar (Typescript) uma ferramenta de anotação web para NLP
-
Jiagu (Python) Jiagu baseia-se em modelos como BiLSTM e é treinado com corpus em grande escala. Oferece segmentação, etiquetagem gramatical, NER, análise de sentimento, extração de relações de grafo de conhecimento, extração de palavras-chave, resumo, descoberta de novas palavras, etc.
-
SmoothNLP (Python & Java) focado em técnicas NLP explicáveis
-
FoolNLTK (Python & Java) um conjunto de linguagem natural chinês A Chinese Nature Language Toolkit
Conjuntos de ferramentas NLP inglesas ou multilíngues comuns Popular NLP Toolkits for English/Multi-Language
Seção intitulada “Conjuntos de ferramentas NLP inglesas ou multilíngues comuns Popular NLP Toolkits for English/Multi-Language”-
CoreNLP por Stanford (Java) um conjunto Java de ferramentas NLP centrais.
-
Stanza por Stanford (Python) uma biblioteca NLP Python para muitas línguas humanas
-
NLTK (Python) Natural Language Toolkit
-
spaCy (Python) PLN de nível industrial com um curso online
-
textacy (Python) NLP, antes e depois do spaCy
-
OpenNLP (Java) um conjunto baseado em aprendizado de máquina para processamento de texto em linguagem natural.
-
gensim (Python) Gensim é uma biblioteca Python para modelagem de tópicos, indexação de documentos e recuperação de similaridade em grandes corpora.
-
Kashgari - framework NLP simples e poderoso, construa um modelo de ponta em 5 minutos para NER, PoS e classificação de texto. Inclui BERT e word2vec.
Segmentação de palavras chinesas Chinese Word Segment
Seção intitulada “Segmentação de palavras chinesas Chinese Word Segment”-
Jieba 结巴中文分词 (Python e muitas outras variantes) o melhor componente de segmentação chinesa para Python
-
北大中文分词工具 (Python) ferramenta de segmentação chinesa de alta precisão, fácil de usar, melhora muito a precisão em relação a ferramentas open-source existentes.
-
kcws 深度学习中文分词 (Python) BiLSTM+CRF e IDCNN+CRF
-
ID-CNN-CWS (Python) Convolyções dilatadas iteradas para segmentação de palavras chinesas Iterated Dilated Convolutions for Chinese Word Segmentation
-
Genius 中文分词 (Python) Genius é um componente aberto de segmentação chinesa em python, usa o algoritmo CRF (Campo aleatório condicional).
-
loso 中文分词 (Python)
-
yaha “哑哈”中文分词 (Python)
-
ChineseWordSegmentation (Python) algoritmo de segmentação chinesa sem corpus Chinese word segmentation algorithm without corpus
-
Segmentação de alto desempenho em Go (Go) segmentação de texto eficiente em Go; suporta inglês, chinês, japonês e outros.
-
Ansj中文分词 (java) implementação java de segmentação chinesa baseada em n-Gram+CRF+HMM
Extração de informação Information Extraction
Seção intitulada “Extração de informação Information Extraction”-
MITIE (C++) biblioteca e ferramentas para extração de informação
-
Duckling (Haskell) linguagem, motor e ferramentas para expressar, testar e avaliar regras de linguagem componíveis sobre cadeias de entrada.
-
IEPY (Python) IEPY é uma ferramenta aberta de extração de informação focada em extração de relações.
-
Snorkel um sistema de criação e gerenciamento de dados de treinamento focado em extração de informação
-
Extração de relações neural implementada com LSTM no TensorFlow
-
Um modelo de rede neural para reconhecimento de entidades nomeadas chinesas
-
bert-chinese-ner usa o modelo de linguagem pré-treinado BERT para NER chinês
-
Information-Extraction-Chinese NER chinesa com IDCNN/biLSTM+CRF e extração de relações com biGRU+2ATT 中文实体识别与关系提取
-
Familia do Baidu, A Toolkit for Industrial Topic Modeling
-
Text Classification todos os tipos de modelos de classificação de texto e mais com deep learning. Usa o corpus de perguntas e respostas Zhihu como dados de teste.
-
ComplexEventExtraction conceitos e padrões explícitos de eventos compostos chineses, incluindo eventos condicionais, causais, sequenciais, inversos, formando um grafo de eventos.
-
TextRank4ZH extrai automaticamente palavras-chave e resumos de texto chinês
Perguntas e respostas e Chatbot QA & Chatbot
Seção intitulada “Perguntas e respostas e Chatbot QA & Chatbot”-
Rasa NLU (Python) converte linguagem natural em dados estruturados, um fork chinês em Rasa NLU Chi
-
Rasa Core (Python) motor de diálogo baseado em aprendizado de máquina para software conversacional
-
Chatstack uma UI de pipeline completo para construir um sistema NLU chinês
-
Snips NLU (Python) Snips NLU é uma biblioteca Python que analisa frases em linguagem natural e extrai informações estruturadas.
-
DeepPavlov (Python) uma biblioteca aberta para construir sistemas de diálogo de ponta a ponta e treinar chatbots.
-
ChatScript ferramenta/gerenciador de diálogo em linguagem natural, um motor de chatbot baseado em regras.
-
Chatterbot (Python) ChatterBot é um motor de diálogo conversacional de aprendizado de máquina para criar chatbots.
-
Chatbot (Python) chatbot contextual baseado em correspondência de vetores
-
Tipask (PHP) um sistema de perguntas e respostas PHP de código aberto, baseado em Laravel, fácil de estender, com grande capacidade de carga e estabilidade.
-
QuestionAnsweringSystem (Java) um sistema homem-máquina de perguntas e respostas em Java que analisa automaticamente as perguntas e dá respostas candidatas.
-
QA-Snake (Python) perguntas e respostas automáticas baseadas em vários motores de busca e deep learning
-
Modelo de chatbot Sequence to Sequence com TensorFlow (Python)
-
Sistema de perguntas e respostas de compreensão de leitura chinesa com deep learning (Python)
-
AnyQ by Baidu inclui principalmente um framework de perguntas e respostas para coleções FAQ e a ferramenta de correspondência semântica SimNet.
-
Código baseline DuReader de compreensão de leitura chinesa (Python)
-
QASystemOnMedicalKG (Python) um grafo de conhecimento médico de certa escala centrado em doenças, que oferece perguntas e respostas e análise automáticas.
-
GPT2-chitchat (Python) modelo GPT2 para conversa chinesa
-
CDial-GPT (Python) fornece um grande conjunto de dados de diálogo chinês e um modelo de pré-treinamento de diálogo chinês (modelo GPT chinês) sobre ele
Representação e recuperação multimodal Multi-Modal Representation & Retrieval
Seção intitulada “Representação e recuperação multimodal Multi-Modal Representation & Retrieval”- Chinese-CLIP (Python) Chinese-CLIP é um modelo pré-treinado de representação multimodal texto-imagem chinês. Baseado na estrutura CLIP da OpenAI, pré-treinado com um grande corpus nativo chinês texto-imagem; vários tamanhos de modelo abertos, com relatório técnico e demo de recuperação.
Corpus chinês Corpus
Seção intitulada “Corpus chinês Corpus”-
CN-Probase, grande grafo de conceitos chineses apresentação em conta oficial
-
Download open-source de um grande grafo de conhecimento chinês de 140 milhões
-
Grafo de conhecimento agrícola recuperação de informação, reconhecimento de entidades, extração de relações, construção de árvore de classificação, mineração de dados no domínio agrícola
-
Modelos pré-treinados chineses segundo diferentes corpora e modelos (BERT, GPT, etc.) framework de modelos pré-treinados chineses que suporta diferentes corpora, codificadores e tarefas (from RUC and Tencent)
-
OpenCLaP repositório aberto multilíngue de modelos de linguagem pré-treinados chineses (from Tsinghua)
-
Corpus etiquetado gramaticalmente do Diário do Povo 1998@Baidu Disk
-
Corpus de notícias Sogou 20061127 (com classificação)@Baidu Disk
-
UDChinese (para treinar PoS do spaCy)
-
Tencent AI Lab Embedding Corpus for Chinese Words and Phrases
-
Código de treinamento GPT2 chinês pode escrever poemas, notícias, romances, ou treinar um modelo de linguagem geral.
-
ChineseGLUE, benchmark de compreensão de linguagem chinesa inclui conjuntos de dados representativos, modelos de referência (pré-treinados), corpora, leaderboard.
-
Banco de dados do dicionário Xinhua chinês inclui provérbios, idiomas, palavras, caracteres.
-
Synonyms: pacote de sinônimos chineses biblioteca de sinônimos treinada com Wikipedia chinesa e word2vec, empacotada como pacote python.
-
Chinese_conversation_sentiment um conjunto de dados de sentimento chinês útil para análise de sentimento.
-
Corpus de emergências chinesas Chinese Emergency Corpus
-
dgk_lost_conv, corpus de diálogos chineses chinese conversation corpus
-
Corpus para treinar sistemas de diálogo chinês-inglês Datasets for Training Chatbot System
-
Corpus de perguntas e respostas do fórum Gossiping em chinês
-
Crawler de anúncios da bolsa chinesa scripts python para obter anúncios (empresas listadas e reguladores) dos mercados chineses sz, sh dos servidores Juchao
-
Interface de dados financeiros tushare TuShare é um pacote python gratuito e aberto de interface de dados financeiros.
-
Conjunto de dados de texto financeiro SmoothNLP 金融文本数据集(公开) Public Financial Datasets for NLP Researches
-
Corpus do setor de seguros [Blog 52nlp] OpenData no setor de seguros para tarefas de aprendizado de máquina OpenData in insurance area for Machine Learning Tasks
-
Banco de dados mais completo de poesia chinesa antiga cerca de 14000 poetas das dinastias Tang/Song, ~55000 poemas Tang + 260000 poemas Song. 1564 autores de ci da Song, 21050 ci.
-
Pequenos corpora chineses inclui um pouco de NER chinesa, reconhecimento de relações, compreensão de leitura chinesa
-
Chinese-Literature-NER-RE-Dataset conjunto de dados de NER e extração de relações em nível de discurso para texto literário chinês A Discourse-Level Named Entity Recognition and Relation Extraction Dataset for Chinese Literature Text
-
ChineseTextualInference projeto de inferência textual chinesa, incluindo tradução/construção de um conjunto de 880k pares de implicação textual e um modelo de implicação baseado em deep learning.
-
Grande corpus de PLN chinês Wikipedia (wiki2019zh), notícias (news2016zh), Q&A de enciclopédia (baike2018qa)
-
Corpus de nomes de pessoas chinesas nomes, sobrenomes, prenomes, tratamentos chineses, nomes japoneses, traduzidos, ingleses.
-
Corpus de nomes de empresas e organizações abreviações, siglas, marcas, nomes de empresas.
-
Dicionário de palavras sensíveis chinesas várias implementações de filtro de palavras sensíveis + um dicionário de ~10k palavras
-
Corpus de abreviações chinesas um corpus de abreviações chinesas incluindo formas completas negativas A corpus of Chinese abbreviation, including negative full forms.
-
Material de pré-processamento de dados chineses dicionário de segmentação e stopwords chinesas
-
SentiBridge: base de conhecimento de sentimento de entidades chinesas descreve como as pessoas descrevem uma entidade, 300000 pares de notícias, viagens, alimentação.
-
OpenCorpus uma coleção de corpora (chineses) livremente disponíveis.
-
ChineseNlpCorpus análise de tendência sentimento/opinião/comentário, NER chinesa, sistema de recomendação
-
FinancialDatasets SmoothNLP 金融文本数据集(公开) Public Financial Datasets for NLP Researches Only
-
People’s Daily & Children’s Fairy Tale PD&CFT: um conjunto de dados de compreensão de leitura chinesa A Chinese Reading Comprehension Dataset
Organizações acadêmicas e competições NLP chinesas Organizations
Seção intitulada “Organizações acadêmicas e competições NLP chinesas Organizations”-
Laboratório de PLN e computação humana da Universidade Tsinghua
-
Laboratório chave do ministério de linguística computacional de Peking
-
Grupo de pesquisa NLP do instituto de computação da Academia
-
Centro de computação social e recuperação de informação de 哈工大
-
NLP Conference Calender principais conferências, periódicos, workshops e tarefas compartilhadas da comunidade NLP.
-
2017 1.ª avaliação de leitura automática chinesa «iFlytek Cup»
-
2017 AI-Challenger descrição de imagem em chinês descrever em uma frase a informação principal de uma imagem dada, desafiando a compreensão de imagem em contexto chinês.
-
2017 AI-Challenger tradução de texto inglês-chinês com grandes dados melhorar a capacidade de modelos de tradução automática inglês-chinês.
-
2017 concurso de aprendizado de máquina Zhihu Kanshan Cup a partir de dados de treinamento de perguntas e tags de tópicos do Zhihu, treinar um modelo de etiquetagem automática de dados não etiquetados.
-
2018 tarefa de perguntas e respostas chinesas em domínio aberto para uma pergunta chinesa dada, o sistema escolhe entidades ou valores da base de conhecimento como resposta.
-
2018 concurso de correspondência de perguntas do atendimento ao cliente do WeBank sobre corpus real de atendimento ao cliente chinês, correspondência de intenção; dadas duas frases, julgar se as intenções são próximas.
Serviços comerciais NLP chineses Industry
Seção intitulada “Serviços comerciais NLP chineses Industry”-
Huawei Cloud NLP serviço em nuvem de análise e mineração de texto para empresas e desenvolvedores, ajuda a processar texto com eficiência
-
Baidu Cloud NLP oferece tecnologia NLP líder, processamento e compreensão de texto de alta qualidade
-
Alibaba Cloud NLP ferramenta central de análise e mineração de texto para empresas e desenvolvedores
-
Tencent Cloud NLP baseado em computação paralela e crawler distribuído, combinado com análise semântica única, atende NLP, transcodificação, extração, captura de dados
-
Plataforma aberta iFlytek plataforma de IA centrada na interação por voz
-
Laboratório Sogou segmentação e etiquetagem gramatical
-
BosonNLP 玻森数据 Shanghai Boson, especializada em análise semântica chinesa
-
Yunfu Tech 云孚科技 pacotes NLP, grafos de conhecimento, mineração de texto, sistemas de diálogo, análise de opinião, etc.
-
Zhiyan Tech 智言科技 empresa de IA focada em deep learning e grafos de conhecimento
-
Zhuiyi Tech 追一科技 focada em deep learning e PLN
Material de aprendizagem Learning Materials
Seção intitulada “Material de aprendizagem Learning Materials”-
Stanford CS224n Natural Language Processing with Deep Learning 2017
-
[Material de curso para Georgia Tech CS 4650 e 7650, «Natural Language»] (https://github.com/jacobeisenstein/gt-nlp-class)
-
Speech and Language Processing por Dan Jurafsky e James H. Martin
-
Material do curso prático de processamento de texto inclui extração de características (TF-IDF), classificação, clusterização, treinamento word2vec, cálculo de similaridade, resumo automático, extração de informação, análise de sentimento e mineração de opiniões.
-
nlp_tasks Natural Language Processing Tasks and Selected References
-
Caminho de introdução à pesquisa NLP do professor Liu Zhiyuan de 清华
-
Chinese NLP Tarefas compartilhadas, conjuntos de dados e resultados de ponta para o processamento de linguagem natural em chinês
HagiCode
O HagiCode é um ambiente de programação com agentes. Interações de interface ricas e práticas tornam o planejamento, a execução de agentes e o trabalho em projetos mais acessíveis e fáceis de acompanhar, criando uma experiência de desenvolvimento envolvente.
Uma experiência de desenvolvimento envolvente, com interações de interface ricas e práticas.

- InteligenteOs fluxos de trabalho do OpenSpec transformam a intenção em um caminho executável, da proposta ao design, às tarefas e à entrega.
- EficienteA execução multiagente mantém pesquisa, implementação e revisão em andamento em paralelo, em vários repositórios e com os Agent CLI que você já usa.
- InteressanteInterações de interface ricas e práticas tornam o planejamento, a execução de agentes e o trabalho em projetos mais acessíveis e fáceis de acompanhar.
Baixar para Windows
Compartilhar o HagiCode

Transforme ideias em software entregue.
O HagiCode é um ambiente de programação com agentes: os fluxos de trabalho do OpenSpec planejam a mudança, a execução multiagente a realiza e o Hero Scenario torna o longo percurso visível, para transformar ideias em software entregue.
- Inteligente
- Os fluxos do OpenSpec transformam a intenção em um caminho da proposta à entrega.
- Eficiente
- A execução multiagente conduz pesquisa, implementação e revisão em paralelo.
- Divertido
- As interações de interface facilitam o planejamento, a execução de agentes e os projetos.
© 2026 HagiCode | Powered By hagilight-starlight@0.21.0 | Branch: main | Commit: 745b50b | Built: