
System Design
Source: https://github.com/madd86/awesome-system-design at
52834671253b
License: CC0-1.0
Read the English original
This edition is an AI-assisted translation.

Sélection d’articles, de livres, de vidéos et d’outils sur la conception de systèmes distribués et le big data.
Que vous prépariez un entretien ou souhaitiez concevoir une application distribuée ou orientée microservices, cette liste vous aidera.
Attention : le nombre d’étoiles sur GitHub ne reflète pas l’utilisation ni la popularité de chaque élément répertorié.
Inspiré par Awesome-BigData
Créé par Gabriel Leon de Mattos
Sommaire
Section intitulée « Sommaire »- Relational Database
- NoSQL
- Systèmes de fichiers distribués
- Gestion des ressources
- Traitement de flux
- Courtier de messages
- Répartiteurs de charge
- Écosystème Hadoop
- Framework REST
Articles
Section intitulée « Articles »Introduction / entretiens
Section intitulée « Introduction / entretiens »-
System Design Primer - [109k ⭐] - Superbe compilation de ressources, y compris des jeux de cartes mémoire Anki.
-
System Design Interview Questions - Concepts you should know - Une liste organisée de sujets pour vous présenter la conception de systèmes.
-
Grokking the System Design Interview - [Paid 💵] - La préparation à la conception de systèmes Grokking est l’un des cours dont on parle le plus. La meilleure chose à ce sujet est la conception des applications qu’il suggère plutôt que des explications sur ce que chaque outil est censé faire.
-
System Design in Software Development - Article de base sur les thèmes de la conception et de l’architecture du système.
-
System Design - Ressources de préparation à l’entretien d’introduction.
-
Design Pattern for Distributed Systems - Article parlant de certains modèles ainsi que de certaines technologies à considérer.
-
Practice system design problems using AI on Codemia.io - Un outil qui vous permet de pratiquer des problèmes de conception de systèmes de manière interactive, comme un entretien avec l’IA. Il y a un retour itératif et une évaluation finale qui notent votre performance
-
Distributed Computing - Article Wikipédia élargissant la vision de la conception de systèmes distribués.
-
Fallacies of Distributed Computing - Article Wikipédia présentant le sujet des erreurs de l’informatique distribuée et de ses effets.
-
Fallacies of Distributed Computing Explained - Explication approfondie des erreurs mentionnées ci-dessus.
-
CAP Theorem - Article IBM sur le théorème CAP, les microservices et les bases de données NoSQL.
-
Pattern: Microservice Architecture - Bon article parlant de l’architecture Microservice ainsi que de ses inconvénients.
-
Taxonomy of Distributed Systems - Cours de 11 pages classifiant les systèmes distribués et expliquant spécifiquement pourquoi nous en avons besoin.
-
Top 10 Secure Coding Practices - Bref article parlant des bonnes pratiques en matière de sécurité du code.
-
Scalable Web Architecture and Distributed Systems - Bon article sur les systèmes distribués ainsi que certains des outils potentiels.
-
Designing Distributed Systems: Patterns and Paradigms for Scalable, Reliable Services - [Paid 💵] - Livre qui parle des systèmes distribués et démontre légèrement un peu de code de ce à quoi il ressemble.
-
Designing Data Intensive Applications - [Paid 💵] - Il explique en profondeur diverses ressources que nous utilisons lorsque nous travaillons avec des systèmes distribués, ainsi que comment ils sont nés et quels problèmes ils visent à résoudre.
-
The System Design Manual - [Paid 💵] - Couvre les aspects fondamentaux des systèmes distribués, tels que : les principes fondamentaux du réseau, la théorie qui sous-tend les systèmes distribués, les modèles architecturaux de systèmes évolutifs, les modèles de stabilité qui renforcent les systèmes contre les pannes et les meilleures pratiques opérationnelles sur la façon de maintenir des systèmes à grande échelle avec une petite équipe.
-
Building Microservices - [Free 👍] - Un livre génial qui parle en profondeur de la conception d’une architecture système avec des microservices et comprend les sujets les plus pertinents à cet égard.
-
Monolith to Microservices - [Free 👍] - Écrit par le même auteur que celui ci-dessus, ce livre couvrira la migration de Monolith vers Microservices, il est recommandé de commencer par le livre précédent.
-
Distributed Systems (3rd Edition) - [Free 👍] - Excellent aperçu et introduction approfondie aux systèmes distribués. Recommandé pour les lecteurs de niveau intermédiaire.
-
Safe by Design - [Free 👍] - Excellent livre sur l’application de l’exactitude du code dès la conception.
Une collection de vidéos sur les systèmes distribués.
Introduction / entretiens
Section intitulée « Introduction / entretiens »-
Gaurav Sen - System Design Series - Bonne ressource pour les personnes qui souhaitent en savoir plus sur la conception de systèmes, présente le sujet d’une manière très simple à comprendre.
-
Tech Dummies - System Design Series - Une autre introduction à la conception de systèmes.
-
Mock System Design Interview at Google - Aperçu de ce à quoi ressemblerait un entretien sur la conception du système du point de vue d’une satisfaction imparfaite mais proche des exigences. L’essentiel ici est la façon dont se déroule l’interaction avec l’intervieweur.
-
Google Preparation Guide - Une vidéo rapide expliquant comment ils interviewent.
-
System Design Interview - Chaîne YouTube axée sur le contenu spécifique aux entretiens sur la conception du système, avec une explication détaillée d’une variété de problèmes.
-
Intro to Architecture and System Design Interviews - Une vidéo YouTube avec Jackson Gabbard avec de bonnes informations sur les entretiens de conception de systèmes.
-
System Design Introduction for Interview - Introduction de Tushar à la conception de systèmes.
-
Distributed Systems - Il s’agit d’un cours d’introduction aux systèmes distribués réalisé par Chris Colohan. Il a obtenu son doctorat à Carnegie Mellon, puis a passé 10 ans à travailler chez Google pour créer des systèmes distribués.
-
The Easy Way - Chaîne à venir avec des vidéos faciles à comprendre sur les systèmes distribués.
-
System Design by SDE Skills - Bonne ressource pour les personnes qui se préparent aux entretiens de conception de système, il existe plusieurs simulations d’entretiens de conception de système et des analyses approfondies.
-
System Design by CodeKarle - Une autre excellente ressource gratuite, une liste de questions d’entretien fréquemment posées.
- The evolution of Reddit Architecture - Aperçu de la façon dont la conception du système Reddit a évolué.
- 6.824 Distributed Systems by MIT - Cours de niveau supérieur sur les systèmes distribués du MIT (2020).
- CSE138 Distributed Systems by UCSC - Cours de premier cycle sur les systèmes distribués de l’UCSC (2020).
- Une sélection des outils les plus courants pour les systèmes distribués
Système de gestion de base de données relationnelle
Section intitulée « Système de gestion de base de données relationnelle »-
MariaDB - MariaDB est un fork du serveur MySQL.
-
MySQL - Base de données relationnelle largement utilisée.
-
PostgresSQL - Base de données relationnelle qui gagne en popularité.
-
SQLite - Une autre base de données largement utilisée, intégrée à tous les téléphones mobiles et à la plupart des ordinateurs.
-
Sql Server - Base de données relationnelle largement utilisée.
Cache (clé-valeur)
Section intitulée « Cache (clé-valeur) »-
Apache Ignite - [3.3k ⭐] - Mise en cache en mémoire avec les propriétés ACID.
-
Couchbase - Inspiré de Memcached, ajoutant des fonctionnalités telles que la réplication et la persistance.
-
Oracle Coherence - [126 ⭐] - Mise en cache en mémoire à haute évolutivité et à faible latence.
-
Memcached - [10.2k ⭐] - L’une des premières bases de données de mise en cache en mémoire, très performante et multithread.
-
Redis - [44k ⭐] - Base de données de mise en cache en mémoire largement utilisée avec de nombreuses fonctionnalités supplémentaires telles que le stockage persistant et la prise en charge des chaînes, des listes, des ensembles, des hachages, des flux, des bitmaps, etc.
Stockage (clé-valeur)
Section intitulée « Stockage (clé-valeur) »-
Apple FoundationDB - [10k ⭐] - Multi-modèle (plusieurs types de données dans une seule base de données), magasin clé-valeur ACID. Facilement évolutif et tolérant aux pannes.
-
Cosmos DB - Service de base de données multimodèle distribué à l’échelle mondiale de Microsoft. Adaptez le débit et le stockage de manière simple et indépendante. API SQL, MongoDB, Cassandra, Tables, Gremlin et Spark.
Stockage de documents
Section intitulée « Stockage de documents »-
CouchDB - [4.6k ⭐] - La base de données de stockage de documents NoSQL conforme à ACID fournit une API HTTP RESTful pour la lecture et la mise à jour des documents de base de données.
-
MongoDB - L’une des bases de données « NoSQL » les plus populaires à usage général.
-
RethinkDB - [23.8k ⭐] - Base de données de stockage de documents.
-
ElasticSearch - [49.9k ⭐] - Base de données « NoSQL » très populaire pour les moteurs de recherche rapides et évolutifs.
-
Cosmos DB - Service de base de données multimodèle distribué à l’échelle mondiale de Microsoft. Adaptez le débit et le stockage de manière simple et indépendante. API SQL, MongoDB, Cassandra, Tables, Gremlin et Spark.
Stockage à colonnes larges
Section intitulée « Stockage à colonnes larges »-
Amazon DynamoDB - Base de données de valeurs-clés et de documents, hautement performante, évolutive et sécurisée.
-
Google Bigtable - Base de données ‘NoSQL’ évolutive et performante pour une charge de travail analytique et opérationnelle importante.
-
Cassandra - Projet né sur Facebook très rapide, facilement évolutif, avec possibilité d’inclure une cohérence à chaque opération.
-
Scylla - [4.9k ⭐] - Magasin de données ‘NoSQL’ utilisant le framework seastar, compatible avec Cassandra.
-
HBase - [3.6k ⭐] - Inspiré de Bigtable de Google et écrit en Java. Développé dans le cadre du projet Apache Hadoop et fonctionne sur HDFS ou Alluxio. (Voir Hadoop Related)
-
Cosmos DB - Service de base de données multimodèle distribué à l’échelle mondiale de Microsoft. Adaptez le débit et le stockage de manière simple et indépendante. API SQL, MongoDB, Cassandra, Tables, Gremlin et Spark.
-
Amazon Neptune - Service de base de données graphique rapide, fiable et entièrement géré.
-
ArangoDB - [10k ⭐] - Base de données flexible pour les documents, les valeurs-clés et les graphiques. Utilise son propre langage de requête, AQL.
-
Neo4j - [7.9k ⭐] - Bon support pour une base de données graphique, conforme à ACID et flexible.
-
Cosmos DB - Service de base de données multimodèle distribué à l’échelle mondiale de Microsoft. Adaptez le débit et le stockage de manière simple et indépendante. API SQL, MongoDB, Cassandra, Tables, Gremlin et Spark.
Systèmes de fichiers distribués
Section intitulée « Systèmes de fichiers distribués »-
HDFS - Le système de fichiers Hadoop est un choix très populaire parmi ses concurrents Big Data, offrant un accès à haut débit.
-
Lustre - Système de fichiers pour les clusters d’ordinateurs.
-
CephFS - Système de stockage unifié et distribué.
-
GlusterFS - Système de fichiers NAS évolutif.
-
MooseFS - Système de fichiers distribué conforme à POSIX.
-
XtreemFS - Système de fichiers tolérant aux pannes.
Gestion des ressources
Section intitulée « Gestion des ressources »- Kubernetes - Moyen très populaire de déployer, gérer et faire évoluer automatiquement un cluster de conteneurs sur des serveurs nus ou virtuels.
Traitement de flux
Section intitulée « Traitement de flux »-
Apache Samza - Créez des applications avec état qui traitent les données en temps réel provenant de plusieurs sources, y compris Kafka. Modèle multi-abonné simple et peu coûteux, peut éliminer la contre-pression et offre une persistance fiable avec une faible latence.
-
Apache Flink - Basé sur le concept de flux et de transformations. Utilise maven, gère les tâches par lots sous forme de flux de données avec des limites finies. Faible latence, débit élevé.
-
Amazon Kinesis Streams - Service durable, évolutif et en temps réel. Collecte des gigaoctets de données par seconde à partir de centaines de milliers de sources, notamment les flux d’événements de bases de données, les flux de clics de sites Web, les transactions financières, etc.
-
Azure Stream Analytics - Service d’analyse en temps réel conçu pour les charges de travail critiques.
Courtier de messages
Section intitulée « Courtier de messages »-
Amazon MQ - Courtier de messages open source d’Amazon.
-
Apache ActiveMQ - Il s’agit d’un serveur de messagerie multiprotocole basé sur Java.
-
Apache Kafka - Courtier de messages très populaire avec une faible latence pour le streaming de données.
-
RabbitMQ - Léger très populaire courtier de messages écrit en erlang qui prend également en charge plusieurs protocoles de messagerie.
-
IronMQ - Courtier de messagerie très rapide et hautement évolutif. (pas open source)
-
Apache Pulsar - Créé par Yahoo, également hautement évolutif, faible latence, géo-réplication et multi-tenacy.
-
Kestrel - Écrit en Scala et parle le protocole memcached. Cela fonctionne un peu comme Kafka.
-
Azure Service Bus - Un courtier de messages d’intégration d’entreprise entièrement géré.
Répartiteurs de charge
Section intitulée « Répartiteurs de charge »Logiciels libres
Section intitulée « Logiciels libres »-
SeeSaw - [5.1k ⭐] - Utilisé par Google, développé en Go, serveur d’équilibrage de charge virtuel basé sur Linux.
-
HAProxy - Option très populaire, offre une haute disponibilité, un proxy et un équilibrage de charge TCP/HTTP. Utilisé par Reddit, Imgur, MaxCDN, GitHub, AirBNB.
-
Zevenet - Prend en charge L3, L4 et L7. Installation facile avec un dépôt Docker. Prend en charge la surveillance avancée des contrôles de santé.
-
Neutrino - Utilisé par eBay, construit avec Scala et Netty. Prend en charge les algorithmes de round-robin et de moindre connexion.
-
Nginx - Attendez, Nginx n’est-il pas un serveur Web ? Oui, l’open source prend en charge le niveau de base de commutation de contenu et de routage des requêtes. L’édition Plus prend en charge l’équilibrage de charge, le WAF, la surveillance, etc.
-
Openresty - Nginx + Lua, combinaison parfaite.
Matériel
Section intitulée « Matériel »-
F5 - Option d’équilibrage de charge matérielle robuste, prenant en charge plusieurs protocoles (IP, TCP, FTP, UDP, HTTP).
-
TP-Link - Alternative moins chère qui fonctionne comme un équilibreur de charge.
-
Barracuda - L’un des meilleurs choix pour l’équilibrage de charge lorsqu’il s’agit de serveurs internes. Mesures de sécurité de pointe intégrées, rapports complets et surveillance du trafic sortant pour prévenir la perte de données.
-
Amazon Elastic Load Balancing - Choix populaire pour les clients Amazon, prend en charge les fonctions lambda, hautement évolutif.
-
Google Load Balancing - Choix populaire pour les clients de Google, livré avec une fonction de mise à l’échelle automatique, très rapide, avec CDN intégré.
-
Cloudflare Load Balancing - Équilibrage de charge évolutif par Cloudflare, fonctionnalité de basculement rapide et un tableau de bord.
-
DigitalOcean Load Balancing - Si vous êtes client digitalocean, c’est une bonne option, très bon marché, disponible régionalement, évolutive, facile à déployer parmi vos autres droplets.
-
Azure Load Balancing - Choix populaire pour les clients Azure de Microsoft. Prend en charge les trafics internes et externes, IPv6, la surveillance et l’ensemble de fonctionnalités d’équilibrage de charge standard.
Écosystème Hadoop
Section intitulée « Écosystème Hadoop »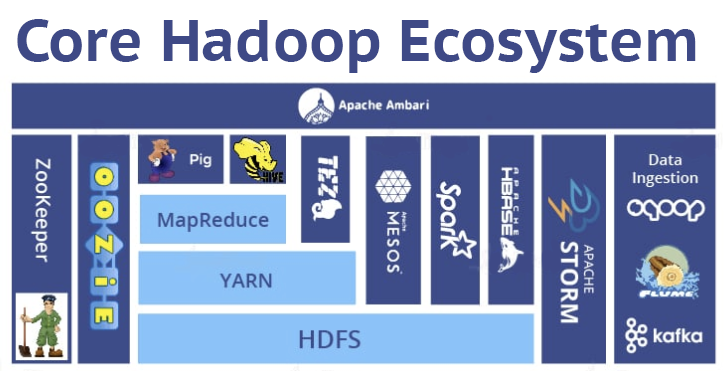
Tableau de bord
Section intitulée « Tableau de bord »- Ambari - Tableau de bord qui intègre la plupart des technologies liées à Hadoop pour une gestion et des exécutions faciles.
Ingestion des données
Section intitulée « Ingestion des données »-
Sqoop - Transférez efficacement des données entre Hadoop et des banques de données structurées telles que des bases de données relationnelles.
-
Flume - Distribué, hautement disponible et efficace pour collecter, agréger et déplacer de grandes quantités de données de journaux.
-
Apache Kafka - Courtier de messages très populaire avec une faible latence pour le streaming de données.
Planificateur de workflows
Section intitulée « Planificateur de workflows »- Oozie - Créez des flux de travail au format XML pour exécuter des tâches (à partir d’autres applications de l’écosystème Hadoop) par étapes, ce qui permet également une exécution parallèle.
- Hive - Interrogez les données stockées par Hadoop dans SQL.
- Pig - Langage de script qui ressemble à SQL pour interroger les données Hadoop.
Traitement
Section intitulée « Traitement »- Tez - Résout un problème similaire à Spark et MapReduce, il est plus efficace que MapReduce car il calcule la manière la plus efficace de le faire.
- Map Reduce - MapReduce, comme son nom l’indique, cartographie les données et réduit les résultats.
- Spark - Un traitement de données puissant non seulement pour traiter des données comme Tez (et MapReduce), mais aussi pour traiter des flux de données en temps réel, appliquer des algorithmes d’analyse de régression en ML et bien plus encore.
- Apex - *Projet retiré, il s’agit d’une plate-forme native YARN qui unifie le traitement par flux et par lots.
Base de données
Section intitulée « Base de données »- HBase - [3.6k ⭐] - Inspiré de Bigtable de Google et écrit en Java. Développé dans le cadre du projet Apache Hadoop.
Gestion des ressources
Section intitulée « Gestion des ressources »- YARN - « Pourtant, un autre négociateur de ressources » fonctionne comme un noyau pour gérer les ressources informatiques à travers les clusters.
- MESOS - Fonctionne comme un noyau Linux en gérant le processeur, la mémoire, le stockage et d’autres ressources sur le cluster.
Framework REST
Section intitulée « Framework REST »-
Gin - [40.6k ⭐] - Framework de microservices incroyablement rapide utilisant Golang, capacité de débit élevée.
-
Phoenix - [15.5k ⭐] - Traitement distribué, facilement évolutif, prise en charge des canaux et du chat en direct. Ce framework - écrit en Elixir, utilise BEAM et Erlang, très efficaces pour les systèmes à grande échelle et prend en charge un débit élevé.
-
Express.js - [49.6k ⭐] - API de repos node.js rapide qui peut bien fonctionner dans de nombreux scénarios.
-
Rails - [46.2k ⭐] - Écrit en Ruby, Rails fournit des API rapides du prototype à la production de manière efficace.
-
Play Framework - [11.6k ⭐] - Framework très rapide et à haut débit écrit en Scala/Java et RESTful par défaut.
-
Flask - [51.6k ⭐] - Un microframework Python léger pour un prototypage et une production rapides.
-
FastAPI - [22.7k ⭐] - Un microframework Python léger inspiré de Flask mais plus moderne, utilisant Python async.
-
Django REST - [18.4k ⭐] - Écrit en Python, Django Rest est une API REST puissante et flexible. L’efficacité et les délais de commercialisation ressemblent à ceux de Rails.
-
ASP.NET Core MVC - Un cadre riche pour créer des applications Web et des API à l’aide du modèle de conception Model-View-Controller en C# ou F#. Numéro 6 sur TechEmpower Composite Benchmarks pour les frameworks web.
-
Fastify - [15.4k ⭐] - Un framework Web Node.js hautement axé sur la fourniture de la meilleure expérience de développement avec le moins de frais généraux et une architecture de plugin puissante.
HagiCode
HagiCode est un espace de développement agentique. Des interactions d’interface riches et pratiques rendent la planification, l’exécution des agents et le travail sur les projets accessibles et faciles à suivre, pour une expérience de développement engageante.
Une expérience de développement engageante grâce à des interactions d’interface riches et pratiques.

- IntelligentLes workflows OpenSpec transforment une intention en parcours exécutable, de la proposition à la livraison en passant par la conception et les tâches.
- EfficaceL’exécution multi-agent fait avancer recherche, réalisation et revue en parallèle, sur plusieurs dépôts et avec les Agent CLI que vous utilisez déjà.
- IntéressantDes interactions d’interface riches et pratiques rendent la planification, l’exécution des agents et le travail sur les projets accessibles et faciles à suivre.
Télécharger pour Windows
Partager HagiCode

Transformez vos idées en logiciels livrés.
HagiCode est un espace de développement agentique : les workflows OpenSpec planifient le changement, l’exécution multi-agent le réalise et Hero Scenario rend le long parcours visible, pour transformer vos idées en logiciels livrés.
- Intelligent
- Les workflows OpenSpec transforment une intention en parcours, de la proposition à la livraison.
- Efficace
- L’exécution multi-agent mène recherche, réalisation et revue en parallèle.
- Ludique
- Les interactions d’interface facilitent la planification, l’exécution des agents et les projets.
© 2026 HagiCode | Powered By hagilight-starlight@0.21.0 | Branch: main | Commit: 745b50b | Built: