
Production Machine Learning
Source: https://github.com/EthicalML/awesome-production-machine-learning at
4efc0a16249c
License: MIT
Read the English original
This edition is an AI-assisted translation.


Awesome Production Machine Learning
Section intitulée « Awesome Production Machine Learning »Ce dépôt rassemble une sélection de bibliothèques open source remarquables pour déployer, surveiller, versionner, mettre à l’échelle et sécuriser des systèmes de machine learning en production 🚀
Pour rester au courant, suivez ce dépôt GitHub : vous recevrez chaque mois, via les releases, un récapitulatif des nouvelles bibliothèques de ML en production 🤩
Nous proposons également une boîte à outils de recherche pour parcourir rapidement cet ensemble d’outils.
Accès rapide aux sections de cette page
Section intitulée « Accès rapide aux sections de cette page »Contribuer à la liste
Section intitulée « Contribuer à la liste »Veuillez consulter les exigences de CONTRIBUTING.md avant de proposer une PR, afin de nous aider à garder la liste propre et à jour. Merci à la communauté de contribuer à son développement continu 🚀
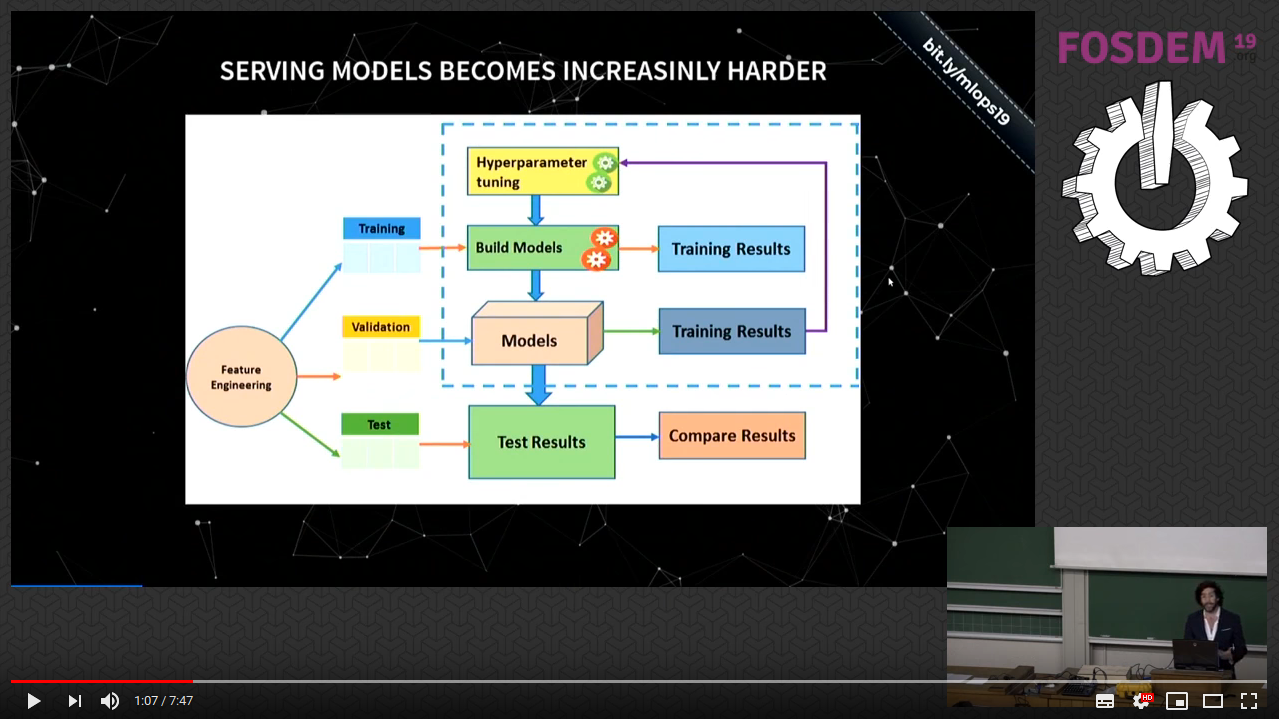
Présentation vidéo en 10 minutes
Section intitulée « Présentation vidéo en 10 minutes »| Cette vidéo de 10 minutes présente les raisons d’être du MLOps ainsi que quelques outils de ce dépôt. Cette vidéo plus récente fait le point sur l’état du MLOps dans sa version actualisée de 2024. |
|
Vous souhaitez recevoir régulièrement des nouvelles de ce dépôt et d’autres avancées ?
Section intitulée « Vous souhaitez recevoir régulièrement des nouvelles de ce dépôt et d’autres avancées ? »| Vous pouvez vous abonner à la newsletter Machine Learning Engineer. Rejoignez plus de 70 000 professionnels et passionnés du ML qui reçoivent chaque semaine des articles et tutoriels sélectionnés sur le machine learning en production. |
|
| Découvrez aussi la liste Awesome Production GenAI, qui rassemble une sélection de bibliothèques open source pour déployer, surveiller, versionner et mettre à l’échelle des applications et systèmes d’intelligence artificielle générative. |
|
Contenu principal
Section intitulée « Contenu principal »- AIDE
 - AIDE est un agent d’ingénierie ML open source qui utilise un algorithme de recherche arborescente pour explorer, mettre en œuvre et évaluer de manière autonome des stratégies de résolution de tâches de machine learning.
- AutoGluon
 - Sélection automatisée de caractéristiques, de modèles et d’hyperparamètres pour les données tabulaires, les images et le texte, reposant sur des bibliothèques de machine learning populaires (Scikit-Learn, LightGBM, CatBoost, PyTorch, MXNet).
- Autokeras
 - Bibliothèque AutoML pour Keras fondée sur « Auto-Keras: Efficient Neural Architecture Search with Network Morphism ».
- auto-sklearn
 - Framework qui automatise le réglage des algorithmes et des hyperparamètres pour sklearn.
- Ax
 - Ax est une plateforme accessible et polyvalente pour comprendre, gérer, déployer et automatiser des expériences adaptatives.
- BoTorch
 - BoTorch est une bibliothèque d’optimisation bayésienne conçue sur PyTorch.
- EvalML
 - EvalML est une bibliothèque AutoML qui construit, optimise et évalue des pipelines de machine learning à l’aide de fonctions objectif propres au domaine.
- Feature Engine
 - Feature-engine est une bibliothèque Python qui contient plusieurs transformateurs pour créer des caractéristiques destinées aux modèles de machine learning.
- Featuretools
 - Framework open source pour l’ingénierie automatisée des caractéristiques.
- FLAML
 - FLAML est une bibliothèque rapide pour le machine learning automatisé et le réglage des modèles.
- HEBO
 - Ensemble de frameworks open source d’optimisation des hyperparamètres, dont le projet lauréat du NeurIPS 2020 Black-Box Optimisation Challenge, testé sur des tâches de réglage d’hyperparamètres.
- Katib
 - Système de réglage des hyperparamètres et de recherche d’architectures neuronales fondé sur Kubernetes.
- keras-tuner
 - Keras Tuner est un framework de réglage des hyperparamètres facile à utiliser et distribuable, qui résout les difficultés de la recherche d’hyperparamètres. Il permet de définir facilement un espace de recherche et d’utiliser les algorithmes intégrés pour trouver les meilleures valeurs.
- Optuna
 - Optuna est un framework logiciel d’optimisation automatique des hyperparamètres, conçu notamment pour le machine learning.
- OSS Vizier
 - OSS Vizier est un service Python d’optimisation en boîte noire et de recherche, l’un des premiers services de réglage des hyperparamètres conçus pour fonctionner à grande échelle.
- Perpetual
 - Machine de boosting par gradient qui ne nécessite pas d’optimisation des hyperparamètres ; un simple paramètre de budget permet de contrôler la complexité du modèle.
- TPOT
 - Automatisation de la création de pipelines sklearn (y compris la sélection de caractéristiques, le prétraitement, etc.).
- tsfresh
 - Extraction automatique de caractéristiques pertinentes à partir de séries temporelles.
Optimisation du calcul et de la communication
Section intitulée « Optimisation du calcul et de la communication »- Accelerate
 - Accelerate n’abstrait que le code répétitif lié au multi-GPU/TPU et à la précision mixte ; le reste de votre code demeure inchangé.
- Adapters
 - Adapters est une bibliothèque unifiée pour l’apprentissage par transfert modulaire et économe en paramètres.
- Cache-DiT
 - Cache-DiT repose sur Diffusers et prend en charge presque tous les DiT. Il fournit une accélération hybride par cache (DBCache, TaylorSeer, SCM, etc.) ainsi que des optimisations complètes du parallélisme : parallélisme de contexte, de tenseurs et parallélisme hybride 2D/3D, avec compatibilité pour la compilation, le déchargement vers le CPU et la quantification.
- Colossal-AI
 - Système unifié d’apprentissage profond pour l’ère des grands modèles, qui aide à déployer rapidement et efficacement l’entraînement et l’inférence de grands modèles d’IA.
- Composer
 - Composer est une bibliothèque PyTorch qui permet d’entraîner des réseaux neuronaux plus rapidement, à moindre coût et avec une meilleure précision.
- CuDF
 - Fondée sur le format mémoire colonnaire Apache Arrow, cuDF est une bibliothèque GPU de DataFrames permettant de charger, joindre, agréger, filtrer et manipuler des données.
- CuML
 - cuML est une suite de bibliothèques qui implémentent des algorithmes de machine learning et des fonctions primitives mathématiques, avec des API compatibles avec celles des autres projets RAPIDS.
- CuPy
 - Implémentation sur CUDA de tableaux multidimensionnels compatibles avec NumPy. CuPy comprend la classe centrale de tableaux multidimensionnels cupy.ndarray et de nombreuses fonctions associées.
- DEAP
 - Framework original de calcul évolutif permettant de prototyper et de tester rapidement des idées. Il vise à rendre les algorithmes explicites et les structures de données transparentes. Il s’intègre parfaitement aux mécanismes de parallélisation tels que multiprocessing et SCOOP.
- DeepEP
 - DeepEP est une bibliothèque de communication adaptée aux Mixture-of-Experts (MoE) et au parallélisme des experts (EP). Elle fournit des noyaux GPU all-to-all à haut débit et faible latence, également appelés dispatch et combinaison MoE. La bibliothèque prend aussi en charge les opérations en faible précision, notamment FP8.
- DGL
 - DGL est un package Python évolutif, performant et facile à utiliser pour l’apprentissage profond sur graphes.
- DLRover
 - DLRover simplifie l’entraînement distribué de grands modèles d’IA : il le rend facile, stable, rapide et écoresponsable.
- Dask
 - Framework de traitement parallèle distribué pour les calculs Pandas et NumPy.
- DeepSpeed
 - DeepSpeed est une bibliothèque d’optimisation de l’apprentissage profond qui rend l’entraînement et l’inférence distribués faciles, efficaces et performants.
- FlagGems
 - FlagGems est une bibliothèque générale d’opérateurs performants, implémentée dans OpenAI Triton. Elle s’appuie sur un ensemble de noyaux indépendants du backend visant à accélérer l’entraînement et l’inférence des LLM sur des plateformes matérielles variées.
- Flashlight
 - Bibliothèque de machine learning rapide et flexible, entièrement écrite en C++ par Facebook AI Research et les créateurs de Torch, TensorFlow, Eigen et Deep Speech.
- Flax
 - Bibliothèque de réseaux neuronaux et écosystème pour JAX, conçus pour offrir de la flexibilité.
- GPUStack
 - GPUStack est un gestionnaire open source de clusters GPU destiné à l’exécution de modèles d’IA.
- Hivemind
 - Apprentissage profond décentralisé avec PyTorch.
- Jax
 - Transformations composables de programmes Python+NumPy : différentiation, vectorisation, compilation JIT pour GPU/TPU, et bien plus.
- Kompute
 - Framework de calcul Vulkan rapide, léger et compatible avec les téléphones mobiles, optimisé pour les usages avancés de traitement de données sur GPU.
- Liger Kernel
 - Liger Kernel est un ensemble de noyaux Triton spécialement conçus pour l’entraînement des LLM.
- LightGBM
 - LightGBM est un framework de boosting par gradient qui utilise des algorithmes d’apprentissage fondés sur des arbres.
- MLX
 - MLX est un framework de tableaux destiné au machine learning sur les puces Apple.
- Modin
 - Accélérez vos workflows Pandas en ne modifiant qu’une seule ligne de code.
- NVIDIA TensorRT
 - TensorRT est une bibliothèque C++ destinée à l’inférence haute performance sur les GPU NVIDIA et les accélérateurs d’apprentissage profond.
- Nevergrad
 - Nevergrad est une plateforme d’optimisation sans gradient.
- Norse
 - Norse vise à exploiter les avantages des composants neuronaux inspirés de la biologie, clairsemés et déclenchés par événements, une différence fondamentale par rapport aux réseaux neuronaux artificiels.
- Numba
 - Compilateur pour les fonctions Python de calcul numérique et sur tableaux.
- Optimum
 - Optimum étend Transformers et Diffusers en fournissant des outils d’optimisation qui maximisent l’efficacité de l’entraînement et de l’exécution des modèles sur le matériel visé, tout en restant faciles à utiliser.
- PEFT
 - Les méthodes PEFT (Parameter-Efficient Fine-Tuning) permettent d’adapter efficacement des modèles de langue préentraînés (PLM) à diverses tâches en aval sans ajuster tous leurs paramètres.
- PaddlePaddle
 - PaddlePaddle est un framework pour l’entraînement de réseaux profonds à grande échelle, utilisant des sources de données réparties sur des centaines de nœuds.
- PyG
 - PyG (PyTorch Geometric) est une bibliothèque construite sur PyTorch qui facilite l’écriture et l’entraînement de réseaux neuronaux sur graphes (GNN) pour de nombreuses applications liées aux données structurées.
- PyTorch Lightning
 - PyTorch Lightning préentraîne, ajuste finement et déploie des modèles d’IA sur plusieurs GPU et TPU sans modifier le code.
- PyTorch
 - PyTorch est une bibliothèque pour développer et entraîner des modèles d’apprentissage profond fondés sur des réseaux neuronaux.
- Ray
 - Ray est un framework d’exécution distribuée flexible et performant pour le machine learning.
- SetFit
 - SetFit est un framework efficace, sans prompt, pour l’ajustement fin en few-shot de Sentence Transformers.
- Sonnet
 - Sonnet est une bibliothèque construite sur TensorFlow 2, conçue pour fournir des abstractions simples et composables destinées à la recherche en machine learning.
- Streaming
 - Bibliothèque de diffusion de données pour entraîner efficacement des réseaux neuronaux.
- TensorFlow
 - TensorFlow est une bibliothèque de premier plan conçue pour développer et déployer des applications de machine learning de pointe.
- ThunderKittens
 ThunderKittens est un framework qui facilite l’écriture de noyaux d’apprentissage profond rapides en CUDA.
- TorchOpt
 - TorchOpt est une bibliothèque efficace d’optimisation différentiable fondée sur PyTorch.
- Triton
 - Triton est un langage et un compilateur permettant d’écrire des primitives personnalisées d’apprentissage profond très efficaces. Son objectif est de fournir un environnement open source pour produire rapidement du code avec une productivité supérieure à CUDA, tout en offrant davantage de flexibilité que les autres DSL existants.
- Vaex
 Vaex est une bibliothèque Python performante pour les DataFrames différés hors mémoire (similaires à Pandas), qui permet de visualiser et d’explorer de grands jeux de données tabulaires. Vaex utilise le mappage mémoire, la copie mémoire nulle et les calculs différés pour offrir les meilleures performances sans gaspiller de mémoire.
- Vowpal Wabbit
 Vowpal Wabbit est un système de machine learning qui repousse les limites du domaine grâce à des techniques telles que l’apprentissage en ligne, le hachage, allreduce, les réductions, learning2search, l’apprentissage actif et interactif.
- XGBoost
 - XGBoost est une bibliothèque optimisée de boosting par gradient distribué, conçue pour être très efficace, flexible et portable.
- YDF
 - YDF (Yggdrasil Decision Forests) est une bibliothèque pour entraîner, évaluer, interpréter et servir des modèles de forêts aléatoires, d’arbres de décision boostés par gradient, CART et Isolation Forest.
- bitsandbytes
 - La bibliothèque Bitsandbytes est une fine couche Python autour de fonctions CUDA personnalisées, notamment des optimiseurs 8 bits, la multiplication matricielle (LLM.int8()) et des fonctions de quantification 8 et 4 bits.
- einops
 - Opérations sur tenseurs flexibles et puissantes, pour un code lisible et fiable.
- scikit-learn
 - Scikit-learn est une puissante bibliothèque de machine learning offrant de nombreux modules d’accès aux données, de préparation des données et de construction de modèles statistiques.
- snnTorch
 - snnTorch est une bibliothèque d’apprentissage profond et en ligne reposant sur des réseaux neuronaux à impulsions.
- torchdistill
 - torchdistill propose diverses méthodes de distillation des connaissances de pointe et permet de concevoir de nouvelles expériences en modifiant simplement un fichier de configuration YAML déclaratif plutôt que du code Python.
- torchkeras
 La bibliothèque torchkeras est un outil simple pour entraîner des réseaux neuronaux avec PyTorch, dans le style de Keras.
- veScale
 - veScale est un framework natif PyTorch pour l’entraînement des LLM.
- yellowbrick
 - yellowbrick propose des graphiques d’évaluation de modèles fondés sur matplotlib pour scikit-learn et d’autres bibliothèques de machine learning.
Annotation et synthèse des données
Section intitulée « Annotation et synthèse des données »- Argilla
 - Argilla aide les experts métier et les équipes de données à créer de meilleurs jeux de données NLP en moins de temps.
- cleanlab
 - Bibliothèque Python pour l’IA centrée sur les données. Elle peut automatiquement repérer les données mal étiquetées et les valeurs aberrantes, estimer le consensus et la qualité des annotateurs pour les jeux de données à annotations multiples, et suggérer les données à réétiqueter ensuite.
- COCO Annotator
 - Outil Web de segmentation d’images pour la détection d’objets, la localisation et les points clés.
- CVAT
 - CVAT (Computer Vision Annotation Tool) est l’outil d’annotation Web d’OpenCV pour les vidéos et les images destinées aux algorithmes de vision.
- Doccano
 - Outil open source d’annotation de texte par des personnes, proposant des fonctions d’analyse des sentiments, de reconnaissance d’entités nommées et de traduction automatique.
- Label Studio
 - Outil d’étiquetage et d’annotation des données pour plusieurs domaines, avec un format de sortie standardisé.
- LightlyStudio
 - Outil open source pour organiser, annoter et gérer des jeux de données de vision (images et vidéos). Il prend en charge la sélection automatique fondée sur les embeddings, l’annotation et l’étiquetage automatique des boîtes englobantes et des segmentations.
- NeMo Curator
 - NeMo Curator est un framework accéléré par GPU pour organiser efficacement les données de grands modèles de langue.
- refinery
 - Le choix open source des spécialistes des données pour mettre à l’échelle, évaluer et maintenir des données en langage naturel.
- SDV
 - Synthetic Data Vault (SDV) est un écosystème de bibliothèques de génération de données synthétiques. Il permet d’apprendre facilement des jeux de données à table unique, multitabulaire ou temporels, puis d’en générer de nouveaux conservant le format et les propriétés statistiques des originaux.
- Semantic Segmentation Editor
 - Outil open source de Hitachi pour étiqueter des données de caméras et de LIDAR.
- synthcity
 - synthcity est une bibliothèque de génération et d’évaluation de données tabulaires synthétiques.
- TabGAN
 - Génération de données tabulaires synthétiques à l’aide de GAN (CTGAN), de modèles de diffusion et de LLM, avec filtrage adversarial, mesures de confidentialité et intégration à sklearn.
- ViPE
 - ViPE est un outil d’IA spatiale pour annoter les poses de caméra et les cartes de profondeur denses à partir de vidéos brutes.
- YData Synthetic
 - YData Synthetic est un package de génération de données tabulaires et temporelles synthétiques exploitant les modèles génératifs de pointe.
Pipelines de données
Section intitulée « Pipelines de données »- Apache Airflow
 - Framework de pipelines de données écrit en Python, avec ordonnanceur, définition de DAG et interface de visualisation.
- Apache Nifi
 - Apache NiFi a été conçu pour les flux de données. Il prend en charge des graphes orientés très configurables pour le routage, la transformation et la médiation des systèmes.
- Argo Workflows
 - Argo Workflows est un moteur de workflow open source natif des conteneurs, qui orchestre des tâches parallèles sur Kubernetes. Il est implémenté sous la forme d’une CRD Kubernetes (Custom Resource Definition).
- Couler
 - Interface unifiée pour construire et gérer des workflows de machine learning sur différents moteurs, comme Argo Workflows, Tekton Pipelines et Apache Airflow.
- DataTrove
 - DataTrove est une bibliothèque permettant de traiter, filtrer et dédupliquer des données textuelles à très grande échelle.
- Dagster
 - Orchestrateur de données pour le machine learning, l’analytique et l’ETL.
- DBT
 - Outil ETL pour exécuter des transformations dans les entrepôts de données.
- Flyte
 - Plateforme de machine learning natif du cloud et de traitement des données de Lyft - (Démo).
- Genie
 - Moteur d’orchestration de tâches permettant de déclencher et de piloter l’exécution de tâches sur des systèmes fondés sur Hadoop.
- Hamilton
 - Hamilton est un framework de micro-orchestration pour définir des flux de données. Il fonctionne partout où Python s’exécute (p. ex. Jupyter, FastAPI, Spark, Ray, Dask). Il apporte les bonnes pratiques de l’ingénierie logicielle sans que vous ayez à les connaître. Utilisez-le pour définir des transformations d’ingénierie des caractéristiques, des pipelines de modèles de bout en bout et des workflows LLM. Il complète les systèmes de macro-orchestration (p. ex. Kedro, Luigi, Airflow, dbt) en remplaçant le code de leurs tâches. Son interface auto-hébergeable recueille la lignée et la provenance, la télémétrie d’exécution et les résumés de données, puis construit un catalogue autoalimenté utilisable en développement comme en production.
- Instill VDP
 - Instill VDP (Versatile Data Pipeline) vise à simplifier les pipelines de traitement des données, de leur création à leur achèvement.
- Instructor
 - Instructor facilite l’obtention de données structurées, comme JSON, à partir de LLM tels que GPT-3.5, GPT-4, GPT-4-Vision et de modèles open source.
- Kedro
 - Kedro est un outil de développement de workflows qui aide à créer des pipelines de données robustes, évolutifs, déployables, reproductibles et versionnés.
- Luigi
 - Luigi est un module Python qui aide à construire des pipelines complexes de tâches par lots et gère la résolution des dépendances, les workflows, la visualisation, etc.
- Metaflow
 - Framework qui permet aux spécialistes des données de créer et gérer facilement des projets de science des données réels.
- Pachyderm
 - Framework de traitement distribué open source fondé sur Kubernetes, principalement axé sur la construction dynamique de pipelines de machine learning en production - (Vidéo).
- Pixeltable
 – Bibliothèque Python open source qui fournit une infrastructure de données déclarative et incrémentale pour créer et gérer des charges de travail d’IA multimodale.
- Prefect Core
 - Système de gestion de workflows qui facilite l’ajout de sémantique à vos pipelines de données : nouvelles tentatives, journalisation, mappage dynamique, mise en cache, notifications d’échec, et bien plus.
- SeqIO
 - SeqIO est une bibliothèque de traitement des données séquentielles destinées aux modèles de séquence en aval.
- Snakemake
 - Système de gestion de workflows pour des analyses de données reproductibles et évolutives.
- Towhee
 - Pipeline de machine learning polyvalent pour générer des vecteurs d’embedding à l’aide d’un ou de plusieurs modèles ML.
- unstructured
 - unstructured simplifie et optimise le workflow de traitement des données pour les LLM : ingestion et prétraitement d’images et de documents texte tels que PDF, HTML, documents Word, et bien d’autres.
- ZenML
 - ZenML est un framework MLOps extensible et open source pour créer des pipelines ML reproductibles, privilégiant le suivi automatique des métadonnées, la mise en cache et les nombreuses intégrations avec d’autres outils.
Notebooks de science des données
Section intitulée « Notebooks de science des données »- Apache Zeppelin
 - Notebook Web qui permet de réaliser des analyses interactives axées sur les données et de créer des documents collaboratifs avec SQL, Scala et d’autres langages.
- Deepnote
 - Deepnote remplace directement Jupyter avec une conception axée sur l’IA, une interface élégante, de nouveaux blocs et des intégrations natives aux données. Utilisez Python, R et SQL en local dans votre IDE préféré, puis passez au cloud Deepnote pour la collaboration en temps réel, l’agent Deepnote et le déploiement d’applications de données.
- Jupyter Notebooks
 - Environnements bac à sable Python accessibles sur le Web pour un développement reproductible.
- Marimo
 - Notebook Python réactif : exécutez des expériences reproductibles, lancez-le comme script, déployez-le comme application et versionnez-le avec Git.
- Papermill
 - Papermill est une bibliothèque permettant de paramétrer des notebooks et de les exécuter comme des scripts Python.
- Polynote
 - Polynote est un environnement expérimental de notebooks multilingues. Il prend actuellement en charge Scala et Python (avec ou sans Spark), SQL et Vega.
- RMarkdown
 - Le package rmarkdown est une nouvelle génération de l’implémentation de R Markdown, fondée sur Pandoc.
- Stencila
 - Stencila est une plateforme de création, de collaboration et de partage de contenus fondés sur les données, transparents et reproductibles.
- Voilà
 - Voilà convertit les notebooks Jupyter en applications Web autonomes, par exemple des tableaux de bord.
Optimisation du stockage des données
Section intitulée « Optimisation du stockage des données »- AIStore
 - AIStore est un système léger de stockage objet pouvant évoluer linéairement à chaque ajout d’un nœud de stockage, particulièrement adapté à l’apprentissage profond à l’échelle du pétaoctet.
- Alluxio
 - Système de stockage distribué virtuel qui fait le lien entre les frameworks de calcul et les systèmes de stockage.
- Apache Arrow
 - Représentation colonnaire des données en mémoire, compatible avec Pandas, les systèmes fondés sur Hadoop, etc.
- Apache Druid
 - Base de données analytique en temps réel hautement performante. Consultez cet article pour une introduction.
- Apache Hudi
 - Hudi est une plateforme de lac de données transactionnelle qui apporte directement les principales fonctions des entrepôts et bases de données aux lacs de données. Hudi convient aux charges de travail en flux et permet aussi de créer des pipelines incrémentiels par lots efficaces. Il prend en charge les moteurs de requête populaires, notamment Spark, Flink, Presto, Trino et Hive. Plus d’informations ici.
- Apache Iceberg
 - Iceberg est un format performant et conforme à ACID, conçu pour les très grandes tables analytiques (jusqu’à des dizaines de pétaoctets). Il apporte aux big data la fiabilité et la simplicité des tables SQL, tout en permettant à Spark, Trino, Flink, Presto, Hive et Impala de travailler simultanément et en toute sécurité sur les mêmes tables. Plus d’informations ici.
- Apache Ignite
 - Base de données distribuée centrée sur la mémoire, plateforme de mise en cache et de traitement pour les charges transactionnelles, analytiques et de flux, offrant des vitesses en mémoire à l’échelle du pétaoctet - Démo.
- Apache Parquet
 - Représentation colonnaire des données sur disque, compatible avec Pandas, les systèmes fondés sur Hadoop, etc.
- Apache Pinot
 - Magasin de données OLAP distribué en temps réel. Une comparaison des systèmes OLAP open source pour le big data (ClickHouse, Druid et Pinot) est disponible ici.
- Casibase
 - Casibase est une base de connaissances RAG (Retrieval-Augmented Generation) semblable à LangChain, avec interface Web et authentification unique d’entreprise (SSO).
- Chroma
 - Chroma est une base de données open source pour les embeddings.
- ClickHouse
 - ClickHouse est un système de gestion de base de données orienté colonnes et open source.
- Delta Lake
 - Delta Lake est une couche de stockage qui apporte des transactions ACID évolutives à Apache Spark et aux autres moteurs de big data.
- EdgeDB
 - Gel enrichit Postgres avec un modèle de données moderne, des requêtes sur graphes, des solutions d’authentification et d’IA, et bien plus encore.
- GPTCache
 - GPTCache est une bibliothèque permettant de créer un cache sémantique pour les requêtes adressées aux grands modèles de langue.
- InfluxDB
 Magasin de données évolutif pour les métriques, les événements et l’analytique en temps réel.
- Milvus
 Milvus est une base de données vectorielle open source native du cloud, conçue pour gérer les vecteurs d’embedding produits par les modèles de machine learning et les réseaux neuronaux.
- Marqo
 Marqo est un moteur de recherche vectorielle de bout en bout.
- pgvector
 pgvector permet d’effectuer des recherches de similarité vectorielle dans Postgres.
- PostgresML
 PostgresML est une extension de machine learning pour PostgreSQL qui permet d’entraîner des modèles et d’effectuer des inférences sur des données textuelles et tabulaires au moyen de requêtes SQL.
- Redis
 Redis est un magasin de données en mémoire open source qui prend en charge la recherche de similarité vectorielle et convient ainsi aux applications d’IA/ML telles que la recherche sémantique et les systèmes de recommandation.
- Safetensors
 Méthode simple et sûre pour stocker et distribuer des tenseurs.
- TimescaleDB
 Base de données SQL temporelle open source optimisée pour l’ingestion rapide et les requêtes complexes, distribuée comme extension PostgreSQL - (Vidéo).
- Weaviate
 - Moteur de recherche vectorielle à faible latence (GraphQL, REST) prenant en charge différents types de médias dès l’installation. Ses modules comprennent la recherche sémantique, les questions-réponses, la classification, les modèles personnalisables (PyTorch/TensorFlow/Keras), et bien plus.
- Zarr
 - Implémentation Python de tableaux multidimensionnels découpés en blocs et compressés, conçus pour le calcul parallèle.
Traitement des flux de données
Section intitulée « Traitement des flux de données »- Apache Beam
 Apache Beam est un modèle de programmation unifié pour le traitement par lots et en flux.
- Apache Flink
 - Framework open source de traitement des flux, doté de puissantes capacités de traitement par flux et par lots.
- Apache Kafka
 - Bibliothèque cliente Kafka pour créer des applications et des microservices dont les entrées et sorties sont stockées dans des clusters Kafka.
- Apache Samza
 - Framework distribué de traitement des flux. Il utilise Apache Kafka pour la messagerie et Apache Hadoop YARN pour assurer la tolérance aux pannes, l’isolation des processeurs, la sécurité et la gestion des ressources.
- Apache Spark
 - Traitement par micro-lots de flux avec Apache Spark comme backend, prenant en charge une sémantique « exactement une fois » avec état.
- Bytewax
 - Framework flexible de traitement de flux avec état, centré sur Python et construit sur un moteur Rust.
- FastStream
 - Framework Python moderne de traitement de flux, indépendant du broker, prenant en charge les protocoles Apache Kafka, RabbitMQ et NATS. Inspiré de FastAPI, il s’intègre facilement à d’autres frameworks Web.
- MOA
 - MOA (Massive Online Analysis) est un framework open source d’exploration de flux de big data.
- MosaicML Streaming - Diffusion rapide et déterministe de grands jeux de données depuis le stockage cloud pour l’entraînement distribué de modèles.
- RisingWave
 - Base de données SQL distribuée pour les flux, qui unifie le traitement de flux et le service à faible latence ; idéale pour créer et servir des caractéristiques destinées au machine learning en ligne.
- TensorStore
 - Bibliothèque de lecture et d’écriture de grands tableaux multidimensionnels.
Déploiement et service
Section intitulée « Déploiement et service »- Agenta
 - Agenta fournit des outils de bout en bout pour l’ensemble du workflow LLMOps : création (bac à sable LLM, évaluation), déploiement (gestion des prompts et des configurations) et observabilité et traçage des LLM.
- AirLLM
 - AirLLM optimise la mémoire utilisée pour l’inférence et permet d’exécuter des grands modèles de langue de 70 milliards de paramètres sur une seule carte GPU de 4 Go, sans quantification, distillation ni élagage.
- AITemplate
 - AITemplate (AIT) est un framework Python qui convertit les réseaux neuronaux profonds en code C++ CUDA (GPU NVIDIA) / HIP (GPU AMD) pour un service d’inférence extrêmement rapide.
- BentoML
 - BentoML est un framework open source pour le service haute performance de modèles ML.
- Bifrost
 - Passerelle d’IA proposant une API unique compatible avec OpenAI pour plus de 23 fournisseurs de LLM, avec basculement automatique, équilibrage de charge, cache sémantique, gestion des budgets et métriques Prometheus.
- BISHENG
 - BISHENG est une plateforme DevOps ouverte pour les applications LLM, destinée aux usages en entreprise.
- CosmoEdge
 - Moteur vidéo d’IA C++ en périphérie pour le déploiement en production, combinant ingestion RTSP, inférence CV/VLM, orchestration visuelle, alertes et transmission d’événements sur les NPU Sophon et Rockchip.
- DeepDetect
 - Serveur de machine learning en production pour les modèles TensorFlow, XGBoost et Cafe, écrit en C++ et maintenu par Jolibrain.
- Dynamo
 - NVIDIA Dynamo est un framework d’inférence à haut débit et faible latence, conçu pour servir des modèles d’IA générative et de raisonnement dans des environnements distribués multinœuds.
- exo
 - exo permet d’exécuter chez soi un cluster d’IA avec des appareils courants.
- Genkit
 - Genkit est un framework open source pour créer des applications propulsées par l’IA à l’aide de modèles familiers centrés sur le code. Il facilite le développement, l’intégration et le test de fonctionnalités d’IA avec observabilité et évaluations.
- GoModel
 - GoModel est une passerelle d’IA auto-hébergée écrite en Go, qui expose une API unifiée compatible avec OpenAI et couvrant OpenAI, Anthropic, Gemini, Groq, xAI, Ollama et d’autres fournisseurs, avec routage, suivi de l’utilisation, limites de débit et garde-fous.
- Inference
 - Serveur d’inférence rapide, prêt pour la production, destiné à la vision par ordinateur et prenant en charge le déploiement de nombreuses architectures de modèles populaires et de modèles ajustés. Avec Inference, déployez vos modèles (YOLOv5, YOLOv8, CLIP, SAM et CogVLM, par exemple) sur votre propre matériel grâce à Docker.
- Infinity
 - Infinity est une API REST à haut débit et faible latence pour servir des embeddings de texte, des modèles de reclassement et CLIP.
- LiteLLM
 - LiteLLM est un SDK Python et un serveur proxy (passerelle LLM) permettant d’appeler plus de 100 API LLM au format OpenAI : Bedrock, Azure, OpenAI, VertexAI, Cohere, Anthropic, Sagemaker, HuggingFace, Replicate et Groq.
- LiteRT
 - LiteRT (anciennement TensorFlow Lite) est le runtime haute performance de Google pour l’inférence d’IA sur appareil ; il permet de déployer des modèles de machine learning sur des appareils mobiles, embarqués et périphériques.
- LiteRT-LM
 - LiteRT-LM est le framework d’inférence haute performance de Google, prêt pour la production, pour déployer des grands modèles de langue sur des appareils périphériques. Il prend en charge Android, iOS, le Web, les ordinateurs de bureau et l’IoT.
- LitServe
 - LitServe est un moteur flexible de service de modèles d’IA construit sur FastAPI. Il prend en charge des moteurs d’inférence personnalisés pour les modèles, les agents, les systèmes multimodaux, le RAG et les pipelines ML complexes.
- jevos
 - jevOS est une alternative open source à Jev de TypeSafe pour les décisions oui/non : un classifieur binaire à 1 milliard de paramètres (GGUF, llama.cpp), servi par une API HTTP FastAPI compatible avec Jev et fonctionnant uniquement sur le CPU d’un ordinateur portable.
- Jina-serve
 - Jina-serve est un framework pour créer et déployer des services d’IA communiquant via gRPC, HTTP et WebSockets.
- Kiln
 - Kiln est un outil open source d’ajustement fin des LLM, de génération de données synthétiques et de collaboration sur les jeux de données.
- KServe
 - KServe fournit une définition de ressource personnalisée Kubernetes pour servir des modèles prédictifs et génératifs de machine learning.
- KTransformers
 - KTransformers est un framework flexible pour expérimenter des optimisations d’inférence de pointe pour les LLM.
- Langtrace
 - Langtrace est un outil d’observabilité de bout en bout open source, fondé sur OpenTelemetry, pour les applications LLM. Il fournit traçage en temps réel, évaluations et métriques pour les LLM populaires, leurs frameworks, les bases de données vectorielles, et bien plus.
- Lepton AI
 - La bibliothèque Python LeptonAI permet de créer facilement un service d’IA à partir de code Python.
- LightLLM
 - LightLLM est un framework Python d’inférence et de service des LLM (grands modèles de langue), réputé pour sa légèreté, sa facilité de mise à l’échelle et ses hautes performances.
- llama.cpp
 - llama.cpp est une bibliothèque logicielle open source qui effectue l’inférence sur divers grands modèles de langue tels que Llama.
- llmfit
 - Outil en terminal qui adapte les modèles LLM à la mémoire vive, au CPU et au GPU de votre système. Il détecte le matériel, évalue chaque modèle selon la qualité, la vitesse, l’adéquation et le contexte, puis indique lesquels fonctionneront réellement bien sur votre machine.
- LMCache
 - LMCache est une couche de cache KV haute performance qui accélère l’inférence des LLM.
- LMDeploy
 - LMDeploy est une boîte à outils pour compresser, déployer et servir les LLM.
- LM Studio
 - LM Studio est un outil permettant de déployer localement des modèles LLM sur un ordinateur, même relativement modeste, à condition qu’il réponde à la configuration minimale requise.
- LocalAI
 - LocalAI est une API REST de remplacement, compatible avec les spécifications de l’API OpenAI, pour l’inférence locale.
- MindsDB
 - MindsDB est une plateforme permettant de créer, servir et ajuster finement des modèles en temps réel à partir de bases de données, de magasins vectoriels et de données applicatives.
- mini-sglang
 - mini-sglang est un framework léger et efficace pour servir des grands modèles de langue.
- MLRun
 - MLRun est un framework MLOps ouvert pour créer et gérer rapidement des applications continues de ML et d’IA générative sur l’ensemble de leur cycle de vie.
- MLServer
 - Serveur d’inférence pour vos modèles de machine learning, avec prise en charge de plusieurs frameworks, du service mult modèle, et bien plus.
- Model Runner
 - Docker Model Runner facilite la gestion, l’exécution et le service de modèles d’IA avec Docker. Il prend en charge les LLM et autres modèles d’IA récupérés directement sur Docker Hub ou dans tout registre conforme à OCI.
- Mosec
 - Serveur de modèles à plusieurs étapes et pipeline, propulsé par Rust, qui propose le regroupement dynamique des requêtes et bien plus encore. Très facile à mettre en œuvre et à déployer sous forme de microservices.
- nano-vllm
 - nano-vllm est une implémentation légère de vLLM, développée de zéro. Elle fournit une inférence hors ligne rapide grâce à des optimisations comme la mise en cache des préfixes, le parallélisme des tenseurs et les graphes CUDA.
- nndeploy
 - Framework de déploiement d’IA facile à utiliser et performant.
- Nuclio
 - Framework « serverless » performant axé sur les charges de travail intensives en données, en E/S et en calcul. Il s’intègre bien aux outils populaires de science des données, comme Jupyter et Kubeflow, prend en charge diverses sources de données et de flux et peut s’exécuter sur CPU et GPU.
- OpenLLM
 - OpenLLM permet aux développeurs d’exécuter n’importe quel LLM open source (Llama 3.1, Qwen2, Phi3, etc.) ou modèle personnalisé sous forme d’API compatible avec OpenAI, avec une seule commande.
- OpenVINO
 - OpenVINO est une boîte à outils open source pour optimiser et déployer l’inférence d’IA.
- Open WebUI
 - Open WebUI est une plateforme d’IA auto-hébergée extensible, riche en fonctionnalités et conviviale, conçue pour fonctionner entièrement hors ligne. Elle prend en charge divers moteurs d’exécution de LLM comme Ollama et les API compatibles avec OpenAI, avec un moteur d’inférence intégré pour le RAG, ce qui en fait une solution puissante de déploiement de l’IA.
- OptiLLM
 - OptiLLM est un proxy d’inférence optimisé et compatible avec l’API OpenAI, qui met en œuvre plus de 20 techniques de pointe pour améliorer considérablement la précision et les performances des LLM sur les tâches de raisonnement, sans entraînement ni ajustement fin des modèles.
- PowerInfer
 - PowerInfer est un moteur d’inférence LLM pour CPU/GPU qui exploite la localité des activations sur votre appareil.
- Prompt2Model
 - Prompt2Model est un système qui prend une description de tâche en langage naturel (comme un prompt pour ChatGPT ou un autre LLM) et entraîne un petit modèle spécialisé adapté au déploiement.
- RamaLama
 - RamaLama est un outil open source qui simplifie l’utilisation locale et le service de modèles d’IA pour l’inférence via des conteneurs OCI, sans avoir à configurer le système hôte.
- RunAnywhere
 - RunAnywhere est un SDK prêt pour la production permettant d’exécuter sur appareil des modèles d’IA (LLM, reconnaissance vocale et synthèse vocale) pour iOS, Android, React Native et Flutter, afin de créer des applications mobiles d’IA privées, hors ligne et rapides.
- Seldon Core
 - Plateforme open source pour déployer des modèles de machine learning sur Kubernetes - (Vidéo).
- SGLang
 - SGLang est un framework rapide de service des grands modèles de langue et des modèles vision-langage.
- SIE
 - Serveur d’inférence open source et cluster de production pour les embeddings, le reclassement et l’extraction. Plus de 85 modèles préconfigurés : denses, épars, multivecteurs, vision, reclasseurs et extracteurs. Comprend Helm, l’autoscaling KEDA, des tableaux de bord Grafana et Terraform.
- SkyPilot
 - SkyPilot est un framework pour exécuter des LLM, des charges de travail d’IA et des tâches par lots sur n’importe quel cloud ; il maximise les économies, la disponibilité des GPU et l’exécution gérée.
- Tensorflow Serving
 - Framework performant pour servir des modèles TensorFlow via le protocole gRPC, capable de gérer 100 000 requêtes par seconde et par cœur.
- torchtune
 - torchtune est une bibliothèque PyTorch qui facilite la création, le post-entraînement et l’expérimentation avec les LLM.
- Transformer Lab
 - Transformer Lab est un espace de travail LLM open source permettant d’ajuster finement, d’évaluer, d’exporter et de tester des modèles localement sur différents moteurs et plateformes d’inférence.
- Triton Inference Server
 - Triton est un logiciel de service open source hautement performant pour déployer des modèles d’IA issus de n’importe quel framework sur GPU et CPU, tout en maximisant leur utilisation.
- Vercel AI
 - Vercel AI est une boîte à outils TypeScript conçue pour créer des applications d’IA avec des frameworks populaires comme Next.js, React, Svelte et Vue, ainsi que des runtimes comme Node.js.
- Vespa
 - Rechercher, effectuer des inférences et organiser des vecteurs, tenseurs, textes et données structurées pendant le service, quelle que soit l’échelle.
- vLLM
 - vLLM est un moteur d’inférence et de service des LLM à haut débit et économe en mémoire.
Évaluation et surveillance
Section intitulée « Évaluation et surveillance »- AlpacaEval
 - AlpacaEval est un évaluateur automatique de modèles de langue suivant des instructions.
- ANN-Benchmarks
 - ANN-Benchmarks est un environnement de benchmark pour les algorithmes de recherche du plus proche voisin approximatif.
- ARES
 - ARES est un framework pour évaluer automatiquement les modèles de génération augmentée par récupération (RAG).
- BEIR
 - BEIR est un benchmark hétérogène regroupant diverses tâches de recherche d’information. Il fournit également un framework commun et simple pour évaluer, dans ce benchmark, vos modèles de recherche basés sur le NLP.
- Code Generation LM Evaluation Harness
 - Code Generation LM Evaluation Harness est un framework d’évaluation des modèles de génération de code.
- COMET
 - COMET est un framework open source d’évaluation du machine learning.
- C-Eval
 - C-Eval est une suite complète d’évaluation en chinois pour les modèles fondamentaux.
- Deepchecks
 - Deepchecks est une solution open source complète pour tous vos besoins de validation en IA et ML, qui permet de tester rigoureusement les données et les modèles, de la recherche à la production.
- DeepEval
 - DeepEval est un framework open source facile à utiliser pour évaluer les applications LLM.
- EvalAI
 - EvalAI est une plateforme open source pour évaluer et comparer à grande échelle des algorithmes d’IA.
- Evalchemy
 - Evalchemy est une boîte à outils unifiée et facile à utiliser pour évaluer les modèles de langue après leur entraînement.
- EvalPlus
 - EvalPlus est un framework robuste d’évaluation des LLM de code, avec les benchmarks HumanEval+ et MBPP+ élargis, l’évaluation de l’efficacité (EvalPerf) ainsi qu’une boîte à outils d’évaluation sécurisée et extensible.
- Evals
 - Evals est un framework pour évaluer les modèles OpenAI et un registre open source de benchmarks.
- EvalScope
 - EvalScope est un framework personnalisable et simplifié pour l’évaluation efficace des grands modèles et les benchmarks de performances.
- Evaluate
 - Evaluate est une bibliothèque qui simplifie et normalise l’évaluation, la comparaison des modèles et la présentation de leurs performances.
- Evidently
 - Evidently est un framework open source pour évaluer, tester et surveiller les systèmes ML et ceux propulsés par des LLM.
- Future AGI
 - Plateforme open source auto-hébergeable d’ingénierie et d’optimisation des agents, de bout en bout, réunissant traçage, évaluations, simulations, jeux de données, passerelle et garde-fous pour les applications LLM et les agents d’IA.
- GAOKAO-Bench
 - GAOKAO-Bench est un framework d’évaluation qui utilise les questions de l’examen national chinois d’entrée à l’université (GAOKAO) comme jeu de données pour mesurer la compréhension du langage et le raisonnement logique des grands modèles.
- Giskard
 - Giskard est une bibliothèque Python open source qui détecte automatiquement les problèmes de performance, de biais et de sécurité dans les applications d’IA.
- guidellm
 - guidellm est un outil de benchmark et d’évaluation des performances des systèmes d’inférence de grands modèles de langue.
- Harbor
 - Harbor est un framework d’évaluation et d’optimisation des agents et des modèles de langue, qui prend en charge les expériences parallèles dans des environnements conteneurisés et intègre la gestion des benchmarks et des environnements.
- HumanEval
 - HumanEval est un benchmark qui évalue la correction fonctionnelle des modèles de génération de code à l’aide de problèmes de programmation Python et de tests unitaires.
- Helicone
 - Helicone est une plateforme open source tout-en-un pour les développeurs LLM.
- HELM
 - HELM (Holistic Evaluation of Language Models) fournit des outils d’évaluation holistique des modèles de langue, notamment des jeux de données standardisés, une API unifiée pour divers modèles, des métriques variées, r, des perturbations d’équité, un framework de construction de prompts et un serveur proxy pour accéder aux modèles de manière unifiée.
- Inspect
 - Inspect est un framework d’évaluation des grands modèles de langue.
- IsaacLab-Arena
 - IsaacLab-Arena est une extension open source de NVIDIA Isaac Lab destinée à créer des environnements composables et à évaluer à grande échelle les politiques robotiques.
- JiWER
 - JiWER est un package Python simple et rapide pour évaluer un système de reconnaissance automatique de la parole.
- Laminar
 - Laminar est une plateforme open source permettant de tracer, évaluer, étiqueter et analyser les données LLM des produits d’IA.
- Langfuse
 - Langfuse est une solution d’observabilité et d’analytique pour les applications reposant sur des LLM.
- LangTest
 - LangTest est une boîte à outils complète d’évaluation des modèles NLP.
- Language Model Evaluation Harness
 - Language Model Evaluation Harness est un framework permettant de tester des modèles génératifs de langue sur un grand nombre de tâches d’évaluation différentes.
- LangWatch
 - LangWatch est une interface visuelle pour DSPy et une plateforme LLM Ops complète qui surveille, expérimente, mesure et améliore les pipelines LLM, selon un modèle de distribution fair-code.
- Latitude
 - Latitude est une plateforme open source d’observabilité des agents d’IA, avec recherche sémantique dans les traces et suivi des problèmes.
- LightEval
 - LightEval est une suite légère d’évaluation des LLM.
- lmms-eval
 - lmms-eval est un framework d’évaluation soigneusement conçu pour évaluer les LMM de façon cohérente et efficace.
- Melting Pot
 - Melting Pot est une suite de scénarios de test pour l’apprentissage par renforcement multi-agents.
- Meta-World
 - Meta-World est un benchmark simulé open source pour l’apprentissage par méta-renforcement et l’apprentissage multitâche, composé de 50 tâches distinctes de manipulation robotique.
- mir_eval
 - mir_eval est une bibliothèque Python qui offre un moyen transparent, normalisé et simple d’évaluer les systèmes de recherche d’information musicale.
- MLPerf Inference
 - MLPerf Inference est une suite de benchmarks qui mesure la vitesse d’exécution des modèles dans divers scénarios de déploiement.
- Massive Text Embedding Benchmark - Massive Text Embedding Benchmark (MTEB) est un framework complet d’évaluation des modèles d’embedding de texte sur des tâches et des langues variées : 8 tâches d’embedding, 58 jeux de données et 112 langues.
- NannyML
 - NannyML est une bibliothèque qui estime les performances des modèles après leur déploiement (sans accès aux cibles), détecte la dérive des données et relie intelligemment les alertes de dérive aux changements de performance des modèles.
- OGB
 - Le benchmark Open Graph (OGB) est un ensemble de jeux de données de référence, de chargeurs de données et d’évaluateurs pour le machine learning sur graphes.
- Ollama Grid Search
 - Ollama Grid Search automatise la sélection des meilleurs modèles, prompts ou paramètres d’inférence pour un cas d’usage donné, permet d’itérer sur leurs combinaisons et d’en examiner visuellement les résultats.
- onWatch
 - onWatch est un outil CLI Go léger qui suit en temps réel l’utilisation des quotas d’API d’IA chez plusieurs fournisseurs (Anthropic Pro/Max Plans, Codex, Gemini CLI, Synthetic, Z.ai, GitHub Copilot, MiniMax Coding/Token Plan, Antigravity et OpenRouter), avec projections du rythme de consommation, graphiques d’historique et suivi par cycle.
- OpenCompass
 - OpenCompass est une plateforme d’évaluation LLM qui prend en charge un large éventail de modèles (LLaMA, LLaMa2, ChatGLM2, ChatGPT, Claude, etc.) sur plus de 50 jeux de données.
- OpenLIT
 - OpenLIT est une plateforme d’ingénierie de l’IA open source qui simplifie les workflows LLM grâce à l’observabilité, la surveillance, les garde-fous, les évaluations et des intégrations transparentes.
- OpenLLMetry
 - OpenLLMetry offre aux développeurs une visibilité approfondie sur les applications de grands modèles de langue grâce à la surveillance des performances, au traçage de l’exécution et au débogage.
- Opik
 - Opik est une plateforme open source pour évaluer, tester et surveiller les applications LLM.
- Overcooked-AI
 - Overcooked-AI est un environnement de benchmark pour évaluer les performances de tâches entièrement coopératives entre humains et IA, inspiré du célèbre jeu Overcooked.
- Phoenix
 - Phoenix est une plateforme open source d’observabilité de l’IA conçue pour l’expérimentation, l’évaluation et le dépannage.
- Promptfoo
 - Framework d’évaluation et de red teaming des LLM pour tester les jailbreaks, l’injection de prompts et d’autres vulnérabilités, avec intégration CI/CD.
- Prometheus-Eval
 - RagaAI Catalyst est une plateforme complète conçue pour améliorer la gestion et l’optimisation des projets LLM.
- RagaAI Catalyst
 - Prometheus-Eval est un ensemble d’outils pour entraîner et évaluer des modèles de langue spécialisés dans l’évaluation d’autres modèles de langue, et pour les utiliser.
- Ragas
 - Ragas est un framework d’évaluation des pipelines RAG.
- RewardBench
 - RewardBench est un benchmark conçu pour évaluer les capacités et la sûreté des modèles de récompense.
- RLBench
 - RLBench est un benchmark ambitieux à grande échelle et un environnement d’apprentissage destiné à faciliter la recherche dans plusieurs domaines de manipulation guidée par la vision : apprentissage par renforcement, apprentissage par imitation, apprentissage multitâche, vision géométrique par ordinateur et, en particulier, apprentissage few-shot.
- SimplerEnv
 - SimplerEnv est un environnement d’évaluation simulé des politiques de manipulation robotique pour des configurations robotiques réelles.
- SwanLab
 - SwanLab est un outil de suivi et de visualisation de l’entraînement de modèles d’IA.
- Speech-to-Text Benchmark
 - Speech-to-Text Benchmark est un framework minimaliste et extensible pour comparer différents moteurs de reconnaissance vocale.
- TensorFlow Model Analysis
 - TensorFlow Model Analysis (TFMA) est une bibliothèque qui évalue les modèles TensorFlow sur de grands volumes de données de manière distribuée, à l’aide des mêmes métriques que leur entraîneur.
- TorchBench
 - TorchBench est un ensemble de benchmarks open source servant à évaluer les performances de PyTorch.
- TruLens
 - TruLens fournit un ensemble d’outils pour évaluer et suivre les expériences LLM.
- TrustLLM
 - TrustLLM est un framework complet d’évaluation de la fiabilité des grands modèles de langue, comprenant des principes, des enquêtes et des benchmarks.
- VBench
 - VBench est une suite complète de benchmarks pour les modèles génératifs vidéo.
- VLMEvalKit
 - VLMEvalKit est une boîte à outils open source d’évaluation des grands modèles vision-langage (LVLM).
Explicabilité et équité
Section intitulée « Explicabilité et équité »- Aequitas
 - Boîte à outils open source d’audit des biais destinée aux spécialistes des données, aux chercheurs en machine learning et aux décideurs publics. Elle permet d’auditer les modèles de machine learning afin de détecter discrimination et biais, et de prendre des décisions éclairées et équitables lors de la création et du déploiement d’outils d’évaluation prédictive des risques.
- AI Explainability 360
 - Interprétabilité et explicabilité des données et des modèles de machine learning, avec un ensemble complet d’algorithmes couvrant différentes dimensions des explications et des métriques d’explicabilité proxy.
- AI Fairness 360
 - Ensemble complet de métriques d’équité pour les jeux de données et les modèles de machine learning, d’explications associées et d’algorithmes d’atténuation des biais dans les données et les modèles.
- Alibi
 - Alibi est une bibliothèque Python open source destinée à l’inspection et à l’interprétation des modèles de machine learning. Elle se concentre initialement sur l’explication de modèles boîte noire au niveau des instances.
- captum
 - Bibliothèque d’interprétabilité et de compréhension des modèles pour PyTorch, développée par Facebook. Elle comprend des implémentations généralistes des gradients intégrés, cartes de saillance, SmoothGrad, VarGrad et d’autres méthodes pour les modèles PyTorch.
- Fairlearn
 - Fairlearn est une boîte à outils Python pour évaluer et atténuer les iniquités des modèles de machine learning.
- InterpretML
 - InterpretML est un package open source pour entraîner des modèles interprétables et expliquer les systèmes boîte noire.
- Lightly
 - Framework Python d’apprentissage auto-supervisé sur des images. Les représentations apprises peuvent servir à analyser la distribution des données non étiquetées et à rééquilibrer les jeux de données.
- LOFO Importance
 - LOFO (Leave One Feature Out) Importance calcule l’importance d’un ensemble de caractéristiques selon une métrique et un modèle choisis, en retirant successivement chaque caractéristique et en évaluant les performances du modèle selon la métrique retenue et un schéma de validation donné.
- mljar-supervised
 - Package Python d’AutoML pour les données tabulaires, avec ingénierie des caractéristiques, réglage des hyperparamètres, explications et documentation automatique.
- Quantus
 - Quantus est une boîte à outils d’IA explicable pour évaluer de manière responsable les explications des réseaux neuronaux.
- SHAP
 - SHapley Additive exPlanations (SHAP) est une approche unifiée pour expliquer les sorties de n’importe quel modèle de machine learning.
- SHAPash
 - Shapash est une bibliothèque Python proposant plusieurs visualisations avec des libellés explicites et compréhensibles par tous.
- WhatIf
 - Interface facile à utiliser pour mieux comprendre un modèle de classification ou de régression ML boîte noire.
Feature Store
Section intitulée « Feature Store »- FEAST
 - Feast (Feature Store) est un magasin de caractéristiques open source pour le machine learning. C’est le moyen le plus rapide de gérer l’infrastructure existante et de mettre en production les données analytiques pour l’entraînement des modèles et l’inférence en ligne.
- Featureform
 - Magasin de caractéristiques virtuel. Prêt à l’emploi avec votre infrastructure existante. Approuvé par les spécialistes des données. Découverte, gouvernance, traçabilité et collaboration à portée d’une installation pip. Prend en charge pandas, Python, Spark et SQL, ainsi que les principaux fournisseurs cloud.
- Hopsworks Feature Store
 - Magasin de caractéristiques hors ligne/en ligne pour le ML (Vidéo).
Détection d’anomalies de niveau industriel
Section intitulée « Détection d’anomalies de niveau industriel »- Alibi Detect
 - alibi-detect est un package Python dédié à la détection des valeurs aberrantes, des attaques adversariales et de la dérive de concept.
- Darts
 - Darts est une bibliothèque conviviale de prévision et de détection des anomalies dans les séries temporelles.
- Deequ
 - Bibliothèque construite sur Apache Spark pour définir des « tests unitaires des données » qui mesurent la qualité des données dans de grands jeux de données.
- PyOD
 - Boîte à outils Python pour la détection évolutive des valeurs aberrantes (détection des anomalies).
- TFDV
 - TFDV (TensorFlow Data Validation) est une bibliothèque d’exploration et de validation des données de machine learning.
Vision par ordinateur de niveau industriel
Section intitulée « Vision par ordinateur de niveau industriel »- CameraTraps
 - CameraTraps (PyTorch Wildlife) est un framework collaboratif d’apprentissage profond pour l’analyse d’images de la faune, proposant des modèles de détection et de classification entraînés sur de grands jeux de données de pièges photographiques.
- Deep Lake
 - Deep Lake est une infrastructure de données optimisée pour la vision par ordinateur.
- DeepForest
 - DeepForest est un package Python permettant d’entraîner des modèles et de prédire individuellement les cimes et les espèces d’arbres à partir d’images aériennes RGB, grâce à l’apprentissage profond.
- Detectron2
 - Detectron2 est la bibliothèque de nouvelle génération de Facebook AI Research, qui fournit des algorithmes de détection et de segmentation de pointe.
- Kornia
 - Kornia est une bibliothèque de vision par ordinateur différentiable, construite sur PyTorch, qui fournit un riche ensemble d’algorithmes différentiables de traitement d’images et de vision géométrique.
- libcom
 - Boîte à outils de composition d’images.
- LightlyTrain
 - Préentraînez des modèles de vision par ordinateur sur des données non étiquetées pour des applications industrielles.
- MMCV
 - MMCV est une bibliothèque fondamentale de vision par ordinateur d’OpenMMLab. Elle propose des fonctions essentielles comme le traitement d’images et de vidéos, la transformation et l’augmentation des données, les architectures CNN et des opérations CUDA optimisées.
- SuperGradients
 - Bibliothèque open source pour entraîner des modèles de vision par ordinateur fondés sur PyTorch.
- supervision
 - Supervision est une bibliothèque Python conçue pour gérer efficacement les pipelines de vision par ordinateur. Elle propose des outils d’annotation, de visualisation et de surveillance des modèles.
- VideoSys
 - VideoSys prend en charge de nombreux modèles de diffusion et diverses techniques d’accélération, qui leur permettent de s’exécuter plus rapidement et d’utiliser moins de mémoire.
Recherche d’information de niveau industriel
Section intitulée « Recherche d’information de niveau industriel »- AutoRAG
 - AutoRAG est un outil AutoML RAG qui recherche automatiquement le pipeline RAG optimal pour vos données.
- BGE
 - BGE fournit une boîte à outils de récupération tout-en-un pour la recherche et le RAG.
- EmbedAnything
 - EmbedAnything est un pipeline d’embeddings minimaliste, léger et performant, écrit en Rust. Il génère des embeddings à partir de texte, d’images, d’audio, de PDF et d’autres médias, et prend en charge les embeddings denses, épars, ONNX et à interaction tardive.
- Faiss
 - Faiss est une bibliothèque de recherche de similarité et de regroupement efficace de vecteurs denses.
- GraphRAG
 - GraphRAG est un ensemble de pipelines et de transformations de données conçu pour extraire des données structurées pertinentes à partir de textes non structurés grâce aux LLM.
- HippoRAG
 - HippoRAG est un nouveau framework de génération augmentée par récupération (RAG), inspiré de la neurobiologie de la mémoire humaine à long terme, qui permet aux LLM d’intégrer en continu les connaissances de documents externes.
- JamAI Base
 - JamAI Base est une plateforme backend open source de RAG (Retrieval-Augmented Generation) qui intègre une base de données embarquée (SQLite) et une base vectorielle embarquée (LanceDB), avec gestion de mémoire et capacités RAG. Elle comprend l’orchestration et la gestion intégrées des LLM, des embeddings vectoriels et des reclasseurs, accessibles via une interface intuitive en forme de feuille de calcul et une API REST simple.
- LangExtract
 - LangExtract est une bibliothèque Python qui utilise les LLM pour extraire des informations structurées de documents non structurés, selon des instructions définies par l’utilisateur. Elle traite notamment des notes et rapports cliniques, en repérant et organisant les détails clés tout en garantissant leur correspondance avec le texte source.
- LightRAG
 - Framework simple et rapide de génération augmentée par récupération.
- llmware
 - llmware fournit un framework unifié pour créer des applications fondées sur les LLM (p. ex. RAG et agents), avec de petits modèles spécialisés déployables en privé, intégrables de manière sûre aux sources de connaissances d’entreprise et adaptables à moindre coût à tout processus métier.
- Mem0
 - Mem0 enrichit les assistants et agents d’IA d’une couche de mémoire intelligente, pour des interactions personnalisées.
- NGT
 - NGT fournit des commandes et une bibliothèque permettant d’effectuer des recherches rapides de plus proches voisins approximatifs dans de grands volumes de données vectorielles de grande dimension.
- NMSLIB
 - Non-Metric Space Library (NMSLIB) : bibliothèque de recherche efficace de similarité et boîte à outils pour évaluer les méthodes k-NN dans des espaces génériques non métriques.
- Qdrant
 - Moteur open source de recherche de similarité vectorielle avec prise en charge avancée du filtrage.
- R2R
 - R2R (RAG to Riches) est une plateforme complète pour créer, déployer et mettre à l’échelle des applications RAG avec recherche hybride, prise en charge multimodale et observabilité avancée.
- RAGFlow
 - RAGFlow est un moteur RAG fondé sur une compréhension approfondie des documents.
- RAGxplorer
 - Outil de création de visualisations RAG.
- RAG-FiT
 - RAG-FiT est une bibliothèque conçue pour améliorer la capacité des LLM à utiliser des informations externes, en ajustant les modèles sur des jeux de données enrichis spécialement pour le RAG.
- TextWorld
 - TextWorld est un générateur de jeux textuels et un environnement d’apprentissage bac à sable extensible pour entraîner et tester des agents d’apprentissage par renforcement (RL).
- Zvec
 - Zvec est une base de données vectorielle open source intégrée au processus, pour la recherche de similarité à faible latence.
Traitement du langage naturel de niveau industriel
Section intitulée « Traitement du langage naturel de niveau industriel »- aisuite
 - aisuite est une interface simple et unifiée vers plusieurs fournisseurs d’IA générative.
- Align-Anything
 - Align-Anything vise à aligner les grands modèles de toute modalité (modèles quelconque-à-quelconque), notamment les LLM et VLM, sur les intentions et les valeurs humaines.
- BERTopic
 - BERTopic est une technique de modélisation thématique qui exploite les transformers et c-TF-IDF pour créer des groupes denses permettant d’interpréter facilement les sujets tout en conservant les mots importants dans leur description.
- Burr
 - Burr aide à développer des applications qui prennent des décisions (chatbots, agents, simulations). Il propose des fonctionnalités prêtes pour la production (télémétrie, persistance, déploiement, etc.) ainsi qu’une interface Burr open source, gratuite et conçue pour fonctionner en local.
- Context7
 - Context7 fournit aux prompts et aux agents de programmation IA une documentation de code à jour.
- Dify
 - Dify est une plateforme open source de développement d’applications LLM dont l’interface intuitive réunit workflows d’IA agentique, pipeline RAG, capacités d’agents, gestion des modèles, fonctionnalités d’observabilité et bien plus, pour passer rapidement du prototype à la production.
- dspy
 - Framework de programmation avec des modèles fondamentaux.
- Dust
 - Dust aide à concevoir et à déployer des applications de grands modèles de langue.
- ESPnet
 - ESPnet est une boîte à outils de traitement de la parole de bout en bout.
- FastChat
 - FastChat est une plateforme ouverte pour entraîner, servir et évaluer des chatbots reposant sur de grands modèles de langue.
- Flair
 - Framework NLP simple et de pointe, développé par Zalando et construit directement sur PyTorch.
- FunASR
 - FunASR est une boîte à outils de reconnaissance automatique de la parole prête pour la production, qui prend en charge plus de 50 langues et intègre VAD, ponctuation, diarisation des locuteurs et reconnaissance des émotions. Elle propose aussi un déploiement Docker/WebSocket/REST et la prise en charge du runtime ONNX.
- Fun-ASR
 - Reconnaissance automatique de la parole basée sur les LLM, prenant en charge 31 langues, y compris les dialectes chinois, avec ponctuation, horodatage et diarisation des locuteurs intégrés.
- Gensim
 - Gensim est une bibliothèque Python pour la modélisation thématique, l’indexation de documents et la recherche de similarité dans de grands corpus.
- gpt-fast
 - Génération de texte par transformer, simple et efficace, native de PyTorch.
- Haystack
 - Haystack est un framework NLP open source permettant d’interagir avec vos données grâce aux modèles Transformer et aux LLM (GPT-3 et similaires). Il fournit des outils prêts pour la production pour créer rapidement des systèmes de questions-réponses à la ChatGPT, de recherche sémantique, de génération de texte, et bien plus.
- Interactive Composition Explorer
 - ICE est une bibliothèque Python et un visualiseur de traces pour les programmes de modèles de langue.
- Jan
 - Jan est une alternative open source à ChatGPT qui fonctionne entièrement hors ligne sur votre ordinateur. Elle permet de télécharger et d’exécuter localement des LLM, avec contrôle et confidentialité complets.
- Lamini
 - Lamini est un moteur LLM permettant de personnaliser rapidement les modèles.
- LangChain
 - LangChain facilite la création d’applications avec des LLM grâce à la composabilité.
- LlamaIndex
 - LlamaIndex (GPT Index) est un framework de données pour votre application LLM.
- LLaMA
 - LLaMA est conçu comme un exemple minimal, modifiable et lisible pour charger les modèles LLaMA (arXiv) et effectuer des inférences.
- LLaMA-Factory
 - LLaMA-Factory facilite l’ajustement fin de plus de 100 grands modèles de langue grâce à une interface en ligne de commande et une interface Web sans code.
- LLMBox
 - LLMBox est une bibliothèque complète pour mettre en œuvre les LLM, comprenant un pipeline d’entraînement unifié et une évaluation exhaustive des modèles.
- LLaMA2-Accessory
 - LLaMA2-Accessory est une boîte à outils open source pour le préentraînement, l’ajustement fin et le déploiement de grands modèles de langue (LLM) et de LLM multimodaux.
- LMFlow
 - LMFlow est une boîte à outils extensible, pratique et efficace pour ajuster finement de grands modèles de machine learning.
- Megatron-LM
 - Megatron-LM est une bibliothèque hautement optimisée et efficace pour entraîner de grands modèles de langue.
- MindNLP
 - MindNLP est un framework NLP et LLM facile à utiliser et performant, basé sur MindSpore, compatible avec les modèles et jeux de données de Hugging Face.
- MLC LLM
 - MLC LLM est une solution universelle pour déployer n’importe quel modèle de langue nativement sur diverses plateformes matérielles et applications, ainsi qu’un framework productif permettant à chacun d’optimiser davantage les performances du modèle selon ses cas d’usage.
- mlx-lm
 - MLX LM est un package Python qui génère du texte et ajuste finement de grands modèles de langue sur les puces Apple avec MLX. Il s’intègre à Hugging Face Hub et prend en charge la quantification et l’inférence distribuée.
- Ollama
 - Lancez-vous rapidement avec les grands modèles de langue, en local.
- olmOCR
 - olmOCR est une boîte à outils pour entraîner des modèles de langue à traiter des documents PDF du monde réel.
- PaddleNLP
 - PaddleNLP est une suite de développement de grands modèles de langue (LLM) fondée sur le framework d’apprentissage profond PaddlePaddle. Elle prend en charge l’entraînement efficace de grands modèles, la compression sans perte et l’inférence haute performance sur divers appareils matériels.
- Promptise Foundry
 - Promptise Foundry est un framework Python de production pour l’IA agentique et les serveurs MCP, couvrant le runtime autonome, la mémoire, l’intégration des outils, la gouvernance (budget, état, mission, secrets), les garde-fous, le cache sémantique et l’observabilité.
- Semantic Kernel
 - Semantic Kernel est un SDK qui intègre les grands modèles de langue (LLM) tels qu’OpenAI, Azure OpenAI et Hugging Face à des langages de programmation classiques comme C#, Python et Java. Il permet de définir des plugins qui s’enchaînent en quelques lignes de code.
- Sentence Transformers
 - Sentence Transformers facilite le calcul des représentations vectorielles denses pour des phrases, des paragraphes et des images.
- SpaCy
 - spaCy est une bibliothèque de traitement avancé du langage naturel en Python et Cython.
- SWIFT
 - SWIFT est une infrastructure évolutive et légère pour l’ajustement fin des modèles d’apprentissage profond.
- Tensorflow Lingvo
 - Framework de création de réseaux neuronaux avec TensorFlow, en particulier de modèles séquentiels.
- Tensorflow Text
 - TensorFlow Text fournit un ensemble de classes et d’opérations liées au texte, prêtes à être utilisées avec TensorFlow 2.0.
- ToolBench
 - ToolBench est une plateforme ouverte pour entraîner, servir et évaluer de grands modèles de langue destinés à l’apprentissage de l’utilisation d’outils.
- Transformers
 - Bibliothèque Hugging Face de modèles préentraînés de pointe pour le traitement du langage naturel (NLP).
Systèmes de recommandation de niveau industriel
Section intitulée « Systèmes de recommandation de niveau industriel »- EasyRec
 - EasyRec est un framework pour les algorithmes de recommandation à grande échelle.
- Gorse
 - Gorse vise à être un système de recommandation open source universel, intégrable rapidement à un large éventail de services en ligne.
- Merlin
 - NVIDIA Merlin est une bibliothèque open source fournissant des systèmes de recommandation accélérés par GPU, de bout en bout, de l’ingénierie et du prétraitement des caractéristiques à l’entraînement de modèles d’apprentissage profond et à l’inférence en production.
- Recommenders
 - Recommenders rassemble, sous forme de notebooks Jupyter, des benchmarks et des bonnes pratiques pour créer des systèmes de recommandation.
- TorchRec
 - TorchRec est une bibliothèque métier PyTorch fournissant les primitives courantes de parcimonie et de parallélisme nécessaires aux systèmes de recommandation à grande échelle (RecSys).
Apprentissage par renforcement de niveau industriel
Section intitulée « Apprentissage par renforcement de niveau industriel »- Acme
 - Acme est une bibliothèque de composants d’apprentissage par renforcement (RL) qui vise à proposer des agents simples, efficaces et lisibles.
- AReaL
 - AReaL est une bibliothèque d’apprentissage par renforcement.
- ChatLearn
 - ChatLearn est un framework flexible et efficace d’entraînement par renforcement des grands modèles de langue. Il prend en charge les moteurs d’entraînement distribués (FSDP2, Megatron) et les moteurs d’inférence (vLLM, SGLang), avec des algorithmes RL modernes comme GRPO et GSPO.
- CleanRL
 - CleanRL est une bibliothèque d’apprentissage profond par renforcement qui fournit des implémentations de grande qualité dans un seul fichier, avec des fonctionnalités adaptées à la recherche. Le code est clair et simple, mais permet de lancer des milliers d’expériences avec AWS Batch.
- d3rlpy
 - d3rlpy est une bibliothèque d’apprentissage profond par renforcement hors ligne, destinée aux praticiens et aux chercheurs.
- D4RL
 - D4RL est un benchmark open source pour l’apprentissage par renforcement hors ligne.
- Dopamine
 - Dopamine est un framework de recherche permettant de prototyper rapidement des algorithmes d’apprentissage par renforcement. Il vise à fournir une base de code réduite et facile à comprendre où les utilisateurs peuvent expérimenter librement des idées audacieuses (recherche exploratoire).
- EvoTorch
 - EvoTorch est une bibliothèque open source de calcul évolutionnaire développée chez NNAISENSE et construite sur PyTorch.
- FinRL
 - FinRL est le premier framework open source à démontrer le grand potentiel de l’apprentissage par renforcement appliqué à la finance.
- Gymnasium
 - Gymnasium est une bibliothèque Python open source pour développer et comparer des algorithmes d’apprentissage par renforcement. Elle fournit une API standard pour la communication entre algorithmes et environnements, ainsi qu’un ensemble d’environnements conformes à cette API.
- Gymnasium-Robotics
 - Gymnasium-Robotics regroupe des environnements robotiques d’apprentissage par renforcement utilisant l’API Gymnasium. Ils s’exécutent avec le moteur physique MuJoCo et ses bindings Python maintenus.
- Jumanji
 - Jumanji est une suite d’environnements d’apprentissage par renforcement (RL) écrits en JAX, qui fournit des environnements clairs et accélérés matériellement pour la recherche appliquée à l’industrie.
- MARLlib
 - MARLlib est une bibliothèque complète d’algorithmes d’apprentissage par renforcement multi-agents fondée sur RLlib. Elle propose à la communauté de recherche MARL une plateforme unifiée pour construire, entraîner et évaluer des algorithmes MARL.
- Mava
 - Mava est un framework d’apprentissage par renforcement distribué multi-agents avec JAX.
- Melting Pot - Melting Pot est une suite de scénarios de test pour l’apprentissage par renforcement multi-agents.
- MetaDrive
 - MetaDrive est un simulateur de conduite qui compose divers scénarios pour l’apprentissage par renforcement généralisable.
- Minigrid
 - La bibliothèque Minigrid regroupe des environnements de grille discrets pour la recherche en apprentissage par renforcement. Ils suivent l’API standard Gymnasium et sont conçus pour être légers, rapides et facilement personnalisables.
- MiniWorld
 - MiniWorld est un simulateur minimaliste d’environnements intérieurs en 3D pour la recherche en apprentissage par renforcement et en robotique.
- ML-Agents
 - ML-Agents est un projet open source qui transforme des jeux et des simulations en environnements d’entraînement d’agents intelligents par apprentissage par renforcement.
- MushroomRL
 - MushroomRL est une bibliothèque Python d’apprentissage par renforcement (RL) modulaire, qui facilite l’utilisation de bibliothèques Python reconnues pour le calcul sur tenseurs (p. ex. PyTorch, TensorFlow) et de benchmarks RL (p. ex. OpenAI Gym, PyBullet, DeepMind Control Suite).
- OmniSafe
 - OmniSafe est un framework d’infrastructure conçu pour accélérer la recherche sur l’apprentissage par renforcement sûr (RL).
- OpenRLHF
 - OpenRLHF est un framework open source pour l’apprentissage par renforcement à partir de rétroactions humaines (RLHF).
- PARL
 - PARL est un framework d’apprentissage par renforcement flexible et très efficace.
- PettingZoo
 - PettingZoo est une bibliothèque Python pour la recherche en apprentissage par renforcement multi-agents, comparable à une version multi-agents de Gymnasium.
- ranx
 - ranx est une bibliothèque de métriques rapides d’évaluation du classement, implémentées en Python avec Numba pour accélérer les opérations vectorielles et paralléliser automatiquement.
- RL4CO
 - RL4CO est une bibliothèque PyTorch consacrée à l’apprentissage par renforcement pour l’optimisation combinatoire (CO).
- RL2
 - RL2 est une bibliothèque d’apprentissage par renforcement.
- RLinf
 - RLinf est une bibliothèque d’apprentissage par renforcement.
- ROLL
 - ROLL est une bibliothèque d’apprentissage par renforcement.
- skrl
 - skrl est une bibliothèque modulaire open source d’apprentissage par renforcement, écrite en Python avec PyTorch et conçue pour privilégier la lisibilité, la simplicité et la transparence des implémentations d’algorithmes.
- SkyRL
 - SkyRL est une bibliothèque complète d’apprentissage par renforcement proposant des frameworks d’entraînement modulaires, des backends d’inférence multiplateformes, des pipelines agentiques et des environnements Gymnasium pour les tâches RL du monde réel à long horizon.
- slime
 - slime est un framework de post-entraînement des LLM pour la mise à l’échelle de l’apprentissage par renforcement.
- Stable Baselines
 - Fork d’OpenAI Baselines proposant des implémentations d’algorithmes d’apprentissage par renforcement.
- TF-Agents
 - Bibliothèque TensorFlow fiable, évolutive et facile à utiliser pour les bandits contextuels et l’apprentissage par renforcement.
- TorchRL
 - TorchRL est une bibliothèque open source d’apprentissage par renforcement (RL) pour PyTorch.
- TRL
 - Entraînez des modèles de langue Transformer avec l’apprentissage par renforcement.
- veRL
 - veRL (HybridFlow) est un framework d’entraînement RL(HF) flexible, efficace et de niveau industriel, conçu pour les LLM.
Robotique de niveau industriel
Section intitulée « Robotique de niveau industriel »- AI2-THOR
 - AI2-THOR est un framework interactif quasi photoréaliste pour les agents d’IA.
- Genesis
 - Genesis est une plateforme physique destinée à l’IA incarnée et à la simulation robotique.
- Habitat-Sim
 - Habitat-Sim est un simulateur 3D flexible et performant pour la recherche sur l’IA incarnée.
- IsaacLab
 - IsaacLab est un framework unifié et modulaire d’apprentissage robotique qui exploite NVIDIA Isaac Sim.
- LeRobot
 - LeRobot fournit des modèles, des jeux de données et des outils pour la robotique du monde réel et l’apprentissage par imitation.
- robosuite
 - robosuite est un framework de simulation s’appuyant sur le moteur physique MuJoCo pour l’apprentissage robotique.
- RoboVerse
 - RoboVerse est une plateforme complète de simulation robotique avec des environnements variés.
Visualisation de niveau industriel
Section intitulée « Visualisation de niveau industriel »- Apache ECharts
 - Apache ECharts est une bibliothèque puissante et interactive de visualisation de données et de graphiques pour navigateur.
- Apache Superset
 - Application Web moderne de veille économique, prête pour les entreprises.
- Bokeh
 - Bokeh est une bibliothèque Python de visualisation interactive qui permet de présenter les données de façon esthétique et pertinente dans les navigateurs Web modernes.
- Bread Dataset Viewer - Extension VS Code permettant d’afficher et d’explorer de grands jeux de données de machine learning (CSV, JSON, Parquet, etc.) directement dans l’éditeur, sans faire planter l’IDE.
- Bread WandB Viewer - Extension VS Code permettant de consulter dans l’IDE les expériences, journaux et artefacts Weights & Biases, sans passer par l’interface Web et en préservant la confidentialité des données grâce à un fonctionnement entièrement hors ligne.
- Data Formulator
 - Transformez les données et créez de riches visualisations de façon itérative avec l’IA.
- ggplot2
 - Implémentation de la grammaire des graphiques pour R.
- gradio
 - Créez et partagez rapidement des démonstrations de modèles en écrivant uniquement du Python. Déboguez les modèles de manière interactive dans votre navigateur, recueillez les commentaires de vos collaborateurs et générez des liens publics sans rien déployer.
- Kangas
 - Kangas est un outil d’exploration, d’analyse et de visualisation de données multimédias à grande échelle. Il fournit une API Python simple pour journaliser de grandes tables de données et une interface visuelle intuitive pour y effectuer des requêtes complexes.
- matplotlib
 - Bibliothèque Python de tracé 2D qui produit des figures de qualité publication dans divers formats d’impression et environnements interactifs, sur toutes les plateformes.
- Model Explorer
 - Model Explorer est un outil de visualisation et d’exploration des modèles de machine learning. Sa vue intuitive en graphe permet de comprendre la structure des modèles, d’examiner les détails des couches et de parcourir de grands réseaux neuronaux.
- Netron
 - Visionneuse de modèles de réseaux neuronaux, d’apprentissage profond et de machine learning.
- Perspective
 Visualisation de tableaux croisés dynamiques en flux via WebAssembly.
- Plotly
 - Bibliothèque de graphiques Python interactive, open source et basée sur le navigateur.
- Redash
 - Redash est un framework de visualisation open source conçu pour faciliter l’accès aux grands jeux de données au moyen de plusieurs backends.
- Rerun
 - Rerun est un SDK open source pour journaliser, stocker, interroger et visualiser des données multimodales, conçu pour la robotique, la vision par ordinateur et l’IA spatiale.
- seaborn
 - Seaborn est une bibliothèque Python de visualisation fondée sur matplotlib. Elle fournit une interface de haut niveau pour tracer des graphiques statistiques attrayants.
- Spotlight
 - Spotlight aide à repérer les segments de données critiques et les modes de défaillance des modèles. Il permet de créer et maintenir des modèles de machine learning fiables en organisant des jeux de données de qualité.
- Streamlit
 - Streamlit permet de créer des applications pour vos projets de machine learning à l’aide de simples scripts Python. Le rechargement à chaud met à jour l’application dès que vous modifiez et enregistrez un fichier.
- tensorboardX
 - Écrivez des événements TensorBoard à l’aide d’un simple appel de fonction.
- TensorBoard
 - TensorBoard est une boîte à outils de visualisation des expériences de machine learning, qui facilite l’hébergement, le suivi et le partage des expériences ML.
- Torchvista
 - Torchvista est un outil interactif à utiliser dans les notebooks pour visualiser la passe avant de n’importe quel modèle PyTorch sous forme de graphe de calcul. Il prend en charge les modules imbriqués repliables et les visualisations partielles tolérantes aux erreurs.
- Transformer Explainer
 - Transformer Explainer est un outil de visualisation interactif conçu pour aider chacun à comprendre le fonctionnement des modèles fondés sur Transformer, comme GPT.
- Vega-Altair
 - Vega-Altair est une bibliothèque déclarative de visualisation statistique pour Python.
- ydata-profiling
 - ydata-profiling propose une expérience d’analyse exploratoire des données (EDA) en une ligne de code, avec une solution cohérente et rapide.
Gestion des métadonnées
Section intitulée « Gestion des métadonnées »- Apache Atlas
 - Le framework Apache Atlas est un ensemble extensible de services fondamentaux de gouvernance, permettant aux entreprises de satisfaire efficacement leurs exigences de conformité dans Hadoop et de s’intégrer à l’ensemble de leur écosystème de données.
- DataHub
 - DataHub est l’outil généraliste de LinkedIn pour rechercher et découvrir des métadonnées.
- Marquez
 - Marquez est un service de métadonnées open source permettant de collecter, agréger et visualiser les métadonnées d’un écosystème de données.
- Metacat
 - Metacat est un service d’API unifiée pour explorer les métadonnées. Il s’attaque à trois problèmes : les vues fédérées des systèmes de métadonnées, le stockage arbitraire de métadonnées sur les jeux de données et la découverte de métadonnées.
- ML Metadata
 - Bibliothèque d’enregistrement et de récupération des métadonnées associées aux workflows des développeurs ML et des spécialistes des données.
Gestion des modèles, des données et des expériences
Section intitulée « Gestion des modèles, des données et des expériences »- Aim
 - Moyen très simple d’enregistrer, de rechercher et de comparer des expériences d’IA.
- ClearML
 - Gestionnaire d’expériences et contrôle de version IA quasi automatique (anciennement Trains).
- DataHub - DataHub est un catalogue de données open source pour les architectures de données modernes.
- Dolt
 - Dolt est une base de données SQL que vous pouvez forker, cloner, créer des branches, fusionner, publier et récupérer, comme un dépôt Git.
- DVC
 - DVC (Data Version Control) est un fork de Git qui permet de gérer les versions des modèles.
- HuggingFace Model Downloader
 - HuggingFace Model Downloader est un utilitaire de téléchargement de modèles et de jeux de données depuis le site Hugging Face. Il propose le téléchargement multithread des fichiers LFS et vérifie l’intégrité des modèles téléchargés à l’aide de sommes de contrôle SHA256.
- Keepsake
 - Contrôle de version pour le machine learning.
- KitOps
 - KitOps est un système ouvert et fondé sur des standards pour empaqueter et versionner des projets d’IA/ML. Il fonctionne avec les outils d’IA/ML, de développement et DevOps que vous utilisez déjà.
- lakeFS
 - Lac de données reproductible, atomique et versionné reposant sur le stockage objet.
- MLflow
 - Plateforme open source de gestion du cycle de vie du ML, notamment l’expérimentation, la reproductibilité et le déploiement.
- Polyaxon
 - Plateforme de machine learning et d’apprentissage profond reproductibles et évolutifs sur Kubernetes - (Vidéo).
- Quilt
 - Versionnement, reproductibilité et déploiement des données et des modèles.
- Sacred
 - Outil de configuration, d’organisation, de journalisation et de reproduction des expériences de machine learning.
- TerminusDB
 - Système de gestion de base de données graphes qui stocke les données comme Git.
- Weights & Biases
 - Weights & Biases est un outil de suivi des expériences de machine learning, de versionnement des jeux de données, de recherche d’hyperparamètres, de visualisation et de collaboration.
Entraînement et orchestration des modèles
Section intitulée « Entraînement et orchestration des modèles »- AutoTrain Advanced
 - AutoTrain Advanced est une solution sans code qui permet d’entraîner des modèles de machine learning en quelques clics.
- Avalanche
 - Avalanche est une bibliothèque complète d’apprentissage continu qui propose une base de code open source, partagée et collaborative (sous licence MIT) pour prototyper rapidement, entraîner et évaluer de façon reproductible des algorithmes d’apprentissage continu.
- Axolotl
 - Axolotl est un outil conçu pour simplifier l’ajustement fin de divers modèles d’IA, avec prise en charge de nombreuses configurations et architectures.
- BindsNET
 - BindsNET est une bibliothèque de simulation des réseaux neuronaux à impulsions, destinée au développement d’algorithmes de machine learning inspirés de la biologie.
- CML
 - Continuous Machine Learning (CML) est une bibliothèque open source permettant de mettre en œuvre l’intégration et la livraison continues (CI/CD) dans les projets de machine learning.
- CoreNet
 - CoreNet est une boîte à outils de réseaux neuronaux profonds qui permet aux chercheurs et aux ingénieurs d’entraîner des modèles classiques ou nouveaux, petits ou à grande échelle, pour diverses tâches : modèles fondamentaux (p. ex. CLIP et LLM), classification et détection d’objets, et segmentation sémantique.
- DataLinter
 - DataLinter est un linter contextuel open source pour les données et le code, conçu pour rester indépendant des données et du code grâce à des plugins.
- Determined
 - Plateforme d’entraînement en apprentissage profond offrant une prise en charge intégrée de l’entraînement distribué, du réglage des hyperparamètres et de la gestion des modèles (TensorFlow et PyTorch).
- dstack
 - dstack est un orchestrateur de conteneurs open source qui simplifie l’orchestration des charges de travail et améliore l’utilisation des GPU pour les équipes ML.
- envd
 - Environnement de développement du machine learning pour les équipes de science des données et d’ingénierie IA/ML.
- Fire-Flyer File System
 - Le système de fichiers Fire-Flyer (3FS) est un système de fichiers distribué performant conçu pour les charges d’entraînement et d’inférence de l’IA. Il exploite les SSD modernes et les réseaux RDMA pour fournir une couche de stockage partagée qui simplifie le développement d’applications distribuées.
- H2O-3
 - Plateforme de machine learning rapide et évolutive pour des applications plus intelligentes : apprentissage profond, boosting par gradient et XGBoost, forêts aléatoires, modélisation linéaire généralisée (régression logistique, Elastic Net), K-Means, ACP, ensembles empilés, apprentissage automatique (AutoML), etc.
- Hopsworks
 - Hopsworks est une plateforme à forte intensité de données pour concevoir et exploiter des pipelines de machine learning.
- Ignite
 - Ignite est une bibliothèque de haut niveau qui facilite l’entraînement et l’évaluation flexibles et transparents de réseaux neuronaux avec PyTorch.
- Kubeflow
 - Plateforme de machine learning native du cloud, fondée sur les pipelines internes de machine learning de Google.
- Ludwig
 - Ludwig est un framework low-code pour créer des modèles d’IA personnalisés, comme des LLM et d’autres réseaux neuronaux profonds.
- MFTCoder
 - MFTCoder est un projet open source de CodeFuse pour l’ajustement fin multitâche (MFT) précis et efficace des grands modèles de langue (LLM), en particulier des modèles de langue spécialisés dans le code.
- MLeap
 - Normalisation de la sérialisation des pipelines et des modèles pour Spark, TensorFlow et sklearn.
- Nanotron
 - Nanotron fournit des primitives distribuées pour entraîner efficacement différents modèles à l’aide du parallélisme 3D.
- NeMo
 - NVIDIA NeMo est un framework d’IA générative évolutif et natif du cloud, conçu pour les chercheurs et développeurs PyTorch travaillant sur les grands modèles de langue (LLM), modèles multimodaux (MM), reconnaissance automatique de la parole (ASR), synthèse vocale (TTS) et vision par ordinateur (CV). Il permet de créer, personnaliser et déployer efficacement de nouveaux modèles génératifs en réutilisant le code existant et des points de contrôle préentraînés.
- Prime
 - Prime est un framework d’entraînement efficace et distribué à l’échelle mondiale de modèles d’IA sur Internet.
- PyCaret
 ) - Bibliothèque low-code pour entraîner et déployer des modèles (scikit-learn, XGBoost, LightGBM, spaCy).
- Sematic
 - Plateforme pour créer des pipelines gourmands en ressources avec du Python simple.
- Skaffold
 - Skaffold est un outil en ligne de commande qui facilite le développement continu d’applications Kubernetes. Vous pouvez modifier localement le code source de votre application, puis le déployer sur des clusters Kubernetes locaux ou distants.
- TFX
 - TensorFlow Extended (TFX) est un framework de configuration ML orienté production, fondé sur TensorFlow, qui comprend notamment la surveillance et la gestion des versions de modèles.
- unsloth
 - Ajustement fin et apprentissage par renforcement pour les LLM. Entraînez OpenAI gpt-oss, DeepSeek-R1, Qwen3, Gemma 3 et TTS deux fois plus vite avec 70 % de VRAM en moins.
Optimisation du stockage des modèles
Section intitulée « Optimisation du stockage des modèles »- AWQ
 - Quantification des poids tenant compte des activations pour compresser et accélérer les LLM.
- GGML
 - GGML est une bibliothèque de tenseurs performante pour le machine learning, qui permet une inférence efficace sur CPU et est particulièrement optimisée pour les grands modèles de langue.
- neural-compressor
 - Intel® Neural Compressor vise à proposer des techniques populaires de compression de modèles — quantification, élagage (parcimonie), distillation et recherche d’architectures neuronales — pour les principaux frameworks.
- NNEF - Neural Network Exchange Format (NNEF) est un standard ouvert de représentation des modèles de réseaux neuronaux, conçu pour assurer l’interopérabilité et la portabilité entre différents frameworks et plateformes de machine learning.
- ONNX
 - ONNX (Open Neural Network Exchange) est un format open source conçu pour faciliter l’interopérabilité et la portabilité des modèles de machine learning entre différents frameworks et plateformes.
- PFA - Le format PFA (Portable Format for Analytics) est un standard de représentation et d’échange portables de modèles prédictifs et de workflows analytiques, fondé sur JSON.
- PMML - PMML (Predictive Model Markup Language) est un standard XML de représentation et de partage des modèles prédictifs entre différentes applications.
- Quanto
 - Quanto vise à simplifier la quantification des modèles d’apprentissage profond.
Confidentialité et sécurité
Section intitulée « Confidentialité et sécurité »- AI Gateway
 - AI Gateway est une passerelle d’IA extrêmement rapide, avec garde-fous intégrés.
- ART
 - ART (Adversarial Robustness Toolbox) fournit des outils permettant aux développeurs et aux chercheurs de défendre et d’évaluer les modèles et applications de machine learning face aux attaques adversariales : évasion, empoisonnement, extraction et inférence.
- CipherChat
 - CipherChat est un framework d’évaluation de la capacité de généralisation de l’alignement de sécurité des LLM.
- DeepTeam
 - DeepTeam est un framework open source de red teaming LLM, simple à utiliser, destiné aux tests d’intrusion et à la protection des systèmes à grands modèles de langue.
- FATE
 - FATE (Federated AI Technology Enabler) est le premier framework open source d’apprentissage fédéré de niveau industriel au monde. Il permet aux entreprises et aux institutions de collaborer sur les données tout en protégeant leur sécurité et leur confidentialité.
- FedML
 - FedML fournit une plateforme intégrée de recherche et de production, en périphérie et dans le cloud, pour l’apprentissage automatique fédéré et distribué, en tout lieu et à toute échelle.
- Flower
 - Flower est un framework d’apprentissage fédéré à approche unifiée. Il permet de fédérer n’importe quelle charge de travail ML, avec n’importe quel framework ML et langage de programmation.
- Google’s Differential Privacy
 - Bibliothèque C++ d’algorithmes à confidentialité différentielle ε, permettant de produire des statistiques agrégées à partir de jeux de données numériques contenant des informations privées ou sensibles.
- Guardrails
 - Guardrails est un package permettant d’ajouter des garanties de structure, de type et de qualité aux sorties des grands modèles de langue.
- NeMo Guardrails
 - NeMo Guardrails est une boîte à outils open source qui facilite l’ajout de garde-fous programmables aux systèmes conversationnels fondés sur les LLM.
- Opacus
 - Opacus est une bibliothèque permettant d’entraîner des modèles PyTorch avec confidentialité différentielle. Elle nécessite peu de modifications du code client, a un faible impact sur les performances d’entraînement et permet de suivre en continu le budget de confidentialité consommé.
- OpenFL
 - OpenFL est un framework Python d’apprentissage fédéré. Conçu pour être flexible, extensible et facile à apprendre, il s’adresse aux spécialistes des données. OpenFL est développé par Intel Internet of Things Group (IOTG) et Intel Labs.
- PySyft
 - Bibliothèque Python pour l’apprentissage profond sécurisé et privé. PySyft sépare les données privées de l’entraînement des modèles en utilisant le calcul multipartite (MPC) dans PyTorch.
- Tensorflow Privacy
 - Bibliothèque Python comprenant des implémentations d’optimiseurs TensorFlow pour entraîner des modèles de machine learning avec confidentialité différentielle.
- TF Encrypted
 - Framework d’apprentissage automatique confidentiel sur des données chiffrées dans TensorFlow.
Autres listes Awesome
Section intitulée « Autres listes Awesome »- Awesome Agentic Engineering Resources
 - Sélection organisée de ressources, d’outils et de références pour créer des systèmes d’IA agentique.
- Awesome AI Gateway
 - Liste sélectionnée et bilingue (EN/zh-CN) de passerelles d’IA et de proxys LLM (LiteLLM, OpenRouter, Portkey, Kong, Higress, new-api), comparés selon le coût, la conformité, l’auto-hébergement et le routage ; avec arbre de décision, benchmarks de coûts reproductibles et grille d’aide au choix.
- Awesome AI Regulation
 - Présente la gouvernance, la conformité et les cadres réglementaires essentiels au déploiement responsable de systèmes de ML dans différents territoires.
- Awesome AI Tokenomics
 - Présente le coût et l’efficacité des jetons dans les systèmes d’IA, notamment la surveillance, l’optimisation, la mise en cache, le choix des modèles et la gestion du contexte.
- Awesome Production GenAI
 - Se concentre sur le déploiement de l’IA générative, notamment les opérations LLM, l’ingénierie des prompts et les outils de surveillance et de sécurité propres à l’IA générative.
- Awesome RAG Production
 - Sélection d’outils de niveau production et de bonnes pratiques pour créer des systèmes RAG évolutifs.
Contributeurs
Section intitulée « Contributeurs »HagiCode
HagiCode est un espace de développement agentique. Des interactions d’interface riches et pratiques rendent la planification, l’exécution des agents et le travail sur les projets accessibles et faciles à suivre, pour une expérience de développement engageante.
Une expérience de développement engageante grâce à des interactions d’interface riches et pratiques.

- IntelligentLes workflows OpenSpec transforment une intention en parcours exécutable, de la proposition à la livraison en passant par la conception et les tâches.
- EfficaceL’exécution multi-agent fait avancer recherche, réalisation et revue en parallèle, sur plusieurs dépôts et avec les Agent CLI que vous utilisez déjà.
- IntéressantDes interactions d’interface riches et pratiques rendent la planification, l’exécution des agents et le travail sur les projets accessibles et faciles à suivre.
Télécharger pour Windows
Partager HagiCode

Transformez vos idées en logiciels livrés.
HagiCode est un espace de développement agentique : les workflows OpenSpec planifient le changement, l’exécution multi-agent le réalise et Hero Scenario rend le long parcours visible, pour transformer vos idées en logiciels livrés.
- Intelligent
- Les workflows OpenSpec transforment une intention en parcours, de la proposition à la livraison.
- Efficace
- L’exécution multi-agent mène recherche, réalisation et revue en parallèle.
- Ludique
- Les interactions d’interface facilitent la planification, l’exécution des agents et les projets.
© 2026 HagiCode | Powered By hagilight-starlight@0.21.0 | Branch: main | Commit: 745b50b | Built: