
Chinese NLP
Source: https://github.com/crownpku/Awesome-Chinese-NLP at
923e20ae6872
License: Apache-2.0
Read the English original
This edition is an AI-assisted translation.
Chinese NLP
Section intitulée « Chinese NLP »
Une liste sélectionnée de ressources pour le TALN (traitement automatique du langage naturel) du chinois.
Ressources relatives au traitement automatique du langage naturel en chinois
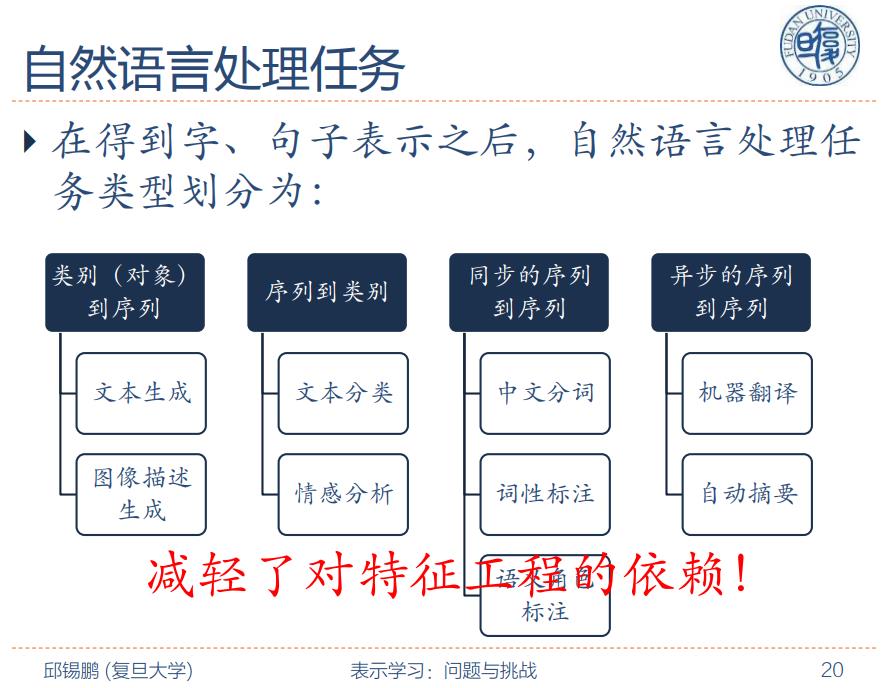
Image issue du professeur Qiu Xipeng de l’Université Fudan
Sommaire Contents
Section intitulée « Sommaire Contents »1. Outils NLP chinois Chinese NLP Toolkits
Section intitulée « 1. Outils NLP chinois Chinese NLP Toolkits »3. Organisations académiques et concours NLP chinois Organizations
Section intitulée « 3. Organisations académiques et concours NLP chinois Organizations »4. Services commerciaux NLP chinois Industry
Section intitulée « 4. Services commerciaux NLP chinois Industry »5. Matériel d’apprentissage Learning Materials
Section intitulée « 5. Matériel d’apprentissage Learning Materials »Outils NLP chinois Chinese NLP Toolkits
Section intitulée « Outils NLP chinois Chinese NLP Toolkits »Boîtes à outils NLP intégrées Toolkits
Section intitulée « Boîtes à outils NLP intégrées Toolkits »-
THULAC 中文词法分析工具包 par 清华 (C++/Java/Python)
-
NLPIR par 中科院 (Java)
-
LTP 语言技术平台 par 哈工大 (C++) pylyp wrapper Python pour LTP
-
FudanNLP par 复旦 (Java)
-
BaiduLac par 百度 outil d’analyse lexicale open-source de Baidu pour le chinois, incluant segmentation, étiquetage grammatical et reconnaissance d’entités nommées.
-
HanLP (Java)
-
FastNLP (Python) une suite NLP légère.
-
SnowNLP (Python) bibliothèque Python pour traiter le texte chinois
-
YaYaNLP (Python) package NLP chinois écrit en Python pur, nommé d’après « 牙牙学语 » (apprendre à parler)
-
小明NLP (Python) outil NLP chinois léger
-
DeepNLP (Python) pipeline NLP de deep learning implémenté sur Tensorflow avec des modèles chinois pré-entraînés.
-
chinese_nlp (C++ & Python) outils et exemples de traitement du langage naturel chinois
-
lightNLP (Python) framework de deep learning NLP basé sur Pytorch et torchtext
-
Chinese-Annotator (Python) outil d’annotation de texte chinois Annotator for Chinese Text Corpus
-
Poplar (Typescript) un outil d’annotation web pour le NLP
-
Jiagu (Python) Jiagu est entraîné sur des corpus à grande échelle à partir de modèles comme BiLSTM. Il fournit segmentation, étiquetage grammatical, reconnaissance d’entités nommées, analyse de sentiment, extraction de relations de graphe de connaissances, extraction de mots-clés, résumé de texte, découverte de nouveaux mots, etc.
-
SmoothNLP (Python & Java) axé sur des techniques NLP explicables
-
FoolNLTK (Python & Java) une boîte à outils de langage naturel chinois A Chinese Nature Language Toolkit
Boîtes à outils NLP anglaises ou multilingues courantes Popular NLP Toolkits for English/Multi-Language
Section intitulée « Boîtes à outils NLP anglaises ou multilingues courantes Popular NLP Toolkits for English/Multi-Language »-
CoreNLP par Stanford (Java) une suite Java d’outils NLP principaux.
-
Stanza par Stanford (Python) une bibliothèque NLP Python pour de nombreuses langues humaines
-
NLTK (Python) Natural Language Toolkit
-
spaCy (Python) NLP de niveau industriel, avec un cours en ligne
-
textacy (Python) NLP, avant et après spaCy
-
OpenNLP (Java) une boîte à outils basée sur l’apprentissage automatique pour le traitement de texte en langage naturel.
-
gensim (Python) Gensim est une bibliothèque Python pour la modélisation thématique, l’indexation de documents et la recherche de similarité sur de grands corpus.
-
Kashgari - framework NLP simple et puissant, construisez votre modèle de pointe en 5 minutes pour la reconnaissance d’entités nommées (NER), l’étiquetage grammatical (PoS) et la classification de texte. Inclut BERT et word2vec.
Segmentation de mots chinois Chinese Word Segment
Section intitulée « Segmentation de mots chinois Chinese Word Segment »-
Jieba 结巴中文分词 (Python et de nombreuses autres variantes) le meilleur composant de segmentation chinoise pour Python
-
北大中文分词工具 (Python) outil de segmentation chinois à haute précision, simple à utiliser, améliorant nettement la précision par rapport aux outils open-source existants.
-
kcws 深度学习中文分词 (Python) BiLSTM+CRF et IDCNN+CRF
-
ID-CNN-CWS (Python) Convolutions dilatées itérées pour la segmentation de mots chinois Iterated Dilated Convolutions for Chinese Word Segmentation
-
Genius 中文分词 (Python) Genius est un composant open-source de segmentation chinoise en python, utilisant l’algorithme CRF (Champ aléatoire conditionnel).
-
loso 中文分词 (Python)
-
yaha “哑哈”中文分词 (Python)
-
ChineseWordSegmentation (Python) algorithme de segmentation chinoise sans corpus Chinese word segmentation algorithm without corpus
-
Go 语言高性能分词 (Go) segmentation de texte efficace en Go ; supporte l’anglais, le chinois, le japonais et autres.
-
Ansj中文分词 (java) implémentation java de segmentation chinoise basée sur n-Gram+CRF+HMM
Extraction d’informations Information Extraction
Section intitulée « Extraction d’informations Information Extraction »-
MITIE (C++) bibliothèque et outils pour l’extraction d’informations
-
Duckling (Haskell) langage, moteur et outillage pour exprimer, tester et évaluer des règles de langage composables sur des chaînes d’entrée.
-
IEPY (Python) IEPY est un outil open-source d’extraction d’informations axé sur l’extraction de relations.
-
Snorkel un système de création et de gestion de données d’entraînement axé sur l’extraction d’informations
-
Extraction de relations neuronale implémentée avec LSTM dans TensorFlow
-
Un modèle de réseau de neurones pour la reconnaissance d’entités nommées chinoises
-
bert-chinese-ner utilise le modèle de langage pré-entraîné BERT pour le NER chinois
-
Information-Extraction-Chinese reconnaissance d’entités chinoises avec IDCNN/biLSTM+CRF, et extraction de relations avec biGRU+2ATT 中文实体识别与关系提取
-
Familia de Baidu, A Toolkit for Industrial Topic Modeling
-
Text Classification tous types de modèles de classification de texte et plus avec le deep learning. Utilise le corpus de questions-réponses Zhihu comme données de test.
-
ComplexEventExtraction concepts et modèles explicites d’événements composés chinois, incluant extraction d’événements conditionnels, causaux, de succession, d’inversion, etc., formant un graphe d’événements.
-
TextRank4ZH extrait automatiquement mots-clés et résumés de textes chinois
QA et Chatbot QA & Chatbot
Section intitulée « QA et Chatbot QA & Chatbot »-
Rasa NLU (Python) transforme le langage naturel en données structurées, une branche chinoise sur Rasa NLU Chi
-
Rasa Core (Python) moteur de dialogue basé sur l’apprentissage automatique pour logiciels conversationnels
-
Chatstack une UI de pipeline complet pour construire un système NLU chinois
-
Snips NLU (Python) Snips NLU est une bibliothèque Python qui analyse des phrases en langage naturel et en extrait des informations structurées.
-
DeepPavlov (Python) une bibliothèque open-source pour construire des systèmes de dialogue de bout en bout et entraîner des chatbots.
-
ChatScript outil/gestionnaire de dialogue en langage naturel, un moteur de chatbot à base de règles.
-
Chatterbot (Python) ChatterBot est un moteur de dialogue conversationnel d’apprentissage automatique pour créer des chatbots.
-
Chatbot (Python) chatbot contextuel basé sur la correspondance vectorielle
-
Tipask (PHP) un système de Q/R PHP open-source, basé sur Laravel, facile à étendre, avec une grande capacité de charge et stabilité.
-
QuestionAnsweringSystem (Java) un système de Q/R homme-machine en Java, capable d’analyser automatiquement les questions et de proposer des réponses candidates.
-
QA-Snake (Python) Q/R automatique basée sur plusieurs moteurs de recherche et le deep learning
-
Modèle de chatbot Sequence to Sequence implémenté avec TensorFlow (Python)
-
Système de Q/R de compréhension de lecture chinoise par deep learning (Python)
-
AnyQ by Baidu comprend principalement un framework de Q/R pour collections FAQ et l’outil de correspondance sémantique SimNet.
-
Code baseline DuReader de compréhension de lecture chinoise (Python)
-
QASystemOnMedicalKG (Python) un graphe de connaissances médicales d’une certaine ampleur centré sur les maladies, fournissant Q/R et analyse automatiques.
-
GPT2-chitchat (Python) modèle GPT2 pour bavardage chinois
-
CDial-GPT (Python) fournit un grand corpus de dialogue chinois et un modèle de pré-entraînement de dialogue chinois (modèle GPT chinois) dessus
Représentation et recherche multimodales Multi-Modal Representation & Retrieval
Section intitulée « Représentation et recherche multimodales Multi-Modal Representation & Retrieval »- Chinese-CLIP (Python) Chinese-CLIP est un modèle pré-entraîné de représentation multimodale texte-image chinois. Basé sur la structure CLIP d’OpenAI, pré-entraîné sur un grand corpus texte-image chinois natif, plusieurs tailles de modèles sont open-source, avec rapport technique et démo de recherche.
Corpus chinois Corpus
Section intitulée « Corpus chinois Corpus »-
CN-Probase, grand graphe de concepts chinois présentation sur compte officiel
-
Téléchargement open-source d’un grand graphe de connaissances chinois de 1,4 milliard
-
Graphe de connaissances agricoles recherche d’informations, reconnaissance d’entités, extraction de relations, construction d’arbres de classification, fouille de données dans le domaine agricole
-
Modèles de pré-entraînement chinois selon différents corpus et modèles (BERT, GPT, etc.) framework de modèles pré-entraînés chinois supportant différents corpus, encodeurs et tâches (from RUC and Tencent)
-
OpenCLaP dépôt open-source de modèles de langue pré-entraînés chinois multi-domaines (from Tsinghua)
-
Corpus d’étiquetage grammatical du Quotidien du Peuple 1998@Baidu Disk
-
Corpus d’actualités Sogou 20061127 (avec classification)@Baidu Disk
-
UDChinese (pour entraîner le PoS spaCy)
-
Plus d’une centaine de vecteurs de mots chinois pré-entraînés
-
Tencent AI Lab Embedding Corpus for Chinese Words and Phrases
-
Code d’entraînement GPT2 chinois peut écrire des poèmes, des nouvelles, des romans, ou entraîner un modèle de langage général.
-
ChineseGLUE, benchmark de compréhension du langage chinois inclut jeux de données représentatifs, modèles de référence (pré-entraînés), corpus, classement.
-
Base de données du dictionnaire Xinhua chinois inclut proverbes, idiomes, mots, caractères.
-
Synonyms : boîte à outils de synonymes chinois bibliothèque de synonymes entraînée sur Wikipédia chinois et word2vec, encapsulée en package python.
-
Chinese_conversation_sentiment un jeu de données de sentiment chinois pouvant servir à l’analyse de sentiment.
-
Corpus d’événements d’urgence chinois Chinese Emergency Corpus
-
dgk_lost_conv, corpus de dialogues chinois chinese conversation corpus
-
Corpus pour entraîner des systèmes de dialogue chinois et anglais Datasets for Training Chatbot System
-
Extraction des annonces boursières chinoises scripts python pour obtenir les annonces (sociétés cotées et régulateurs) des marchés sz, sh depuis les serveurs de Juchao
-
Interface de données financières tushare TuShare est un package d’interface de données financières python gratuit et open-source.
-
Jeu de données de texte financier SmoothNLP 金融文本数据集(公开) Public Financial Datasets for NLP Researches
-
Corpus du domaine de l’assurance [Blog 52nlp] OpenData en assurance pour tâches d’apprentissage automatique OpenData in insurance area for Machine Learning Tasks
-
Base de données la plus complète de poésie chinoise ancienne près de 14000 poètes des dynasties Tang et Song, ~55000 poèmes Tang et 260000 poèmes Song. 1564 auteurs de ci de l’époque Song, 21050 ci.
-
Petits corpus chinois inclut reconnaissance d’entités, reconnaissance de relations, compréhension de lecture chinoises en petites quantités
-
Chinese-Literature-NER-RE-Dataset jeu de données de reconnaissance d’entités et d’extraction de relations au niveau du discours pour texte littéraire chinois A Discourse-Level Named Entity Recognition and Relation Extraction Dataset for Chinese Literature Text
-
ChineseTextualInference projet d’inférence textuelle chinoise, incluant traduction et construction d’un jeu de 880000 paires d’implication textuelle, et modèle d’implication textuelle basé sur le deep learning.
-
Grand corpus de TALN chinois Wikipédia (wiki2019zh), actualités (news2016zh), Q/R encyclopédiques (baike2018qa)
-
Corpus de noms de personnes chinois noms, patronymes, prénoms, appellations chinoises, noms japonais, noms traduits, noms anglais.
-
Corpus de noms d’entreprises et d’organisations abréviations, acronymes, marques, noms d’entreprises.
-
Dictionnaire de mots sensibles chinois plusieurs implémentations de filtrage de mots sensibles + un dictionnaire de ~10k mots
-
Corpus d’abréviations chinoises un corpus d’abréviations chinoises incluant les formes longues négatives A corpus of Chinese abbreviation, including negative full forms.
-
Matériel de prétraitement de données chinoises dictionnaire de segmentation et mots vides chinois
-
SentiBridge : base de connaissances de sentiment d’entités chinoises décrit comment les gens décrivent une entité, 300000 paires couvrant actualités, voyage, restauration.
-
OpenCorpus une collection de corpus (chinois) librement disponibles.
-
ChineseNlpCorpus analyse de tendance sentiment/opinion/commentaire, reconnaissance d’entités chinoises, système de recommandation
-
FinancialDatasets SmoothNLP 金融文本数据集(公开) Public Financial Datasets for NLP Researches Only
-
People’s Daily & Children’s Fairy Tale PD&CFT : un jeu de données de compréhension de lecture chinois A Chinese Reading Comprehension Dataset
-
Wikipédia chinoise 230k entrées de qualité - maj juillet 2023 - infos sensibles/contestées filtrées
Organisations académiques et concours NLP chinois Organizations
Section intitulée « Organisations académiques et concours NLP chinois Organizations »-
Laboratoire de TALN et de calcul humain de l’Université Tsinghua
-
Laboratoire clé du ministère de linguistique computationnelle de l’Université Peking
-
Groupe de recherche TALN de l’Institut de calcul de l’Académie des sciences
-
Centre de calcul social et de recherche d’information de 哈工大
-
NLP Conference Calender principales conférences, revues, ateliers et tâches partagées de la communauté NLP.
-
2017 1ère évaluation de compréhension de lecture machine chinoise « iFlytek Cup »
-
2017 AI-Challenger description d’images en chinois décrire en une phrase l’information principale d’une image donnée, relevant du défi de compréhension d’image en contexte chinois.
-
2017 AI-Challenger traduction de texte anglais-chinois utiliser de grands corpus pour améliorer les modèles de traduction automatique anglo-chinois.
-
2017 concours d’apprentissage automatique Zhihu Kanshan Cup entraîner un modèle d’étiquetage automatique à partir des données de formation liant questions et tags de sujets sur Zhihu.
-
2018 tâche de Q/R chinoise en domaine ouvert pour une question chinoise donnée, le système choisit dans la base de connaissances des entités ou valeurs comme réponse.
-
2018 concours d’appariement de questions du service client de WeBank sur corpus client réel en chinois, appariement d’intention ; étant données deux phrases, juger si les intentions sont proches.
Services commerciaux NLP chinois Industry
Section intitulée « Services commerciaux NLP chinois Industry »-
Huawei Cloud NLP service cloud d’analyse et d’exploitation de texte pour entreprises et développeurs, aidant à traiter efficacement le texte
-
Baidu Cloud NLP fournit une technologie NLP de pointe, d’excellente compréhension et traitement de texte
-
Alibaba Cloud NLP outil central d’analyse et d’exploitation de texte pour entreprises et développeurs
-
Tencent Cloud NLP basé sur calcul parallèle et crawler distribué, combiné à une analyse sémantique unique, répond en un point aux besoins NLP, transcodage, extraction, capture de données
-
Plateforme ouverte iFlytek plateforme d’IA centrée sur l’interaction vocale
-
Laboratoire Sogou segmentation et étiquetage grammatical
-
BosonNLP 玻森数据 société shanghaise Boson, spécialisée dans l’analyse sémantique chinoise
-
Yunfu Tech 云孚科技 boîtes à outils NLP, graphes de connaissances, fouille de texte, systèmes de dialogue, analyse d’opinion, etc.
-
Zhiyan Tech 智言科技 société d’IA axée sur le deep learning et les graphes de connaissances
-
Zhuiyi Tech 追一科技 axée sur le deep learning et le TALN
Matériel d’apprentissage Learning Materials
Section intitulée « Matériel d’apprentissage Learning Materials »-
Stanford CS224n Natural Language Processing with Deep Learning 2017
-
[Supports de cours pour Georgia Tech CS 4650 et 7650, « Natural Language »] (https://github.com/jacobeisenstein/gt-nlp-class)
-
Speech and Language Processing par Dan Jurafsky et James H. Martin
-
Supports du cours pratique de traitement de texte incluant extraction de features (TF-IDF), classification, clustering, entraînement word2vec et similarité de mots, résumé automatique, extraction d’informations, analyse de sentiment et fouille d’opinion.
-
nlp_tasks Natural Language Processing Tasks and Selected References
-
Introduction à la recherche NLP par le professeur Liu Zhiyuan de 清华
-
Chinese NLP Tâches partagées, jeux de données et résultats de l’état de l’art pour le traitement automatique du chinois
HagiCode
HagiCode est un espace de développement agentique. Des interactions d’interface riches et pratiques rendent la planification, l’exécution des agents et le travail sur les projets accessibles et faciles à suivre, pour une expérience de développement engageante.
Une expérience de développement engageante grâce à des interactions d’interface riches et pratiques.

- IntelligentLes workflows OpenSpec transforment une intention en parcours exécutable, de la proposition à la livraison en passant par la conception et les tâches.
- EfficaceL’exécution multi-agent fait avancer recherche, réalisation et revue en parallèle, sur plusieurs dépôts et avec les Agent CLI que vous utilisez déjà.
- IntéressantDes interactions d’interface riches et pratiques rendent la planification, l’exécution des agents et le travail sur les projets accessibles et faciles à suivre.
Télécharger pour Windows
Partager HagiCode

Transformez vos idées en logiciels livrés.
HagiCode est un espace de développement agentique : les workflows OpenSpec planifient le changement, l’exécution multi-agent le réalise et Hero Scenario rend le long parcours visible, pour transformer vos idées en logiciels livrés.
- Intelligent
- Les workflows OpenSpec transforment une intention en parcours, de la proposition à la livraison.
- Efficace
- L’exécution multi-agent mène recherche, réalisation et revue en parallèle.
- Ludique
- Les interactions d’interface facilitent la planification, l’exécution des agents et les projets.
© 2026 HagiCode | Powered By hagilight-starlight@0.21.0 | Branch: main | Commit: 745b50b | Built: